
TL;DR: A equipe de agentes de IA da OpenAI transformou 5.034 alvos de auditoria no kernel do Linux em 948 exploits exclusivos de escalação local de privilégios (LPE) com um custo aproximado de US$ 1,2 milhão em créditos de API; em seguida, pesquisadores humanos revisaram os resultados. Você pode adotar essa mesma estrutura no seu próprio código: agentes fazem o mapeamento do que é acessível, analisam os alvos, comprovam cada achado isoladamente e elaboram uma proposta de correção, cabendo a aprovação final a uma pessoa.
Em 4 de novembro de 2026, a OpenAI publicou o artigo “A thousand fewer paths to root”. A manchete destaca os 948 exploits no Linux. A grande lição para equipes de desenvolvimento de software está nos bastidores: o resultado foi alcançado por agentes especializados atuando em etapas coordenadas, nas quais cada um repassa evidências concretas ao próximo, com uma revisão humana ao final do processo.
Essa abordagem não depende de conhecimento aprofundado no kernel, o que permite aplicar a mesma estrutura aos seus próprios serviços. A urgência é real: a OpenAI informou que seu pipeline gerou “lucro líquido” em comparação com os pagamentos de recompensas de programas públicos de bug bounty. Cibercriminosos também sabem fazer essas contas — por isso, comece agora mesmo.
O que a equipe de agentes de IA da OpenAI descobriu
A OpenAI executou o pipeline em meados de outubro de 2026 na versão mais recente do kernel Linux, utilizando um modelo voltado à segurança cibernética que ainda será lançado. Os alvos foram máquinas virtuais isoladas rodando um sistema operacional desktop padrão com as proteções habituais ativadas.
| Stage | Result | API cost |
|---|---|---|
| Scout | 5.034 alvos de auditoria, cerca de 2,8M de linhas, aproximadamente 7% do kernel | $3,426 |
| Analyze | 2.308 achados candidatos | $316,549 |
| Validate | 1.724 reproduzidos (cerca de 74,7%) | $73,330 |
| Assess exploitability | 948 exploits exclusivos de LPE, 291 PoCs de vazamento de informações | $820,123 |
| Total | $1,213,430 |
Esses números refletem a escala do kernel analisado pela OpenAI, e não uma estimativa para o seu repositório. A própria OpenAI classifica esses custos como “mais próximos de um limite superior”, pois o objetivo principal foi avaliar capacidade, e não eficiência.
Tenha três limitações importantes em mente:
- Trata-se de falhas de escalação local de privilégios (LPE). O invasor precisa obter acesso local prévio. Elas não funcionam como exploits remotos por si sós.
- Muitas ainda não foram corrigidas. Quando a varredura e análise de 10 dias terminaram, 61 LPEs haviam sido corrigidas upstream, 43 tinham patches em staging e 299 estavam sob discussão pública. A OpenAI enviou centenas de relatórios e correções para falhas críticas e está encaminhando o restante de forma gradual com os parceiros do programa Patch the Planet.
- O artigo da OpenAI não relata a exploração ativa dessas falhas no mundo real (in the wild).
A orientação da OpenAI é direta. Em um sistema operacional sem as correções mais recentes instaladas, uma conta com privilégios baixos “deve ser considerada funcionalmente equivalente ao acesso root para um agente de ameaça bem financiado”. Portanto, aplique os patches e restrinja o raio de impacto com soluções de isolamento como Firecracker e gVisor.
As cinco etapas de um fluxo de segurança com agentes de IA
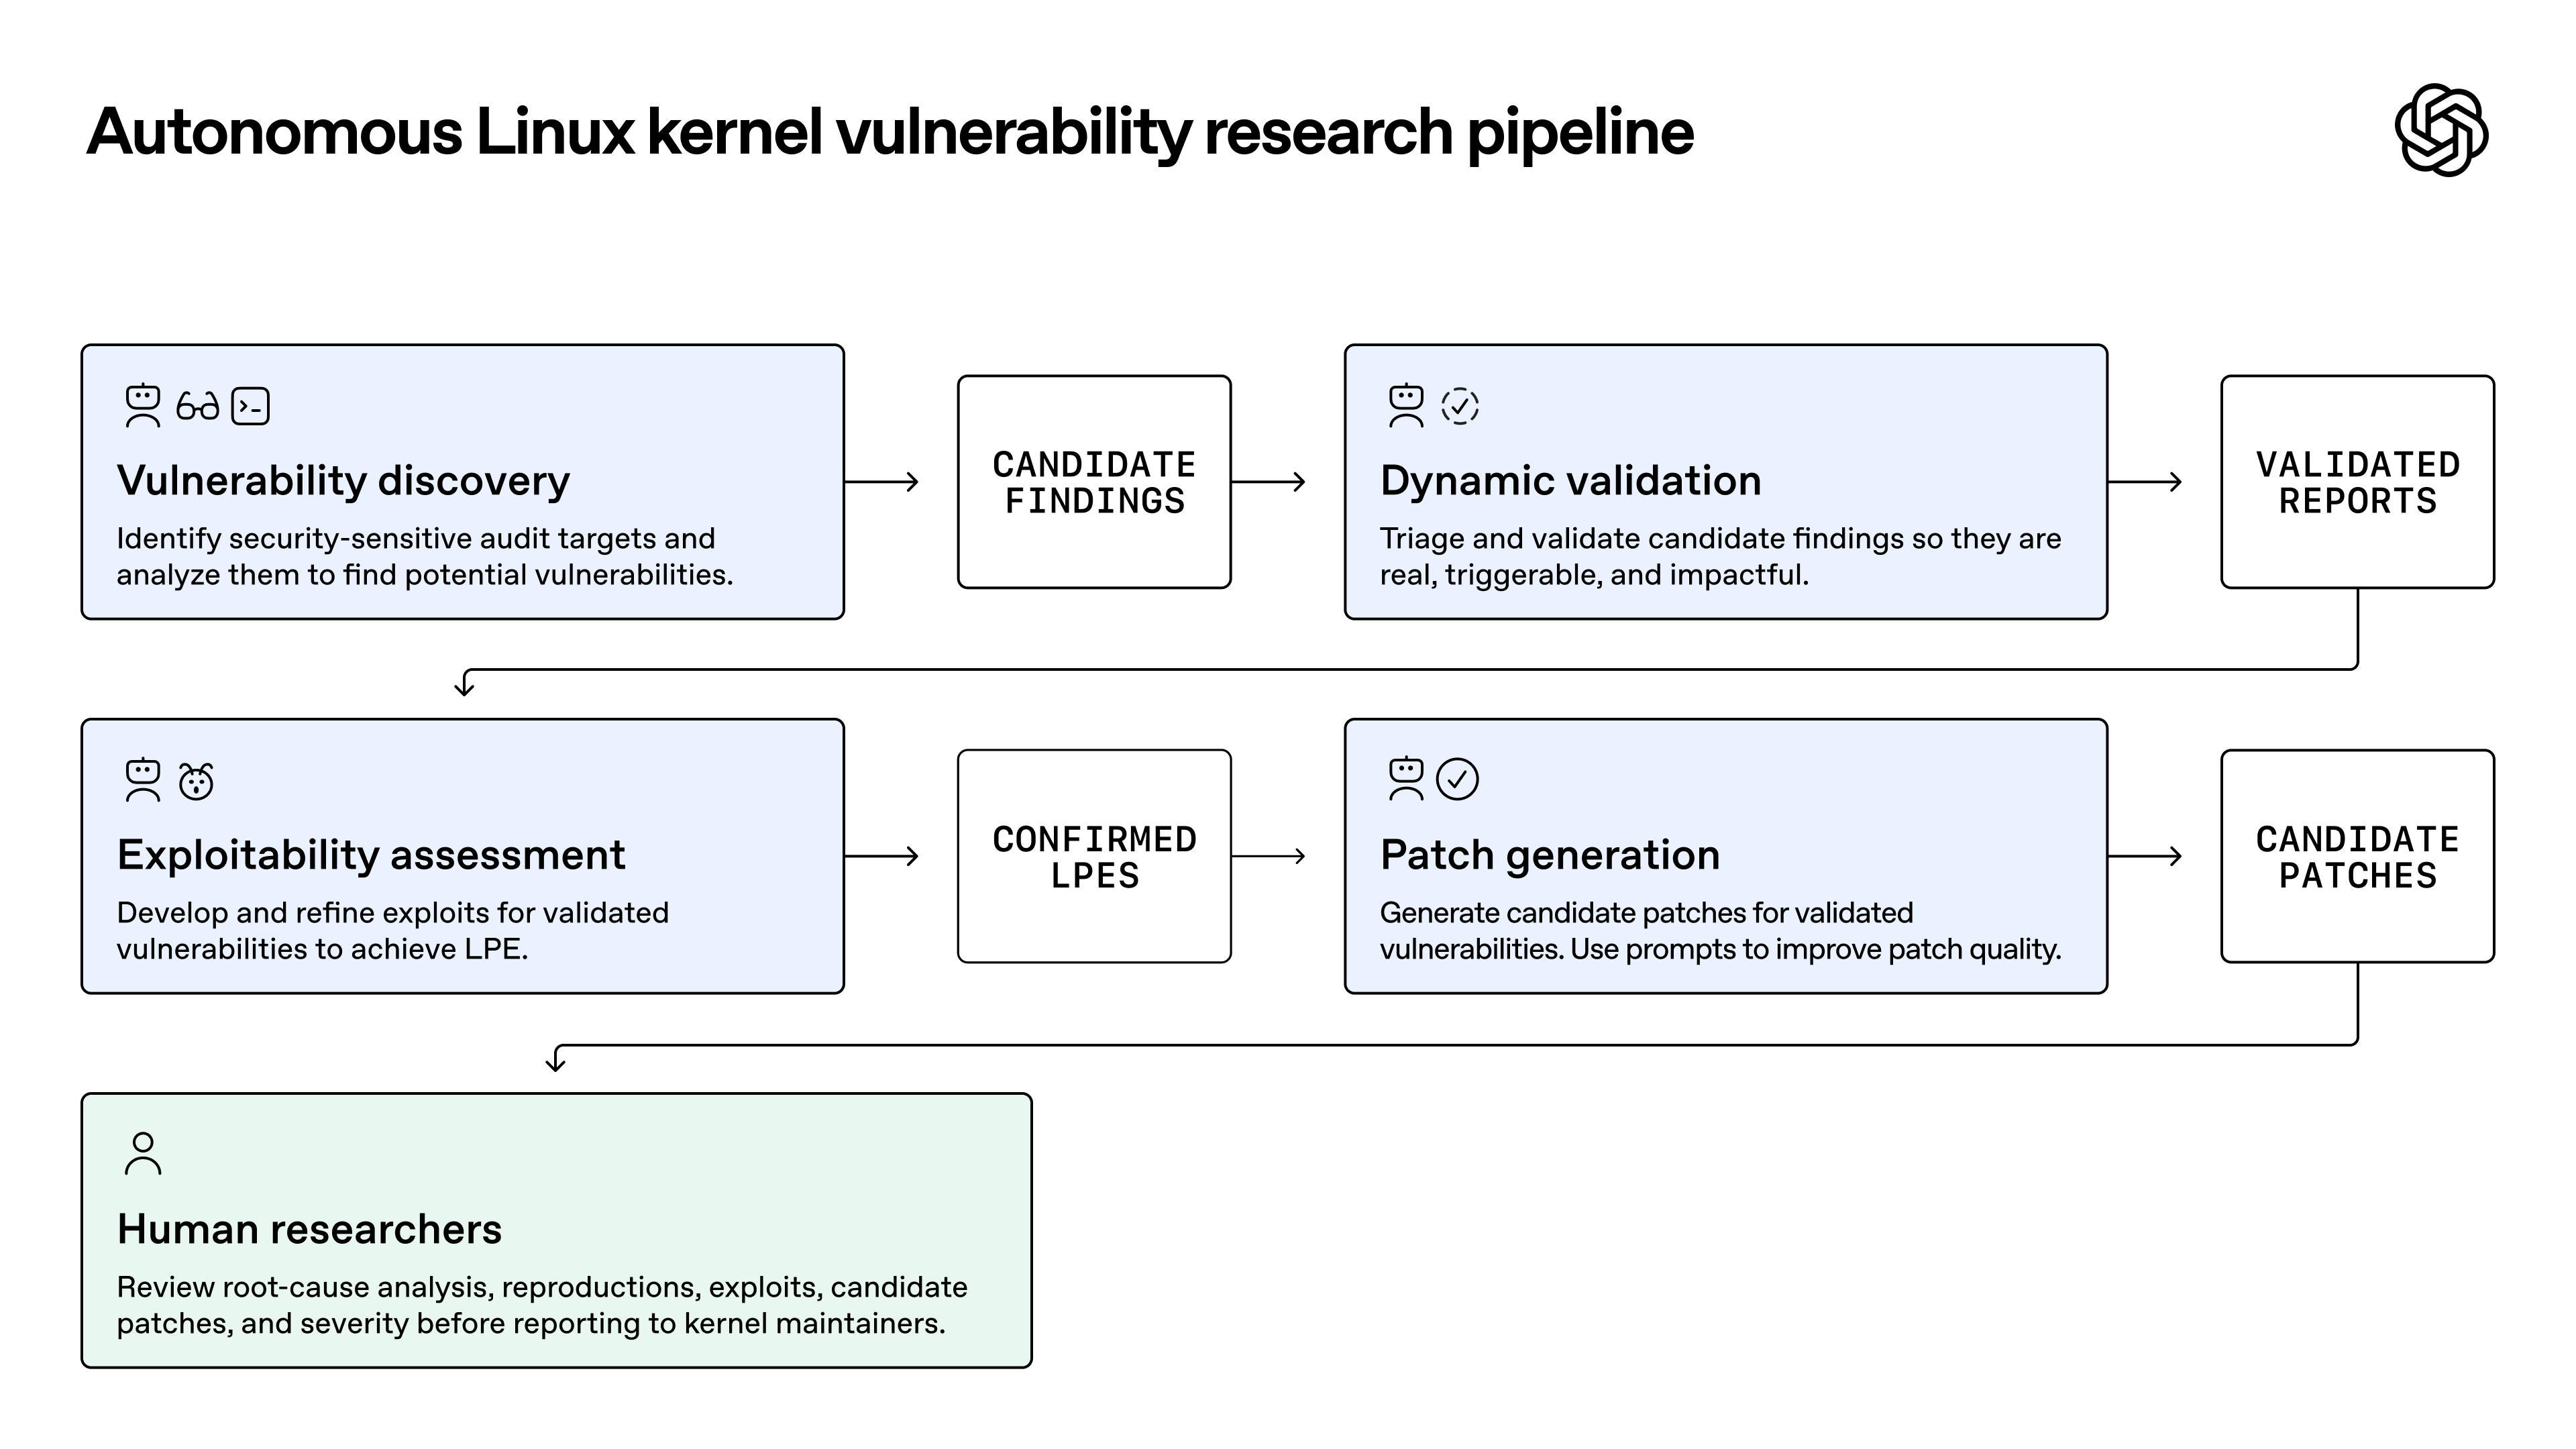
Um fluxo de segurança baseado em agentes de IA divide o processo de revisão em etapas, em que cada fase afunila o trabalho e gera evidências para a etapa seguinte. O modelo da OpenAI é composto por cinco etapas:
- Descoberta (Discovery). Agentes de reconhecimento (scout) selecionam alvos de auditoria com base na acessibilidade e na relevância para a segurança. Agentes analistas examinam cada alvo, elaboram uma modelagem de ameaças e reportam potenciais vulnerabilidades.
- Validação dinâmica (Dynamic validation). Agentes de triagem escrevem uma prova de conceito (PoC) e a executam em uma VM isolada com KASAN, um detector de erros de memória do kernel, refinando o código até que a falha seja reproduzida ou que as alternativas se esgotem.
- Avaliação de explorabilidade (Exploitability assessment). Um agente de triagem preliminar descarta achados sem um caminho de ataque viável. Em seguida, agentes de desenvolvimento de exploits (ExploitDev) realizam testes práticos nos casos restantes.
- Geração de correções (Patch generation). Agentes criam um rascunho de patch para cada bug validado, seguindo as convenções do código circundante e buscando variantes do problema.
- Revisão humana (Human review). Pesquisadores de segurança avaliam o exploit, o patch e a severidade antes de qualquer envio aos mantenedores.
Cada transferência entre etapas é sustentada por evidências, e não por suposições, permitindo que a pessoa na etapa final tome decisões fundamentadas em fatos.
Como mapear cada etapa para o seu próprio repositório
Aplique este fluxo de trabalho apenas em códigos que pertençam a você ou sobre os quais você tenha autorização formal para testar. No caso do seu repositório, elimine totalmente a etapa de desenvolvimento de exploits. Um teste automatizado que falha já comprova o defeito sem a necessidade de produzir uma ferramenta de ataque.
| OpenAI stage | Your version | Output |
|---|---|---|
| Scout | Mapear pontos de entrada acessíveis por usuários anônimos ou com poucos privilégios: rotas, webhooks, uploads, parsers, consumidores de fila | Lista de auditoria |
| Analyst | Um alvo por execução: ler o código, estruturar um modelo de ameaças sucinto, reportar falhas suspeitas | Achados candidatos |
| Validate | Escrever um teste mínimo que falhe em um ambiente descartável | Teste e logs |
| Assess | Classificar o impacto com base na fronteira de confiança ultrapassada | Severidade com justificativa |
| Patch | Criar a correção como um pull request acompanhado do teste | Pull request |
| Human | Revisar e, em seguida, fazer o merge ou rejeitar | Correção mesclada ou achado encerrado |
Delimitar o escopo traz retorno imediato. Os agentes de reconhecimento da OpenAI custaram US$ 3.426 e reduziram a auditoria a cerca de 7% do kernel. Comece com um único serviço e seus pontos de entrada públicos. Uma tarefa para analisar um achado pode ser tão direta quanto esta:
Title: Validate finding: path traversal in /api/exports/download

Scope: this repository only. Disposable test environment only.
No production credentials, no external network targets.

Goal: write a minimal failing test that proves or disproves the finding.
Evidence: test file, command output, code path from entry point to flaw.
Give up: stop after two approaches with no new evidence. Report what you tried.
Do not: fix the bug here, build an attack payload, or merge anything.
Verifique o caminho, não apenas o resultado final
Em uma das primeiras execuções, a etapa de exploração da OpenAI reportou 200 casos de sucesso. A revisão humana constatou que 20 deles obtiveram privilégios de root por meio de um 0-day diferente daquele designado para o teste. O pipeline sinalizou sucesso baseando-se apenas no resultado final — e o resultado estava correto, mas pelo motivo errado.
A OpenAI restringiu as condições das tarefas e incluiu uma validação independente para confirmar que cada exploit utilizava exclusivamente a vulnerabilidade atribuída. A lição principal: verifique tanto o caminho percorrido até o resultado quanto o resultado em si.
No seu dia a dia, essa situação é comum: um agente afirma que o teste comprova uma vulnerabilidade de autenticação, mas o teste falha apenas porque faltou carregar uma fixture. Adicione um agente de checagem que não tenha participado da escrita do teste e faça uma pergunta simples: essa falha é realmente originada no caminho de código reportado?
Valide com antecedência: falsos positivos custam o mesmo
A OpenAI constatou que o custo de tentar validar um verdadeiro positivo é equivalente ao de validar um falso positivo. Portanto, qualquer achado incorreto que chegue à fase de validação consome o custo de uma execução inteira.
Filtre antes de comprovar. A OpenAI concentrou a validação em achados que pudessem ser alcançados por um usuário com baixos privilégios, que não demandassem permissões especiais e que gerassem evidências mensuráveis. Estabeleça barreiras semelhantes no seu código, como “acessível sem perfil de administrador”. Achados que não passarem nesse filtro devem ser encerrados com o devido motivo registrado.
Em seguida, reavalie os achados com base na versão mais recente do código antes de formalizar os relatórios, conforme recomenda a OpenAI, evitando relatórios redundantes ou desatualizados.
Defina uma regra de desistência antes do início da execução
As tentativas que falharam foram as mais caras. Entre os candidatos a LPE, as 69 tentativas com falha custaram em média US$ 3.922 cada, enquanto os 1.169 casos bem-sucedidos tiveram um custo médio de US$ 360. De acordo com nossas contas, cerca de 6% das tentativas consumiram aproximadamente 39% dos US$ 691.000 aplicados nessa fase.
A solução recomendada pela OpenAI é estipular uma condição de desistência (give-up rule), como interromper o processo após uma hora sem avanço comprovado. Inclua essa regra explicitamente na tarefa e aplique um limite rígido de tempo de execução.
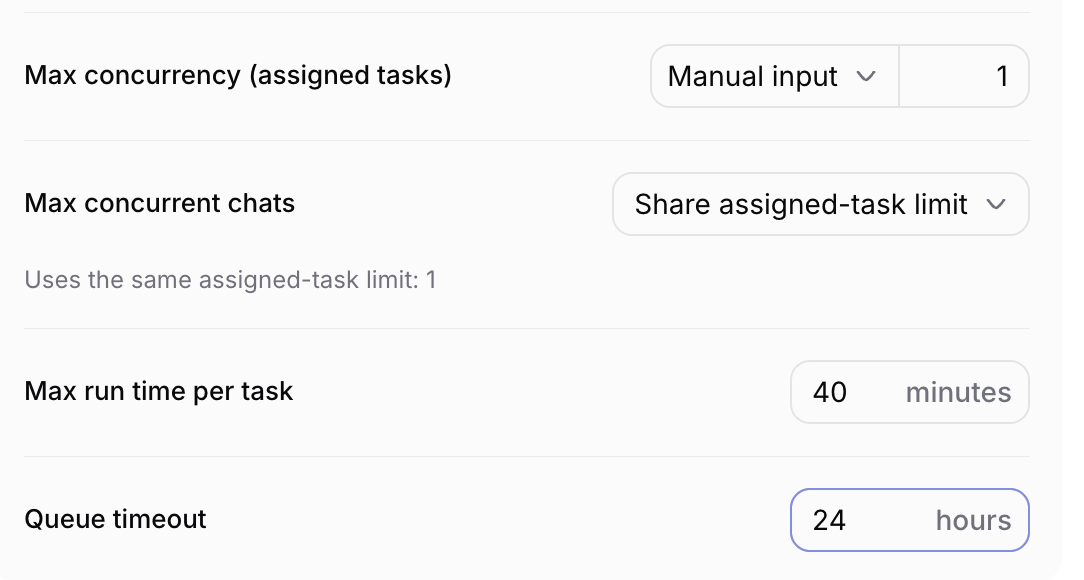
No Sharkly, o limite de tempo por tarefa é configurado nas Run settings do Agente. Como essa configuração atua como um teto de tempo e não como um identificador de progresso, mantenha a regra de “interromper caso não haja novas evidências” nas instruções da tarefa.
Mantenha a orquestração enxuta com a evolução dos modelos
A OpenAI construiu uma camada de 103 técnicas de exploração voltada ao GPT-5.5 Cyber, elevando sua taxa de sucesso de 76,2% para 88,9%. No entanto, essa mesma camada proporcionou um ganho de apenas 1,5 ponto percentual no GPT-5.6 Cyber, levando a equipe a descontinuá-la.
Reavalie sua infraestrutura de suporte a prompts e ferramentas sempre que atualizar os modelos. Refaça também as varreduras: a execução de outubro identificou 5 vezes mais LPEs inéditas do que os testes de julho com o GPT-5.6 Sol, operando em um código que havia recebido três meses adicionais de correções e hardening.
Mantenha a revisão humana antes de colocar qualquer alteração em produção
Agentes elaboram correções na forma de pull requests. Um ser humano faz o merge. A OpenAI identificou que os primeiros patches gerados podiam ser mais extensos do que o necessário, ignorar variações do bug ou descumprir padrões de código, e que rodadas adicionais de refinamento aprimoravam os resultados.
A empresa também recomenda o uso de modelos para conduzir revisões adversariais tanto em patches desenvolvidos por humanos quanto por IA. Encarregue um agente de tentar contornar a correção implementada e, em seguida, deixe a decisão com um revisor humano. Se as revisões já representam um gargalo no seu time, leia nosso artigo sobre como estruturar o processo de revisão para agentes paralelos antes de introduzir uma nova fila contínua de pull requests.
Como estruturar esse fluxo de trabalho como tarefas no Sharkly
Uma Tarefa (Task) é a unidade fundamental de trabalho no Sharkly. Veja um exemplo prático de implementação:
- Crie um tipo de tarefa. Um task type gerencia um Workflow estruturado com status ordenados. Um tipo como “Security finding” pode utilizar as seguintes etapas: Candidate, Reproduced, Patch drafted, In review, Closed.
- Crie uma equipe (Crew). Um Crew é um grupo reutilizável composto por Pessoas e Agentes, coordenado por um Agente líder. Inclua Agentes para as funções de reconhecimento (scout), análise (analyst), validação (check) e correção (patch). O líder inicia o processo e aciona os membros para tarefas específicas.
- Isole as execuções. Utilize um diretório temporário para que cada Task opere em seu próprio worktree, e consulte nosso guia sobre worktrees isolados ao escalar tarefas em paralelo. Mantenha desativado o diretório compartilhado do Crew nas etapas em que o Agente de checagem precise de total independência.
- Automatize as transições. Uma regra de Automation acionada pela mudança de status da tarefa pode iniciar o Agente de correção assim que a Task atingir o status Reproduced. Como essas execuções ocorrem sem supervisão e não realizam perguntas interativas — além de os status serem compartilhados por toda a organização —, instrua o fluxo a confirmar a Task disparadora.
- Vincule os pull requests. Com a integração com o GitHub, incluir o ID da tarefa no nome da branch, no título ou na descrição associa o pull request automaticamente. Como o merge não encerra o status da tarefa de forma automática, cabe ao revisor finalizar a Task.
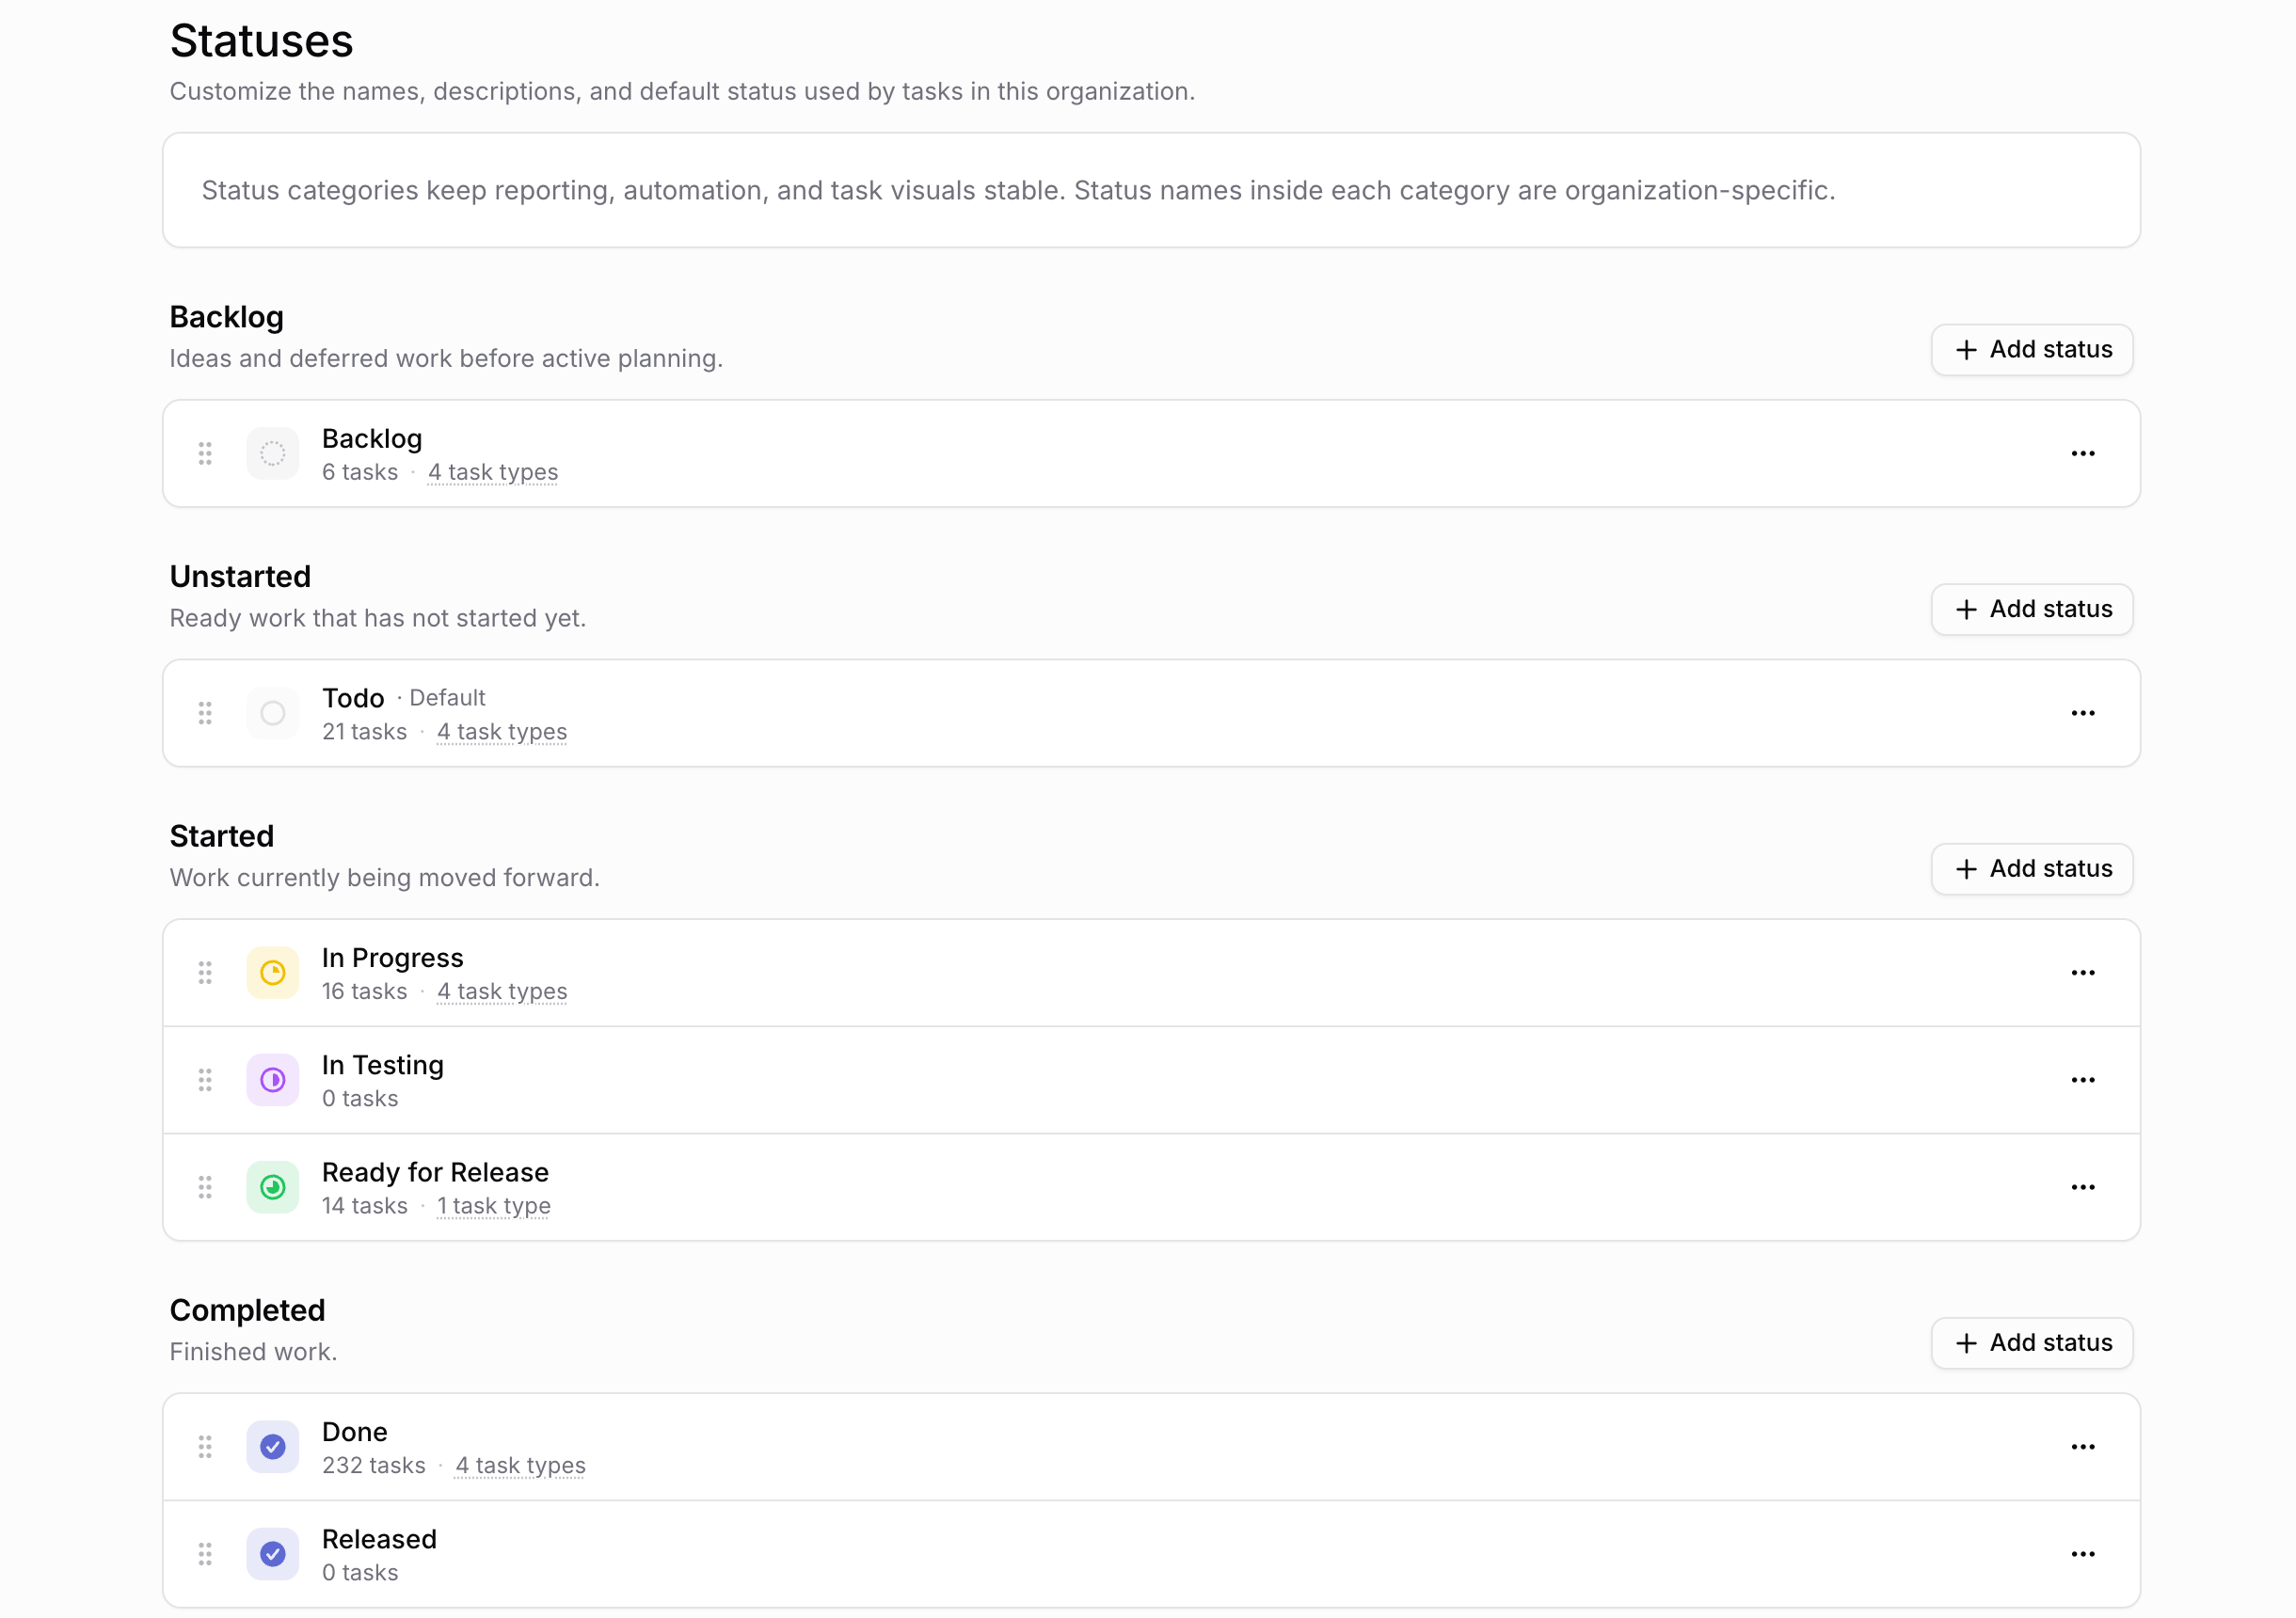
Os status são globais em toda a Organização; por isso, crie novos status dedicados a este fluxo em vez de modificar os já existentes.
Um ponto fundamental de segurança: um worktree impede que Tasks sobreponham arquivos, mas não atua como sandbox de segurança. Execute testes de reprodução em containers ou VMs descartáveis e desprovidos de credenciais de produção, concedendo aos Agentes apenas as permissões estritamente necessárias no Git.
O Sharkly atua na coordenação de todo o fluxo. A execução técnica fica a cargo de ferramentas como Claude Code, Codex e soluções similares, enquanto o consumo dos modelos se mantém pelas assinaturas ou chaves de API integradas a essas ferramentas. Se o seu objetivo é ampliar a escala, veja como executar 10 agentes de codificação por IA em paralelo.
Em repositórios pequenos, vincule um único Agente a uma Task e dispense o uso de Crews. Recorra a um Crew quando houver necessidade de um líder para orquestrar papéis distintos e centralizar os relatórios em uma única Task.
Conclusão
O resultado alcançado pela OpenAI estabelece um roteiro prático para o seu time: restrinja o escopo, exija evidências a cada etapa, valide o caminho da execução, encerre tentativas improdutivas com rapidez e mantenha uma pessoa responsável pela aprovação final do merge.
Dê o primeiro passo esta semana. Selecione um serviço do seu projeto, faça um inventário de seus pontos de entrada públicos e crie uma Task de validação para cada potencial vulnerabilidade identificada. O guia de início rápido do Sharkly auxilia na configuração do seu primeiro Agente em um Computer conectado, e o portal sharkly.ai apresenta em detalhes como nossa camada de tarefas e revisão potencializa o uso de agentes.
FAQ
Os agentes da OpenAI atacaram sistemas Linux em produção?
Não. Os exploits foram executados exclusivamente em VMs isoladas em um ambiente controlado de testes, e pesquisadores humanos validaram todos os resultados antes do envio de relatórios aos mantenedores.
Todas as 948 vulnerabilidades do Linux foram corrigidas?
Não. Muitas ainda estão em processo de notificação e desenvolvimento de patches. Ao término dos 10 dias de varredura, 61 haviam sido corrigidas upstream e 43 contavam com patches em staging.
Esses exploits permitem comprometer um servidor remotamente?
Não diretamente. Trata-se de falhas de escalação local de privilégios (LPE), o que significa que o atacante precisa obter acesso local prévio ao ambiente. Mantenha os sistemas atualizados e garanta o isolamento de aplicações que processam dados não confiáveis.
Quanto custaria executar esse fluxo no meu repositório?
Os custos reportados pela OpenAI não devem ser tomados como base direta, pois foram obtidos na escala do kernel Linux. Comece com um único serviço, estabeleça limites claros de execução e avalie o custo médio por falha validada.
É obrigatório usar o modelo cyber da OpenAI?
Esse modelo ainda não está disponível publicamente, tendo sido anunciado pela OpenAI como um lançamento futuro. A estrutura das etapas independe do modelo utilizado: teste o fluxo com os agentes de código que sua equipe já utiliza e avalie os resultados a partir das evidências geradas.


