
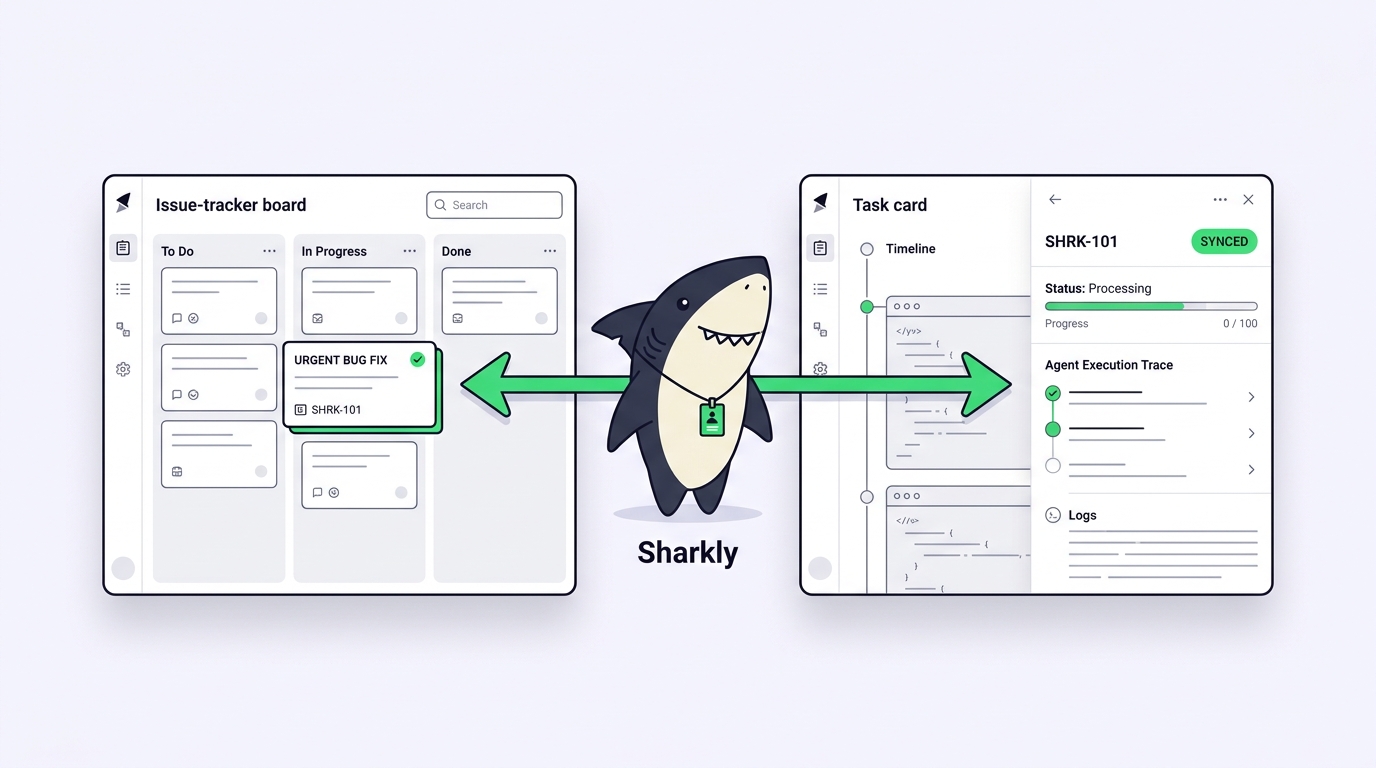
Seu backlog vive no Jira. Ninguém está pensando em tirá-lo de lá. Os épicos estão ali, os relatórios de sprint vão para a liderança e outras três equipes dependem daqueles IDs de itens de trabalho. Então, quando alguém pergunta se um agente de codificação com IA deveria pegar a JIRA-4821, a questão não é “devemos substituir o Jira”. Ela é mais restrita e mais prática: onde o agente realmente roda, quem revisa o que ele produziu e se algo disso volta para o ticket?
É essa a comparação que importa. O Jira já tem agentes, e eles funcionam. O Sharkly também executa agentes, em computadores que você conecta, e sincroniza o resultado de volta no Jira. Este guia traça a linha entre os dois com honestidade, inclusive nos casos em que adicionar o Sharkly seria exagero.
TL;DR
O Jira é um sistema de registro que incorporou a execução de agentes. O Sharkly é uma camada de execução que se conecta ao seu sistema de registro. O Rovo Dev, da Atlassian, cuida de planejamento, codificação e revisão dentro dos ambientes da Atlassian, e você pode atribuir itens de trabalho a agentes pelo menu suspenso de responsável. O Sharkly executa qualquer Runtime que sua equipe já paga em Computers que você conecta, mantém o rastreamento da execução em uma Task compartilhada e sincroniza nos dois sentidos com Jira Cloud, Server ou Data Center. Se o trabalho dos seus agentes cabe nos ambientes suportados pela Atlassian, só o Jira basta. Se seus agentes precisam rodar nas suas próprias máquinas, com seus próprios runtimes e seu próprio gate de revisão, o Sharkly adiciona essa camada sem expulsar o Jira.
O que o Jira faz bem, sem rodeios
Vamos dar ao Jira a sua melhor versão, porque a versão honesta já é forte.
O Jira é onde a empresa entra em acordo sobre qual trabalho existe. Esse acordo tem valor real: IDs compartilhados, modelos de permissão, histórico de auditoria, relatórios que o financeiro e a liderança já leem. Qualquer ferramenta que peça a uma equipe para abandoná-lo está pedindo algo caro.
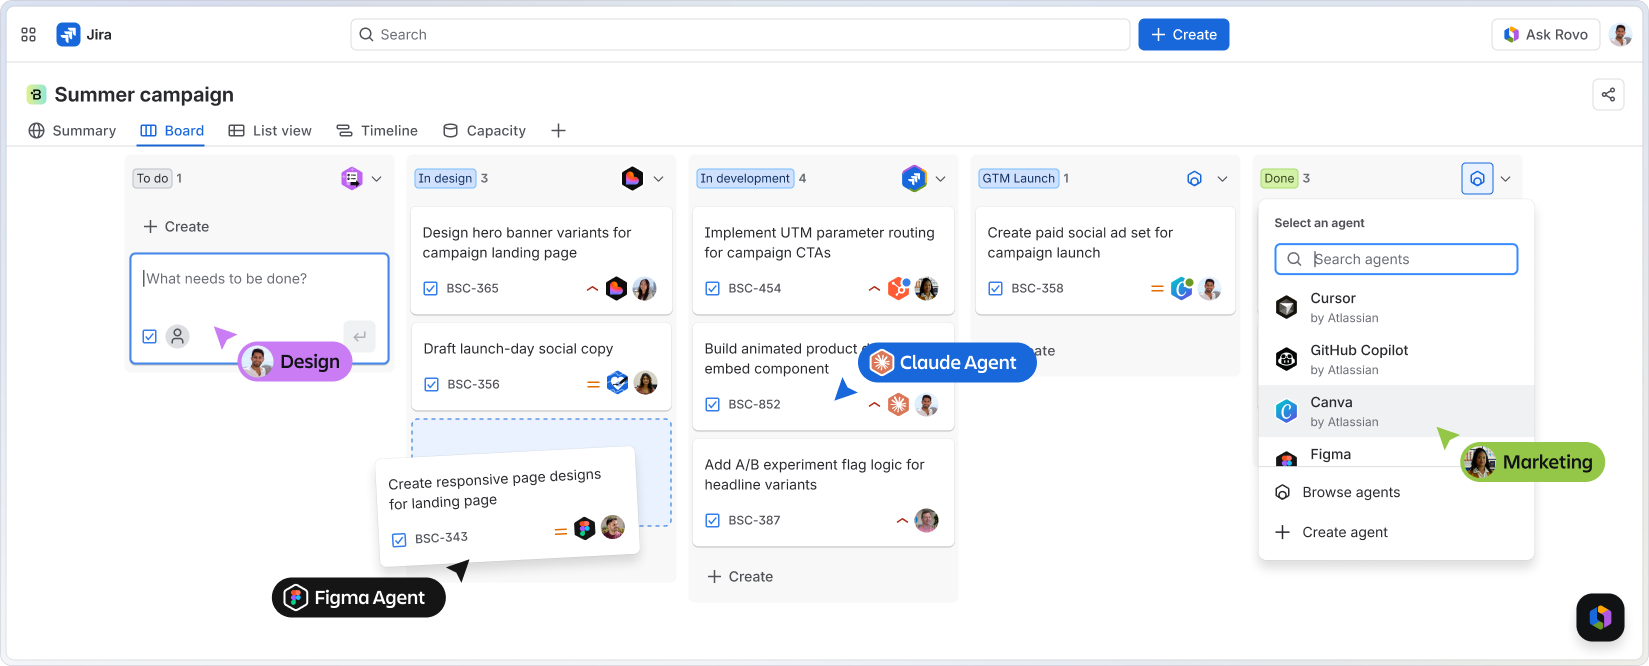
A Atlassian também não ficou parada no quesito agentes. O Rovo Dev é descrito pela Atlassian como “um agente de IA sensível ao contexto que acelera o ciclo de vida de desenvolvimento de software ao cuidar de planejamento, codificação, revisões e automação de trabalho repetitivo em escala”. Ele valida alterações de código com base nos critérios de aceite no Jira e atua no CLI do terminal, no Bitbucket Cloud, no GitHub e no VS Code. A Atlassian afirma que o Rovo Dev Standard está disponível para todos os clientes novos e existentes, com créditos mensais sendo liberados nos planos Standard, Premium e Enterprise Cloud.
O modelo de atribuição é genuinamente bom. Você abre o menu de responsável de um item de trabalho e escolhe um agente do mesmo jeito que escolheria um colega, e essa lista inclui agentes de terceiros, como o agente de codificação do GitHub Copilot. A própria equipe de engenharia da Atlassian publicou um relato sobre entregar 120 PRs em duas semanas usando o Rovo Dev no Jira. Não é número de demonstração. É uma equipe reportando produtividade em trabalho real.
Ou seja, o ponto de partida não é “o Jira está atrasado”. É “o Jira tem uma resposta, e você precisa saber exatamente o que essa resposta cobre”.
Onde termina a resposta do Jira
A fronteira está em onde a execução acontece e a quais ferramentas ela consegue chegar.
A execução de agentes nativa do Jira acontece dentro dos ambientes que a Atlassian suporta. Isso é um design deliberado e, para muitas equipes, é o certo. Também significa que a questão do runtime já vem resolvida para você. Se seus desenvolvedores padronizaram o uso do Claude Code com uma configuração específica de Skills, do Codex por meio de uma assinatura do ChatGPT, do Gemini CLI, do OpenCode ou de algo que você construiu com base em um protocolo personalizado, o caminho nativo do Jira não executa essas ferramentas do jeito que seus desenvolvedores as executam localmente.
Há uma segunda fronteira que importa mais do que a maioria das comparações admite: a máquina. O trabalho de um agente não é só uma chamada de modelo. Ele precisa de um checkout, um gerenciador de pacotes, variáveis de ambiente, um banco de dados local, a rota de VPN até a sua API de staging e as vinte pequenas coisas que fazem seu repositório compilar no seu notebook, mas não em um contêiner genérico. As equipes esbarram nisso na segunda semana, não na primeira.
E há a questão da revisão. Quando um agente produz uma alteração, o artefato útil não é apenas o pull request. É o rastreamento: o que foi dito ao agente, o que ele leu, o que tentou, onde travou e o que um humano decidiu a respeito. Esse registro precisa de um lugar que a próxima pessoa consiga ler.
As duas decisões
A própria documentação do Sharkly é direta sobre a divisão de trabalho, e a mesma franqueza vale aqui.
Use só o Jira quando o trabalho dos seus agentes couber nos ambientes suportados pela Atlassian, seus repositórios estiverem no Bitbucket ou no GitHub e os agentes que você quer forem aqueles que o Jira já consegue atribuir. Você tem um sistema de registro e um caminho de execução em um único produto, com uma única cobrança. Adicionar outra camada só traz complexidade desnecessária. Essa é uma recomendação de verdade, não uma ressalva.
Adicione o Sharkly quando a execução precisar acontecer em hardware e runtimes que você controla. Um Computer no Sharkly fornece o host de execução para o trabalho de Agents, e pode ser um computador local, um servidor remoto, um contêiner ou um host de nuvem compatível. Um pequeno serviço local conecta esse Computer ao Sharkly, detecta os Runtimes disponíveis, recebe trabalho, prepara o diretório da tarefa, inicia o Runtime selecionado e transmite o progresso de volta. Essa é a peça que o Jira não tenta ser.
Uma definição, porque o restante depende dela. Uma Task é a principal unidade de trabalho no Sharkly. Ela reúne o objetivo e a descrição, a pessoa responsável, o Agent ou Crew designado para executá-la, os comentários, o estado de execução, o rastreamento e o resultado. Enquanto uma issue do Jira registra que o trabalho existe, uma Task do Sharkly registra como o trabalho foi feito, por qual agente e em qual máquina.
Você não precisa escolher: o caminho da sincronização
É aqui que a maioria das comparações “Sharkly vs. Jira” erra. Os dois não são mutuamente exclusivos, e a integração é documentada, não uma promessa.
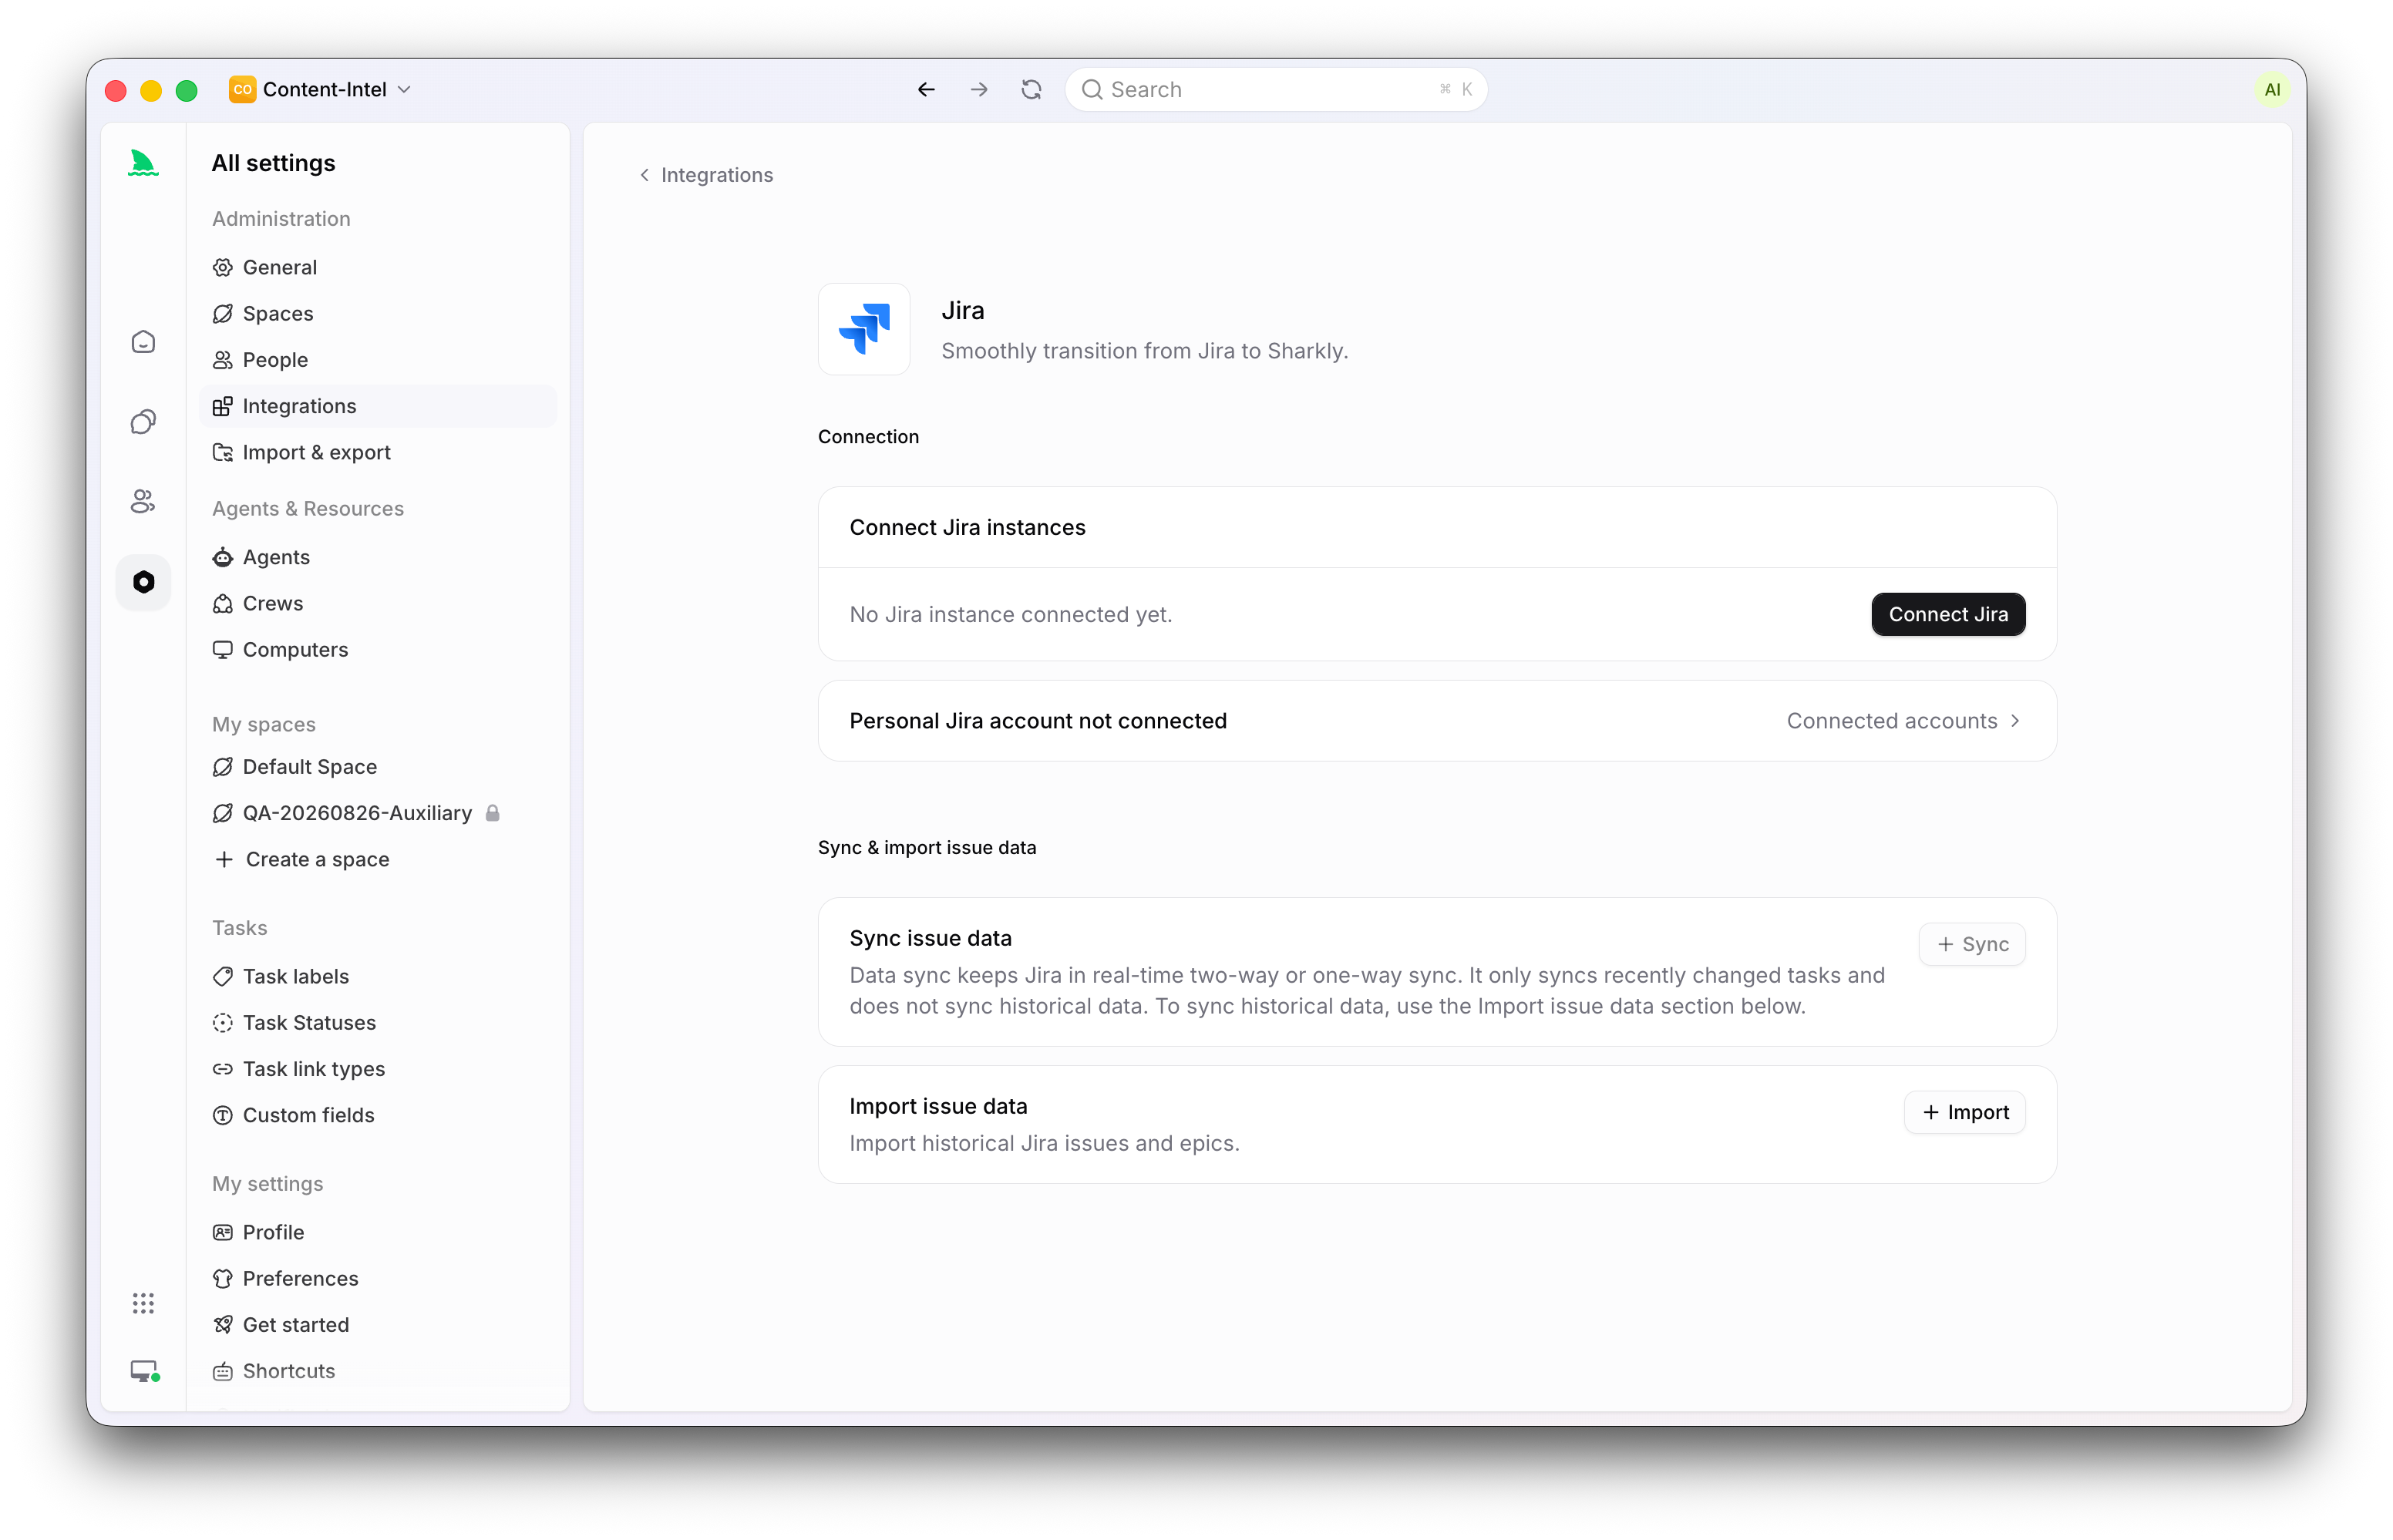
A integração com o Jira do Sharkly oferece suporte ao Jira Cloud e ao Jira Server ou Data Center, com três modos:
- Import copia dados existentes do Jira para o Sharkly. Use para trabalho histórico ou uma migração controlada.
- Sync vincula um projeto do Jira a um Space do Sharkly e mantém as mudanças recentes conectadas. O Sync não importa dados históricos por conta própria.
- Import and then sync traz o histórico selecionado e pode habilitar a sincronização contínua com as credenciais já informadas no assistente.
Um vínculo de sincronização pareia um projeto do Jira com um Space do Sharkly. Um projeto do Jira pode ter apenas um vínculo ativo, embora vários projetos do Jira possam apontar para o mesmo Space. No modo bidirecional, issues e épicos do Jira sincronizam com Tasks e Projects do Sharkly nos dois sentidos, e novas Tasks e Projects no Space vinculado podem criar issues e épicos no Jira. Se você preferir manter o Jira como autoridade, o modo Jira to Sharkly cria e atualiza registros vinculados no Sharkly sem enviar novos registros de volta.
Duas observações operacionais que vale a pena conhecer antes de começar. A instalação automática de webhooks exige permissão de administração do Jira, e a ausência dessa permissão não bloqueia a conexão, mas impede que as mudanças do Jira cheguem. Excluir um vínculo interrompe a sincronização futura sem apagar nada de nenhum dos lados, o que torna o processo reversível caso você desista.
Para o fluxo no nível do ticket, nosso passo a passo sobre atribuir um ticket do Jira a um agente de IA cobre o ciclo de ponta a ponta.
Um exemplo prático
Uma equipe de pagamentos usa o Jira como padrão da empresa. O suporte abre a JIRA-4821: uma tempestade de retentativas de webhook está cobrando duas vezes um pequeno número de clientes.
O tech lead faz a triagem no Jira, define a prioridade e vincula o item ao épico de incidente. Como o Space vinculado sincroniza nos dois sentidos, o mesmo trabalho aparece no Sharkly como uma Task, com a descrição e os critérios de aceite intactos.
Aí o direcionamento fica específico. A Task vai para um Agent configurado para correções de backend: um papel definido, o repositório de pagamentos e o Claude Code como Runtime, rodando em um Computer conectado que já tem as credenciais de staging e a rota de VPN. Um segundo Agent cuida da cobertura de testes em um worktree isolado, para que os dois nunca toquem nos mesmos arquivos. Nosso guia sobre executar agentes em paralelo em worktrees isolados explica por que esse isolamento importa quando mais de um agente está trabalhando.
O agente lê a issue, reproduz a tempestade de retentativas com um replay local, propõe uma mudança na chave de idempotência, roda a suíte de testes e reporta o resultado. Tudo o que ele leu, tentou e no que falhou está na Task, no rastreamento, ao lado dos comentários. O líder revisa o diff, faz uma pergunta de acompanhamento em um comentário da Task — o que dispara outra execução — e então aprova.
O resultado volta para a JIRA-4821 para as pessoas que nunca saíram do Jira: o ticket é fechado, o relatório de sprint fica preciso e o suporte vê a resolução na ferramenta que já usa. Ninguém precisou mudar de lugar.
Sharkly vs. Jira: uma comparação justa
| Jira (com Rovo Dev e agentes atribuíveis) | Sharkly | |
|---|---|---|
| Papel principal | Sistema de registro para o trabalho de toda a organização | Camada de execução e revisão para People e Agents |
| Atribuição de agentes | Menu suspenso de responsável, agentes Rovo e agentes de terceiros compatíveis | Task atribuída a um Agent ou a um Crew |
| Onde os agentes rodam | Ambientes suportados pela Atlassian, incluindo CLI, Bitbucket Cloud, GitHub e VS Code | Computers que você conecta: máquina local, servidor remoto, contêiner ou host de nuvem compatível |
| Escolha de runtime | Os agentes que o Jira suporta | O Runtime detectado nesse Computer, incluindo um Runtime ACP personalizado que você configura |
| Cobrança de modelos | Por meio do seu plano e dos créditos da Atlassian | Por meio das assinaturas ou chaves de API já configuradas nas suas ferramentas |
| Registro de execução | Histórico do item de trabalho e PRs vinculados | Task com estado de execução, rastreamento, resultado e comentários |
| Hosts multiplataforma | Gerenciados pela Atlassian | Instaladores para macOS, Linux e Windows do CLI e do serviço local |
| Relação | O registro sobre o qual todos reportam | Sincroniza nos dois sentidos com o Jira em vez de substituí-lo |
Erros comuns
Tratar isso como uma migração. O erro mais comum é enxergar a execução de agentes como motivo para deixar o Jira. O financeiro, o suporte e outras três equipes leem esses relatórios. Sincronize, não expulse.
Pular a conversa sobre webhooks. O vínculo com o Jira precisa de permissão de administrador para instalar o webhook automaticamente. Se você não tem essa permissão, entregue cedo o pacote de configuração única a um administrador do Jira, em vez de ficar depurando o silêncio depois.
Apontar vários projetos do Jira para um mesmo Space sem querer. Um projeto do Jira pode ter apenas um vínculo ativo com um Space, e o pareamento não pode ser alterado depois de criado. Defina o mapeamento antes de criar os vínculos, porque corrigir isso significa excluir e recriar.
Atribuir trabalho que não está pronto para agentes. Um ticket que diz “corrija o bug de pagamentos” gera uma execução ruim, seja qual for a plataforma. Os critérios de aceite são o que faz a diferença — a mesma disciplina que bons tickets sempre exigiram. Nosso panorama sobre gestão de projetos com agentes de IA aborda o que muda quando o responsável não é uma pessoa.
Conclusão
O Jira responde “qual trabalho existe e quem é o dono dele”. Com o Rovo Dev e agentes atribuíveis, ele agora também responde parte de “quem faz o trabalho”, dentro dos ambientes que a Atlassian suporta. Se isso cobre a sua stack, está resolvido, e você pode parar de ler posts comparativos.
O Sharkly responde a uma pergunta diferente: onde a execução de agentes acontece quando ela precisa das suas máquinas, dos seus runtimes e do seu gate de revisão, e como esse registro continua legível para a equipe. Ele não substitui o Claude Code nem o Codex, e também não substitui o Jira. Ele adiciona a task compartilhada, o Computer conectado, o contexto, o controle e a camada de revisão em torno das ferramentas que sua equipe já usa, e depois sincroniza o resultado de volta para o ticket que todos os outros leem.
Se é essa lacuna que você está sentindo, comece pelo Sharkly e conecte um projeto do Jira a um Space antes de mexer em qualquer outra coisa.
FAQ
O Sharkly substitui o Jira? Não. Ele se conecta ao Jira por importação, sincronização unidirecional ou sincronização bidirecional. Excluir um vínculo interrompe a sincronização futura sem apagar issues do Jira, épicos do Jira, Tasks do Sharkly ou Projects do Sharkly.
Posso manter o Jira como fonte da verdade? Sim. A direção Jira to Sharkly cria ou atualiza registros vinculados no Sharkly sem criar novos registros no Jira a partir do Sharkly. Atualizações compatíveis em registros já vinculados ainda podem ser gravadas de volta.
Isso funciona com Jira auto-hospedado? Tanto o Jira Cloud quanto o Jira Server ou Data Center são suportados. Instalações Server e Data Center também expõem uma opção de proxy de rede privada que o Jira Cloud não exibe.
E os custos de modelo? O uso de modelos continua por meio das assinaturas ou chaves de API configuradas nas suas ferramentas de codificação. A cota de modelos depende das ferramentas de codificação com IA, dos planos e das contas de API que sua equipe conectar.
Quais agentes o Jira consegue atribuir nativamente? Agentes Rovo e agentes de terceiros compatíveis, como o agente de codificação do GitHub Copilot, selecionados no menu de responsável do item de trabalho. Consulte a documentação atual da Atlassian, pois a lista de compatibilidade muda.
Preciso das duas ferramentas para começar? Não. Você pode rodar o Sharkly com os próprios Spaces dele primeiro e conectar o Jira depois. Equipes que já vivem no Jira costumam achar a sincronização mais fácil de justificar quando um squad já tem um ciclo de agentes funcionando. Nossa comparação de alternativas ao Jira para equipes de humanos e agentes cobre o caso em que o Jira ainda não está enraizado.


