
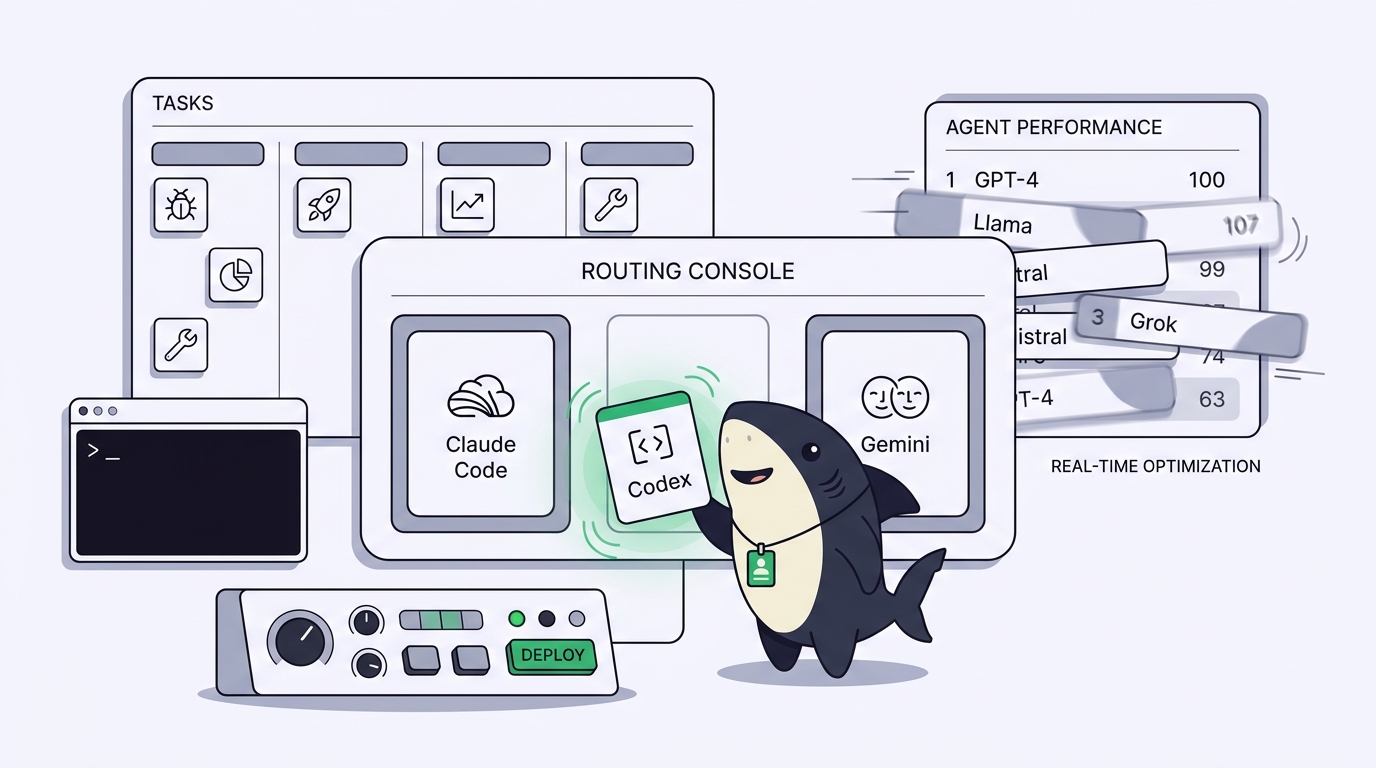
Você está tentando escolher o melhor agente de código. Lê o leaderboard, assiste aos posts de lançamento, roda o mesmo prompt no Claude Code, no Codex e no Gemini CLI para ver qual parece mais afiado. Aí sai um modelo novo, o ranking se reorganiza, e o agente que você padronizou no mês passado de repente está no meio da tabela. Então você troca de novo.
A parte incômoda é esta: o agente que você escolhe muda menos a sua semana do que você imagina. O que decide quanto trabalho você de fato entrega é o que acontece ao redor do agente. Qual agente está em qual tarefa, o que terminou, o que falhou, o que está esperando você revisar. A maioria dos desenvolvedores sente o chamado do ranking e nunca percebe que o ranking nunca foi o gargalo.
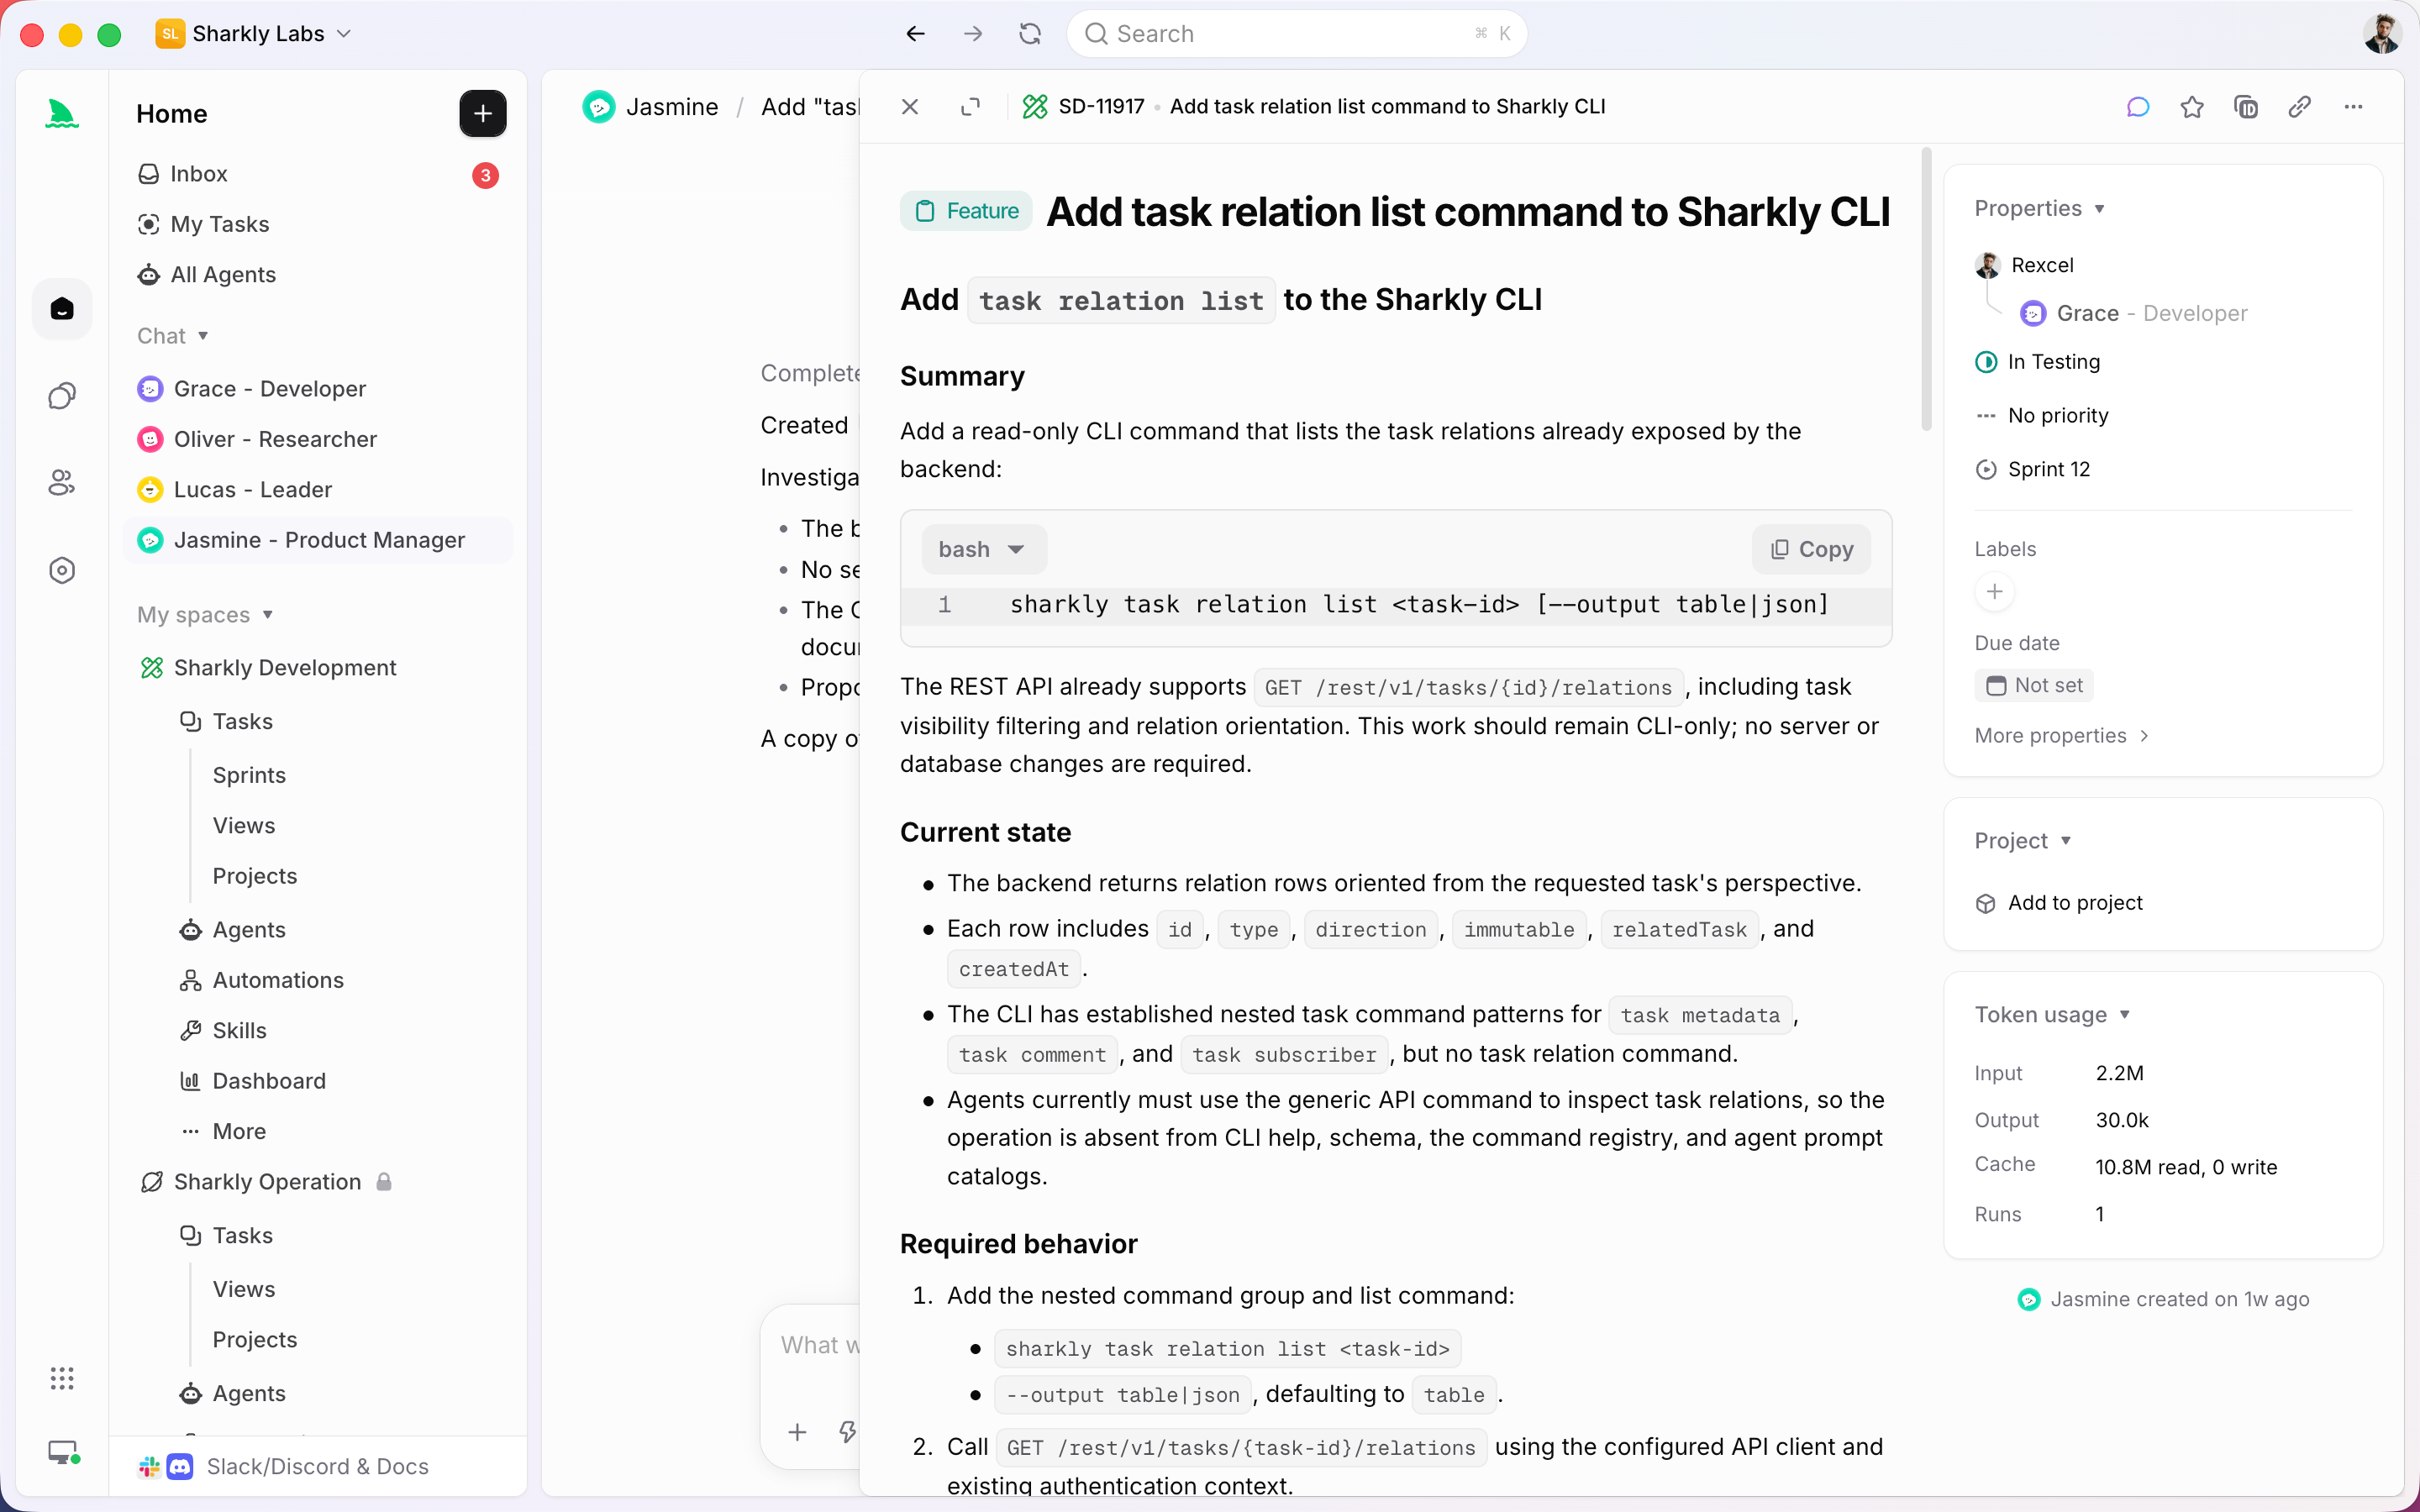
A Sharkly foi construída sobre essa observação. A Sharkly é uma plataforma tudo-em-um de comando e gestão de Agentes: você conecta o seu próprio Computador, atribui uma Tarefa a qualquer Agente que já use, e cada execução devolve o seu diff, a sua saída de testes e a sua revisão em um único lugar. Ela fica acima dos agentes, não ao lado deles. Este artigo mostra por que a camada de gestão determina o que você entrega mais do que o modelo, e o que fazer a respeito neste trimestre em vez de correr atrás do próximo leaderboard.
O melhor agente é um alvo móvel
Um leaderboard de agentes de código mede um conjunto fixo e compartilhado de problemas em um momento fixo no tempo. Os dois fatos envelhecem mal. O conjunto de problemas não é o seu código, e o momento não é o mês que vem.
Olhe o ritmo. Anthropic, OpenAI e Google lançaram, cada uma, várias atualizações de modelos com capacidade de agente de código no último ano, e o ranking relativo entre elas já virou mais de uma vez [VERIFY: a cadência exata de lançamentos e o ranking atual mudam a cada mês; confirme antes de citar números específicos]. Se você trata “usar o melhor agente” como uma decisão, está assinando um compromisso de refazer essa decisão toda vez que um laboratório lança algo. Cada troca traz um custo: nova configuração, novos arquivos de contexto, novos hábitos, um novo conjunto de modos de falha que o seu time precisa aprender.
Eis uma previsão, declarada como previsão. A diferença entre os principais agentes de código vai continuar diminuindo, não aumentando. Quando três agentes resolvem o mesmo bug no seu repositório, a pergunta deixa de ser “qual é o melhor” e passa a ser “para qual deles eu entrego esta tarefa específica, e como eu vejo o resultado”. O diferencial sai do modelo e vai para o fluxo de trabalho. Essa mudança já é visível na forma como os times falam sobre agentes; ela será o padrão antes de ser a exceção.
A defesa contra um alvo móvel não é mirar melhor. É um fluxo de trabalho que sobrevive ao alvo se mover. Comparar agentes no seu próprio código diz quais vale a pena rodar hoje; não te prende a essa resposta amanhã.
O que realmente determina o que você entrega
Faça as contas de onde uma tarefa passa o tempo. O agente gera um diff em minutos. Todo o resto — decidir qual agente fica com a tarefa, manter as mudanças dele isoladas dos outros quatro agentes, descobrir que ele travou numa etapa de build, ler o que ele produziu, aceitar ou rejeitar — é a parte que consome o seu dia. Nada disso é uma propriedade do modelo.
Este é o problema de gestão, e ele aparece no momento em que você roda mais de um agente. Qual agente está trabalhando em quê? Qual deles deve receber a próxima tarefa? O que terminou, o que falhou, o que precisa que um humano olhe? Como impedir que três agentes editando um mesmo repositório mexam nos mesmos arquivos? Quanto mais capaz fica cada agente individual, mais deles você roda ao mesmo tempo, e mais afiadas ficam essas perguntas.
A Sharkly responde a essas perguntas como uma camada, não como uma ferramenta. Uma Tarefa é a unidade principal de trabalho: você a atribui a um Agente, o Agente roda em um Computador conectado, em um worktree isolado, e execução, bloqueios, resultados e acompanhamento voltam todos para a Tarefa. O agente que fez o trabalho é uma configuração da Tarefa, não a arquitetura de toda a sua operação. Troque o Claude Code pelo Codex na próxima tarefa e nada mais do seu processo muda. É isso que a neutralidade de fornecedor te dá: o seu fluxo de trabalho sobrevive a qualquer agente que esteja ganhando no momento.
A capacidade de revisão é o verdadeiro teto
Um agente que imprime “concluído” não entregou nada. Um humano ainda precisa ler o diff, checar os testes e decidir. Essa etapa de revisão, e não a geração de código, é o limite que quase todo time encontra primeiro.
A conta é crua. Se um agente produz um dia de trabalho revisável em vinte minutos, cinco agentes produzem cinco dias de revisão nos mesmos vinte minutos, e você continua com um único par de olhos. Um agente mais rápido ou mais inteligente piora isso, não melhora, porque enche a sua fila mais rápido. Escolher o melhor agente otimiza a etapa que nunca foi o gargalo e deixa o gargalo real intocado. A capacidade de revisão é o limite real de quanto trabalho paralelo de agentes um time consegue absorver, e nenhuma atualização de modelo muda essa aritmética.
Então o par de decisões que importa não é “Claude Code ou Codex”. É este: use um agente mais rápido quando a sua restrição é gerar um primeiro rascunho de mudança; invista no seu fluxo de revisão quando a sua restrição é decidir se uma mudança está correta. Para a maioria dos times que rodam agentes em paralelo, a segunda restrição aperta muito antes da primeira. A solução é tornar cada execução revisável com evidências no nível da tarefa: um diff, saída de typecheck e de testes, um resumo das mudanças e os limites que o próprio agente admite, tudo em um só lugar em vez de espalhado por terminais.
É aqui que o contrato humano-agente se paga. Agentes pesquisam, executam, testam e reportam. Pessoas definem a direção, concedem autoridade e aceitam o resultado. A automação para onde o julgamento do time é necessário. Um agente melhor faz mais da primeira frase; não faz nada da segunda. O teto está do seu lado dessa linha.
Faça da escolha do agente uma configuração, não uma arquitetura
Aqui está o limite, dito de forma clara para que ninguém presuma errado: a Sharkly não é um agente de código nem um substituto do Claude Code, do Codex ou de qualquer runtime. Ela não escreve código melhor do que eles. Ela adiciona a camada compartilhada de Tarefa, Computador, contexto e revisão em volta das ferramentas que o seu time já usa.
Essa distinção é o ponto central. Quando a escolha do agente é uma configuração, testar um agente novo custa uma tarefa, não uma migração. Você conecta o runtime, atribui a ele um requisito real e lê o que volta, ao lado dos resultados do agente que você usou ontem. Quando a escolha do agente está embutida na sua arquitetura, todo experimento é caro e cada reorganização do leaderboard é uma ameaça.
Seja honesto sobre quando você não precisa disso. Se você usa apenas um agente de código e vive feliz em um único terminal, uma sessão bem ajustada do Claude Code no próprio worktree basta, e a camada de gestão é custo extra que você pode pular. A equação muda no momento em que você roda dois ou mais agentes, em mais de uma tarefa ou repositório, e quer os resultados em um formato que um colega consiga ler sem você narrar o seu scrollback. Esse é o limiar em que a gestão de agentes de código se torna uma camada de que você realmente precisa, e não apenas uma boa ideia.
O que fazer de diferente neste trimestre
Pare de passar a semana correndo atrás do ranking. Passe-a construindo a camada que transforma o ranking em um detalhe.
Três movimentos concretos. Primeiro, escolha seus agentes do jeito mais sem graça possível: rode dois deles em uma tarefa real do seu backlog e fique com o que se sai melhor no seu código, sabendo que você vai revisitar essa escolha. Segundo, meça a sua taxa de revisão com honestidade; se os agentes terminam mais rápido do que você consegue aceitar o trabalho deles, a próxima atualização de agente não vai te ajudar, mas um fluxo de revisão melhor vai. Terceiro, pare de fixar um único agente no seu processo. Encaminhe o trabalho por uma camada que trate o agente como intercambiável, para que o próximo lançamento de modelo seja uma opção que você testa, não uma reconstrução que você teme. Se você ainda está decidindo qual modelo apontar para cada agente, combinar modelos com papéis de agente é um uso melhor de uma tarde do que ficar atualizando um leaderboard.
Se você quer continuar usando vários agentes de código em vez de se comprometer com um único ecossistema, esse é o problema em torno do qual a Sharkly foi projetada. Baixe a Sharkly, conecte um Computador e atribua a mesma tarefa real a dois agentes. O melhor vai mudar. A forma como você os gerencia não precisa mudar.


