
การจัดการโปรเจกต์แบบ Agentic ขายง่ายและขายเกินจริงก็ง่าย ข้อเสนอขายเขียนเองได้เลย: งานถูกมอบหมายให้ agent หลายตัวทำงานพร้อมกัน บอร์ดอัปเดตตัวเอง และทีมของคุณส่งงานได้มากขึ้น หลายส่วนในนั้นทำได้จริง ส่วนที่ทำไม่ได้ก็คือส่วนที่ไม่มีใครใส่ลงในสไลด์ และมันเฉพาะเจาะจงพอที่จะวางแผนรับมือได้
นี่คือเวอร์ชันตรงไปตรงมา สิ่งที่แนวปฏิบัตินี้ให้คุณได้จริง ค่าใช้จ่ายที่ต้องจ่าย และจุดที่มันหยุดทำงานไม่ว่าโมเดลจะเก่งแค่ไหน ถ้าคุณต้องการคำนิยามและลูปการทำงานก่อน คู่มือของเราเกี่ยวกับ การจัดการโปรเจกต์ด้วย AI agent อธิบายกลไกไว้ ส่วนบทความนี้สมมติว่าคุณรู้ภาพรวมแล้วและกำลังตัดสินใจว่าจะลงมือจริงหรือไม่ Sharkly ถูกสร้างมาเพื่อแนวปฏิบัตินี้ จึงเป็นเหตุผลที่ส่วนข้อจำกัดด้านล่างถูกเขียนไว้ตรง ๆ ไม่มีการทำให้ดูเบาลง
สรุปย่อ
การจัดการโปรเจกต์แบบ Agentic หมายถึงการรัน AI agent เป็นผู้ปฏิบัติงานที่ถูกติดตามและมอบหมายได้ภายในระบบงานจริง ไม่ใช่ในฐานะเครื่องมือส่วนตัว ประโยชน์ที่ยืนยันได้คือปริมาณงานที่ทำได้พร้อมกัน ร่องรอยของสิ่งที่เกิดขึ้นที่คงทน และการเปลี่ยนฝีมือการเขียน prompt ของนักพัฒนาคนหนึ่งให้กลายเป็นความสามารถของทีม ส่วนความเสี่ยงคือคอขวดในการรีวิว การทำงานอัตโนมัติที่ขอบเขตผลกระทบกว้างเกินคาด และการสับสนระหว่างการรันที่เสร็จสิ้นกับผลลัพธ์ที่ถูกต้อง ข้อจำกัดคือดุลยพินิจ: ทิศทาง อำนาจ และการยอมรับผลลัพธ์ยังคงอยู่กับคน และการทำงานอัตโนมัติไม่ว่าจะมากแค่ไหนก็ไม่สามารถเลื่อนเส้นนั้นได้
ประโยชน์ที่ยืนยันได้จริง
ปริมาณงานที่คุณมองเห็นได้จริง หลายงานทำงานพร้อมกันบนเครื่องที่เชื่อมต่อกัน โดยแต่ละงานอยู่ในไดเรกทอรีแยกของตัวเอง โดยไม่ต้องให้นักพัฒนานั่งเฝ้าแท็บเทอร์มินัล คู่มือของเราเกี่ยวกับagent แบบขนานใน worktree ที่แยกจากกันอธิบายว่าทำไมการแยกสภาพแวดล้อมจึงทำให้การทำงานแบบขนานปลอดภัย ไม่ใช่แค่ตื่นเต้น
ร่องรอยที่คงอยู่หลังการรัน บันทึกการทำงานบันทึกเหตุผลที่การรันถูกจัดคิว เวลาเริ่มและสิ้นสุด การเรียกใช้เครื่องมือ แหล่งที่มาของการทริกเกอร์ และรายละเอียดความล้มเหลว หกสัปดาห์ต่อมา บันทึกนั้นตอบคำถามที่บทสนทนาในแล็ปท็อปของใครสักคนตอบไม่ได้
ความสามารถที่อยู่ได้นานกว่าตัวคน agent คือการตั้งค่าที่บันทึกไว้: คำสั่ง runtime repository สภาพแวดล้อม การตั้งค่าการรัน และskillที่ผูกไว้ คนที่คิดวิธีรัน migration ที่ซับซ้อนได้จะทิ้งสิ่งที่ทีมมอบหมายได้ไว้เบื้องหลัง ไม่ใช่แค่ข้อความใน Slack
สถานะที่รายงานตัวเอง ความคืบหน้า อุปสรรค และผลลัพธ์ผูกติดกับงานทันทีที่เกิดขึ้น การประชุมประจำที่จุดประสงค์เดียวคือการรวบรวมสถานะจะสั้นลง และกล่องขาเข้าจะส่งต่อเฉพาะข้อยกเว้นที่ต้องให้คนจัดการจริง ๆ
ความเสี่ยงที่ไม่มีใครใส่ลงในสไลด์
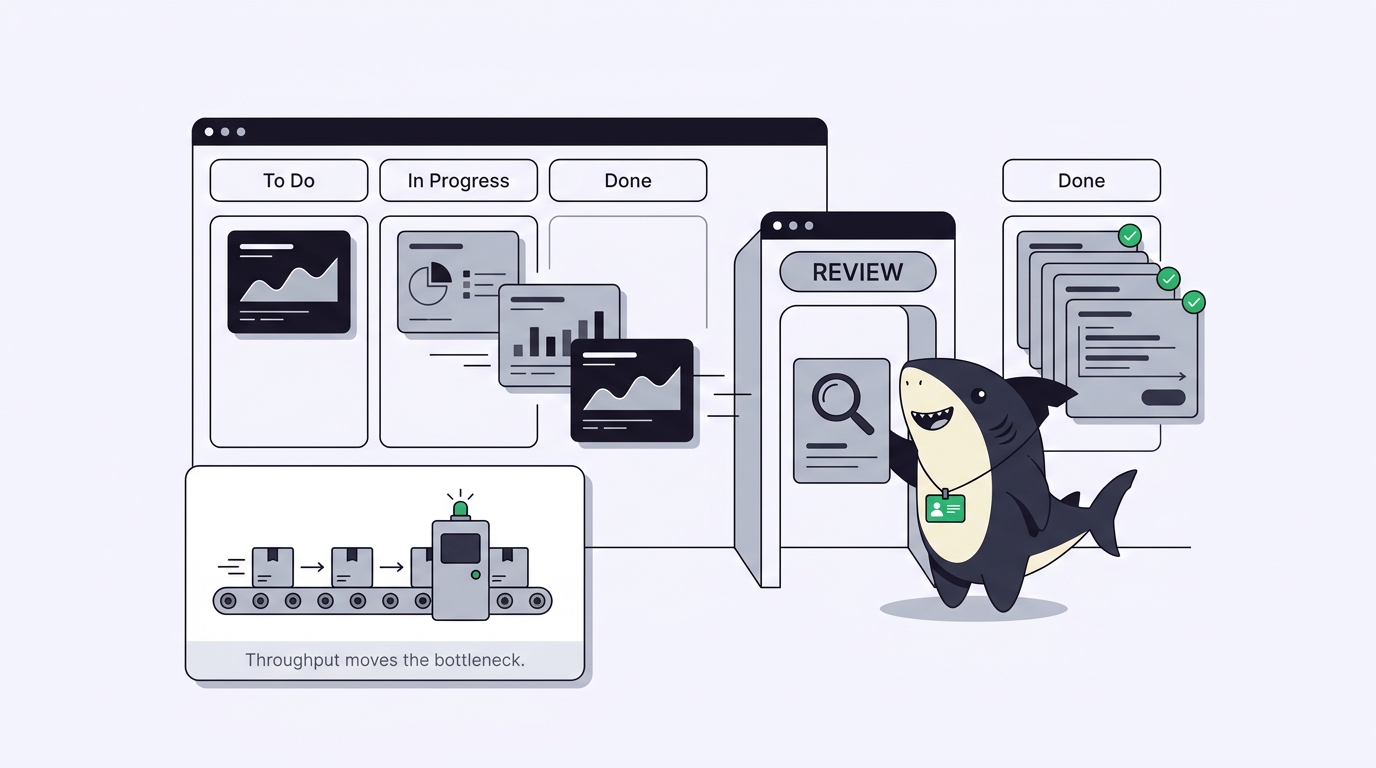
การรีวิวกลายเป็นคอขวดทันที agent ผลิตงานที่ต้องรีวิวได้เร็วกว่าที่มนุษย์อ่าน ทีมที่เพิ่ม agent สามตัวแต่ไม่เพิ่มกำลังในการรีวิวไม่ได้เพิ่มปริมาณงาน แต่แค่ย้ายคิว วัดว่าผลลัพธ์ใช้เวลานานแค่ไหนในสถานะรอรีวิวก่อนที่คุณจะเพิ่ม agent ตัวที่สี่
การรันที่เสร็จสิ้นไม่ใช่ผลลัพธ์ที่ถูกต้อง ข้อนี้ควรยกมาจากเอกสารผลิตภัณฑ์ เพราะเป็นรูปแบบความล้มเหลวที่กัดทีมหนักที่สุด: สถานะ "เสร็จสิ้น" อธิบายการรันอัตโนมัติ ไม่ใช่คำสัญญาว่าผลลัพธ์ทางธุรกิจปลายน้ำทุกอย่างถูกต้อง ยังต้องมีคนเปิดงานที่เชื่อมโยงและอ่านหลักฐานอยู่ดี
การทำงานอัตโนมัติมีขอบเขตผลกระทบกว้างเกินที่คนคาด ทริกเกอร์สถานะและทริกเกอร์คอมเมนต์อาจจับได้กว้างกว่าพื้นที่ที่คุณตั้งค่าไว้ ดังนั้นวลีทั่วไปอย่าง "please retry" หรือสถานะที่ใช้กันแพร่หลายอาจเริ่มการรันที่คุณไม่ได้ตั้งใจ ควรใช้นามแฝง slash command ที่เฉพาะเจาะจงหรือสถานะที่แคบ และเขียนคำสั่งที่ตรวจสอบงานที่ทริกเกอร์ก่อนทำการเปลี่ยนแปลง
หนี้จากการวินิจฉัยสะสม การรันที่ล้มเหลวส่งคืนข้อผิดพลาดจากผู้ให้บริการที่ดูเหมือนแทนกันได้แต่ไม่ใช่: 429 อาจหมายถึงคำขอมาถึงเร็วเกินไปหรือโควต้าหมด และวิธีแก้ตรงกันข้ามกัน 403 มักหมายถึงโมเดล องค์กร หรือภูมิภาคไม่ได้รับอนุญาต มากกว่าคีย์พิมพ์ผิด ทีมที่มองทุกความล้มเหลวว่า "ลองใหม่สิ" จะเสียเวลาหนึ่งสัปดาห์กว่าจะค้นพบเรื่องนี้
ขอบเขตงานที่เขียนไว้กลายเป็นเรื่องสำคัญมาก agent ได้บริบทเท่าที่คุณบันทึกไว้เท่านั้น เกณฑ์การยอมรับที่คลุมเครือเคยมีต้นทุนแค่บทสนทนา ตอนนี้มันมีต้นทุนเป็นการรัน การรีวิว และการเขียนใหม่
การกระจายสิทธิ์เกินขอบเขต ทุก agent ที่เข้าถึง repository เครื่อง และชุดข้อมูลรับรองได้ คือช่องทางเข้าสู่สภาพแวดล้อมของคุณ จำกัดขอบเขต agent ให้เข้าถึงเฉพาะ repository และคอมพิวเตอร์ที่งานต้องใช้ และเก็บ webhook URL กับ signing secret ออกจาก source control และช่องสาธารณะ
| ประโยชน์ | ความเสี่ยงที่คู่กัน | การควบคุมที่ทำให้ยังซื่อตรง |
|---|---|---|
| ปริมาณงานแบบขนาน | คิวรีวิวโตขึ้นอย่างเงียบ ๆ | จำกัดงาน agent ที่ค้างอยู่ต่อผู้รีวิวหนึ่งคน |
| สถานะที่รายงานตัวเอง | สถานะการรันถูกอ่านเป็นสถานะโปรเจกต์ | แยกสถานะวงจรชีวิตกับสถานะการรันออกจากกัน |
| การทำงานอัตโนมัติของงานประจำ | ทริกเกอร์ทำงานกว้างเกินที่ตั้งใจ | วลีที่เฉพาะเจาะจง สถานะที่แคบ ตรวจสอบในคำสั่ง |
| ร่องรอยการทำงานที่คงทน | ไม่มีใครอ่าน | กำหนดให้ต้องมีหลักฐานในขั้นตอนการยอมรับ |
| การตั้งค่า agent ที่ใช้ซ้ำได้ | คำสั่งที่ล้าสมัยอยู่ได้นานกว่าผู้เขียน | รีวิวคำนิยาม agent ตามกำหนดเวลา |
ข้อจำกัด: จุดที่แนวปฏิบัติหยุด
ข้อจำกัดสามข้อเป็นเชิงโครงสร้าง ไม่ใช่ชั่วคราว
ความรับผิดชอบมอบหมายต่อไม่ได้ agent ได้รับมอบหมายให้ปฏิบัติงานและได้รับเครดิตจากงานได้ แต่มันไม่สามารถรับผิดชอบต่อผลลัพธ์ได้ ให้มีชื่อคนที่รับผิดชอบในทุกงาน ในฟิลด์ที่แยกจากผู้รับผิดชอบการปฏิบัติงาน ไม่งั้นบอร์ดของคุณจะเต็มไปด้วยงานที่ไม่มีใครถูกถามได้
ความคลุมเครือทำให้เป็นอัตโนมัติไม่ได้ งานที่ต้องเลือกระหว่างสองทางที่สมเหตุสมผลทั้งคู่ ชั่งน้ำหนักความสัมพันธ์กับลูกค้า หรือยอมรับการแลกเปลี่ยนด้านความปลอดภัย ไม่ได้ช้าเพราะมีคนทำอยู่ แต่มันคือการตัดสินใจ และการส่งต่อให้ agent ก็เปลี่ยนการตัดสินใจให้กลายเป็นการเดาพร้อมคำอธิบายที่ฟังดูสมเหตุสมผล
สถานะสิ้นสุดไม่ใช่ปุ่มเลิกทำ การย้ายงานไปยัง "เสร็จสิ้น" ทำให้มันเป็นสถานะสิ้นสุดแต่ไม่ได้ยกเลิกการรันที่ยังทำงานอยู่ ส่วนสถานะ "ยกเลิก" และ "ซ้ำ" หยุดการรันที่ทำงานอยู่ได้ การรู้ว่าการคลิกของคุณทำอะไรกันแน่คือความแตกต่างระหว่างการหยุดงานกับการแค่เปลี่ยนป้ายชื่อ
หน้าตาบนบอร์ดจริงเป็นอย่างไร
ทีมหกคนรันหนึ่งพื้นที่ทำงานกับ agent สี่ตัว งานอัปเดต dependency การคัดแยก flaky test และการประกอบ changelog ถูกมอบหมายให้ agent โดยค่าเริ่มต้น งานฟีเจอร์มอบหมายให้คน ซึ่งบางครั้งส่งงานบางส่วนที่ขอบเขตชัดเจนให้ agent หลังจากดีไซน์ลงตัวแล้ว
กฎสองข้อทำงานหนักที่สุด ทุกงานที่ agent ปฏิบัติต้องระบุชื่อคนที่ยอมรับผลลัพธ์ และไม่มีงาน agent ไหนส่งได้โดยไม่มีใครอ่านบันทึกการทำงานควบคู่กับ diff automationรายสัปดาห์โพสต์สรุปการรันที่ล้มเหลว ซึ่งเป็นสิ่งที่ใกล้เคียงที่สุดที่ทีมมีต่อการตรวจสุขภาพการตั้งค่าของตัวเอง
การเปลี่ยนแปลงที่มองเห็นได้หลังหนึ่งเดือนไม่ใช่ "โค้ดมากขึ้น" แต่เป็นว่างานประจำที่น่าเบื่อหยุดแย่งความสนใจกับงานฟีเจอร์ และทีมตอบได้ว่า agent ทำอะไรและใครยอมรับ โดยไม่ต้องถามใคร
นำมาใช้โดยไม่เก็บความเสี่ยงมากอง
เริ่มจากงานที่สังเกตได้และย้อนกลับได้ และรีวิวหลายรอบก่อนขยายขอบเขต เลือกงานประเภทหนึ่งที่ทำซ้ำ กำหนดผลลัพธ์เป็นลายลักษณ์อักษรและขั้นตอนรีวิว แล้วรันหนึ่งสัปดาห์กับสองคน ทดสอบทริกเกอร์ automation แต่ละตัวแยกกัน และรัน automation ด้วยมือก่อนพึ่งพาตารางเวลา
จากนั้นตรวจสอบตัวเลขสามตัวก่อนขยาย: เวลาจากการรันเสร็จถึงการตัดสินใจของคน สัดส่วนการรันที่ต้องเขียนใหม่เพราะขอบเขตบางเกินไป และความถี่ที่ความล้มเหลวถูกวินิจฉัยถูกต้องในการลองครั้งแรก สามตัวนี้บอกคุณว่าแนวปฏิบัติได้ผลดีกว่าที่เรื่องเล่าจะบอกหรือไม่ บทเรียนแบบทีละขั้นของเราเกี่ยวกับการจัดการโปรเจกต์ด้วย Claude Codeแสดงลูปตั้งแต่ต้นจนจบในงานเดียว และ Sharkly จัดแพ็กเกจให้ถ้าคุณไม่อยากประกอบเอง
คำถามที่พบบ่อย
การจัดการโปรเจกต์แบบ Agentic เป็นแค่ automation ที่เปลี่ยนชื่อหรือเปล่า? ไม่ใช่ automation รันขั้นตอนที่กำหนดไว้ล่วงหน้า การจัดการโปรเจกต์แบบ Agentic มอบหมายผลลัพธ์ให้ผู้ปฏิบัติงานที่ตัดสินใจขั้นตอนเอง นี่คือเหตุผลที่การรีวิวและการยอมรับมีน้ำหนักมากกว่าใน automation แบบดั้งเดิม
ต้องเปลี่ยน Jira หรือ Linear ไหม? ไม่ต้อง ตัวเลือกนำเข้าและซิงค์มีอยู่เพื่อให้ tracker ที่องค์กรคุณใช้อยู่แล้วคงอยู่ต่อไป บทความทางเลือกแทน Jira สำหรับทีมที่ผสมคนกับ agentของเราครอบคลุมกรณีที่ tracker พร้อมจะถูกเปลี่ยนจริง ๆ
ทีมขนาดไหนได้ประโยชน์? สองคนกับ agent สองตัวก็เพียงพอที่จะรู้สึกถึงความแตกต่าง เพราะนั่นคือจุดแรกที่ใครสักคนรีวิวงานที่ตัวเองไม่ได้เริ่ม
ค่าใช้จ่ายในการรันเท่าไหร่? การใช้งานโมเดลยังคงผ่านการสมัครสมาชิกหรือ API key ที่ตั้งค่าไว้ในเครื่องมือเขียนโค้ดของคุณ ดังนั้นโควต้าขึ้นอยู่กับเครื่องมือ แพลน และบัญชีที่ทีมของคุณเชื่อมต่อ จัดสรรเวลาในการรีวิวให้จริงจังเท่ากับงบประมาณค่าโมเดล


