
คำตอบสั้น ๆ: ในการแก้ไข CI ที่ไม่ผ่านด้วย AI agent ให้ส่ง event ความล้มเหลวของ CI ไปยัง webhook จากนั้นให้ coding agent ตรวจสอบว่าปัญหาดังกล่าวอยู่ในขอบเขตที่สามารถแก้ไขได้หรือไม่ แล้วจำลองปัญหา (reproduce) ในเครื่องบน worktree ที่สะอาด ก่อนจะ push โค้ดที่แก้ไขแล้วไปยัง branch ในรูปแบบ draft pull request โดยมีคนคอย review และ merge หากจำลองปัญหาในเครื่องไม่ได้ ก็จะไม่มีการ push โค้ดเด็ดขาด
บิลด์ขึ้นสีแดงตอนสี่โมงเย็นมีต้นทุนสูงกว่าเวลาที่ใช้แก้จริง เมื่อมีใครสักคนต้องหยุดงานที่กำลังทำอยู่ เปิดดู log เลื่อนผ่านข้อความการตั้งค่ากว่า 900 บรรทัด แล้วพบเพียงข้อผิดพลาดของ linter หรือ snapshot ที่ไม่อัปเดต การแก้โค้ดใช้เวลาแค่สองนาที แต่การสลับบริบทการทำงาน (context switch) กลับกินเวลาไปถึงยี่สิบนาที
ช่องว่างตรงนี้คือจุดที่ coding agent เข้ามาแสดงความคุ้มค่า คุณอาจใช้งาน Claude Code, Codex หรือ agent ตัวอื่นบนเครื่องของคุณอยู่แล้ว สิ่งที่ยังขาดหายไปคือการเชื่อมต่อระบบ: นั่นคือกลไกที่ตรวจจับข้อผิดพลาด ส่งต่อไปยัง agent พร้อมบริบทที่ถูกต้อง และป้องกันไม่ให้ agent push โค้ดที่เกิดจากการเดาสุ่มเข้าไปใน repository คู่มือนี้จะพาคุณสร้างการเชื่อมต่อดังกล่าวด้วย GitHub Actions และ Automation ของ Sharkly ซึ่งโครงสร้างแบบเดียวกันนี้สามารถนำไปปรับใช้กับระบบ CI ใดก็ตามที่ส่ง HTTP request ได้
สิ่งที่ AI agent แก้ไขใน CI ได้ดี (และสิ่งที่ไม่ควรให้ทำ)
Agent ทำงานได้มีประสิทธิภาพที่สุดกับข้อผิดพลาดที่สามารถจำลองขึ้นใหม่บนแล็ปท็อปได้ และมีจุดแก้ไขขนาดเล็กที่ตรวจสอบความถูกต้องได้ชัดเจน แต่จะมีประสิทธิภาพต่ำที่สุดกับปัญหาที่เกี่ยวข้องกับโครงสร้างพื้นฐาน, ข้อมูล credential หรือบริการภายนอก ดังนั้นควรคัดแยกประเภทปัญหาก่อนเริ่มทำระบบอัตโนมัติ:
| ประเภทข้อผิดพลาด | ความเหมาะสมของ Agent | เหตุผล |
|---|---|---|
| ข้อผิดพลาดเกี่ยวกับ lint และ format | เหมาะสมมาก | ผลลัพธ์แน่นอนชัดเจน และ linter ยืนยันผลการแก้ไขได้ทันที |
| ข้อผิดพลาดด้าน Type | เหมาะสมมาก | คอมไพเลอร์ยืนยันผลการแก้ไขได้ทันที |
| Snapshot ไม่ผ่านหลังจากการตั้งใจเปลี่ยน UI | เหมาะสมดี | จำลองปัญหาได้ง่าย แต่มนุษย์ควรเป็นผู้ยืนยันว่าการเปลี่ยนแปลงนั้นเป็นไปตามที่ตั้งใจ |
| Flaky test | ก้ำกึ่ง | การจำลองปัญหาต้องรันซ้ำหลายรอบ และต้นเหตุที่แท้จริงมักเป็น race condition |
| Unit test ไม่ผ่านหลังปรับเปลี่ยน logic | ก้ำกึ่ง | Test อาจจะเขียนถูกต้องแล้ว แต่ตัวโค้ดต่างหากที่ทำงานผิด |
| ดิสก์ของ Runner เต็ม หรือเกิด network timeout | ไม่เหมาะสม | ไม่มีส่วนใดใน repository ที่ต้องแก้ไข |
| Secret ขาดหายหรือหมดอายุ, ปัญหาเรื่องสิทธิ์ (permission) | ห้ามเด็ดขาด | Agent ต้องไม่ยุ่งเกี่ยวกับ credential โดยเด็ดขาด |
กฎสำคัญที่ได้จากตารางนี้คือ Agent จะส่งมอบเฉพาะโค้ดแก้ไขที่มันได้เห็นผลการทดสอบเปลี่ยนจากสีแดงเป็นสีเขียวบน Computer ของตัวเองเท่านั้น บทความด้านการออกแบบที่ทีม DeepSeek Harness โพสต์บน X เรียกรูปแบบนี้ว่า “silently reproduce and fix” ซึ่ง trigger จะคอยตรวจจับเหตุการณ์ ไม่ส่งเสียงรบกวนโดยไม่จำเป็น และจะแจ้งเตือนขึ้นมาเฉพาะเมื่อมีวิธีแก้ปัญหาแบบง่ายที่ได้รับการยืนยันผลแล้วเท่านั้น แม้บทความดังกล่าวจะอธิบายถึงการออกแบบรุ่นต้นแบบ ไม่ใช่ผลิตภัณฑ์จริง แต่หลักการนี้สามารถนำไปปรับใช้กับระบบใดก็ตามที่คุณสร้างขึ้นเองได้
ลูปการแก้ไข CI ทำงานอย่างไร
ลูปนี้ประกอบด้วย 5 ส่วน ได้แก่ เหตุการณ์ความล้มเหลว (failure event), webhook ที่มีลายเซ็นกำกับ (signed webhook), ตัวกรองที่ประหยัดทรัพยากร (cheap filter), การจำลองปัญหาในสภาพแวดล้อมแยกเดี่ยว (isolated repro) และขั้นตอนการตรวจสอบโดยมนุษย์ (human review gate)
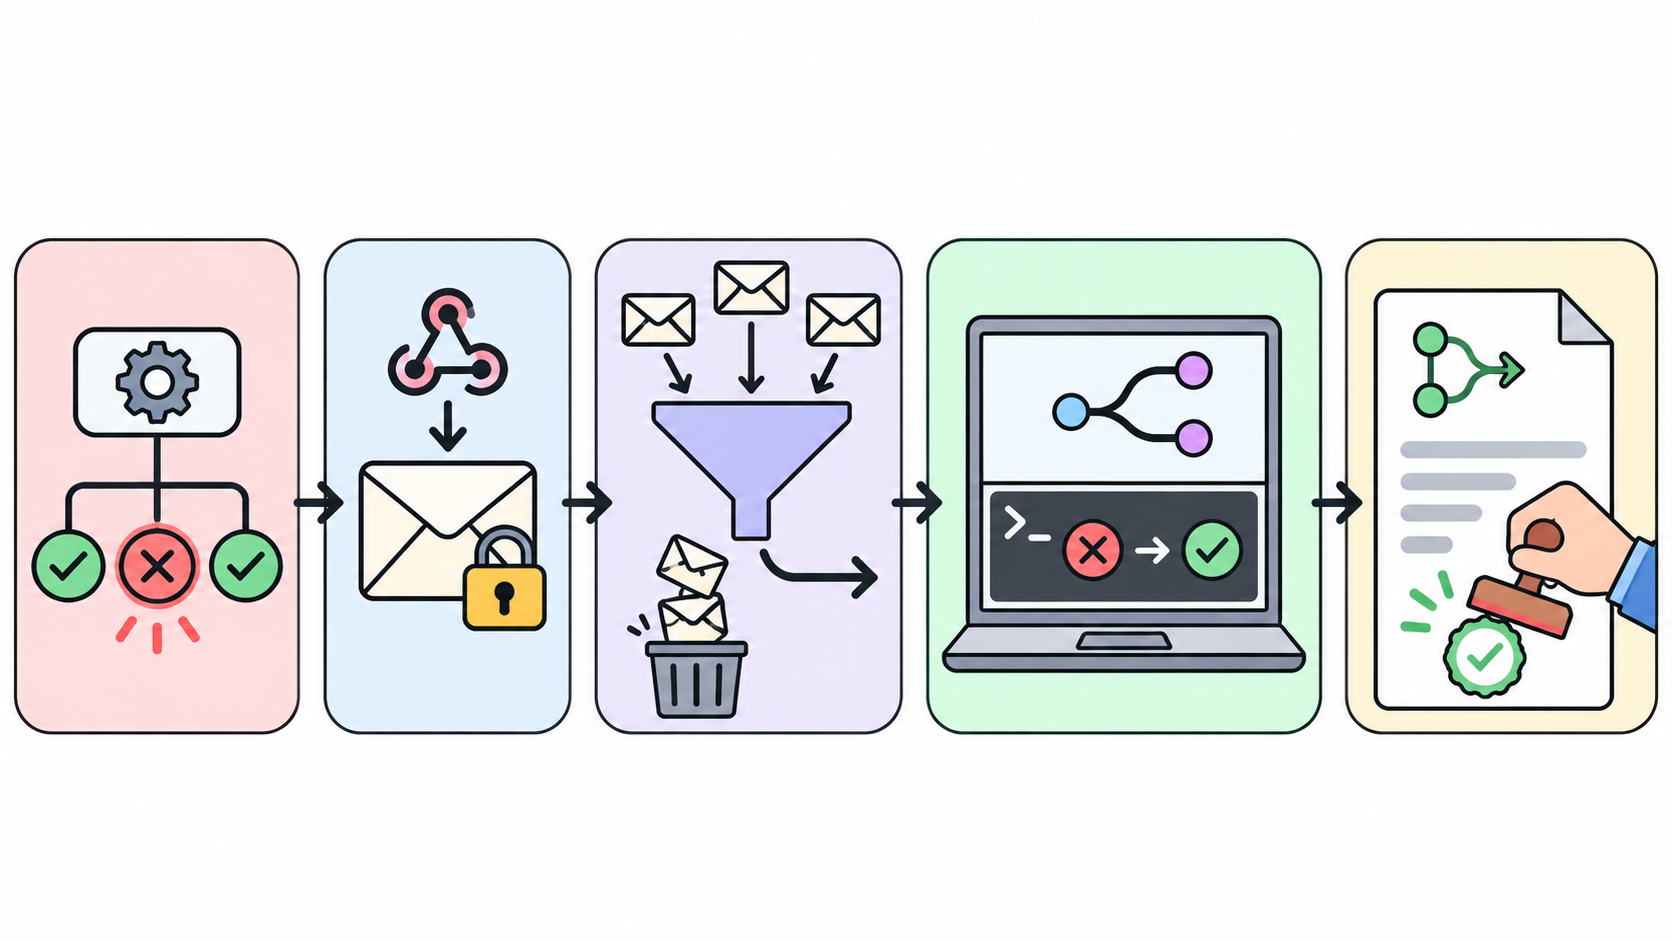
- CI ของคุณรันเสร็จสิ้นโดยมีสถานะล้มเหลว
- Workflow ขนาดเล็กจะส่งข้อมูล JSON ที่มีการลงลายเซ็นกำกับไปยัง URL ของ webhook
- Agent จะอ่านข้อมูลดังกล่าวและคัดทิ้งสิ่งที่ไม่เกี่ยวข้อง เช่น repository ที่ไม่ใช่เป้าหมาย หรือบิลด์ที่พังบน release branch
- Agent จะสร้าง task ขึ้นมา ทำการ checkout ไปยัง worktree ใหม่ จำลองข้อผิดพลาด และลงมือแก้ไข
- Agent จะ push branch ขึ้นไปและเปิด draft pull request จากนั้นมนุษย์จะเป็นผู้ merge หรือ close ต่อไป
ขั้นตอนที่ 3 และ 4 จะทำงานในรูปแบบ Sharkly Automation โดย Automation คือชุดคำสั่งที่บันทึกไว้พร้อมกับ Agent หรือ Crew ที่จะนำคำสั่งไปปฏิบัติ ซึ่งจะเริ่มทำงานตาม trigger ที่กำหนด เช่น ตามกำหนดเวลา, เมื่อสถานะ task เปลี่ยนแปลง, จากข้อความใน comment หรือผ่าน webhook
ขั้นตอนที่ 1: ส่งเหตุการณ์ CI ล้มเหลวไปยัง webhook
GitHub Actions มี event workflow_run ที่จะทำงานเมื่อ workflow อื่นทำงานเสร็จสิ้น โดยจะถูกเรียกในทุกผลลัพธ์การทำงาน ดังนั้นคุณจึงต้องกรองเฉพาะสถานะ failure ด้วยเงื่อนไขของ job แต่มีข้อควรระวังหนึ่งตามเอกสารของ GitHub คือ ไฟล์ workflow นี้ต้องอยู่ใน default branch เท่านั้น ไม่เช่นนั้นจะไม่ถูกทริกเกอร์เลย
Workflow นี้จะคอยตรวจจับ workflow ที่มีชื่อว่า CI จากนั้นจะสร้าง payload JSON ขนาดเล็ก ลงลายเซ็นกำกับ แล้วส่งออกไป:
name: Report CI failure
on:
  workflow_run:
    workflows: [CI]
    types: [completed]

jobs:
  notify:
    if: ${{ github.event.workflow_run.conclusion == 'failure' }}
    runs-on: ubuntu-latest
    steps:
      - name: Send signed webhook
        env:
          WEBHOOK_URL: ${{ secrets.SHARKLY_WEBHOOK_URL }}
          SIGNING_SECRET: ${{ secrets.SHARKLY_SIGNING_SECRET }}
          REPO: ${{ github.repository }}
          RUN_ID: ${{ github.event.workflow_run.id }}
          RUN_URL: ${{ github.event.workflow_run.html_url }}
          BRANCH: ${{ github.event.workflow_run.head_branch }}
          SHA: ${{ github.event.workflow_run.head_sha }}
        run: |
          BODY=$(jq -nc --arg repo "$REPO" --arg run_id "$RUN_ID" \
            --arg url "$RUN_URL" --arg branch "$BRANCH" --arg sha "$SHA" \
            '{event:"ci_failure",repo:$repo,run_id:$run_id,run_url:$url,branch:$branch,sha:$sha}')
          TS=$(date +%s)
          SIG=$(printf '%s\n%s' "$TS" "$BODY" \
            | openssl dgst -sha256 -hmac "$SIGNING_SECRET" -binary | base64)
          curl -fsS -X POST "$WEBHOOK_URL" \
            -H "Content-Type: application/json" \
            -H "X-Webhook-Timestamp: $TS" \
            -H "X-Webhook-Signature: v1=$SIG" \
            --data-raw "$BODY"
ชื่อ branch นั้นมาจาก contributors ดังนั้น workflow จึงส่งค่าผ่าน env และ jq แทนที่จะแปะลงไปในเชลล์สคริปต์ตรง ๆ และควรเก็บค่าทั้งสองไว้ในรูปแบบ encrypted repository secrets เสมอ ห้ามใส่ไว้ในไฟล์เด็ดขาด
ขั้นตอนที่ 2: สร้าง Automation และ Webhook Trigger
ใน Space ของคุณ ให้สร้าง Automation ขึ้นมา มอบหมายงานให้กับ Agent ที่ต้องการให้ทำการแก้ไขปัญหา และเพิ่ม trigger แบบ Webhook เข้าไป ทั้งนี้ Sharkly จะแสดง URL แบบเต็มเพียงครั้งเดียวตอนที่คุณสร้างหรือสร้าง trigger ใหม่ ดังนั้นให้คัดลอกไปใส่ไว้ใน GitHub secret ได้ทันที
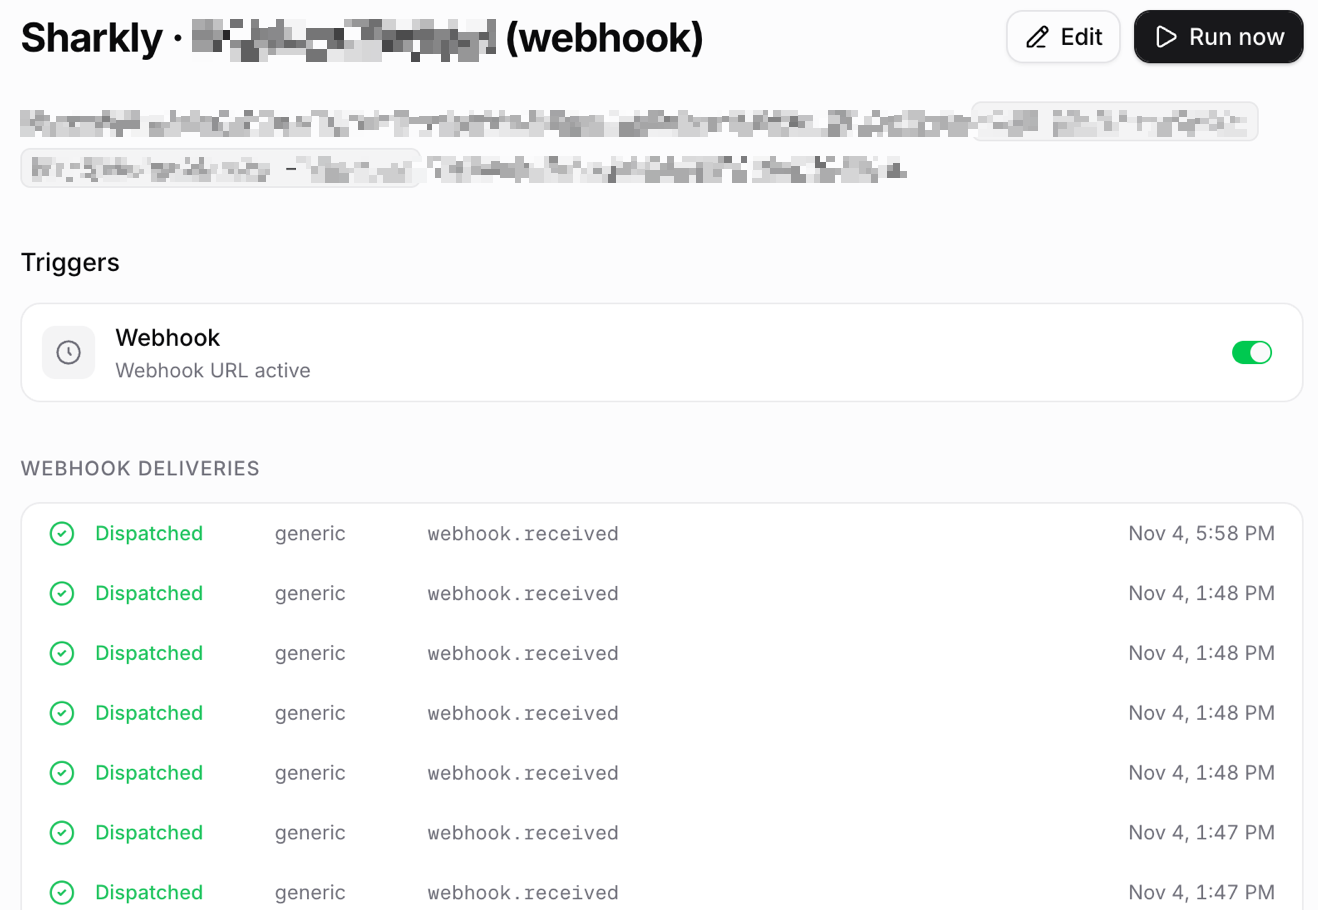
ให้เปิดใช้งาน signing secret เสมอ เพราะหากไม่มี URL ดังกล่าวจะทำงานเสมือนเป็น bearer secret ที่ใครก็ตามที่มี URL จะสามารถสั่งรันระบบได้ แต่หากเปิดใช้งาน ตามที่ระบุไว้ในเอกสารของ Automations ทุก request จะต้องแนบ header X-Webhook-Signature ที่ขึ้นต้นด้วย v1= ตามด้วย Base64 HMAC-SHA256 ที่คำนวณจาก timestamp, เครื่องหมายขึ้นบรรทัดใหม่ และ raw body โดยใช้ secret ที่ขึ้นต้นด้วย whsec_ เป็นคีย์ Sharkly จะปฏิเสธ timestamp ที่คลาดเคลื่อนเกิน 300 วินาที และจะยอมรับ signature หนึ่ง ๆ เพียงครั้งเดียวภายในช่วงเวลา 10 นาที ทำให้ไม่สามารถนำ request ที่ดักจับได้มาส่งซ้ำ (replay attack) ได้
คุณต้องเปิดใช้งาน trigger และตั้งค่าสถานะของ Automation ให้เป็น Active ก่อน จึงจะเริ่มรันจาก request ที่ถูกต้องได้ โดยแนะนำให้ทดสอบด้วยปุ่ม Run now ก่อนเป็นอันดับแรก
ขั้นตอนที่ 3: เขียนคำสั่งโดยเน้นการกรองก่อน แล้วค่อยลงมือแก้
การรัน Automation ผ่าน webhook จะไม่ได้สร้าง task ขึ้นมาโดยอัตโนมัติ และการรันนั้นไม่มี task ผูกไว้แต่แรก ดังนั้นชุดคำสั่งของคุณจึงควรสั่งให้เปิด task ขึ้นมา เพื่อให้ข้อผิดพลาดแต่ละรายการมีบันทึก มีเธรดสำหรับการสอบถาม และมีสถานะที่ทีมมองเห็นได้ ควรวางเงื่อนไขการตรวจสอบที่ใช้ทรัพยากรน้อยไว้ด้านบนสุด เพื่อให้เหตุการณ์ส่วนใหญ่จบกระบวนการได้ภายในเวลาไม่กี่วินาที:
You receive a CI failure webhook. The trigger payload is JSON with
event, repo, run_id, run_url, branch, sha.

1. Stop with no output unless event == "ci_failure" and repo is
   acme/web. Stop if branch starts with "release/".
2. Search open tasks for run_id. If one exists, stop.
3. File a task titled "CI fix: <repo> run <run_id>" with run_url in
   the body. Do all further work under that task.
4. Read the failed steps: gh run view <run_id> --log-failed
5. If the cause is a secret, permission, runner, or network problem,
   comment the diagnosis on the task and stop. Change nothing.
6. Check out sha in a fresh worktree. Run the failing command and
   confirm it fails the same way. If it does not reproduce, comment
   what you tried and stop. Never push an unreproduced fix.
7. Make the smallest change that fixes it. Do not edit CI config,
   lockfiles, or tests you were not asked to fix. Rerun the command
   and the nearest test suite.
8. Push to branch ci-fix/<TASK-ID> and open a draft PR with
   gh pr create --draft, task ID in the title. Comment the PR link
   on the task and hand it to a human for review.
มีรายละเอียดสำคัญสองจุดในส่วนนี้ ประการแรก ปัจจุบัน trigger จาก status และ comment จะตรวจจับครอบคลุมทั้งองค์กร ซึ่งเป็นเหตุผลที่เอกสารแนะนำให้ตรวจสอบความถูกต้องของ input ภายในชุดคำสั่ง แม้ว่า webhook จะผูกกับ URL เฉพาะ แต่ขั้นตอนที่ 1 ก็ยังช่วยป้องกันกรณีที่ request ถูกส่งมาผิดทางได้ ประการที่สอง task ID ในชื่อ branch มีประโยชน์อย่างมาก เพราะเมื่อเชื่อมต่อกับ GitHub integration แล้ว การระบุ task ID ในชื่อ branch, หัวข้อ PR หรือเนื้อหาของ PR จะช่วยลิงก์ pull request กลับมายัง task นั้นโดยอัตโนมัติ
ขั้นตอนที่ 4: รันบน Computer ใน worktree ที่แยกเดี่ยว
Computer คือโฮสต์ที่เชื่อมต่ออยู่ซึ่งเป็นที่ที่ Agent ของคุณทำงาน โดยจะมี Runtime, ไฟล์ และข้อมูล Git credential เป็นของตัวเอง ให้ตั้งค่า repository ของ Agent เป็นโหมด Temporary เพื่อให้การรันแต่ละครั้งมี directory สำหรับ task และ worktree แยกเป็นของตัวเองอย่างอิสระ เมื่อมีข้อผิดพลาดสองรายการเกิดขึ้นห่างกันเพียงหนึ่งนาที ไฟล์ของทั้งสองงานก็จะไม่ชนกัน สำหรับกลไกการทำงานอย่างละเอียด สามารถดูได้จากบทความเกี่ยวกับ การทำงานของ agent แบบคู่ขนานใน worktree ที่แยกเดี่ยว และ เอกสารอ้างอิง git worktree
สิทธิ์การเข้าถึง Git จะมาจากตัว Computer เอง ไม่ได้มาจาก GitHub App โดยตัว integration มีหน้าที่เพียงแค่เชื่อมโยง pull request และซิงค์ issue เท่านั้น ส่วนการ clone และ push ยังคงใช้ SSH key, HTTPS token หรือการล็อกอินผ่าน gh บนโฮสต์นั้น ควรกำหนดสิทธิ์ของ credential ดังกล่าวให้ push ได้เฉพาะ branch ย่อยเท่านั้น และตั้งค่า protect ให้กับ default branch เพื่อให้การ merge จำเป็นต้องผ่านการ review เสมอ
ค่าใช้จ่ายและแนวทางควบคุมความปลอดภัย
การรันแต่ละครั้งจะคิดค่าบริการตามแพ็กเกจของ Runtime นั้น ๆ โดยตรง เนื่องจาก Sharkly ไม่ได้จำหน่าย token ดังนั้นค่าใช้จ่ายในการแก้ไข CI แต่ละครั้งจึงเท่ากับค่าบริการ session ของ Claude Code หรือ Codex ตามระยะเวลาที่ใช้งานจริง การคัดกรองแบบรวดเร็วในขั้นตอนที่ 1 จึงเป็นวิธีหลักในการควบคุมค่าใช้จ่าย เพราะเหตุการณ์ที่ถูกตัดจบตั้งแต่ขั้นตอนที่ 1 จะใช้ token เพียงไม่กี่ร้อย token เท่านั้น ไม่ต้องเสียทรัพยากรไปกับการจำลองปัญหาทั้งหมด
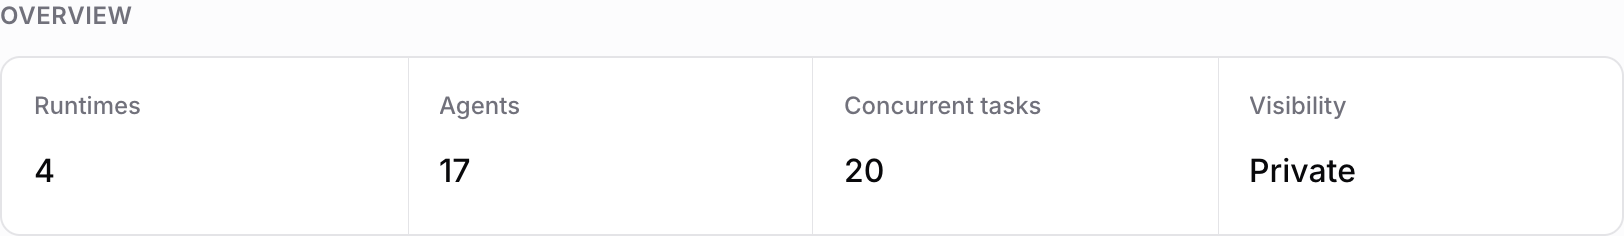
การจำกัดการทำงานพร้อมกัน (Concurrency) คือกลไกควบคุมตัวที่สอง โดย Computer แต่ละเครื่องจะมีขีดจำกัดจำนวน task ที่รันพร้อมกัน และการรันใน temporary directory จะถูกตั้งค่าเริ่มต้นไว้ที่ครึ่งหนึ่งของขีดจำกัดดังกล่าว เมื่อขีดความสามารถเต็ม การรันส่วนเกินจะถูกจัดเข้าคิวแทนที่จะแย่งทรัพยากรกันจนแล็ปท็อปค้าง เช้าวันแย่ ๆ ที่มีบิลด์สีแดงถึง 30 ตัวก็จะกลายเป็นคิวงานที่เป็นระเบียบ แทนที่จะกลายเป็นหายนะของระบบ
ส่วนที่เหลือคือกฎที่คุณกำหนดไว้เพียงครั้งเดียว:
- สร้างเป็น Draft PR เท่านั้น โดย agent จะไม่มีสิทธิ์ merge เด็ดขาด ดูรายละเอียดเกี่ยวกับจุดที่ควรวางขั้นตอนการตรวจสอบได้ที่ coding agent แบบ human-in-the-loop
- พยายามแก้เพียงครั้งเดียวต่อการรันหนึ่งรอบ หากการแก้ครั้งแรกยังไม่ผ่านการทดสอบซ้ำ agent จะเขียน comment แจ้งและหยุดทำงานทันที
- กำหนด Deny list (รายการที่ห้ามแตะต้อง): คอนฟิก CI, secrets, lockfile, ไฟล์ migration
- กด Pause ตัว Automation จากหน้าจัดการเมื่อมีการแก้ไขคำสั่ง และกลับมาเปิดใช้งานอีกครั้งหลังจากทดสอบด้วย Run now แล้ว
ตรวจสอบความถูกต้องก่อนที่จะไว้วางใจระบบ หลักการ plan, observe, verify loop สามารถนำมาใช้ได้ที่นี่ โดยควรอ่านและตรวจสอบประวัติการรันย้อนหลังสักหนึ่งสัปดาห์ ก่อนที่จะขยายขอบเขตไปยัง repository อื่น ๆ เพิ่มเติม
ทางเลือกอื่น
คุณสามารถเลือกสร้าง task สำหรับความล้มเหลวแต่ละครั้งแทนที่จะใช้ Automation ผ่าน webhook ได้ โดยกำหนดให้ workflow เรียกใช้สคริปต์ที่สั่งคำสั่ง sharkly task create จากนั้นให้ Agent ที่ได้รับมอบหมายมารับงานไป วิธีนี้จะสร้าง task ขึ้นมาสำหรับทุกบิลด์ที่ขึ้นสีแดง รวมถึงบิลด์ที่ agent ควรข้ามไปด้วย จึงเหมาะสำหรับ repository ที่มีปริมาณงานไม่มากนัก สำหรับทีมที่จัดการ issue ผ่าน GitHub อยู่แล้ว ก็สามารถเริ่มต้นได้จากแนวทาง การมอบหมาย GitHub issue ให้กับ AI agent
เริ่มต้นจาก repository เดียวก่อน
เลือก repository ที่พบปัญหา lint และ type บ่อยที่สุด เชื่อมต่อ workflow ตามขั้นตอนข้างต้น แล้วทดลองรัน Automation แบบแมนนวลสักสามครั้งก่อนจะเปิดให้ webhook ทำงาน เมื่อคุณพร้อมที่จะขยายการทำงานเกินกว่าหนึ่ง agent บทความ วิธีรัน AI coding agent 10 ตัวพร้อมกัน จะครอบคลุมเนื้อหาในส่วนที่เหลือ คุณสามารถเริ่มต้นใช้งาน Sharkly ได้ฟรี เพียงเชื่อมต่อ Computer แล้วปล่อยให้ agent ที่คุณมีอยู่จัดการกับบิลด์สีแดงตัวถัดไปได้เลย
คำถามที่พบบ่อย (FAQ)
AI agent สามารถแก้ไขบิลด์ CI ที่ไม่ผ่านได้ด้วยตัวเองหรือไม่?
สามารถแก้ไขข้อผิดพลาดประเภท lint, type และ snapshot ที่สามารถจำลองขึ้นใหม่ในเครื่องได้ แต่ไม่ควรปล่อยให้ทำการ merge เองโดยอัตโนมัติ โดยควรตั้งค่าผลลัพธ์ให้เป็น draft PR เสมอ เพื่อให้มนุษย์เป็นผู้ตรวจสอบและอนุมัติ
จะทริกเกอร์ AI agent ได้อย่างไรเมื่อ GitHub Actions ทำงานล้มเหลว?
เพิ่ม workflow ที่ดักฟัง event workflow_run โดยระบุ types: [completed] และใส่เงื่อนไขของ job เป็น conclusion == 'failure' ซึ่ง job นี้จะส่ง request ที่ลงลายเซ็นกำกับไปยัง URL webhook ของ agent
อะไรคือสิ่งที่ป้องกันไม่ให้ agent push โค้ดแก้ปัญหาที่ผิดพลาดขึ้นไป?
กฎการจำลองปัญหา (repro rule) กล่าวคือ agent จะต้องจำลองข้อผิดพลาดในเครื่องให้เห็นจริง ทำการแก้ไขโค้ด และเห็นคำสั่งเดิมรันผ่านสำเร็จ หากจำลองปัญหาไม่ได้ จะทำได้เพียงคอมเมนต์แจ้งบน task และจะไม่มีการ push โค้ดขึ้นไปเด็ดขาด
ระบบ GitHub integration ของ Sharkly สามารถเปิด pull request เองได้หรือไม่?
ไม่ได้ ตัว integration มีหน้าที่เชื่อมโยง pull request เข้ากับ task และซิงค์ issue เท่านั้น ส่วนการเปิด PR จะเป็นหน้าที่ของ agent โดยใช้ credential ของ Git และ gh ที่อยู่บน Computer ของตนเอง
แล้วกรณีที่เป็น Flaky test ล่ะ?
ควรกำหนดให้ agent รันแบบทดสอบที่ไม่ผ่านซ้ำหลาย ๆ ครั้งก่อนตัดสินใจ หากการทดสอบผ่านบ้างไม่ผ่านบ้าง agent ควรรายงานปัญหาความไม่เสถียรนี้ลงบน task แทนที่จะพยายามเขียนโค้ดแก้ปัญหาแบบหลบเลี่ยงไปเรื่อย
การรันเพื่อแก้ปัญหา CI มีค่าใช้จ่ายเท่าไหร่?
คิดตามจำนวน token ที่ Runtime ของคุณใช้งานใน session นั้น ๆ โดยการรันบน Sharkly จะเรียกเก็บเงินผ่านแพ็กเกจของ Claude Code, Codex หรือ API ของคุณเอง


