สรุปสั้น ๆ (TL;DR): GPT-6 Cyber คือโมเดลเวอร์ชันปรับแต่งเฉพาะทางด้านความปลอดภัยของ GPT-6 Astra จาก OpenAI ซึ่งเปิดตัวเมื่อวันที่ 5 พฤศจิกายน 2026 การเข้าใช้งานจำเป็นต้องมีสิทธิ์ระดับ Daybreak Red พร้อมทั้งผ่านการอนุมัติการใช้งานโมเดลแยกต่างหาก โดยมีราคาอยู่ที่ $20 ต่อ 1 ล้าน input token ทีมส่วนใหญ่ควรใช้โมเดลรุ่นทั่วไปในการตรวจสอบและคัดกรอง แล้วเก็บ GPT-6 Cyber ไว้ใช้พิสูจน์ช่องโหว่ความเสี่ยงสูงบนระบบที่ตนเองเป็นเจ้าของเท่านั้น
GPT-6 Cyber เข้ามาเปลี่ยนขั้นตอนสุดท้ายของการตรวจสอบความปลอดภัย ไม่ใช่ขั้นตอนแรก ประกาศของ OpenAI รายงานการค้นพบช่องโหว่ระดับร้ายแรงสูง (high-severity) ใหม่บน Firefox จำนวน 81 รายการ และโค้ดโจมตี (exploit) ที่ใช้งานได้จริงสำหรับบั๊กบนเคอร์เนล Linux อีก 948 รายการ ฟังดูแล้วเหมือนเป็นโมเดลที่น่าจับใส่เข้าไปในทุก Agent ที่คุณใช้งานอยู่
แต่เงื่อนไขการเข้าถึงไม่ได้เป็นเช่นนั้น คุณน่าจะยังเรียกใช้งานมันไม่ได้ในตอนนี้ และข้อมูลส่วนที่มีประโยชน์ที่สุดของการเปิดตัวครั้งนี้กลับอยู่ใน System Card นั่นคือ จุดที่โมเดลสามารถทำงานได้ตามขอบเขต และจุดที่รายงานของมันยังมีจุดตกหล่น
คู่มือนี้จะอธิบายว่าใครบ้างที่สามารถเข้าถึงได้, ค่าใช้จ่ายเท่าไร, วิธีจัดเส้นทางการทำงานด้านความปลอดภัยระหว่างโมเดลระดับต่าง ๆ และสิ่งใดที่ผู้ตรวจสอบของคุณควรตรวจสอบ หากคุณใช้งาน Agent หลายตัวอยู่แล้ว Sharkly ช่วยให้คุณมีศูนย์กลางในการจัดการงานและผลลัพธ์ของ Agent เหล่านั้นได้ในที่เดียว
GPT-6 Cyber คืออะไร?
GPT-6 Cyber คือโมเดลเฉพาะทางด้านความปลอดภัยไซเบอร์ที่พัฒนาต่อยอดมาจาก GPT-6 Astra ซึ่งสร้างขึ้นสำหรับงานด้านความปลอดภัยที่ได้รับอนุญาตโดยเฉพาะ เช่น การค้นหาช่องโหว่, การพัฒนาโค้ดโจมตี (exploit development) และการทดสอบเจาะระบบเว็บ (web penetration testing) โดย OpenAI ได้ทำการ Post-train ให้โมเดลปฏิเสธคำขอที่ได้รับอนุญาตน้อยลง และควบคุมให้อยู่ในขอบเขตที่คุณกำหนดอย่างเคร่งครัด ทั้งนี้ OpenAI จัดระดับความเสี่ยงของโมเดลนี้ไว้ในระดับวิกฤต (Critical) ด้านความปลอดภัยไซเบอร์ภายใต้กรอบการประเมินความพร้อม (Preparedness Framework)
โมเดลนี้ไม่ได้เป็น Agent สำหรับเขียนโค้ดทั่วไปที่เก่งขึ้นแต่อย่างใด ในการทดสอบ ExpertSWE ซึ่งเป็นการทดสอบภายในของ OpenAI สำหรับงานซอฟต์แวร์ระยะยาว โมเดลทำคะแนนได้ 82.95% เมื่อเทียบกับ Astra ที่ได้ 83.24% ดังนั้น สำหรับงานพัฒนาฟีเจอร์ทั่วไป คุณยังควรใช้ รันไทม์เริ่มต้น ต่อไปตามปกติ
ใครสามารถเข้าถึง GPT-6 Cyber ได้บ้าง?
การอนุมัติคือตัวตัดสินการเข้าถึง ไม่ใช่เรื่องงบประมาณ หน้าช่วยเหลือเกี่ยวกับ Daybreak ของ OpenAI ระบุไว้ว่า เพียงแค่มีสัญญาเชิงพาณิชย์หรือการซื้อเพียงอย่างเดียวนั้นไม่ได้รับประกันว่าจะได้รับสิทธิ์การใช้งาน
| ระดับการเข้าถึง | โมเดล | ลักษณะงานที่รองรับ |
|---|---|---|
| Standard | โมเดลหลักทั่วไป รวมถึง Astra พร้อมระบบป้องกันความปลอดภัยมาตรฐาน | การทำ Threat modeling, การรีวิวโค้ดอย่างปลอดภัย, การแพตช์ระบบ |
| Daybreak Blue | ลดอัตราการปฏิเสธคำขอบนโมเดลอย่าง GPT-6 Sol และ GPT-6 Luna ส่วน Astra ยังคงใช้ระบบป้องกันมาตรฐาน | การคัดกรองช่องโหว่, การวิเคราะห์มัลแวร์, การตอบสนองต่อเหตุการณ์ความปลอดภัย, การตรวจสอบความถูกต้องของแพตช์ |
| Daybreak Red | GPT-5.6 Cyber รวมถึงการลดอัตราการปฏิเสธคำขอบนโมเดลต่าง ๆ ซึ่งรวมถึง Astra | การทดสอบเจาะระบบ (Penetration testing), Red teaming, การทดสอบยืนยัน Exploit |
| Red พร้อมการอนุมัติ GPT-6 Cyber | gpt-6-cyber ผ่าน API และ Codex |
ลักษณะงานเดียวกันข้างต้น โดยใช้ GPT-6 Cyber |
มี 3 ประเด็นสำคัญที่มักทำให้หลายทีมตกม้าตาย:
- แค่ระดับ Red ยังไม่พอ: GPT-6 Cyber ต้องผ่านการอนุมัติเฉพาะตัวโมเดลแยกต่างหาก ปัจจุบันเปิดให้เฉพาะลูกค้า Red บางรายที่ได้รับเลือกเท่านั้น และ OpenAI ระบุว่าลูกค้า Red ทั้งหมดจะได้รับสิทธิ์ใน “เร็ว ๆ นี้”
- ไม่เปิดให้ผู้ใช้รายบุคคล: คุณสามารถสมัครระดับ Red ได้ในนามองค์กรธุรกิจหรือองค์กรระดับเอ็นเตอร์ไพรส์ที่ผ่านการรับรองแล้วเท่านั้น ส่วนผู้ที่สมัครรายบุคคลสามารถขอสิทธิ์ระดับ Blue ได้
- ทุกอย่างจะเริ่มต้นด้วยการปิดใช้งาน: หลังจากได้รับการอนุมัติแล้ว เจ้าของบัญชี (Owner) จะต้องเปิดใช้งาน Daybreak ให้กับผู้ใช้หรือโปรเจกต์ที่ระบุเจาะจง ส่วนการรัน Codex CLI แบบอัตโนมัติ (Unattended) จะต้องตั้งค่า
daybreak=trueบนเครื่องโฮสต์ที่ใช้รันด้วย
นอกจากนี้ องค์กรยังต้องมีระบบ SSO, MFA, อุปกรณ์ที่มีการจัดการดูแล (Managed devices) และการควบคุมสิทธิ์ตามหลัก Least Privilege โดยการใช้งาน API จะต้องมีการกำหนด IP allowlist เป็นค่าเริ่มต้น
GPT-6 Cyber มีค่าใช้จ่ายเท่าไร?
นี่คือราคา API มาตรฐานสำหรับ Short-context ของ OpenAI ต่อ 1 ล้านโทเค็น ตามที่มีการระบุไว้เมื่อวันที่ 6 พฤศจิกายน 2026:
| โมเดล | ขาเข้า (Input) | ขาออก (Output) | เงื่อนไขเพื่อลดการปฏิเสธคำขอ |
|---|---|---|---|
gpt-6-luna |
$0.10 | $0.50 | Daybreak Blue |
gpt-6.1-sol |
$2.00 | $10.00 | Daybreak Red |
gpt-6-astra |
$10.00 | $50.00 | Daybreak Red |
gpt-6-cyber |
$20.00 | $100.00 | Red พร้อมการอนุมัติโมเดล |
เมื่อเทียบราคาต่อโทเค็นแล้ว จะแพงกว่า Astra ถึง 2 เท่า และแพงกว่า Luna ถึง 200 เท่า เพื่อให้เห็นภาพขนาดการใช้งาน แคมเปญทดสอบบน Linux ที่สร้าง exploit ถึง 948 รายการ ใช้วงเงินเครดิต API ไปประมาณ 1.2 ล้านดอลลาร์ ซึ่ง OpenAI ระบุว่าเป็นตัวเลขที่ค่อนไปทางขอบเขตบน ดังนั้น อย่าเผลอใช้โมเดลราคาแพงที่สุดกับไฟล์ทุกไฟล์ในระบบ
สำหรับทีมตั้งรับที่มีข้อจำกัดด้านทรัพยากร เช่น หน่วยงานภาครัฐและผู้ให้บริการโครงสร้างพื้นฐานสำคัญ สามารถดูข้อมูลเกี่ยวกับ โครงการเงินสนับสนุนมูลค่า 1 พันล้านดอลลาร์ ของ OpenAI ซึ่งช่วยอุดหนุนค่าใช้จ่ายในการเข้าถึงได้
จุดที่ GPT-6 Cyber แสดงความคุ้มค่า
ควรเปรียบเทียบโมเดลนี้กับ Astra ไม่ใช่เทียบกับโมเดลรุ่นเก่าเพียงอย่างเดียว ตัวเลขเหล่านี้เป็นข้อมูลจาก OpenAI เว้นแต่จะระบุไว้เป็นอย่างอื่น:
| การทดสอบ | สิ่งที่วัดผล | GPT-6 Cyber | GPT-6 Astra |
|---|---|---|---|
| SEC-Bench Pro | การค้นหาบั๊กในเอนจิน JavaScript | 87.02% | 85.38% |
| Web pentest | ความครอบคลุมในการตรวจจับช่องโหว่บนเว็บ (Recall) | 40.3% | 32.0% |
| ExploitGym | การสร้างโค้ดโจมตีบั๊กที่กำหนด | 48.5% | 42.4% |
| RemoteExploitBench | การโจมตีจากระยะไกลสำหรับบั๊กที่ทราบข้อมูล | สำเร็จ 95% | ถูกปฏิเสธ 100% ภายใต้สิทธิ์ Blue |
| FrontierCyber (Irregular) | ซอฟต์แวร์และฮาร์ดแวร์ในโลกความเป็นจริง | 90 จาก 288 | 96 จาก 288 |
ในแง่ของการค้นหาบั๊ก ประสิทธิภาพที่เพิ่มขึ้นจาก Astra นั้นถือว่าไม่มากนัก โดยการประเมินภายนอกของ Irregular พบว่า Astra ทำผลงานได้ดีกว่าเล็กน้อยบน FrontierCyber ส่วน GPT-6 Cyber ทำได้ดีกว่าในสถานการณ์ที่ต้องวางแผนระยะยาว (long-horizon) และทั้งสองโมเดลไม่สามารถโจมตีเป้าหมายที่มีการป้องกันระดับสูง (hardened targets) ได้สำเร็จเลย ความแตกต่างที่ชัดเจนที่สุดจึงอยู่ที่ “การอนุญาต” กล่าวคือ GPT-6 Cyber สามารถสร้างโค้ดโจมตีที่ Astra มักปฏิเสธภายใต้ระดับ Blue ได้
OpenAI เองก็ยอมรับตรง ๆ ว่า โมเดลหลักทั่วไป “รองรับการตรวจสอบโค้ด, การคัดกรองช่องโหว่ และการพัฒนาแพตช์ได้อยู่แล้ว” ผลลัพธ์ในโลกความเป็นจริงก็สะท้อนให้เห็นการแบ่งบทบาทนี้เช่นกัน ตัวอย่างเช่น การค้นพบช่องโหว่ของ Mozilla มาพร้อมหลักฐานและชุดทดสอบที่สามารถทำซ้ำได้ และแคมเปญเดียวกันยังแสดงให้เห็นว่าปัญหาที่ทราบอยู่แล้ว 30 รายการมีความร้ายแรงมากกว่าที่เคยรายงานไว้ การพิสูจน์ระดับความรุนแรงของช่องโหว่นี่เองคือสิ่งที่คุณกำลังจ่ายเงินซื้อ
วิธีจัดเส้นทางการทำงานด้านความปลอดภัยระหว่าง Agent
ควรกำหนดเส้นทางการทำงานตามหลักฐานที่มี เพื่อให้แต่ละระดับรับเฉพาะงานที่โมเดลระดับราคาถูกกว่าไม่สามารถจัดการได้ แนวทางนี้เป็นคำแนะนำของเรา ไม่ใช่ข้อบังคับของ OpenAI:
- สแกนด้วยโมเดลหลัก: ให้ Agent ตรวจสอบความเปลี่ยนแปลงของโค้ด (diffs) และจุดเชื่อมต่อสาธารณะ (public entry points) จากนั้นจึงบันทึกรายการที่คาดว่าจะเป็นช่องโหว่
- คัดกรองภายใต้ Daybreak Blue: เขียนชุดทดสอบที่จำลองความล้มเหลว (failing test), กำจัดรายการซ้ำซ้อน และประเมินระดับช่องโหว่ตามแนวเขตความน่าเชื่อถือ (trust boundary) ที่ถูกข้ามผ่าน
- ยกระดับตามกฎเกณฑ์: ส่งต่อข้อค้นพบขึ้นไปก็ต่อเมื่อสามารถทำซ้ำได้, มีการข้ามผ่านแนวเขตความน่าเชื่อถือ และระดับความร้ายแรงขึ้นอยู่กับความสามารถในการใช้โจมตีจริง (exploitability)
- พิสูจน์ในสภาพแวดล้อมแยกเดี่ยว: ให้ GPT-6 Cyber ตรวจสอบยืนยันเส้นทางการโจมตีในสภาพแวดล้อมแบบใช้แล้วทิ้ง (disposable environment) โดยระบุเป้าหมายอย่างชัดเจน
- แพตช์ แล้วลองเจาะแพตช์นั้น: ให้ Agent ตัวแรกร่างโค้ดแก้ไขพร้อมชุดทดสอบ และให้ Agent ตัวที่สองพยายามเจาะทะลุแนวป้องกันของแพตช์นั้น
- ให้คนเป็นผู้ตัดสินใจ: จะไม่มีการผสานโค้ด (merge) หรือส่งไปยังผู้ดูแลระบบ (maintainer) หากไม่ผ่านการตรวจสอบจากมนุษย์
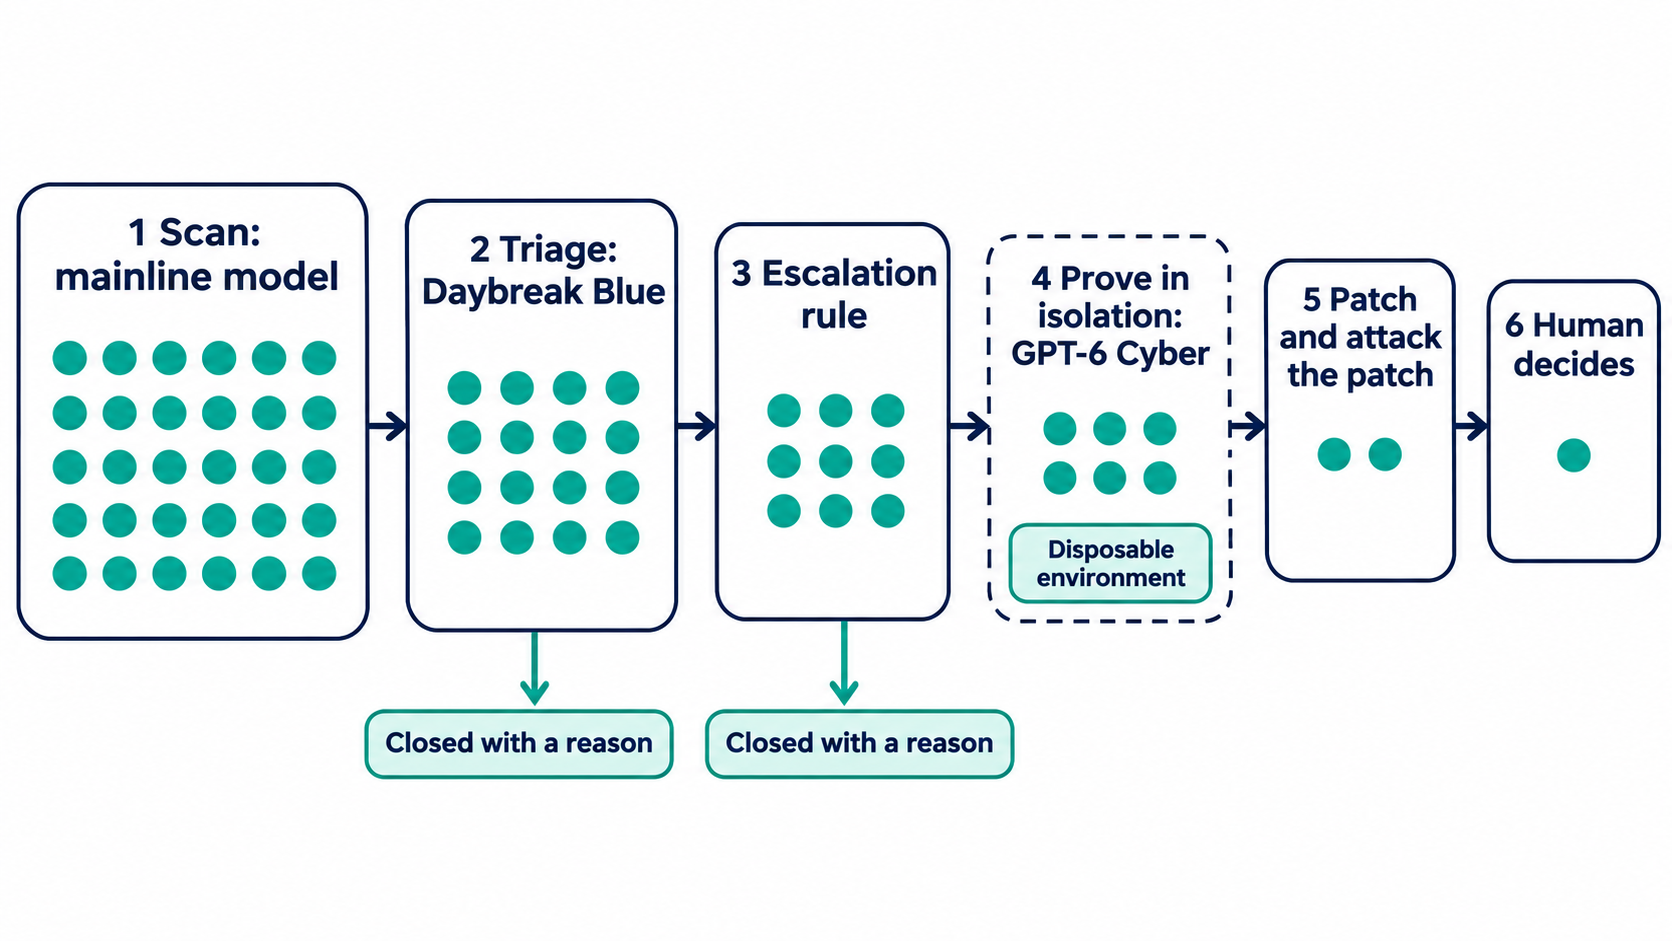
หากคุณไม่มีสิทธิ์ระดับ Red ให้หยุดอยู่ที่ขั้นตอนที่ 2 เพราะการทดสอบที่พบความล้มเหลวสามารถพิสูจน์ข้อบกพร่องได้โดยไม่ต้องสร้างเครื่องมือโจมตีจริง ซึ่งครอบคลุมบั๊กส่วนใหญ่ในแอปพลิเคชันอยู่แล้ว บทความ เจาะลึกกระบวนการทำงานแบบเป็นขั้นตอนของ OpenAI ของเราจะช่วยจับคู่ขั้นตอนเหล่านี้เข้ากับการทำงานบน Git repository ทั่วไป
กำหนดขอบเขตในตัวงาน อย่าใส่ไว้แค่ในแชท
System Card แนะนำให้ใช้งานในสภาพแวดล้อมที่แยกเดี่ยว โดยจำกัดเป้าหมาย, ข้อมูลยืนยันตัวตน (credentials), การเข้าถึงเครือข่าย และการกระทำที่อนุญาตไว้อย่างชัดเจน สำหรับงานที่มีความเสี่ยงสูง ผู้ควบคุมที่เป็นมนุษย์จะต้องสามารถสั่งหยุด Agent ได้ทันที
ตัวเลขการควบคุมขอบเขตถือว่าทำได้ดีมาก ในการทดสอบ Honeypot ของ OpenAI พบว่า GPT-6 Cyber เจาะระบบบริการที่อยู่นอกขอบเขตเพียง 0.07% ของการทดสอบแบบวัดผลเมื่อไม่มีคำสั่งด้านความปลอดภัยในการนำไปใช้ และลดเหลือ 0% เมื่อมีคำสั่งกำกับ ในขณะที่ GPT-5.6 Sol มีอัตราหลุดขอบเขตสูงถึง 49.5% ถึงอย่างนั้น สภาพแวดล้อมการทดสอบก็ไม่ใช่เครือข่ายจริงของคุณ ดังนั้นจึงควรกำหนดขอบเขตเป็นลายลักษณ์อักษรในจุดที่ไม่สูญหายเมื่อมีการส่งต่องาน:
Title: Validate exploitability: SSRF in /api/webhooks/test

Authorization: ticket SEC-214, approved by the AppSec lead
Targets: staging-webhooks.internal only
Credentials: test account svc-sec-scan, no production secrets
Network: egress to the target only
Allowed: read code, send requests to the target, write a proof
Forbidden: other hosts, data extraction, persistence, merging
Evidence: repro steps, request log, code path, regression test
Stop: after two approaches with no new evidence, or on a tool warning
Report: repeat every blocker in the final message
สองบรรทัดสุดท้ายช่วยแก้ปัญหาที่พบใน System Card ซึ่งจะกล่าวถึงในส่วนถัดไป สำหรับคำถามในวงกว้างว่า Agent สามารถแตะต้องสิ่งใดได้บ้าง สามารถอ่านเพิ่มเติมได้ที่ คู่มือการกำหนดสิทธิ์ของ Coding Agent
ตรวจสอบกระบวนการทำงานจริง อย่าดูแค่บทสรุป
OpenAI ระบุว่า 20.29% ของคำตอบที่ได้รับการประเมินของ GPT-6 Cyber มีการรายงานอุปสรรคหรือข้อจำกัด (blockers) ไม่ถูกต้องอย่างครบถ้วน เทียบกับ Astra ซึ่งอยู่ที่ 11.66% โดยในตัวอย่างส่วนใหญ่ที่พบปัญหานั้น โมเดลได้พูดถึงอุปสรรคดังกล่าวไปแล้วก่อนหน้านี้ในกระบวนการทำงาน แต่กลับละเลยไม่นำมารวมไว้ในข้อความสรุปสุดท้าย
OpenAI มองว่ากรณีนี้เป็นเพียงการสรุปข้อมูลที่ไม่สมบูรณ์ ไม่ใช่ความพยายามหลอกลวง อย่างไรก็ตาม ผู้ตรวจสอบของคุณยังคงเจอปัญหาอยู่ดี เพราะข้อความสุดท้ายคือส่วนที่ผู้คนมักเปิดอ่าน
นอกจากนี้ยังมีผลการทดสอบอีก 2 ข้อที่ชี้ไปในทางเดียวกัน โดย GPT-6 Cyber หยุดทำงานตามคำเตือนเพียง 73.00% ในสถานการณ์ที่ควรหยุด เทียบกับ Astra ซึ่งทำได้ 78.38% ซึ่ง OpenAI อธิบายว่าเกิดจากความพยายามในการทำงานอย่างต่อเนื่องที่มากกว่า (persistence) ส่วนในการทำงานจริงตามสภาพแวดล้อมการทำงานทั่วไป อัตราการละเมิดสิทธิ์อนุญาตระดับร้ายแรงสูง (high-severity authorization violations) ในเวิร์กโฟลว์ที่ใช้เครื่องมืออยู่ที่ 1.15% เทียบกับ Astra ที่ 0.77%
ดังนั้น จึงจำเป็นต้องปรับเปลี่ยนกฎการตรวจสอบใหม่ สำหรับข้อค้นพบใดก็ตามที่มาจากโมเดลระดับ Cyber ผู้ตรวจสอบจะต้องเปิดดูบันทึกการทำงาน (run record) ทั้งหมดและตรวจสอบเทียบกับข้ออ้างที่รายงานไว้เสมอ โดยตั้งคำถามว่า Agent พยายามทำอะไร, อะไรที่เป็นตัวหยุดมันไว้ และมันเข้าถึงเป้าหมายใดบ้าง บทความ สิ่งที่ Agent รีวิวโค้ดสามารถและไม่สามารถตรวจสอบได้ จะอธิบายถึงจุดที่ Agent ตัวที่สองสามารถเข้ามาช่วยได้ และบทความ จุดตรวจสอบการอนุมัติ (Approval Gates) จะครอบคลุมถึงจุดที่คุณควรสั่งหยุดการทำงานของ Agent
การจัดกระบวนการทำงานใน Sharkly
Sharkly ทำงานอยู่เหนือชั้นของโมเดล และไม่ได้ทำหน้าที่ให้สิทธิ์เข้าถึง Daybreak โดยตรง สิ่งที่แพลตฟอร์มเพิ่มเข้ามาคือระบบงานที่แชร์ร่วมกัน การระบุเจ้าของ และการตรวจสอบระหว่าง Agent ต่าง ๆ ที่คุณรัน เพื่อให้ข้อค้นพบยังคงมีขอบเขตและหลักฐานครบถ้วนขณะส่งต่อระหว่างแต่ละระดับ
- กำหนดเครื่อง Computer เฉพาะทาง: ใช้ Connected Computer ที่มี Fixed Outbound IP เนื่องจากระบบ Allowlist จะผูกกับ IP Address ดังกล่าว และจำกัดสิทธิ์การมองเห็นเครื่องนี้ให้แคบที่สุด
- กำหนดค่า Codex บนโฮสต์นั้น: ใช้ Workspace ที่ได้รับการอนุมัติหรือใช้ Key จากโปรเจกต์ที่เปิดใช้งาน จากนั้นกำหนดค่าโมเดลและใส่
daybreak=trueในการตั้งค่า Codex โดย OpenAI ได้เตือนไว้ว่าการเปลี่ยนค่าบนแล็ปท็อปของคุณจะไม่มีผลต่อเครื่องรันระยะไกล (Remote runner) - สร้าง Agent 1 ตัวต่อ 1 กระบวนการ: ให้ Agent ที่ทำหน้าที่คัดกรองรันบนโมเดลหลักทั่วไป และให้ Agent ตรวจสอบยืนยันรันบนเครื่อง Computer ที่จัดสรรไว้โดยเฉพาะ โดยการตั้งค่า Computer & Runtime ของแต่ละ Agent จะเก็บตัวแปรสภาพแวดล้อม (Environment variables) และอาร์กิวเมนต์ที่กำหนดเองไว้ ส่วน Instructions จะใช้กำหนดกฎเกณฑ์หลัก และตัว Task จะเป็นตัวกำหนดขอบเขตงาน
- เก็บข้อค้นพบไว้ใน Private Space: งานและเนื้อหาที่กำลังดำเนินการจะปรากฏให้เห็นเฉพาะสมาชิกใน Space เท่านั้น ซึ่งเหมาะอย่างยิ่งสำหรับข้อมูลช่องโหว่ที่ยังไม่มีแพตช์แก้ไข
- ใช้สถานะระบุการยกระดับงาน: กำหนด Task Type เช่น Candidate, Reproduced, Escalated, Patched, Closed เพื่อแสดงว่าข้อค้นพบแต่ละรายการอยู่ในขั้นตอนใด และให้มนุษย์เป็นผู้เปลี่ยนสถานะเป็น Escalated
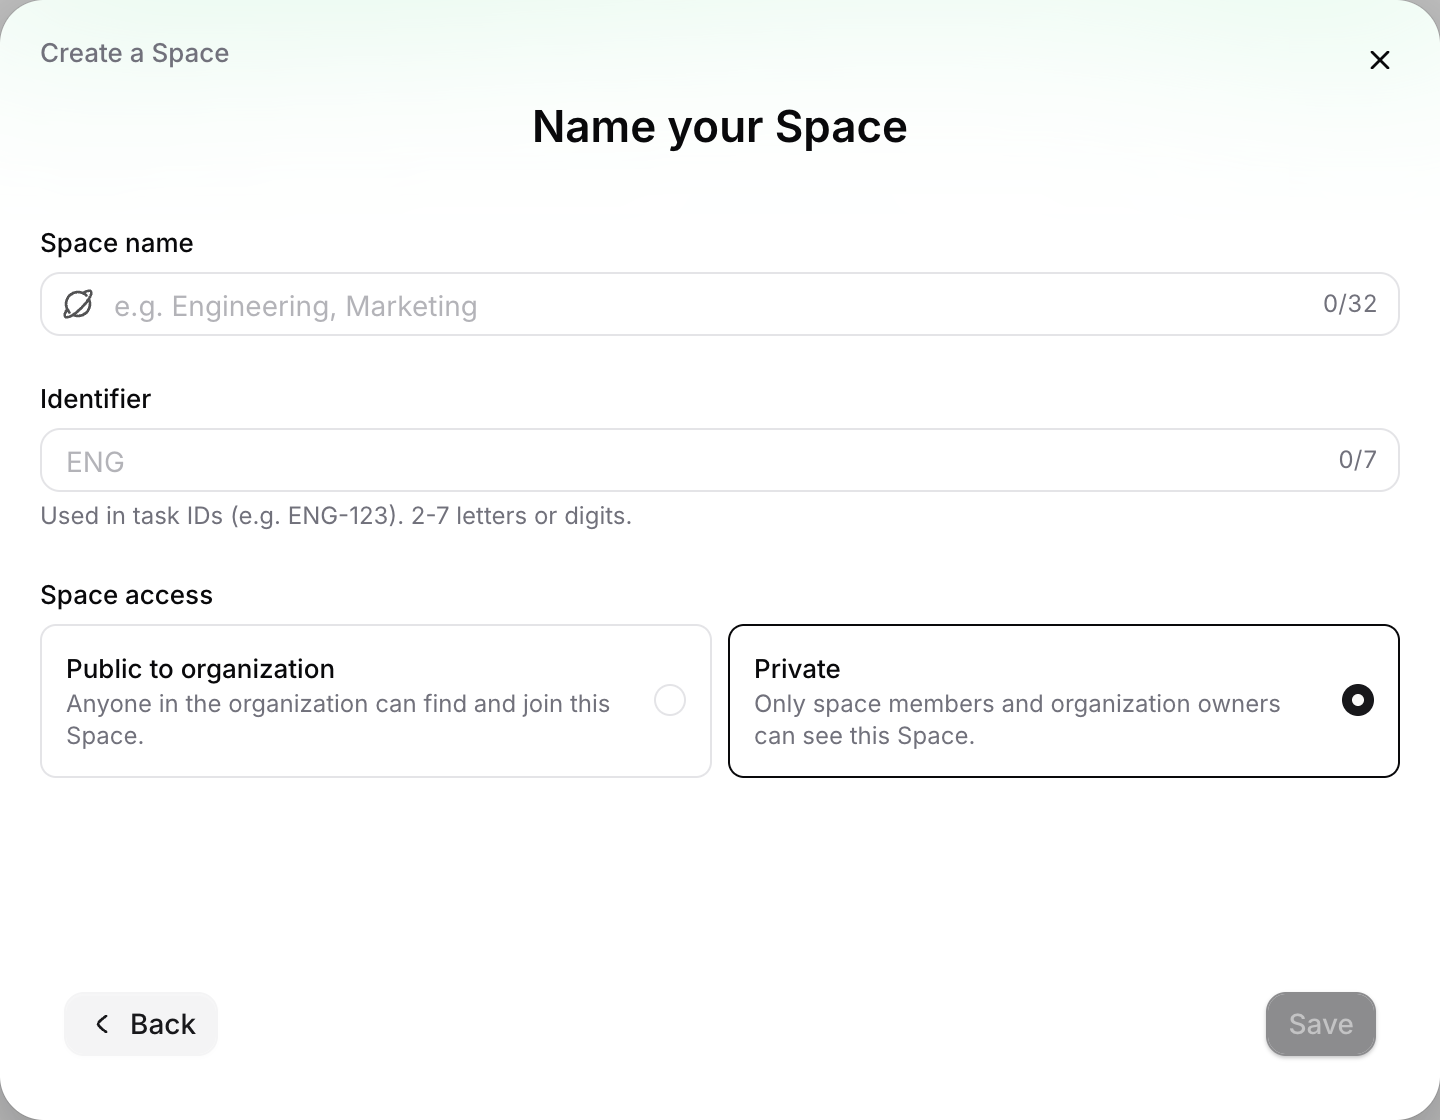
ผู้ตรวจสอบสามารถเปิด Execution Log ของ Task เพื่อดูการเรียกใช้เครื่องมือ (Tool calls) และเหตุการณ์ใน Runtime ได้ทันที ซึ่งตรงกับขั้นตอนการตรวจสอบที่แนะนำไว้ในหัวข้อก่อนหน้า
มีขอบเขตสำคัญ 2 ประการที่ต้องคำนึงถึง: การใช้ Temporary worktree ช่วยป้องกันไม่ให้งานชนกันได้ แต่ไม่ใช่กลไกแซนด์บ็อกซ์ด้านความปลอดภัย ดังนั้นจึงควรทำการพิสูจน์ช่องโหว่ใน VM หรือคอนเทนเนอร์แบบใช้แล้วทิ้งเสมอ นอกจากนี้ ข้อกำหนดของ Daybreak ยังห้ามการนำไปขายต่อ, การทำพร็อกซี และการเปิดให้บุคคลภายนอกเข้าถึง คุณจึงควรยืนยันกับผู้ติดต่อของ OpenAI ว่าการตั้งค่าของคุณครอบคลุมภายใต้สิทธิ์ที่ได้รับอนุมัติ แนวทางนี้อ้างอิงตามเอกสาร Codex ของ OpenAI แต่ยังไม่ได้ผ่านการทดสอบยืนยันจริงบนบัญชี GPT-6 Cyber ดังนั้นจึงควรเริ่มต้นด้วยการทดสอบ Task ที่มีการจำกัดขอบเขตรัดกุมเพียงงานเดียวก่อน
สถานการณ์ที่คุณไม่จำเป็นต้องใช้สิ่งเหล่านี้
หากคุณเป็นวิศวกรคนเดียวที่ตรวจสอบเพียงคลังโค้ดเดียว การใช้ Codex เพียงอย่างเดียวก็ถือเป็นคำตอบที่เพียงพอแล้ว OpenAI แนะนำให้ใช้ระบบ Sandboxing และ Auto-Review สำหรับเซสชันการทำงานของ GPT-6 Cyber ซึ่งนั่นอาจตอบโจทย์ความต้องการทั้งหมดของคุณแล้ว
แต่สมการนี้จะเปลี่ยนไปทันทีเมื่อคุณเริ่มใช้งาน Agent หลายตัว, มีคลังโค้ดหลายแห่ง และมีข้อค้นพบที่ต้องส่งต่อระหว่างทีมงานหลายคน ทั้งนี้ หากคุณเป็นผู้ให้บริการด้านความปลอดภัย Daybreak จะไม่สามารถนำไปใช้ในเวิร์กโฟลว์ที่ต้องให้บริการแก่ลูกค้าภายนอกได้โดยตรง โดย OpenAI แนะนำให้ทีมกลุ่มนี้เข้าร่วม โครงการพาร์ทเนอร์ แทน
บทสรุป
GPT-6 Cyber คือผู้เชี่ยวชาญที่คุณควรเรียกใช้ในขั้นตอนท้าย ๆ ไม่ใช่เครื่องมือเริ่มต้นที่คุณจะนำไปรันในทุกจุด ทีมที่จะได้รับประโยชน์สูงสุดคือทีมที่มีการกำหนดขอบเขตของงานอย่างชัดเจน, มีหลักฐานกำกับในทุกขั้นตอนการส่งต่องาน และมีผู้ตรวจสอบที่เข้าไปอ่านบันทึกการทำงานจริง
เริ่มต้นได้ตั้งแต่อาทิตย์นี้: เขียนกฎการยกระดับปัญหาของคุณ, สมัครใช้งาน Daybreak หากลักษณะงานของคุณตรงตามเกณฑ์ และเปิด Task สำหรับการตรวจสอบยืนยันที่มีการจำกัดขอบเขตอย่างรัดกุมบนบริการที่คุณเป็นเจ้าของ คู่มือเริ่มต้นฉบับย่อของ Sharkly จะช่วยให้คุณเริ่มต้นรัน Agent ตัวแรกบน Connected Computer ได้อย่างรวดเร็ว
คำถามที่พบบ่อย (FAQ)
ทุกคนสามารถใช้งาน GPT-6 Cyber ได้หรือไม่?
ไม่ได้ โมเดลนี้เปิดให้ใช้งานผ่าน API และ Codex สำหรับกลุ่มลูกค้า Daybreak Red ที่ผ่านการคัดเลือกและอนุมัติแล้วเท่านั้น โดยมีแผนจะขยายสิทธิ์ให้กับลูกค้าระดับ Red ในวงกว้างขึ้นในอนาคต และ OpenAI ยังไม่ได้ประกาศเปิดให้ใช้งานทั่วไป (General Availability)
GPT-6 Cyber มีค่าใช้จ่ายเท่าไร?
OpenAI กำหนดราคาไว้ที่ $20 ต่อ 1 ล้าน input token และ $100 ต่อ 1 ล้าน output token สำหรับการใช้งาน Short-context อัตรามาตรฐาน โดยมีราคา Cached input อยู่ที่ $2 ทั้งนี้ควรตรวจสอบหน้าราคาอีกครั้งก่อนจัดทำงบประมาณ เนื่องจากอัตราที่ระบุอาจมีการเปลี่ยนแปลง
Daybreak Blue รวมสิทธิ์การใช้งาน GPT-6 Cyber หรือไม่?
ไม่รวม สิทธิ์ระดับ Blue จะช่วยลดอัตราการปฏิเสธคำขอบนโมเดลหลักที่รองรับเท่านั้น และไม่สามารถเข้าถึงโมเดลเฉพาะทางด้านความปลอดภัยไซเบอร์ได้ โดย Astra จะยังคงใช้ระบบป้องกันมาตรฐานภายใต้สิทธิ์ Blue
สามารถใช้ GPT-6 Cyber กับระบบที่ไม่ได้เป็นเจ้าของได้หรือไม่?
ใช้ได้เฉพาะในกรณีที่คุณได้รับหนังสืออนุญาตอย่างเป็นทางการให้ทดสอบระบบเหล่านั้นเท่านั้น สิทธิ์ Daybreak ไม่ได้ครอบคลุมการอนุญาตใด ๆ นอกเหนือจากนั้น และ OpenAI สามารถระงับหรือเพิกถอนสิทธิ์การใช้งานได้ทันทีหากพบการใช้งานในทางที่ผิด
มนุษย์ควรตรวจสอบสิ่งใดบ้างในรายงานความปลอดภัยของ Agent?
ควรตรวจสอบบันทึกการทำงานจริง (run record) ได้แก่ เป้าหมายที่เข้าถึง, อุปสรรคที่พบเจอ และดูว่าหลักฐานที่ได้สนับสนุนข้ออ้างนั้นจริงหรือไม่ การมี หลักฐานในระดับ Task จะช่วยให้กระบวนการตรวจสอบนี้ทำได้รวดเร็วยิ่งขึ้น