
Anthropic ระบุว่า Claude Opus 5.5 มีต้นทุนการรันต่ำกว่า Opus 5 อยู่ 40% ใครสักคนในทีมคุณคงคิดเลขง่าย ๆ ไปแล้ว: งบเท่าเดิม ได้ agent run ราว 1.7 เท่า ดังนั้นงานที่ส่งมอบได้ก็ราว 1.7 เท่า การคำนวณนั้นถูกต้องตามหลักเลขคณิต แต่ผิดในทางปฏิบัติ และสัปดาห์ที่เริ่มลงมือทำตามนั้น คือสัปดาห์ที่บอร์ดงานของคุณเต็มไปด้วย run ที่เสร็จแล้วแต่ไม่มีใครอ่าน
ข้อจำกัดของการรัน agent แบบขนานมากขึ้นไม่เคยอยู่ที่ค่าบริโมเดล แต่คือขีดความสามารถของคนหนึ่งคนในการอ่าน diff เข้าใจสิ่งที่ agent ตัดสินใจ และยอมรับมัน การลดราคาไม่ได้เปลี่ยนตัวเลขนั้นเลย มีแต่ทำให้งานไหลมาถึงจุดนั้นเร็วขึ้น
สรุปสั้น ๆ
เพดานการรีวิว (review ceiling) คือจำนวน agent run ที่เสร็จสมบูรณ์ซึ่งทีมอ่าน ตรวจสอบ และยอมรับได้จริงในหนึ่งวัน และเพดานนี้ถูกกำหนดโดยคน ไม่ใช่โดยโทเคน โมเดลที่ถูกลงทำให้งานไหลมาถึงเพดานนั้นเร็วขึ้น โดยที่ตัวเพดานเองไม่ขยับ ผลที่เห็นได้ชัดเป็นอย่างแรกของการลดราคาจึงไม่ใช่การปล่อยงานที่เร็วขึ้น แต่คือคิวที่ยาวขึ้น agent ค้นคว้า ลงมือทำ ทดสอบ และรายงาน คนเป็นคนกำหนดทิศทาง ให้อำนาจ และยอมรับผลลัพธ์ วิธีรับมือที่มีประโยชน์คือ จำกัด concurrency ให้สอดคล้องกับจำนวนคนรีวิว ไม่ใช่กับงบประมาณ และแยกงานของ agent ที่บรรจบกันเป็นผลลัพธ์เดียวที่รีวิวได้ ออกจากงานของ agent ที่กระจายออกเป็นหลายชิ้น Sharkly ทำให้บริบท ความคืบหน้า อุปสรรค ผลลัพธ์ และการรีวิวโดยมนุษย์มองเห็นได้บน Task ตั้งแต่คำขอจนถึงการปล่อยงาน ซึ่งเป็นสิ่งที่ทำให้คิวนับได้ตั้งแต่แรก
อะไรกันแน่ที่ถูกลง
สองแล็บเปิดตัวในวันที่ 22 กันยายน 2026 นี่คือส่วนที่กระทบใบแจ้งหนี้ของคุณ
| Claude Opus 5 | Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|---|
| API id | claude-opus-5 |
claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| อินพุตต่อ 1M โทเคน | $5 | $4 | $2 | $0.10 |
| เอาต์พุตต่อ 1M โทเคน | $25 | $20 | $10 | $0.50 |
| อินพุตแบบแคช | n/a | $0.20 อ่าน, $5 เขียน | ลด 90% สำหรับการอ่าน | ลด 90% สำหรับการอ่าน |
Anthropic ระบุว่า Opus 5.5 มีต้นทุนการรันต่ำกว่า Opus 5 อยู่ 40% และให้ผลลัพธ์เร็วขึ้นราว 30% อัตราตามรายการข้างต้นต่ำกว่าราคาต่อโทเคนของ Opus 5 อยู่ 20% ซึ่งเป็นการคำนวณของเราเองจากตัวเลขที่เปิดเผยสองตัว และเป็นข้ออ้างแยกต่างหากจากตัวเลข 40% OpenAI ระบุว่า Sol และ Luna แต่ละตัวถูกกว่าราคาโปรโมชันของ GPT-5.6 อยู่ 50% และคำว่า “โปรโมชัน” ก็เป็นคำของ OpenAI เอง ดังนั้นพาดหัวนั้นจึงเทียบกับราคาที่ลดแล้ว ไม่ใช่ราคาตามรายการ
ต้นทุนต่องานที่ทำสำเร็จขยับมากกว่าต้นทุนต่อโทเคน บน AutomationBench 1.0.6 OpenAI รายงานว่า GPT-6 Sol ที่ระดับ extra high reasoning ทำคะแนนได้ 33.2% ด้วยต้นทุน $0.27 ต่องาน เทียบกับ Claude Opus 5 ที่ max reasoning ซึ่งทำได้ 26.9% ด้วยต้นทุน 11.1 เท่าของ Sol บน DeepSWE 1.1 OpenAI วัดให้ GPT-6 Luna ที่ max reasoning ได้ 66.6% และถูกกว่าต่องานเมื่อเทียบกับ Opus 5 ถึง 93%
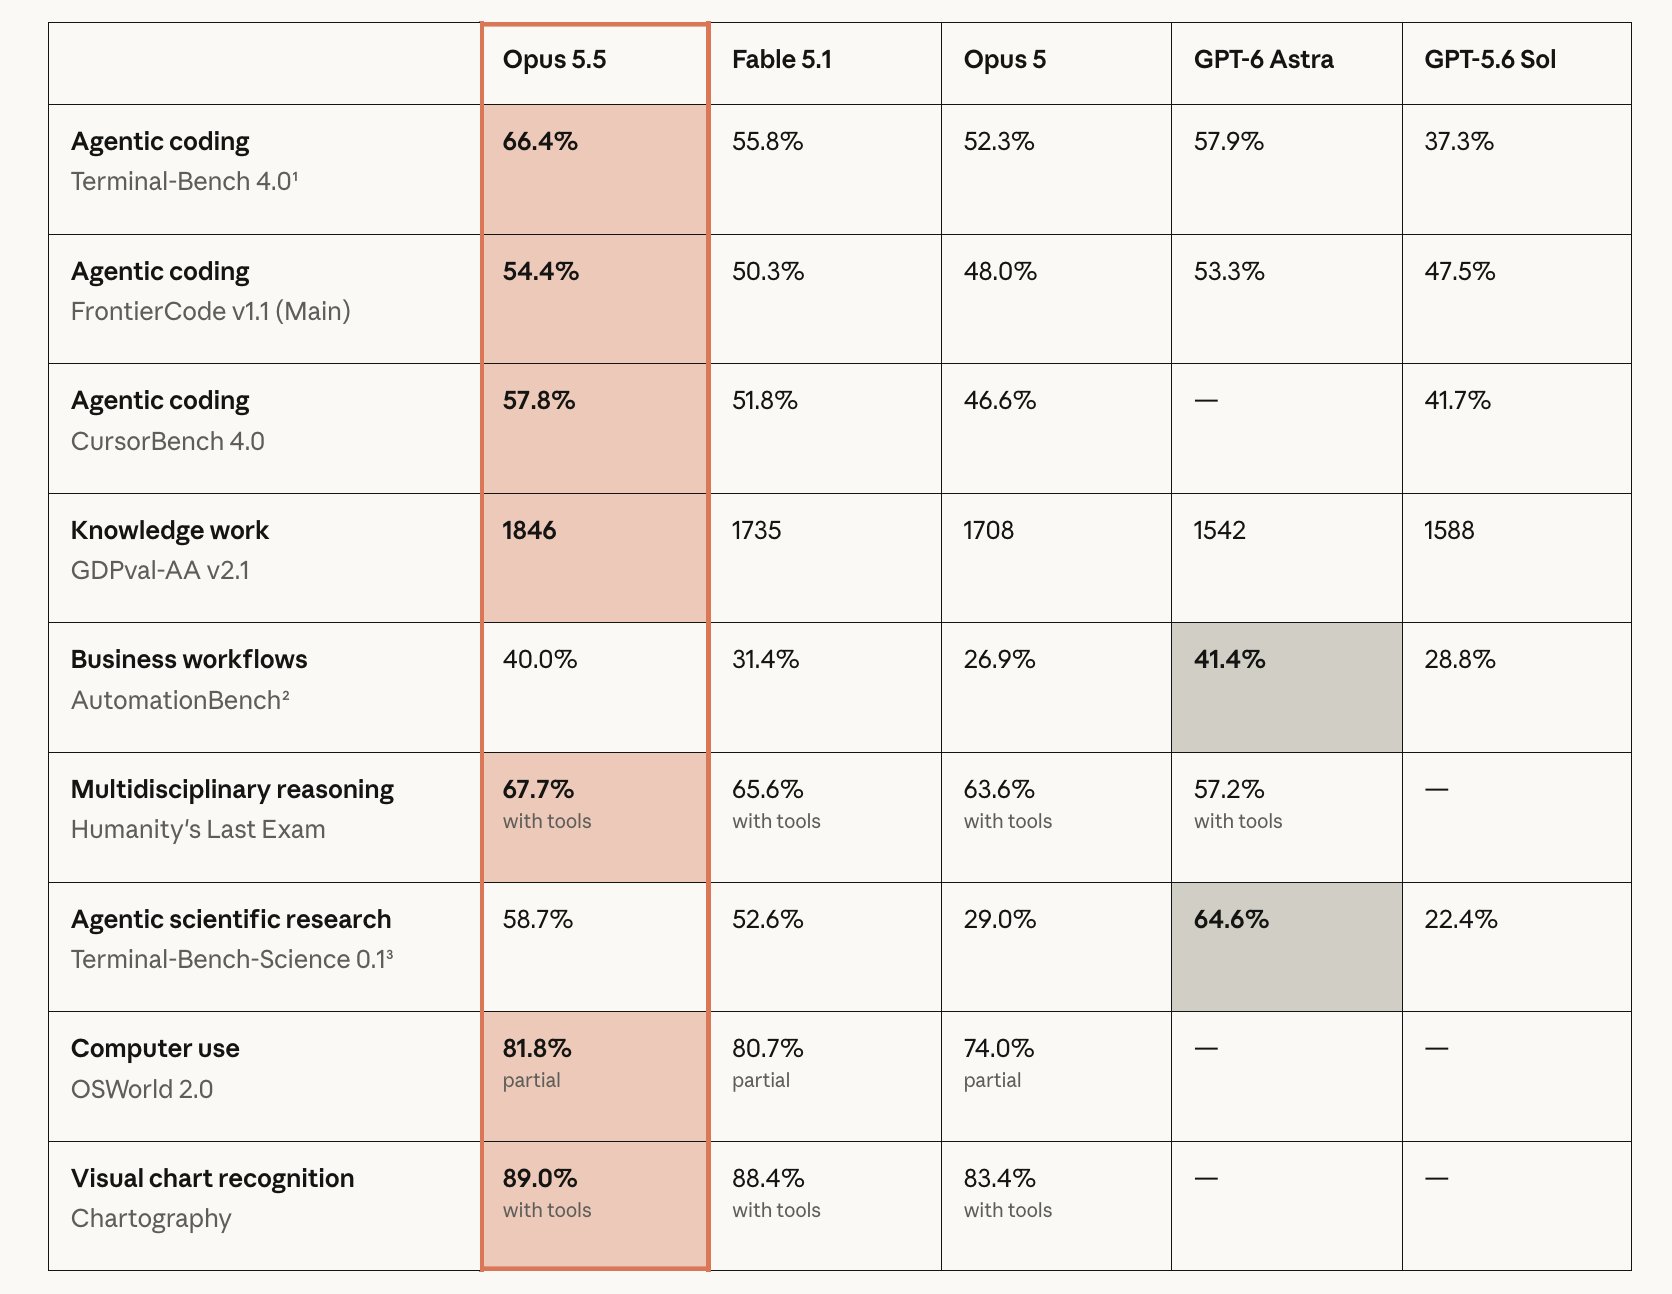
ดังนั้นราคาของความพยายามหนึ่งครั้งจึงลดลงอย่างมาก จากสองผู้ให้บริการ ในวันเดียว ไม่มีอะไรอื่นในสัปดาห์ของคุณเปลี่ยนไป
การคำนวณที่ใคร ๆ ก็ทำกันสัปดาห์นี้
ตรึงค่าใช้จ่ายให้คงที่แล้วหารดู ด้วยต้นทุนการรันที่ต่ำลง 40% งบรายเดือนเท่าเดิมซื้อ run ของ Opus 5.5 ได้ราว 1.67 เท่าของ run Opus 5 แต่ถ้าโยนงาน routine ครึ่งหนึ่งไปให้ Luna ตัวคูณก็ไม่น่าสนใจอีกต่อไป เพราะที่ราคา $0.10 และ $0.50 ต่อล้านโทเคน ค่าโมเดลไม่ใช่รายการที่คุณต้องตั้งงบอีกแล้ว
ทีนี้ลองคิดเลขอีกสมการหนึ่ง สมการที่ตัดสินว่ามีอะไรจะได้ขึ้นจริงไหม เอาเลขจำนวน run ที่เสร็จแล้วซึ่งวิศวกรคนหนึ่งของคุณอ่านได้อย่างเต็มที่ในหนึ่งวัน ไม่ใช่แค่อ่านผ่าน ๆ ไม่ใช่กดอนุมัติตามเครื่องหมายสีเขียว แต่คืออ่าน diff เข้าใจว่า agent เลือกทำอะไร และรับผิดชอบต่อสิ่งนั้น ตัวเลขนั้นเป็นเท่าไร วันที่ 21 กันยายน 2026 มันก็เท่านั้น และไตรมาสหน้าก็จะยังเท่าเดิม คณิตศาสตร์ของขีดความสามารถในการรีวิวออกมาแย่อยู่แล้วก่อนจะมีการลดราคา และการลดราคาก็เปลี่ยนแค่ฝั่งอินพุต
การลดราคาไม่ใช่การเพิ่มขีดความสามารถ มันเป็นแค่การเปลี่ยนว่าการสร้างสิ่งที่ยังต้องมีคนมารับผิดชอบนั้นถูกลงแค่ไหน
สัญญาณบอกใบ้: ต้นทุนไม่ใช่สิ่งที่หยุดคุณไว้
ถ้าต้นทุนโมเดลเป็นข้อจำกัดที่แท้จริง ทีมต่าง ๆ คงรันการตั้งค่าที่ถูกที่สุดที่ยังใช้งานได้ แต่พวกเขาไม่ได้ทำอย่างนั้น ตัวเลขของ OpenAI เองระบุว่านักวิจัยค่ามัธยฐานในองค์กรใช้ inference วันละกว่า $600 ที่ราคา API และเปอร์เซ็นไทล์ที่ 90 ใช้ถึง $7,000 ต่อวัน ตาราง benchmark ที่เผยแพร่ยังแสดงให้เห็นว่าทีมต่าง ๆ ยอมใช้การตั้งค่าที่แพงกว่าต่องานถึง 11.1 เท่าเพื่อให้ได้คะแนนที่ต่ำกว่า เพราะผลลัพธ์ที่คุณเชื่อใจได้มีค่ามากกว่าผลลัพธ์ที่คุณต้องตรวจซ้ำสองครั้ง
นั่นคือรูปร่างของข้อจำกัดที่แท้จริง คนยอมจ่ายแพงขึ้นหลายเท่าสำหรับผลลัพธ์ที่ต้องใช้การตรวจสอบโดยมนุษย์ต่อหน่วยน้อยลง ทรัพยากรที่หายากซึ่งถูกซื้อไปคือความสนใจ ไม่ใช่ compute และมันถูกซื้อในราคาที่แพงลิ่วอยู่แล้ว
ซึ่งหมายความว่าการลดราคาลงกระทบแบบไม่สมมาตร มันทำให้ฝั่งที่สร้างงานถูกลง แต่ปล่อยให้ฝั่งที่ต้องยอมรับผลอยู่ในจุดเดิมเป๊ะ
Fan-out ที่บรรจบกัน และ fan-out ที่ไปกองบนบอร์ดงาน
นี่คือความแตกต่างที่ทำให้โมเดลราคาถูกมีประโยชน์จริง ๆ แทนที่จะแพงแบบเงียบ ๆ และเป็นเรื่องที่ทีมส่วนใหญ่ข้ามไป
ความขนานบางแบบบรรจบกัน agent สามตัวลอง migration เดียวกันใน worktree ที่แยกจากกัน ชุดเทสต์และ Agent หัวหน้าคัดเลือกอันที่ผ่าน และมีผลลัพธ์เดียวส่งถึงคน ต้นทุนเพิ่มสามเท่า แต่ภาระการรีวิวไม่ขยับเลย นี่คือจุดที่การลดราคาซื้อ throughput จริง ๆ ให้คุณ และเป็นจุดที่เศรษฐศาสตร์ใหม่คุ้มค่าที่จะปรับ setup ตาม
ความขนานบางแบบกระจายออก agent สิบตัวรับ Task ที่ไม่เกี่ยวข้องกันสิบงาน และสร้าง diff สิบชุด สรุปการเปลี่ยนแปลงสิบชุด และการตัดสินใจยอมรับสิบครั้ง ต้นทุนก็คือสิบ run เท่าเดิม แต่ภาระการรีวิวคือสิบเท่าของหน่วยความสนใจของคนหนึ่งคน
| Fan-out ที่บรรจบกัน | Fan-out ที่กระจายออก | |
|---|---|---|
| ตัวอย่าง | ลอง 3 ครั้งกับหนึ่ง migration ครั้งที่ดีที่สุดชนะ | 10 Task, 10 Assignee, 10 diff |
| สิ่งที่โมเดลราคาถูกซื้อให้ | ลองได้มากขึ้น มีโอกาสได้ผลลัพธ์ที่ดี | งานที่เสร็จแล้วรออยู่มากขึ้น |
| จำนวนรายการที่ต้องรีวิว | 1 | 10 |
| ขยายตามราคาอย่างเดียวได้อย่างปลอดภัย | ได้ | ไม่ได้ |
ใช้โมเดลราคาถูกขยาย converging fan-out ให้กว้างเท่าที่ความอดทนต่อการลองซ้ำของคุณจะไปถึง แต่อย่าใช้มันขยาย diverging fan-out ให้เกินจำนวนคนรีวิวของคุณ ไม่ว่า run จะถูกลงแค่ไหนก็ตาม นั่นคือคู่การตัดสินใจที่ตรงไปตรงมา และครึ่งหลังคือส่วนที่ทำให้เสียเงินเมื่อถูกมองข้าม
ควรเปลี่ยนอะไรแทนการเปลี่ยนงบประมาณ
จำกัด concurrency ให้สอดคล้องกับจำนวนคนรีวิว ไม่ใช่กับค่าใช้จ่าย เขียนกฎไว้ในที่ที่ Crew มองเห็น: Task ที่เปิดอยู่ซึ่งรอการยอมรับจากมนุษย์ไม่ควรเกินจำนวนคนรีวิวในกะ คูณด้วยจำนวนรีวิวที่แต่ละคนทำได้ในหนึ่งกะ สองตัวเลขนั้นของคุณ ไม่ใช่ของเรา เมื่อถึงเพดาน agent จะหยุดรับ Task ใหม่ แม้งบประมาณจะยังไหวอยู่ก็ตาม กฎการ routing ที่เขียนไว้เป็นลายลักษณ์อักษรชนะความชอบส่วนตัวในจุดนี้ เพราะความชอบส่วนตัวแพ้ให้กับราคาที่ถูกลงอย่างเงียบ ๆ
ทำให้ “รอคน” เป็นสถานะที่มองเห็นได้ run ที่เสร็จแล้วกับ run ที่หยุดเพื่อถามอะไรบางอย่างดูเหมือนกันจากภายนอก และทั้งคู่ก็มองไม่เห็นเลยถ้าบันทึกเดียวที่มีคือ terminal การลงมือทำ อุปสรรค ผลลัพธ์ และการพูดคุยต่อเนื่องควรกลับไปอยู่ในไทม์ไลน์ของ Task เพื่อให้คิวเป็นสิ่งที่คุณนับได้ ไม่ใช่ความรู้สึกที่คุณได้ในวันศุกร์
คิดราคาที่การรีวิว ไม่ใช่ที่โทเคน การติดตามต้นทุนข้าม agentที่รายงานเป็นดอลลาร์ต่อ run ตอบคำถามที่ไม่มีผลผูกมัดอีกต่อไป ตัวเลขที่ควรขึ้นแดชบอร์ดคือจำนวนนาทีของมนุษย์ต่อการเปลี่ยนแปลงที่ได้รับการยอมรับ ถ้าตัวเลขนั้นเพิ่มขึ้นหลังจากคุณเปลี่ยนไปใช้โมเดลที่ถูกกว่า แปลว่าโมเดลที่ถูกกว่านั้นแพงกว่า
ใช้เงินที่ประหยัดได้ส่วนหนึ่งไปกับหลักฐาน run ที่แนบ typecheck ผลการทดสอบ สรุปการเปลี่ยนแปลง และข้อจำกัดที่รู้อยู่แล้ว ใช้โทเคนมากขึ้นแต่ใช้ความสนใจน้อยลง ที่ราคา $0.20 ต่อล้านโทเคนอินพุตแบบแคชบน Opus 5.5 และส่วนลด 90% สำหรับการอ่านแคชบน GPT-6 รอบการตรวจสอบเพิ่มเติมแทบไม่มีค่าใช้จ่าย และมันซื้อทรัพยากรที่หายากจริง ๆ กลับคืนมา
ทั้งหมดนี้ทิ้งอะไรไว้กับสัปดาห์ของคุณ
สองแล็บลดราคาของความพยายามหนึ่งครั้งในวันเดียวกัน และหนึ่งในนั้น benchmark กับโมเดลที่ถูกแทนที่ภายในไม่กี่ชั่วโมงต่อมา ไม่มีใครในสองเจ้านั้นส่งอะไรที่อ่าน diff แทนคุณได้ ความเป็นเจ้าของงานโดยมนุษย์คือส่วนที่ไม่ได้ถูกลง 40% และเป็นส่วนที่ตัดสินว่าอะไรจะไปถึงโปรดักชัน
ถ้าคุณรัน coding agent หลายตัวอยู่แล้ว การขยับที่มีประโยชน์ในสัปดาห์นี้ไม่ใช่การเพิ่มตัวเลข concurrency แต่คือการหาว่าเพดานการรีวิวของคุณจริง ๆ อยู่ที่เท่าไร แล้วตั้ง concurrency ให้สอดคล้องกัน Sharkly ให้คุณเห็น run อุปสรรค ผลลัพธ์ และคิวงานที่รอคนมายอมรับได้ในที่เดียว


