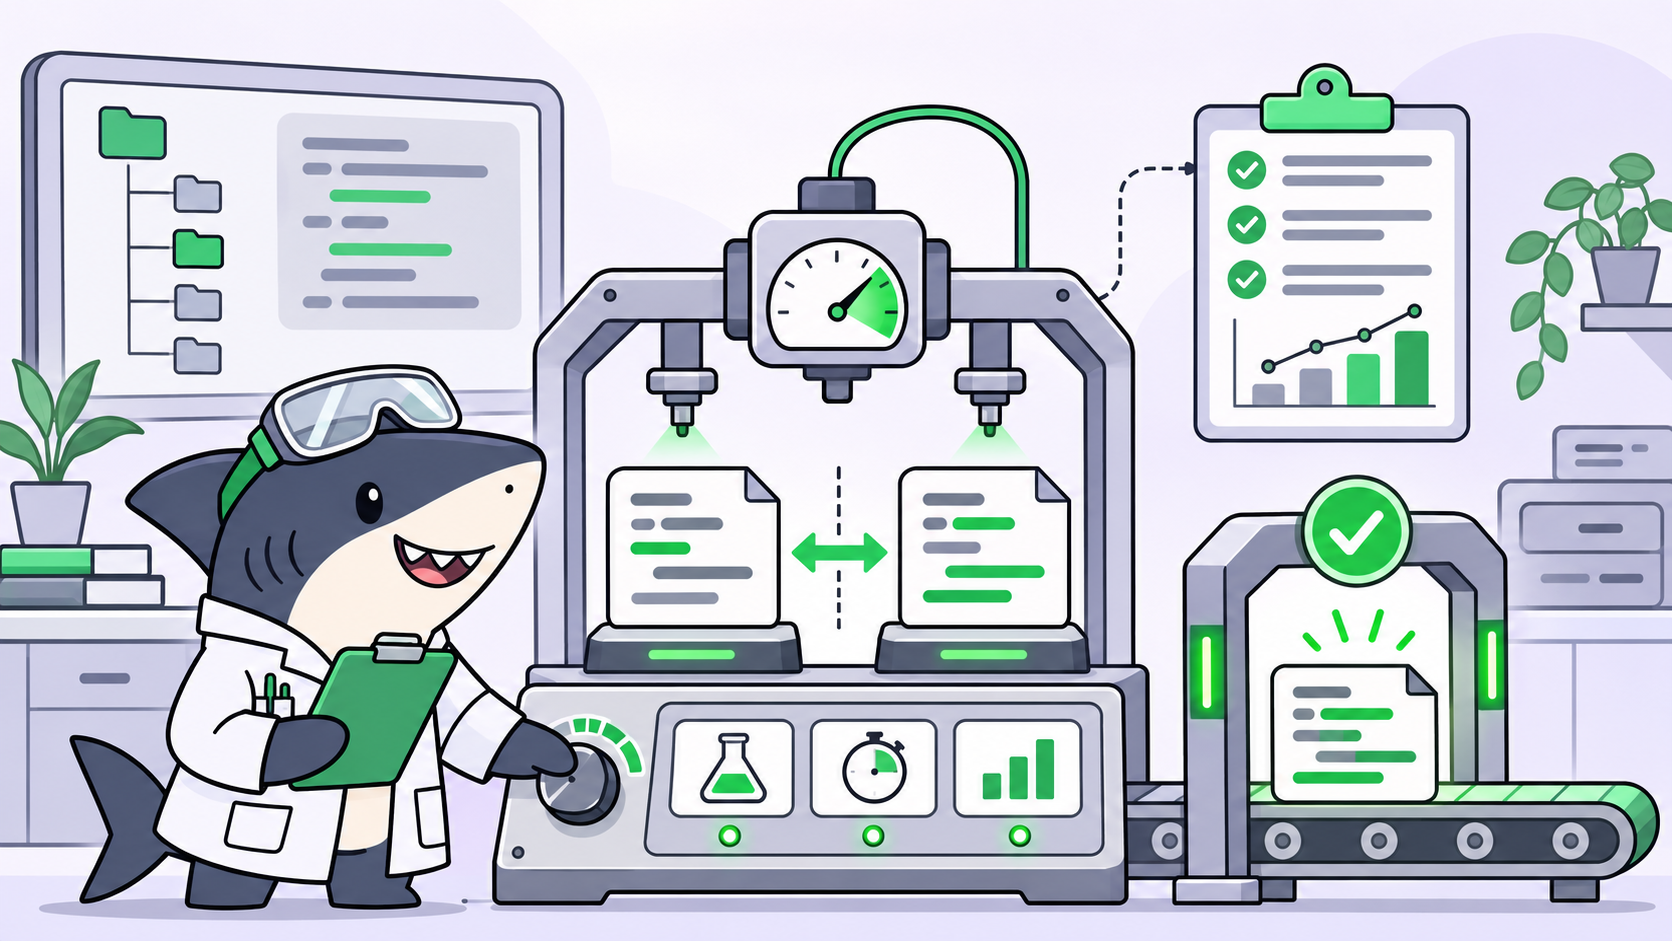
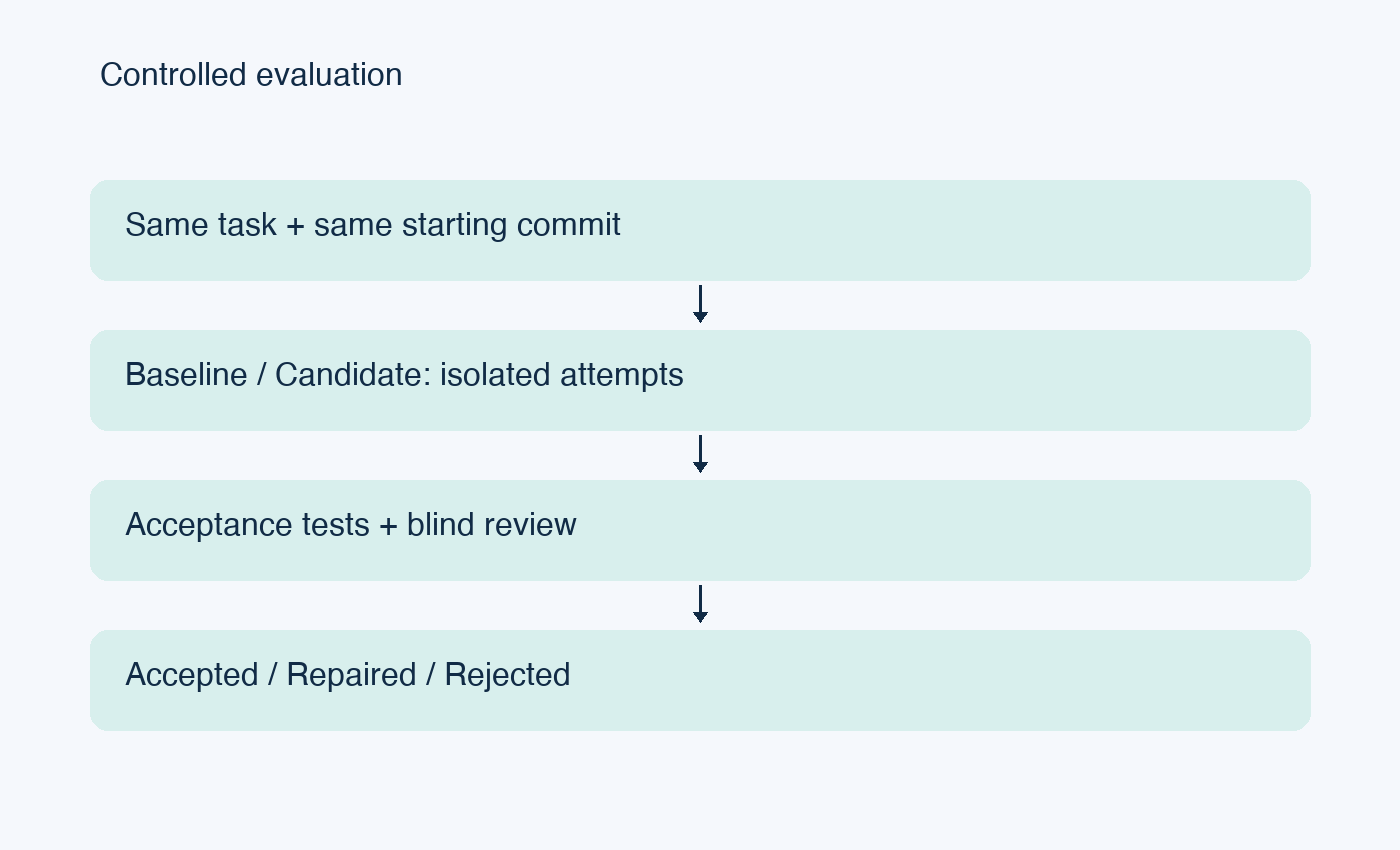
ประเมินประสิทธิภาพของ Claude Fable 5.2 จากงานจริงที่เป็นตัวแทนของ repository โดยใช้เกณฑ์การยอมรับ (acceptance criteria) ที่ชัดเจน สภาพแวดล้อมที่เหมือนกันทุกประการ และเปรียบเทียบกับ baseline ที่คุณใช้อยู่เป็นประจำ วัดผลการเปลี่ยนแปลงที่ผ่านการยอมรับ (accepted changes) ควบคู่ไปกับภาระงานในการรีวิว เวลาที่ใช้จริง และค่าใช้จ่ายทั้งหมด ทำการทดสอบซ้ำ บันทึกกรณีที่ล้มเหลวไว้ด้วย และตัดสินใจเลือกนำมาปรับใช้ตามหมวดหมู่งาน แทนที่จะพิจารณาจากคะแนน benchmark เพียงอย่างเดียว
Anthropic ได้เปิดตัว Fable 5.2 เมื่อวันที่ 9 พฤศจิกายน 2026 โดยในประกาศเปิดตัวระบุถึงการพัฒนาด้านการเขียนโค้ดและการใช้เหตุผล ทว่าข้อมูลเหล่านั้นเป็นเพียงการกล่าวอ้างของผู้พัฒนาจากการประเมินและสภาพแวดล้อมการทดสอบของตนเอง ซึ่งไม่อาจบ่งบอกได้เลยว่าโมเดลจะทำงานร่วมกับ dependencies, แนวทางปฏิบัติ (conventions) ตลอดจนข้อกำหนดการ release ในระบบงานจริงของคุณได้ดีเพียงใด
การประเมินของคุณควรมุ่งเน้นไปที่คำถามที่เจาะจงยิ่งขึ้น นั่นคือ งานประเภทใดที่คุณสามารถมอบหมายให้ AI ทำได้โดยมีภาระในการรีวิวอยู่ในระดับที่รับได้? หากคุณใช้งาน coding agents หลายตัวในการแบ่งเบาภาระงานดังกล่าวอยู่แล้ว Sharkly ก็เป็นพื้นที่ที่ช่วยคุณจัดระเบียบงานและบริบทสำหรับการรีวิวได้อย่างมีประสิทธิภาพ
คู่มือนี้เป็นการเสนอแนวทางการทดลอง โดยไม่ได้มีผลลัพธ์การเปรียบเทียบเชิงตัวเลขระบุไว้
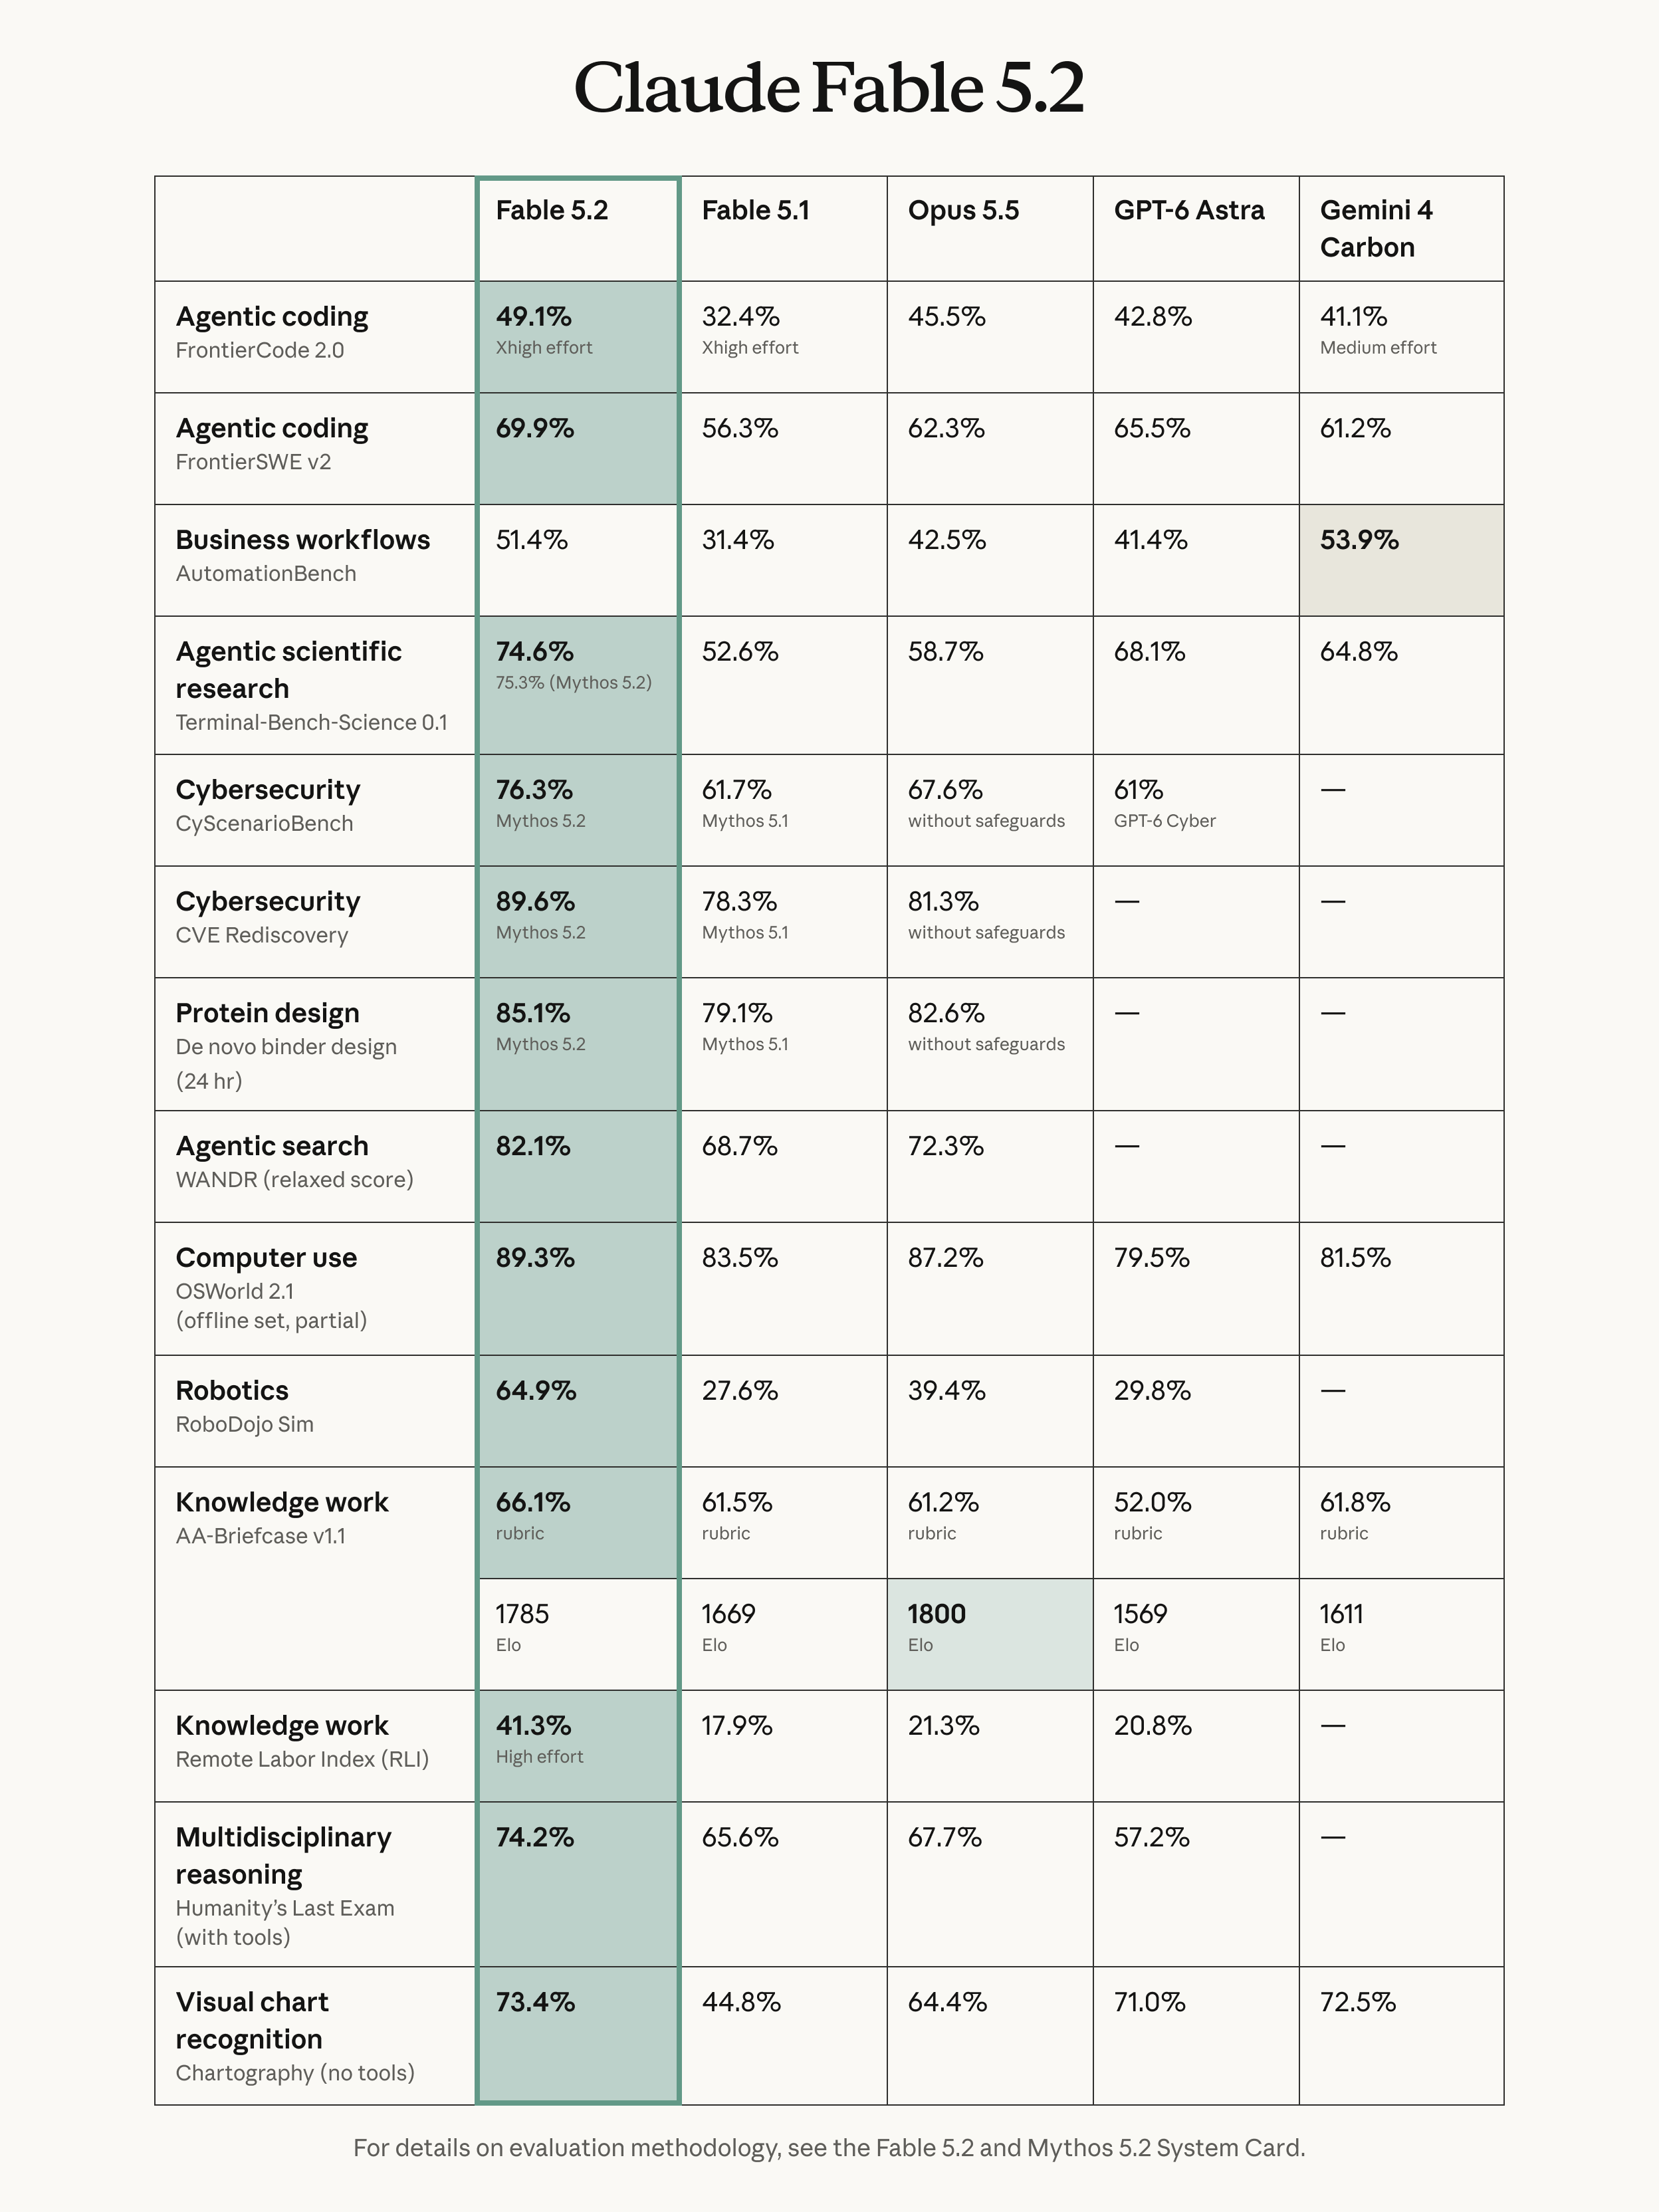
สร้างชุดงานทดสอบที่เป็นตัวแทนของงานจริง
การประเมิน repository คือการเปรียบเทียบกระบวนการเขียนโค้ดภายใต้การควบคุม โดยอิงตาม requirement จากงานพัฒนาจริงของคุณ ตัวชี้วัดความสำเร็จคือการเปลี่ยนแปลงที่ผ่านการยอมรับ (accepted change) ซึ่งรวมถึงชุดการทดสอบและการรีวิวโค้ดด้วย ทั้งนี้ patch ที่ดูสมเหตุสมผล คำสั่งทดสอบที่ผ่าน หรือข้อความยืนยันการทำงานเสร็จอย่างมั่นใจเพียงอย่างเดียว ไม่สามารถนับเป็นการยอมรับงานได้
เริ่มต้นด้วยงานทดสอบ 12 งานที่คัดมาจากงานดูแลรักษาระบบ (maintenance) ล่าสุด ตัวเลขนี้เป็นขนาดเริ่มต้นที่แนะนำสำหรับการทดลองนำร่อง ไม่ใช่เกณฑ์ชี้วัดทางสถิติ ควรครอบคลุมทั้งการแก้บั๊ก (bug fix) การเพิ่มฟังก์ชันย่อย (small addition) การรีแฟกเตอร์โค้ด (refactor) และงานสืบค้นหาสาเหตุของปัญหา (investigation) ในสัดส่วนที่ใกล้เคียงกับ backlog จริงของคุณ
เลือกงานที่มี commit เริ่มต้นที่ชัดเจน และมีผู้รีวิวที่เข้าใจพฤติกรรมที่คาดหวังของระบบอย่างถ่องแท้ หลีกเลี่ยงการเลือกเฉพาะ issue ที่มีคำตอบตายตัวชัดเจนอยู่แล้ว และควรมีงานอย่างน้อยหนึ่งงานที่คำตอบที่ถูกต้องจำเป็นต้องถามคำถามเพิ่มเติมหรือชี้แจงถึง dependency ที่ขาดหายไป
สำหรับ issue เก่าที่เคยเกิดขึ้น ให้ตัดส่วนเฉลยหรือวิธีแก้ออกจากบริบทที่ส่งให้โมเดล พร้อมทั้งบันทึกไว้ด้วยว่าวิธีแก้นั้นเคยเปิดเผยเป็นสาธารณะหรือไม่ เนื่องจากโมเดลอาจเคยเห็นมาก่อนในชุดข้อมูลฝึกฝน และควรแยกชุดงานที่ไม่เคยเผยแพร่ไว้ต่างหากสำหรับการทดสอบยืนยันผลในรอบถัดไป
กำหนดเกณฑ์การยอมรับ (acceptance criteria) ให้เสร็จสิ้นก่อนเริ่มการทดสอบเสมอ ตัวอย่างเช่น หากเป็นการแก้ปัญหาระบบแบ่งหน้าของ API (API pagination) ควรกำหนดกรณีที่ผลลัพธ์ว่างเปล่า ขอบเขตของหน้า (page boundaries) cursor ที่ไม่ถูกต้อง และความเข้ากันได้กับไคลเอนต์เดิม รวมถึงระบุขอบเขตการแก้ไขโค้ดที่อนุญาตและการตรวจสอบที่จำเป็นต่อการยอมรับงาน
| หมวดหมู่ | ตัวอย่างงาน | หลักฐานเพื่อการยอมรับงาน |
|---|---|---|
| แก้บั๊ก (Bug fix) | แก้ไขการจัดการขอบเขต cursor ให้ถูกต้อง | Regression test และชุดการทดสอบเดิมผ่านทั้งหมด |
| เพิ่มฟังก์ชันย่อย (Small addition) | เพิ่มตัวกรอง request แบบระบุหรือไม่ก็ได้ (optional request filtering) | Contract tests ผ่านและมีเอกสารระบุค่าเริ่มต้น (documented defaults) |
| รีแฟกเตอร์โค้ด (Refactor) | แยก logic การตรวจสอบความถูกต้อง (validation) ที่ซ้ำซ้อนออกมา | Public behavior ยังคงเดิมและผ่านการรีวิวโค้ด |
| สืบค้นหาสาเหตุ (Investigation) | วินิจฉัยหาสาเหตุของปัญหา timeout ที่เกิดขึ้นเป็นครั้งคราว | จำลองปัญหาซ้ำได้ (reproduction) และมีคำอธิบายสาเหตุพร้อมหลักฐานสนับสนุน |
ใช้งานขนาดเล็กเมื่อต้องการการเปรียบเทียบที่ตรงไปตรงมาและวัดผลได้ชัดเจน ส่วนงานขนาดใหญ่ควรใช้เมื่อโจทย์รวมถึงเรื่องการทำงานประสานกัน (coordination) ด้วย และให้ประเมินคะแนนการทดลองดังกล่าวแยกต่างหาก
ตรึงเงื่อนไขและสภาพแวดล้อมให้คงที่ก่อนเริ่มรันเอเจนต์
บันทึก commit ของ repository, ระบบปฏิบัติการ, lockfile ของ dependencies, เวอร์ชันของเครื่องมือ, รหัสระบุโมเดล (model identifier) และการตั้งค่าต่าง ๆ เอาไว้ให้ครบถ้วน รวมถึงล็อกเวอร์ชันของ agent harness ด้วย โดย harness คือซอฟต์แวร์ที่คอยจัดเตรียมเครื่องมือ บริบท และควบคุมพฤติกรรมการทำงานรอบตัวโมเดล
เปรียบเทียบ Fable 5.2 กับกระบวนการทำงานปัจจุบันของคุณ หากเป็นการเปรียบเทียบระหว่างโมเดล ควรใช้ harness เดียวกันเท่าที่รองรับได้ แต่หากเป็นการเปรียบเทียบกระบวนการทำงาน (workflow) ก็สามารถใช้เครื่องมือที่แตกต่างกันได้ เพียงแต่ข้อสรุปจะต้องระบุรายละเอียดการตั้งค่าทั้งหมดไว้อย่างครบถ้วน
กำหนดสิทธิ์การเข้าถึง การเชื่อมต่อเครือข่าย บริบทเริ่มต้น และการจำกัดเวลาให้เท่าเทียมกัน ตลอดจนกำหนดให้ชัดเจนว่าการติดตั้ง dependency จะนับรวมในเวลาที่ใช้จริงหรือไม่ อย่าปล่อยให้การทดสอบของ configuration หนึ่งได้รับผลพลอยได้จากไฟล์ที่ถูกแก้ไข แคชที่มีคำตอบอยู่แล้ว หรือประวัติการสนทนาจากการรันครั้งก่อนหน้า
ใช้โค้ดที่ checkout ใหม่หรือใช้ worktree ที่แยกจากกันในแต่ละรอบการทดสอบ โดยเอกสารประกอบของ Git worktree ได้อธิบายวิธีแชร์ repository ระหว่าง working tree หลายตัวไว้แล้ว ทั้งนี้ การแยกไฟล์ไม่ได้หมายถึงการแยกฐานข้อมูล พอร์ต หรือบริการภายนอกออกจากกัน ดังนั้นจึงควรจัดเตรียม resource ทดสอบแยกสำหรับส่วนเหล่านี้ด้วยเช่นกัน
กำหนดกฎการเข้าแทรกแซงของมนุษย์ให้ชัดเจน ตัวอย่างเช่น อนุญาตให้ตอบคำถามเพื่อชี้แจงได้หนึ่งครั้ง โดยต้องระบุเฉพาะข้อมูลที่ทุก configuration เข้าถึงได้เท่ากัน และบันทึกเวลาที่ใช้ในการแทรกแซงทั้งหมด เพราะหากผู้รีวิวแอบช่วยแก้ไขโค้ดที่เอเจนต์ทำไว้ สิ่งที่วัดผลได้ในการทดลองจะเปลี่ยนไปทันที
รันการทดสอบแบบจับคู่และเก็บข้อมูลความล้มเหลวไว้ทั้งหมด
ทดสอบแต่ละ configuration กับชุดงานเดียวกัน และสลับลำดับการรัน เพื่อไม่ให้ปัญหาบริการชะลอตัวชั่วคราวส่งผลดีต่อฝั่งใดฝั่งหนึ่งอย่างมีนัยสำคัญ ทำการทดสอบซ้ำเมื่อมีทรัพยากรเพียงพอ โดยกำหนดจำนวนรอบการทดสอบซ้ำไว้ล่วงหน้าก่อนที่จะเปิดดูผลลัพธ์
สำหรับการทดลองนำร่องในทางปฏิบัติ อาจเริ่มที่ 3 รอบต่อหนึ่ง configuration ต่องาน ซึ่งควรถือว่านี่เป็นจุดเริ่มต้นเชิงวิศวกรรมเท่านั้น เพราะกลุ่มตัวอย่างขนาดเล็กไม่สามารถนำมาใช้อ้างอิงข้อสรุปที่แม่นยำเกี่ยวกับความล้มเหลวที่เกิดขึ้นไม่บ่อย หรือการันตีว่าโมเดลใดเหนือกว่าในทุกด้านได้อย่างสมบูรณ์
บันทึก prompt, configuration, เวลา (timestamps), บทสนทนา (transcript), patch, ผลลัพธ์จากเครื่องมือ (tool output) และข้อสรุปผลลัพธ์ขั้นสุดท้ายในทุกรอบการทดสอบ พร้อมทั้งบันทึกกรณีที่เกิด timeout หรือการรันที่ถูกยกเลิกเป็นผลลัพธ์ด้วย การตัดกรณีเหล่านี้ทิ้งจะทำให้รอบที่สำเร็จดูมีต้นทุนต่ำกว่าและเร็วกว่าความเป็นจริงเมื่อเทียบกับกระบวนการทำงานที่คุณจะนำไปปรับใช้จริง
แยก test fixtures และ credentials ออกจากสภาพแวดล้อมจริง (production) อย่างเด็ดขาด และปฏิบัติตามขั้นตอนการทดสอบเดิมของ repository สำหรับ repository ภาษา Python เอกสารประกอบของ pytest ได้อธิบายเกี่ยวกับการใช้ fixture และการรันชุดการทดสอบไว้ แต่ตัวเฟรมเวิร์กเองไม่สามารถตัดสินแทนคุณได้ว่าเกณฑ์การยอมรับงานนั้นครอบคลุม requirement ทั้งหมดแล้วหรือไม่
ตรวจทานความถูกต้องก่อนพิจารณาความเร็ว
ให้ผู้รีวิวตรวจสอบ patch โดยไม่เห็นชื่อโมเดล (blind review) เท่าที่สามารถทำได้ และใช้เกณฑ์การประเมินที่กำหนดไว้แน่นอน ซึ่งครอบคลุมทั้งการตอบโจทย์ requirement, ความเสี่ยงต่อการเกิด regression, ความง่ายต่อการดูแลรักษา (maintainability), คุณภาพของชุดการทดสอบ ตลอดจนการแก้ไขที่เกินขอบเขตโดยไม่จำเป็น
แม้การทดสอบที่ผ่านจะเป็นสิ่งจำเป็นเมื่อโจทย์กำหนด แต่ชุดการทดสอบก็อาจเขียนขึ้นมาผิดจากพฤติกรรมที่ถูกต้องได้เช่นกัน จึงควรตรวจสอบ assertion เทียบกับ requirement เดิม ระวังการปิดคำสั่งตรวจสอบ (disabled checks) การขยายค่าเผื่อ (widened tolerances) การดักจับ error แล้วกลืนทิ้ง (swallowed errors) หรือการแก้โค้ดเพื่อหลบเลี่ยง path ที่เคยล้มเหลว
จำแนกผลการตัดสินออกเป็น 3 สถานะ ได้แก่: ยอมรับโดยไม่ต้องแก้ไข (accepted unchanged), ยอมรับหลังได้รับการซ่อมแซม (accepted after repair) และปฏิเสธ (rejected) พร้อมทั้งบันทึกเวลาที่ใช้ในการซ่อมแซมเป็นนาทีและลักษณะของการแก้ไขแต่ละครั้ง และกำหนดไว้ล่วงหน้าว่างานที่ต้องซ่อมแซมก่อนจะนับรวมในอัตราการยอมรับงานหลัก (primary acceptance rate) หรือไม่
สำหรับงานสืบค้นหาสาเหตุ ให้ประเมินคะแนนจากลำดับความเชื่อมโยงของหลักฐาน (evidence chain) รายงานที่ดีควรระบุสิ่งที่สังเกตพบ แยกแยะสมมติฐานต่าง ๆ ออกจากกัน และให้ขั้นตอนในการจำลองปัญหาซ้ำเพื่อนำไปดำเนินการต่อได้ อย่าให้คะแนนเพียงเพราะการวินิจฉัยที่ฟังดูมั่นใจแต่ปราศจากหลักฐานรองรับ
คำนวณต้นทุนต่อหนึ่งการเปลี่ยนแปลงที่ผ่านการยอมรับ
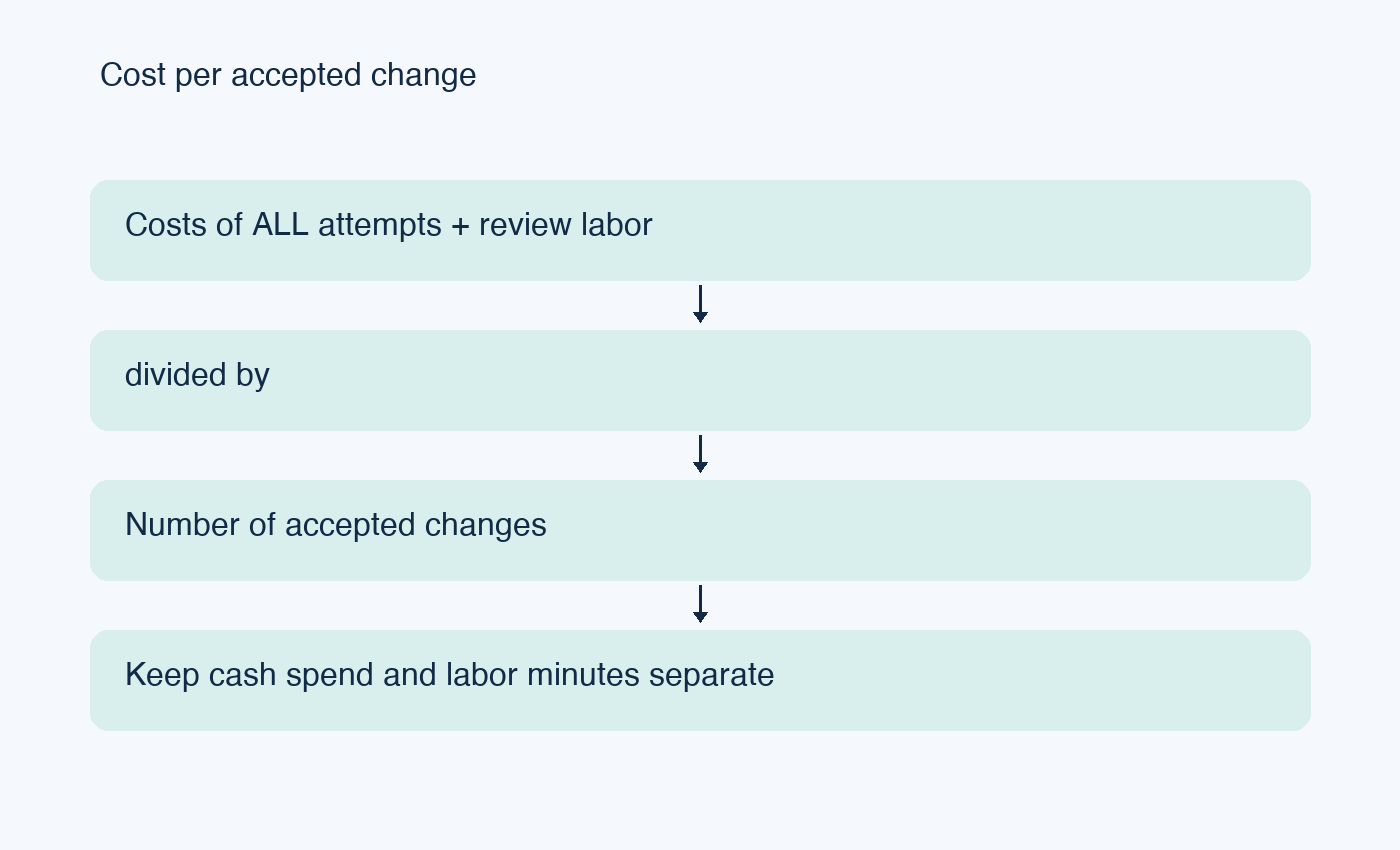
ต้นทุนต่อหนึ่งการเปลี่ยนแปลงที่ผ่านการยอมรับ คำนวณโดยนำต้นทุนการประเมินทั้งหมดหารด้วยจำนวนการเปลี่ยนแปลงที่ได้รับการยอมรับตามกฎที่คุณกำหนดไว้ล่วงหน้า โดยต้องรวมรอบการทดสอบที่ล้มเหลวไว้ในตัวตั้งด้วย หากไม่มีการเปลี่ยนแปลงใดได้รับการยอมรับเลย ให้รายงานเป็นยอดต้นทุนร่วมกับการยอมรับเป็นศูนย์ เนื่องจากอัตราส่วนดังกล่าวไม่มีค่าจำกัด (finite value)
ติดตามตัวชี้วัดเหล่านี้ควบคู่กันไป:
- อัตราการยอมรับงานตามหมวดหมู่งาน
- เวลาจริง (wall-clock time) ตั้งแต่เริ่มงานจนได้ผลลัพธ์ที่พร้อมสำหรับการรีวิว
- เวลาของมนุษย์ที่ใช้ในการรีวิวและซ่อมแซม (เป็นนาที)
- ค่าใช้จ่ายของโมเดลและเครื่องมือในการทดสอบทุกรอบ
- ต้นทุนโครงสร้างพื้นฐาน (infrastructure) ในส่วนที่มีนัยสำคัญ
- ปัญหา regression ที่ตรวจพบในระหว่างช่วงเวลาสังเกตการณ์
บันทึกการใช้งานโทเคน (token usage) และแหล่งอ้างอิงราคาพร้อมระบุวันที่ ควบคู่ไปกับยอดเงินที่เรียกเก็บจริง ทั้งนี้ cached tokens การ retry และเครื่องมือประมวลผลคำสั่งสามารถทำให้ต้นทุนเปลี่ยนแปลงได้ จึงไม่ควรประเมินค่าใช้จ่ายจากความยาวของผลลัพธ์ (output) เพียงอย่างเดียว
หากคุณกำหนดมูลค่าทางการเงินให้กับเวลาของผู้รีวิว ให้ระบุไว้ชัดเจนว่าเป็นสมมติฐานภายใน และควรแสดงค่าใช้จ่ายที่เป็นตัวเงินแยกจากเวลาการทำงานของทีมเป็นนาที เพื่อให้ผู้อ่านสามารถนำไปคำนวณเปรียบเทียบใหม่ได้ตามความเหมาะสม เพราะโมเดลที่สร้างผลลัพธ์ได้ถูกกว่า อาจยังคงต้องการการดูแลและแก้ไขจากวิศวกรมากกว่าก็เป็นได้
จัดเก็บหลักฐานการประเมินควบคู่ไปกับตัวงาน
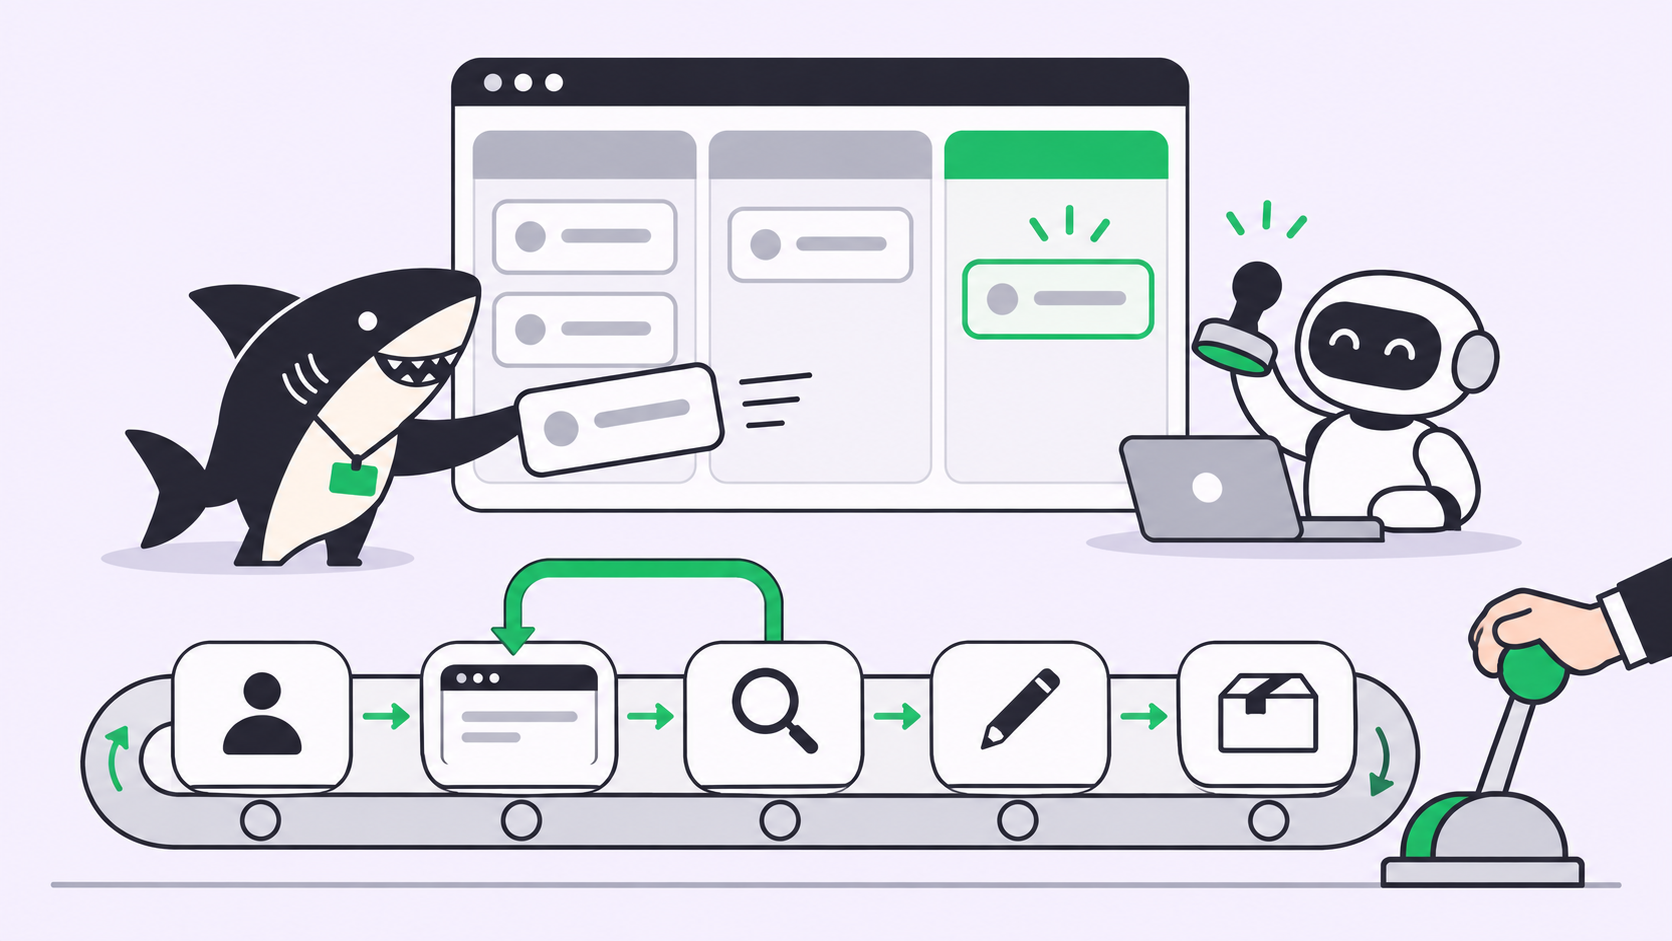
Sharkly ช่วยบริหารจัดการกระบวนการทำงานรอบตัว coding agents โดยเวิร์กโฟลว์ตามเอกสารจะเชื่อมโยง Tasks, Agents, Computers, execution context และการรีวิวของมนุษย์เข้าด้วยกัน สามารถดูรายละเอียดคำศัพท์เฉพาะของผลิตภัณฑ์และการตั้งค่าปัจจุบันได้ที่เอกสารประกอบของ Sharkly
สำหรับการทดลองนี้ ให้ใส่เกณฑ์การยอมรับไว้ในแต่ละ Task แล้วส่ง patch, หลักฐานการทดสอบ และผลลัพธ์กลับมายังบันทึกงานชิ้นเดียวกัน คุณอาจบันทึกบัญชีการประเมินผล (evaluation ledger) ไว้ในสเปรดชีตหรือไฟล์ข้อมูลที่มีการคุมเวอร์ชันหากสะดวกต่อการวิเคราะห์ที่สุด แต่อย่าทึกทักเอาเองว่าแพลตฟอร์มจะคำนวณเมตริกการทดลองให้คุณโดยอัตโนมัติ
ใช้ Agent เพียงตัวเดียวสำหรับการทดสอบที่มีขอบเขตชัดเจน และให้เริ่มนำ Crew เข้ามาใช้เฉพาะเมื่อเรื่องการทำงานประสานกันเป็นส่วนหนึ่งของการประเมินเท่านั้น เนื่องจากการเปลี่ยนโครงสร้างทีมระหว่างทางจะทำให้มีตัวแปรแทรกซ้อนเพิ่มขึ้นมา
เอเจนต์มีหน้าที่ประมวลผลและรายงานหลักฐาน ส่วนมนุษย์มีหน้าที่กำหนดเกณฑ์การยอมรับ ตรวจสอบการเปลี่ยนแปลง และอนุมัติการ release ซึ่งการแบ่งหน้าที่เช่นนี้ยังคงมีประโยชน์อย่างยิ่ง แม้ว่าโค้ดจะผ่านการตรวจสอบอัตโนมัติทุกขั้นตอนแล้วก็ตาม
ตัดสินใจเลือกนำไปใช้ตามหมวดหมู่งาน
กำหนดเกณฑ์ในการตัดสินใจนำมาใช้งานก่อนที่จะเปิดดูผลลัพธ์ โดยต้องยึดความถูกต้องในระดับที่ยอมรับได้เป็นเกณฑ์แรก จากนั้นจึงค่อยเปรียบเทียบต้นทุนและเวลาที่ใช้ระหว่าง configuration ที่ผ่านเกณฑ์ดังกล่าว และควรแยกหมวดหมู่ที่อ่อนไหวต่อความปลอดภัยหรือมีชุดการทดสอบครอบคลุมไม่เพียงพอออกจากการเปิดตัวใช้งานในระยะแรก
รายงานจำนวนที่แท้จริงควบคู่ไปกับเปอร์เซ็นต์เสมอ เพราะผลลัพธ์ที่ผ่านการยอมรับ 2 ใน 3 งาน ย่อมสื่อความหมายต่างจากการผ่าน 200 ใน 300 งานอย่างสิ้นเชิง ควรอธิบายถึงความไม่แน่นอนและรูปแบบความล้มเหลวที่พบ แทนที่จะด่วนสรุปหาผู้ชนะในทุกสถานการณ์
ทำการประเมินซ้ำเมื่อมีการเปลี่ยนแปลงที่มีนัยสำคัญต่อ prompt, harness, เวอร์ชันของโมเดล หรือโครงสร้างของ repository พร้อมทั้งเก็บรักษา configuration เดิมไว้ เพื่อให้การพัฒนาปรับปรุงในอนาคตมี baseline ที่สามารถจำลองซ้ำได้
เริ่มต้นด้วยงานดูแลรักษาระบบที่เป็นตัวแทนงานจริงสักหนึ่งงานใน Sharkly พร้อมแนบเกณฑ์การยอมรับที่ชัดเจน แล้วนำหลักฐานที่ได้กลับมาเปรียบเทียบกับกระบวนการทำงานปัจจุบันของคุณ จากนั้นจึงค่อยขยายผลหลังจากที่คุณสามารถอธิบายเหตุผลเบื้องหลังทั้งความสำเร็จและความล้มเหลวได้อย่างชัดเจนแล้ว
คำถามที่พบบ่อย (FAQ)
Benchmark การเขียนโค้ดที่เป็นสาธารณะสามารถนำมาใช้แทนการประเมินนี้ได้หรือไม่?
Benchmark ดังกล่าวอาจช่วยคุณคัดเลือกตัวเลือกเบื้องต้นได้ แต่ไม่ได้ครอบคลุมถึงแนวทางปฏิบัติ (conventions), dependencies, ความคาดหวังในการรีวิว หรือข้อจำกัดในการดำเนินงานของ repository คุณ
การทดสอบทุกรอบควรใช้ prompt เดียวกันทั้งหมดหรือไม่?
ควรใช้ข้อมูลงานที่เทียบเท่ากันและกำหนดนโยบายการเขียน prompt ไว้ล่วงหน้า พร้อมทั้งบันทึก prompt wrapper เฉพาะของแต่ละเครื่องมือไว้ เพื่อให้สามารถตรวจสอบความแตกต่างได้ในภายหลัง
patch ที่ต้องได้รับการซ่อมแซมก่อนจะนับเป็นความสำเร็จหรือไม่?
ควรกำหนดกฎเกณฑ์ไว้ล่วงหน้า และรายงานผลการยอมรับแบบต้องซ่อมแซมแยกต่างหากจากการยอมรับโดยไม่ต้องแก้ไข รวมถึงนำเวลาที่ใช้ในการซ่อมแซมไปคิดคำนวณในการเปรียบเทียบกระบวนการทำงานด้วย
ควรให้คะแนนกรณีเกิด timeout อย่างไร?
ให้นับเป็นความล้มเหลวภายใต้กรอบเวลาที่กำหนดไว้ และรวมค่าใช้จ่ายรวมถึงเวลาที่ใช้ไปของรอบนั้น ๆ เข้าไปในผลลัพธ์ด้วย
ทีมควรเริ่มขยายการนำไปใช้งานจริงเมื่อใด?
ควรขยายผลเมื่อหมวดหมู่งานนั้นผ่านเกณฑ์การยอมรับของคุณอย่างสม่ำเสมอจากการทดสอบซ้ำหลายครั้ง และผู้รีวิวเข้าใจรูปแบบความล้มเหลว (failure modes) ที่เกิดขึ้นซ้ำ ๆ ได้เป็นอย่างดีแล้ว
แหล่งข้อมูลเพิ่มเติม
อ่านเอกสารประกอบของ Git เกี่ยวกับการแยกสภาพแวดล้อม repository, คู่มือ pytest fixtures สำหรับการจัดเตรียมการทดสอบภายใต้การควบคุม และ Sharkly สำหรับการจัดระเบียบงานของเอเจนต์และการรีวิวโดยมนุษย์