
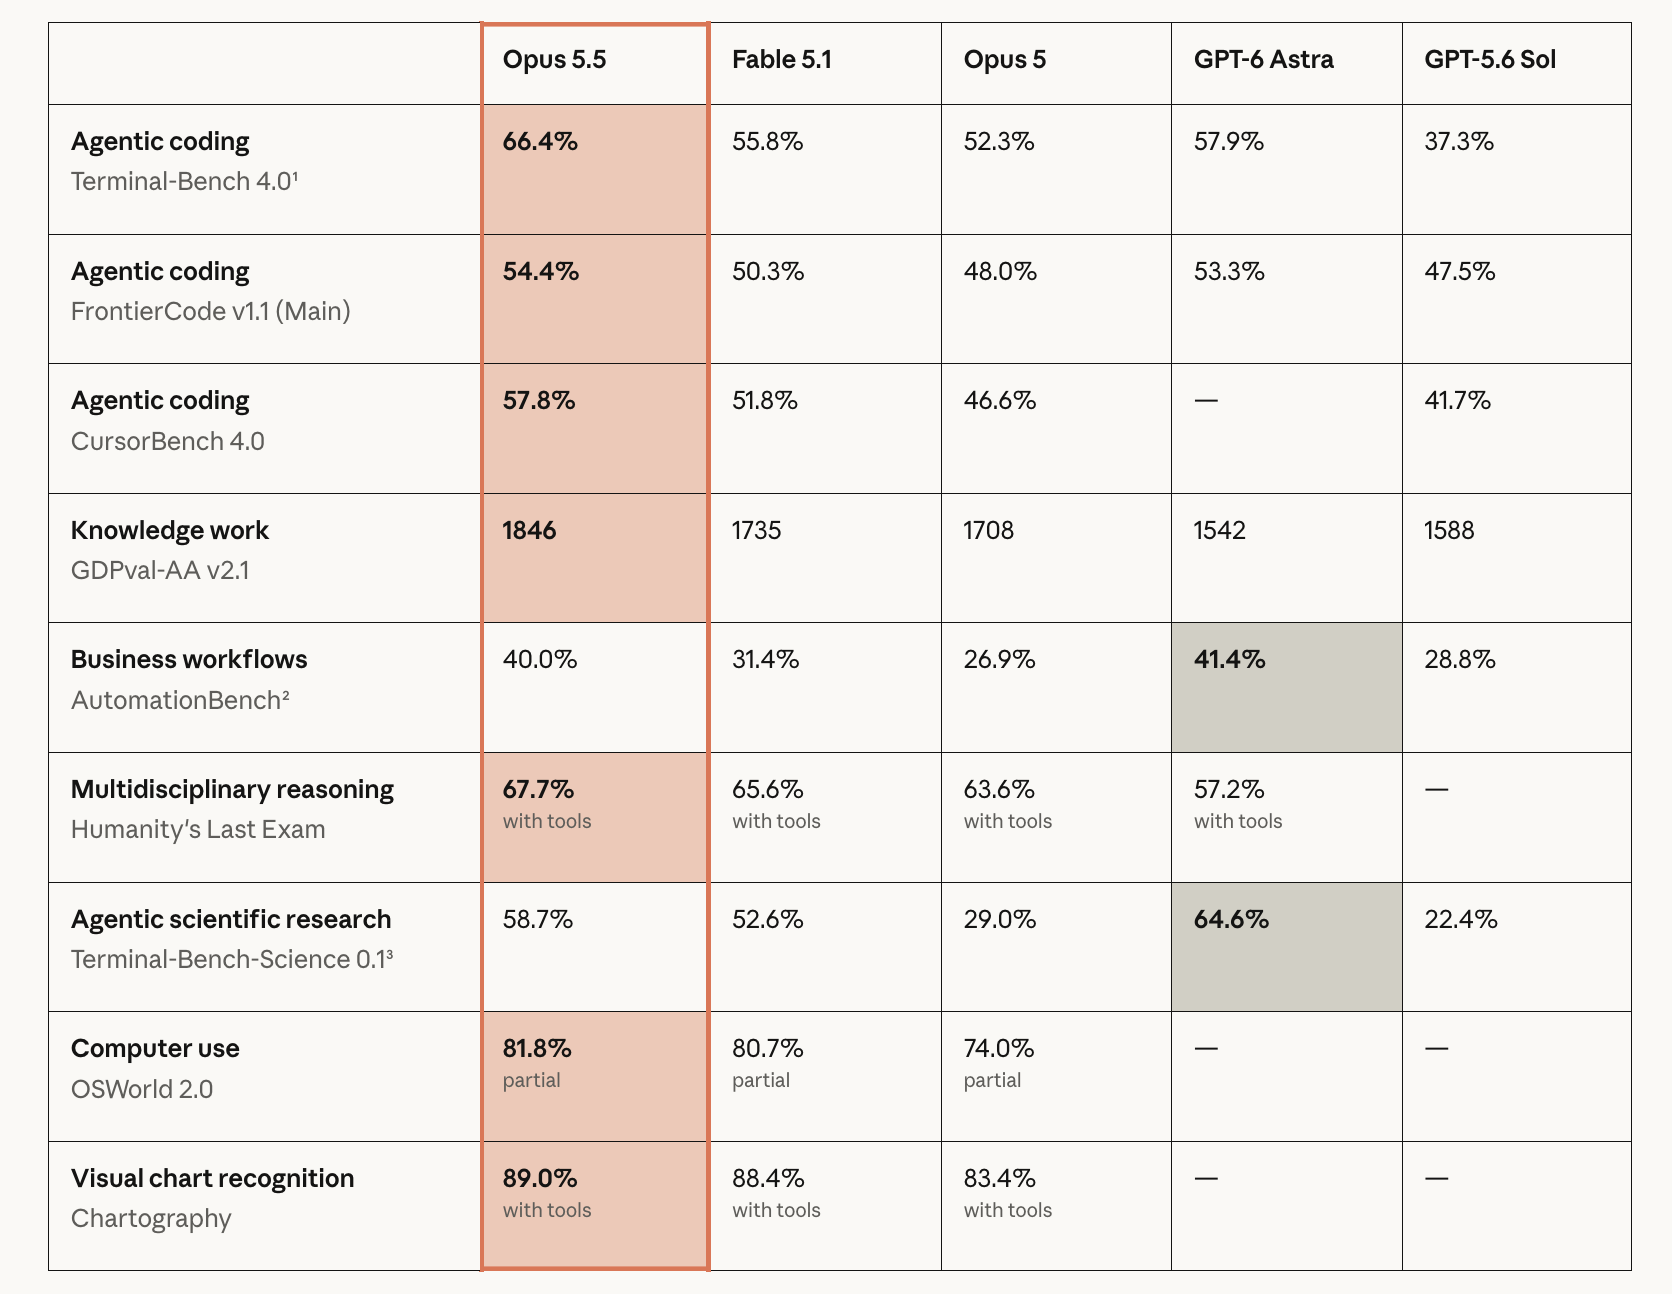
Anthropic เปิดตัว Claude Opus 5.5 เมื่อวันที่ 22 กันยายน สิ่งที่ทีมซึ่งรัน coding agent หลายตัวอยู่แล้วควรสนใจไม่ได้อยู่ในตาราง benchmark แต่คือเรื่องเหล่านี้ Anthropic ระบุว่าโมเดลนี้มีต้นทุนการรันต่ำกว่า Opus 5 อยู่ 40% ให้ผลลัพธ์เร็วกว่าประมาณ 30% และทำงานต่อเนื่องได้ 18 ชั่วโมงขึ้นไป ราคาตั้งอยู่ที่ 4 ดอลลาร์ต่ออินพุต 1 ล้านโทเคน และ 20 ดอลลาร์ต่อเอาต์พุต 1 ล้านโทเคน เทียบกับ 5 และ 25 ดอลลาร์ของ Opus 5
โมเดลที่ถูกลงและทำงานได้นานขึ้นโดยไม่หยุดไม่ได้ทำให้สัปดาห์ของคุณง่ายขึ้นเลย มันหมายความว่าจะมีงานที่เสร็จแล้วไหลมาถึงมือนักตรวจทานจำนวนเท่าเดิมมากขึ้น การเอา Opus 5.5 ขึ้นบอร์ดเป็นงานแค่สิบนาที แต่การตัดสินใจว่าบอร์ดจะทำอะไรกับ throughput ที่เพิ่มขึ้นต่างหากคืองานจริง คู่มือนี้จะพาคุณเดินเส้นทางที่สั้นและมีประโยชน์ที่สุดผ่านส่วนแรก และจะพูดตรง ๆ เกี่ยวกับส่วนที่สอง นั่นคือ เอา Opus 5.5 ไปใส่ใน Claude Code บน Computer หนึ่งเครื่อง สร้าง Agent หนึ่งตัว มอบหมาย Task จริงหนึ่งงาน
TL;DR
ตั้งค่า claude-opus-5-5 เป็นโมเดลใน Claude Code บน Computer ที่เชื่อมต่ออยู่ ตรวจสอบว่า Runtime ขึ้นสถานะ Available สร้าง Agent ที่มี timeout ต่อ Task ให้สอดคล้องกับระยะเวลาที่ Opus 5.5 จะทำงานจริง ตั้ง working directory เป็น Temporary แล้วมอบหมาย Task หนึ่งงาน Sharkly จะไม่แสดงชื่อโมเดล แต่จะแสดงการรัน บันทึก คำถาม และผลลัพธ์บน Task นั้น Agent จะค้นคว้า ลงมือทำ ทดสอบ และรายงาน ส่วนคนเป็นผู้กำหนดทิศทาง ให้อำนาจ และรับผลลัพธ์
การตั้งค่าโมเดลอยู่ตรงไหน
Sharkly ไม่ได้เป็นตัวเลือกโมเดล เอกสาร Agents ระบุไว้ตรง ๆ ว่า “Agent จะใช้โมเดลเริ่มต้นของ Runtime ไม่มีการรับประกันหรือแสดงชื่อโมเดลใดเป็นเฉพาะ เปลี่ยนโมเดลได้ที่การตั้งค่าเครื่องมือของ Runtime หรือ Computer ไม่ใช่ที่ Agent”
นี่คือขอบเขตที่ควรพูดไว้ก่อนที่คุณจะไปตามหาดรอปดาวน์ที่ไม่มีอยู่จริง มีสี่บทบาท แต่ละบทบาทมีหน้าที่เดียว Agent กำหนดว่างานควรถูกจัดการอย่างไร Computer จัดหาทรัพยากรโฮสต์และทรัพยากรภายในเครื่อง Runtime ทำหน้าที่รันเซสชันของ agent จริง ๆ และในที่นี้ Claude Code คือ Runtime ส่วน Task ยังคงเป็นบันทึกร่วมของทีม Opus 5.5 เข้าสู่ Sharkly เหมือนโมเดลอื่นทุกตัว คือผ่านเครื่องมือที่รันมัน ซึ่งตั้งค่าบนโฮสต์ที่รันเครื่องมือนั้น
ขั้นตอนที่ 1: ใส่ Opus 5.5 ใน Claude Code บน Computer
บน Computer ที่จะใช้รัน อัปเดต Claude Code แล้วลงชื่อเข้าใช้ด้วยบัญชีหรือ API key ที่เข้าถึง Opus 5.5 ได้ Anthropic ระบุว่าโมเดลนี้มีให้ใช้บน Claude Platform, Amazon Web Services, Google Cloud และ Microsoft Azure ดังนั้นทีมที่ใช้ผู้ให้บริการคลาวด์ก็ชี้ Claude Code ไปที่นั่นแทนได้ หากคำสั่ง claude --model claude-opus-5-5 เปิดเซสชันได้ในเทอร์มินัลธรรมดาบนโฮสต์นั้น Sharkly ก็ใช้งานได้
จากนั้นตั้งค่าเริ่มต้นเพื่อให้ทุกการรันบน Computer เครื่องนี้ใช้โมเดลนี้:
// ~/.claude/settings.json
{
  "model": "claude-opus-5-5"
}
ตรวจสอบชื่อคีย์การตั้งค่าที่แน่นอนและเวอร์ชัน Claude Code ขั้นต่ำกับเอกสารอ้างอิงการตั้งค่า Claude Code ฉบับปัจจุบัน ก่อนที่จะนำไปใช้กับ Computer ที่ใช้ร่วมกัน [VERIFY]
กลับมาที่ Sharkly เปิดหน้ารายละเอียด Computer แล้วกด rescan หรือทดสอบการเชื่อมต่อ Runtime ของ Claude Code ควรขึ้นสถานะ Available การที่ Computer แสดงว่า online เท่านั้นหมายความว่าเซอร์วิสภายในเครื่องกำลังส่งสัญญาณ heartbeat อยู่ สถานะความสามารถของ Runtime ต่างหากที่บอกคุณว่าการรันจะเริ่มต้นได้
Computer เดียว สองระดับโมเดล Agent ไม่มีตัวเลือกโมเดล แต่มี environment variable แบบธรรมดาและแบบ secret รวมถึง Runtime argument เพิ่มเติมที่ส่งต่อไปถึงตอนเรียกใช้ Runtime ได้ นี่คือวิธีที่คุณตั้งค่าเริ่มต้นแบบประหยัดไว้บน Computer และใส่ Opus 5.5 เฉพาะ Agent ที่ต้องการจริง ๆ แทนที่จะจ่ายราคาระดับหัวหน้าทีมสำหรับงานคัดกรองทุกงาน ลองทดสอบกับ Agent ตัวเดียวก่อนที่จะทำเป็นมาตรฐาน [VERIFY]
ขั้นตอนที่ 2: สร้าง Agent ให้สอดรับกับพฤติกรรมของ Opus 5.5
เปิดหน้า Agents เลือก New Agent แล้วเลือก Computer และ Runtime ของ Claude Code จากนั้นตั้งค่าสามอย่างที่สำคัญกับโมเดลนี้มากกว่าโมเดลก่อนหน้า
Timeout ต่อ Task Anthropic ระบุว่า Opus 5.5 ทำงานต่อเนื่องได้ 18 ชั่วโมงขึ้นไป timeout ที่ตั้งไว้สำหรับแก้บั๊ก 20 นาทีจะทำให้การรันถูกตัดจบกลางทางและได้บันทึกที่อ่านไม่รู้เรื่อง เพิ่มค่า timeout แบบเจาะจงเฉพาะที่จำเป็น ไม่ใช่เพิ่มทุกที่ ตั้ง timeout ยาวกับ Agent ที่ทำงาน migration และ refactor ขนาดใหญ่ และตั้งสั้นกับ Agent ที่แก้บั๊ก frontend เล็ก ๆ การตั้ง timeout ยาวกับ Agent ที่ทำงานแคบ ๆ ส่วนใหญ่มีแต่ทำให้ความล้มเหลวช้าลงเท่านั้น
Working directory ใช้โหมด Temporary แต่ละ Task จะได้ไดเรกทอรีแยกของตัวเอง และการรันที่ผูกกับ repository จะเตรียม worktree ใหม่ให้ ทำให้การรัน Opus 5.5 สองรายการบน repository เดียวกันเขียนทับกันไม่ได้ สำหรับไดเรกทอรีแบบ temporary ค่า concurrency เริ่มต้นคือ 50% ของขีดจำกัดของ Computer ปล่อยไว้แบบนั้นจนกว่า Computer จะรับงานจริงมาสักสองสามรอบ
ขนาดเอาต์พุต Opus 5.5 รองรับเอาต์พุตได้ถึง 128k โทเคนในการตอบหนึ่งครั้ง การรันที่ปล่อยให้ทำงานหลายชั่วโมงแล้วตอบยาวขนาดนั้นจะคืน diff ที่ไม่มีใครอ่านอย่างละเอียด กำหนดขอบเขต Task ให้ผลลัพธ์ตรวจสอบได้ ไม่ใช่เพื่อให้โมเดลยุ่งไว้
คำสั่งควรสั้นและคงที่:
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior.
Ask a question only when different interpretations would
materially change the result; otherwise proceed with a stated
assumption and record it in your report.
Run the closest relevant checks and report failures without hiding them.
Stop and ask before anything destructive or outside the repositories
attached to this Agent.
ขั้นตอนที่ 3: มอบหมาย Task หนึ่งงาน แล้วค่อยชี้ Crew เข้าไป
เลือก Task ที่มีเกณฑ์การยอมรับชัดเจน ตั้ง Agent เป็น Assignee แล้วย้าย Task ออกจาก Backlog ไปยังสถานะที่อยู่ในหมวดพร้อมทำงาน Task ที่มอบหมายไว้ใน Backlog จะรออยู่เฉย ๆ การรันจะไล่จาก queued ไป dispatched แล้ว running และแท็บ Executions จะสตรีมบันทึกให้ดู
ใช้ Agent ตัวเดียวสำหรับ Task แรกนี้ Crew คือกลุ่มของ People และ Agent ที่นำกลับมาใช้ซ้ำได้ โดยมี leader Agent คอยประสาน และจะคุ้มค่าก็ต่อเมื่อ leader ต้องตีความเป้าหมายและรวบรวมผลลัพธ์จากสมาชิกหลายตัวกลับมาไว้ใน Task เดียว สำหรับการเปลี่ยนแปลงที่มีขอบเขตชัดเจน Agent ตัวเดียวคือคำตอบที่ถูก และไม่มีชิ้นส่วนใดต้องขยับเลย
เมื่อ Crew คุ้มค่าจริง ๆ Opus 5.5 ก็เป็น leader ที่สมเหตุสมผลกว่าเมื่อเทียบกับราคาอีกขั้นก่อนหน้านี้ งานของ leader ส่วนใหญ่คืออ่าน วางแผน มอบหมาย และตรวจทาน ซึ่งเป็นรูปแบบงานที่อธิบายเหตุผลได้ยากที่สุดเมื่อราคาอยู่ในระดับสูงสุดของตาราง:
| โมเดล Runtime | API id | อินพุต / เอาต์พุตต่อ 1M | ตำแหน่งที่เหมาะใน Crew |
|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 |
$4 / $20 | Leader, ผู้ตรวจทาน, งาน migration ยาว ๆ |
| Claude Opus 5 | claude-opus-5 |
$5 / $25 | ค่าเริ่มต้นเดิมที่โมเดลนี้เข้ามาแทน |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | Runtime ตัวที่สองสำหรับสมาชิกที่ทำงานประจำ |
การอ่านอินพุตจากแคชบน Opus 5.5 อยู่ที่ 0.20 ดอลลาร์ต่อล้าน และการเขียนแคชอยู่ที่ 5 ดอลลาร์ ซึ่งเป็นตัวตัดสินว่าเซสชันยาว ๆ ที่อ่าน repository prefix เดิมซ้ำ ๆ จะถูกหรือแพง และยังมีโหมด fast ที่ราคา 8 และ 40 ดอลลาร์สำหรับเวลาที่ความหน่วงสำคัญกว่าต้นทุน การใช้งานโมเดลจะคิดผ่าน subscription หรือ API key ที่ตั้งค่าไว้ในเครื่องมือเหล่านั้น ดังนั้นอัตราเหล่านี้จะไปอยู่บนบิลของผู้ให้บริการของคุณ ไม่ใช่ของ Sharkly
สิ่งที่เปลี่ยนไปจริง ๆ บนบอร์ด
มีสามอย่าง และมีเพียงอย่างเดียวที่เกี่ยวกับตัวโมเดล
การรันถูกลง แต่การตรวจทานไม่ อัตราค่าโทเคนลดลง 20% และต้นทุนการรันต่ำกว่า Opus 5 อยู่ 40% หมายความว่างบประมาณรายเดือนเท่าเดิมจะซื้อการรัน agent ได้มากขึ้นในสัปดาห์นี้เทียบกับสัปดาห์ก่อน แต่ไม่มีอะไรในประโยคนั้นที่เพิ่มชั่วโมงของนักตรวจทานเลย ข้อจำกัดของทีมที่ใช้ multi-agent ไม่เคยอยู่ที่ต้นทุนโมเดล แต่อยู่ที่ว่าคนหนึ่งคนรับ diff ที่เสร็จแล้วได้จริงกี่ชิ้นต่อวันต่างหาก โมเดลที่ถูกลงยิ่งทำให้ข้อจำกัดนั้นตึงขึ้น วางแผนโดยคำนึงถึง ขีดความสามารถในการตรวจทาน ไม่ใช่การเลือกโมเดล
การรันยาว ๆ เปลี่ยนความหมายของการกำกับดูแล agent ที่ถือ task ไว้เกือบทั้งวันไม่อาจกำกับดูแลได้ด้วยการนั่งจ้องเทอร์มินัล คุณต้องมีสถานะที่อ่านปราดเดียวก็เข้าใจ มีคำถามที่ส่งถึงคนได้จริงไม่ใช่เลื่อนผ่านไป และมีที่ให้ผลลัพธ์ไปลง ใน Sharkly คำถามจะกลับไปที่ Task ในรูปคอมเมนต์ Task จะแสดงว่ากำลังรอคำตอบจากคน และจะถูกส่งต่อไปยัง Inbox ของคุณ
การหลบเลี่ยงขอบเขตที่สำเร็จน้อยลงถือเป็นความคืบหน้า ไม่ใช่ราวกันตก Anthropic รายงานว่ามีความพยายามหลบเลี่ยงขอบเขตที่สำเร็จน้อยกว่า Opus 5 ถึง 85% นั่นเป็นการพัฒนาพฤติกรรมจริง แต่ไม่ใช่ระบบสิทธิ์การเข้าถึง สิ่งที่กำหนดขอบเขตของการรันคือ repository ที่ผูกกับ Agent, environment variable ของมัน และขั้นตอนการยอมรับโดยคน ปล่อยให้พฤติกรรมที่ดีขึ้นของโมเดลเป็นชั้นป้องกันชั้นที่สอง ไม่ใช่ชั้นเดียว
เมื่อการรันหยุดก่อนกำหนด
การรันที่จบก่อนกำหนดไม่ได้สูญเปล่า เปิดบันทึกการทำงาน อ่านหัวข้อและรายละเอียดทางเทคนิค แล้วรันใหม่จาก Task ด้วยขอบเขตที่แคบลง ไดเรกทอรีและบันทึกของ Task ยังอยู่ ดังนั้นความพยายามครั้งต่อไปจะเริ่มจากหลักฐาน ไม่ใช่จากความจำ คุม Task ให้เล็กพอที่การหยุดหนึ่งครั้งจะเสียเวลาแค่ไม่กี่นาที
นั่นคือส่วนที่ควรทำให้มั่นคง โมเดลเปลี่ยนไปในสัปดาห์นี้ แต่การมอบหมาย บริบท ความคืบหน้า อุปสรรค ผลลัพธ์ และการตรวจทานโดยคนยังอยู่ที่เดิมที่ทีมมองเห็นได้ ถ้าคุณรัน coding agent หลายตัวอยู่แล้ว ลองเชื่อมต่อ Computer สักหนึ่งเครื่อง สร้าง Agent หนึ่งตัว แล้วมอบหมายงานน่าเบื่อ ๆ ให้มันสักงาน


