

ลองถามเอเจนต์เขียนโค้ดของคุณว่าฟังก์ชันหนึ่งถูกเรียกจากที่ไหน แล้วดูว่าจะเกิดอะไรขึ้น มันจะ grep อ่านไฟล์สามไฟล์ grep อีกครั้งด้วยแพตเทิร์นที่ต่างออกไป อ่านเพิ่มอีกสี่ไฟล์ และสุดท้ายก็ตอบได้ถูกต้อง แต่ระหว่างนั้นมันได้เติมคอนเท็กซ์ของตัวเองไปด้วยซอร์สโค้ดที่จะถูกลืมทันทีที่เซสชันจบลง พอถามคำถามต่อเนื่องอีกข้อ มันก็เริ่มทำทั้งหมดซ้ำอีกครั้ง
codebase-memory-mcp ตัดวงจรนั้นทิ้งไป ด้วยดาว 41,536 ดวง สัญญาอนุญาต MIT และเขียนด้วยภาษา C มันคือเครื่องมือในกระแส agent tooling ของปีนี้ที่ให้ผลตอบแทนคุ้มค่าที่สุด โดยแทบไม่ต้องเปลี่ยนวิธีทำงานของคุณเลย มันมอบความจำเรื่องโค้ดให้กับเอเจนต์ แต่ไม่ได้มอบความจำเรื่องงานให้กับทีมของคุณ และสองเรื่องนี้เป็นคนละปัญหากัน
TL;DR
นี่คือหนึ่งในห้าบทวิเคราะห์เจาะลึกจากบทความรวบรวมเครื่องมือโอเพนซอร์สที่ต่อยอดความสามารถของเอเจนต์เขียนโค้ดของเรา
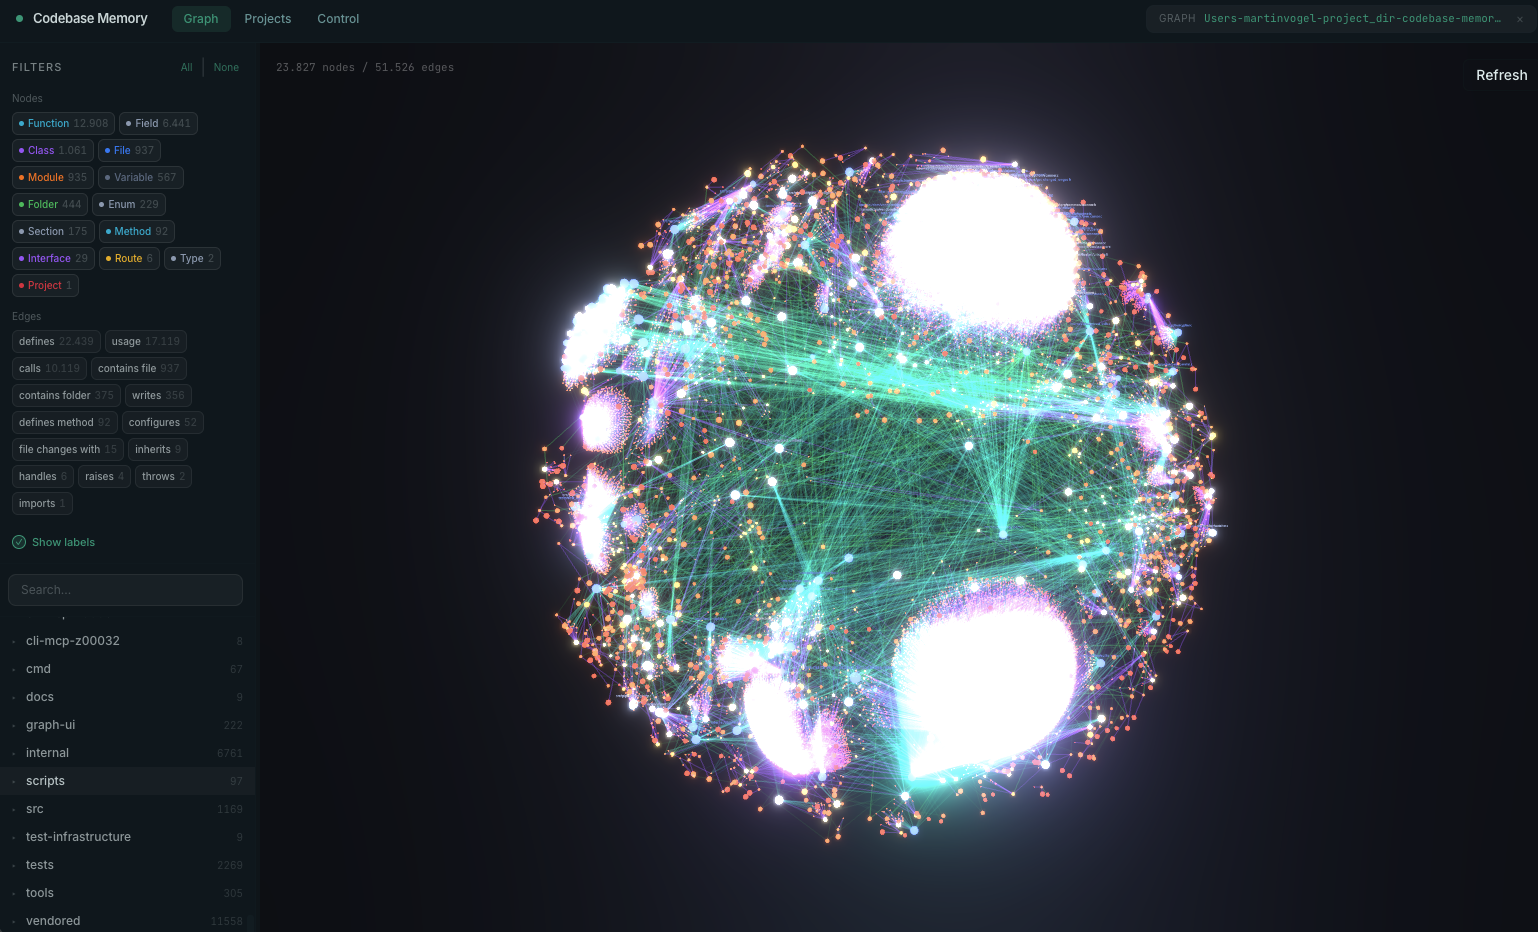
codebase-memory-mcp ทำดัชนีรีโพซิทอรีให้กลายเป็น knowledge graph แบบถาวรของฟังก์ชัน คลาส สายการเรียก และ route จากนั้นจึงตอบคำถามเชิงโครงสร้างจากกราฟแทนการ grep โปรเจกต์นี้วัดผลคำถามเชิงโครงสร้างห้าข้อไว้ที่ราว 3,400 โทเคนเมื่อถามผ่านกราฟ เทียบกับราว 412,000 โทเคนเมื่ออ่านทีละไฟล์ มันเป็นไบนารีเนทีฟไฟล์เดียว ไม่ต้องมีรันไทม์หรือ API key ทำงานในเครื่องทั้งหมด และใช้ได้กับ MCP client ทุกตัว ติดตั้งมันก่อน แล้วค่อยแยกตัดสินใจอีกทีว่าบันทึกว่าเอเจนต์ของคุณทำอะไรไปบ้างจะเก็บไว้ที่ไหน
มันทำอะไรได้บ้าง
การพาร์สทำผ่าน tree-sitter ครอบคลุมกว่า 160 ภาษา โดยมีการวิเคราะห์ชนิดเชิงความหมาย (semantic type resolution) เพิ่มเติมสำหรับกลุ่มภาษาหลัก ซึ่งรวมถึง Python ตระกูล TypeScript และ JavaScript, Go, Java, Rust, C# และ C++ ผลลัพธ์ถูกเปิดออกมาในรูปเครื่องมือ MCP 15 รายการ ครอบคลุมการค้นหา การไล่สายการเรียก ภาพรวมสถาปัตยกรรม การวิเคราะห์ผลกระทบ การตรวจจับโค้ดที่ไม่ได้ใช้ การ query กราฟ และการเชื่อมโยง HTTP ข้ามบริการ client ใดก็ตามที่สื่อสารด้วย Model Context Protocol ใช้ได้ และโปรเจกต์ระบุว่ามี agent surface ที่รองรับ 45 แห่ง
| ตัวชี้วัด | ค่าที่รายงาน |
|---|---|
| คำถามเชิงโครงสร้างห้าข้อ | ~3,400 โทเคน เทียบกับ ~412,000 เมื่ออ่านทีละไฟล์ |
| การเปรียบเทียบที่ผ่านการ peer review | ใช้โทเคนน้อยลง 10 เท่า เรียกเครื่องมือน้อยลง 2.1 เท่า คุณภาพคำตอบ 83% |
| การทำดัชนี Linux kernel | 28 ล้านบรรทัด 75,000 ไฟล์ 3 นาที |
| ความหน่วงของคำถามเชิงโครงสร้าง | ต่ำกว่า 1 มิลลิวินาที |
ลองอ่านตัวเลขโทเคนสองตัวนั้นประกอบกัน การลดลง 99% มาจากคำถามเชิงโครงสร้างห้าข้อ ซึ่งเป็นกรณีที่ดีที่สุดของกราฟ ส่วนตัวเลขใน preprint ที่วัดจาก 31 รีโพซิทอรีคือ 10 เท่า ให้วางแผนโดยอิงที่ 10 เท่า และถือว่าอะไรที่ได้ดีกว่านั้นเป็นโบนัส
การติดตั้ง
curl -fsSL https://raw.githubusercontent.com/DeusData/codebase-memory-mcp/main/install.sh | bash
บน Windows มีตัวติดตั้งแบบ PowerShell และทางโปรเจกต์แนะนำให้อ่านก่อนรัน ตัวติดตั้งจะตรวจจับเอเจนต์เขียนโค้ดของคุณและเขียนรายการ MCP ของเอเจนต์เหล่านั้นให้ รีสตาร์ทเอเจนต์แล้วสั่งให้มันทำดัชนีโปรเจกต์
มีการตั้งค่าสองอย่างที่ควรตั้งแต่วันแรก:
codebase-memory-mcp config set auto_index true
codebase-memory-mcp --ui=true --port=9749
ตัวดูกราฟถูกฝังอยู่ในไบนารีอยู่แล้ว และเป็นวิธีตรวจสอบง่าย ๆ ที่มีประโยชน์ว่าดัชนีครอบคลุมสิ่งที่คุณคาดไว้จริงหรือไม่
มีข้อควรระวังสองข้อที่ทางโปรเจกต์ระบุไว้เอง ทั้งคู่ใช้เวลาอ่านแค่สามสิบวินาที Microsoft Defender อาจตั้งค่าสถานะไบนารีที่ปล่อยออกมาเป็น false positive โดยทางโปรเจกต์ระบุว่าปกติแล้วประมาณ 62 เอนจินจะมีราว 61 ตัวที่รายงานว่าสะอาด และการตรวจจับตระกูลเดียวกันนี้ก็เกิดกับ GitHub CLI และ Go toolchain ของ Microsoft เองด้วย และเครื่องมือนี้จะอ่านโค้ดเบสของคุณและเขียนลงไฟล์คอนฟิกของเอเจนต์ ซึ่งนั่นก็คืองานของมัน และทางโปรเจกต์ก็บอกไว้ตรง ๆ แล้ว อ่านสคริปต์ติดตั้งก่อนที่จะ pipe เข้าเชลล์
ทำไมต้องเริ่มจากตัวนี้
เครื่องมืออื่น ๆ ในกระแสตอนนี้ล้วนขอให้คุณเปลี่ยนวิธีทำงาน คลัง role เปลี่ยนวิธีที่คุณเขียนพรอมป์ต์ worktree แบบขนานเปลี่ยนวิธีที่คุณจัดระเบียบงาน การเข้าถึงเว็บเปลี่ยนสิ่งที่คุณถาม
แต่ตัวนี้ไม่เปลี่ยนอะไรเลย และทำให้ทุกเซสชันถูกลง ไม่มีนิสัยใหม่ที่ต้องฝึก
ผลด้านคุณภาพคืออีกครึ่งที่มักถูกมองข้าม เอเจนต์ที่ใช้โทเคน 400,000 โทเคนไปกับการอ่านไฟล์ ย่อมเหลือพื้นที่ให้ใช้เหตุผลกับปัญหาของคุณน้อยลงตามไปด้วย และความสามารถในการระลึกถึงสิ่งที่อ่านไปตอนต้นก็จะเสื่อมลงเมื่อเซสชันยาวนานขึ้น การตอบจากกราฟช่วยให้คอนเท็กซ์ว่างอยู่
ความเปลี่ยนแปลงนี้จะเห็นได้จากสิ่งที่คุณถาม คำถามที่เมื่อก่อนคุณเลี่ยงเพราะมันกินโทเคน 50,000 โทเคนและเวลาสองนาที ตอนนี้แทบไม่มีค่าใช้จ่ายเลย การวิเคราะห์ผลกระทบก่อนเปลี่ยน signature จะเปลี่ยน “ฉันคิดว่าน่าจะปลอดภัย” ให้กลายเป็นรายการ ส่วนการไล่สายการเรียกในรีโพซิทอรีที่ไม่คุ้นเคยก็ได้ผลดีกว่าการไล่อ่านย้อนขึ้นไปห้าไฟล์โดยหวังว่าจะเจอจุดเริ่มต้น
ความจำเรื่องโค้ด ไม่ใช่ความจำเรื่องงาน
นี่คือเส้นแบ่ง และมันคมชัดมาก
กราฟถูกสร้างขึ้นจากโค้ดของคุณ มันจึงรู้ว่าโค้ดของคุณคืออะไร มันบอกคุณได้ว่า retry helper เรียก payments client แต่มันบอกคุณไม่ได้ว่าทำไมค่า backoff ถึงเปลี่ยนไปในเดือนกรกฎาคม ใครเป็นคนตัดสินใจ ทางเลือกอื่นคืออะไร หรือมีใครรีวิวหรือไม่ ประวัติเหล่านั้นเคยอยู่ในเซสชันเทอร์มินัลที่จากไปแล้ว
ทีมต่างรู้สึกถึงความไม่สมดุลที่แปลก ๆ นี้: เอเจนต์จดจำโค้ดเบสได้ดีกว่ามนุษย์ทุกคนในทีม แต่กลับไม่จดจำการตัดสินใจที่ทำให้เกิดโค้ดนั้นเลยแม้แต่นิดเดียว
ดัชนียังผูกกับเครื่องแต่ละเครื่องด้วย มันอยู่ในไดเรกทอรีแคชภายใต้บัญชีหนึ่ง แชร์ข้ามเซสชันในเครื่องของคุณผ่าน coordination daemon และมันหยุดอยู่แค่ขอบของเครื่องนั้น
บันทึกการทำงานอยู่ที่ไหน
Task คือหน่วยหลักของงานใน Sharkly มันบรรจุคำขอ คอนเท็กซ์ การทำงาน อุปสรรค และผลลัพธ์ไว้ในที่แชร์กันที่เดียว แทนที่จะกระจายไปตามพรอมป์ต์ส่วนตัวและเซสชันเทอร์มินัล
แต่ละส่วนมีหน้าที่ของตัวเอง Agent กำหนดว่างานควรถูกจัดการอย่างไร Computer จัดหาโฮสต์และทรัพยากรในเครื่อง Runtime ทำหน้าที่รันเซสชันของเอเจนต์จริง โดยใช้เครื่องมือเขียนโค้ดที่ติดตั้งอยู่แล้วบนนั้น ส่วน Task ยังคงเป็นบันทึกที่แชร์ร่วมกัน
การแยกส่วนแบบนี้ทำให้การจับคู่เป็นรูปธรรมขึ้น ดัชนีเป็นทรัพยากรในเครื่องบน Computer ดังนั้น Computer ที่ถือรีโพซิทอรีที่ทำดัชนีแล้วคือเครื่องที่มีกราฟพร้อมใช้ แทนที่จะต้องเริ่มจากศูนย์สามนาที Agent คือคอนฟิกที่บันทึกไว้ ดังนั้นการตั้งค่าที่เอเจนต์มีดัชนีและสิทธิ์ที่ถูกต้องจะถูกนำกลับมาใช้ซ้ำ ไม่ต้องสร้างใหม่ทีละเครื่อง และการทำงาน อุปสรรค ผลลัพธ์ และการพูดคุยติดตามผลจะกลับไปอยู่บนไทม์ไลน์ของ task ซึ่งเป็นที่ที่เหตุผลเบื้องหลังการเปลี่ยนแปลงยังคงอยู่
Sharkly ไม่ใช่ตัวแทนที่มาแทน Claude Code, Codex หรือ codebase-memory-mcp แต่มันเพิ่มชั้นของ task ที่แชร์กัน, Computer, คอนเท็กซ์, การควบคุม และการรีวิวเข้าไปรอบ ๆ เครื่องมือเหล่านั้น การใช้งานโมเดลยังคงดำเนินไปผ่าน subscription หรือ API key ที่ตั้งค่าไว้ในเครื่องมือเหล่านั้น
ความจำเรื่องโค้ดบวกความจำเรื่องงานคือสูตรผสมที่ลงตัว อย่างหนึ่งให้เอเจนต์จดจำรีโพซิทอรีได้ ส่วนอีกอย่างให้ทีมจดจำได้ว่าเอเจนต์ทำอะไรลงไปในรีโพซิทอรีนั้น
เมื่อไหร่ที่คุณต้องใช้แต่ละอย่าง
ติดตั้ง codebase-memory-mcp เดี๋ยวนี้เลย ไม่ว่าทีมของคุณจะมีขนาดไหน มันทำงานในเครื่อง ไม่ต้องเปลี่ยนเวิร์กโฟลว์ และการลดต้นทุนก็ได้ผลกับนักพัฒนาคนเดียวพอ ๆ กับทีมยี่สิบคน
เพิ่มระบบงานที่แชร์กันเมื่อเหตุผลจำเป็นต้องอยู่ยั่งยืนกว่าเซสชัน: เมื่อมีการรีวิวก่อนปล่อยงาน เมื่อมีคนมากกว่าหนึ่งคนแตะรีโพซิทอรีเดียวกัน หรือเมื่ออีกสามเดือนจะมีคนถามว่าทำไมถึงมีการเปลี่ยนแปลงนี้ กราฟจะตอบได้ว่าโค้ดทำอะไร แต่จะไม่มีวันตอบได้ว่าทำไม
เอเจนต์ค้นคว้า ลงมือทำ ทดสอบ และรายงาน ส่วนคนกำหนดทิศทาง มอบอำนาจ และรับผลลัพธ์
คำถามที่พบบ่อย
ใช้ได้กับเอเจนต์อื่นนอกเหนือจาก Claude Code ไหม? ได้ เพราะมันเป็น MCP server ดังนั้น MCP client ตัวไหนก็ใช้ได้ และโปรเจกต์ระบุว่ามี agent surface ที่รองรับ 45 แห่ง รวมถึง Cursor, Codex, Windsurf, OpenCode และ Aider
โค้ดของฉันออกจากเครื่องไปไหม? ไม่ออก การประมวลผลเกิดขึ้นในเครื่องทั้งหมด และทางโปรเจกต์ระบุว่ามันไม่ส่งคำขอเครือข่ายด้วยตัวเอง และไม่ตรวจสอบอัปเดตในเบื้องหลัง ซอร์สโค้ดเปิดให้ดูได้ หากคุณอยากตรวจสอบด้วยตัวเองแทนที่จะเชื่อ
การลดโทเคน 99% นั้นสมจริงไหม? ตัวเลขนั้นมาจากคำถามเชิงโครงสร้างห้าข้อ ซึ่งเป็นกรณีที่ดีที่สุด ตัวเลขที่ผ่านการ peer review จาก 31 รีโพซิทอรีคือใช้โทเคนน้อยลง 10 เท่า และเรียกเครื่องมือน้อยลง 2.1 เท่า ให้วางแผนโดยอิงที่ 10 เท่า
รองรับรีโพซิทอรีใหญ่ได้แค่ไหน? กรณีสูงสุดที่ระบุไว้คือ Linux kernel ขนาด 28 ล้านบรรทัด ใช้เวลาสามนาที ส่วนรีโพซิทอรีแอปพลิเคชันทั่วไปทำดัชนีเสร็จในระดับมิลลิวินาที
ช่วยได้ไหมเมื่อมีเอเจนต์หลายตัวรันพร้อมกัน? ช่วยได้ และมากกว่าปกติด้วย เอเจนต์ห้าตัว grep รีโพซิทอรีเดียวกันก็คือความสิ้นเปลืองห้าเท่า การรันแต่ละ Task ยังคงได้ worktree แยกของตัวเอง ขณะที่ดัชนีเชิงโครงสร้างถูกแชร์อยู่บน Computer
สรุปสั้น ๆ
นี่คือเครื่องมือที่มองเห็นได้น้อยที่สุดในกระแสปี 2026 และเป็นตัวที่ให้ผลตอบแทนดีที่สุด ไบนารีเนทีฟไฟล์เดียว ไม่ต้องเปลี่ยนเวิร์กโฟลว์ และลดโทเคนที่เอเจนต์ใช้ตอบคำถามซึ่งจริง ๆ ไม่ควรต้องไป grep ถึงระดับหลักสิบเท่าอย่างวัดผลได้ ติดตั้งมัน ทำดัชนีโปรเจกต์ของคุณ แล้วเปิดตัวดูกราฟสักครั้งเพื่อดูว่ามันสร้างอะไรขึ้นมา
จากนั้นก็ให้ชัดเจนเรื่องขอบเขตของมัน มันจดจำรีโพซิทอรี ไม่ใช่ตัวงาน และการตัดสินใจเบื้องหลังการเปลี่ยนแปลงจะตายไปพร้อมกับเซสชัน ถ้าไม่มีอะไรเก็บมันไว้ Sharkly เก็บสิ่งนั้นไว้: Task คือบันทึกที่แชร์ร่วมกัน การทำงานรันบน Computer ที่คุณเชื่อมต่อผ่าน runtime ที่คุณจ่ายเงินอยู่แล้ว และผลลัพธ์จะกลับมาอยู่ในที่ที่คนสามารถรีวิวและรับมันได้


