

Jev คือโมเดลใหม่จาก TypeSafe AI ที่ไม่เขียนโค้ดและไม่เขียนข้อความ คุณป้อนสถานะของโปรแกรม (program state) เข้าไป ประกาศคำถามที่ต้องการคำตอบ แล้วมันจะคืนคำตอบแบบมีชนิดข้อมูล (typed) พร้อมความน่าจะเป็นที่ปรับเทียบแล้ว (calibrated) TypeSafe เรียกมันว่า System One Model และมันเปิดตัวบน Vercel AI Gateway เมื่อวันที่ 16 กันยายน 2026 ซึ่งเป็นเหตุผลที่อยู่ ๆ มันก็โผล่เต็มฟีดไปหมด
สำหรับทีมที่รันเอเจนต์เขียนโค้ดหลายตัว สิ่งที่น่าสนใจไม่ใช่ตัวโมเดล แต่อยู่ที่ว่าโมเดลตัดสินใจเข้าไปอยู่ตรงไหนในสแตก เอเจนต์ของคุณสร้างงานขึ้นมา ปัญหาที่ยากจริง ๆ อย่างที่เราเคยเขียนไว้ใน ทำไมการรีวิวโดยมนุษย์ถึงเป็นคอขวด คือการตัดสินใจว่าจะทำอย่างไรกับผลลัพธ์จากห้ารอบที่มาพร้อมกัน งานไหนต้องให้คนดู งานไหน merge ได้ งานไหนติดขัด Jev ถูกสร้างมาเพื่อคำถามแบบนี้โดยเฉพาะ บทความนี้จะอธิบายว่ามันคืออะไร ไม่ใช่อะไร และอยู่ตรงไหนเหนือเอเจนต์ของคุณ
Jev คืออะไร
System One Model คือโมเดลที่คืนค่าการตัดสินใจแทนที่จะเป็นข้อความ โพสต์เปิดตัวของ TypeSafe อธิบายไว้ว่า “ป้อน state ที่ไม่มีโครงสร้างเข้าไป ได้การตัดสินใจแบบมีชนิดข้อมูลพร้อมความน่าจะเป็นออกมา” มีคุณสมบัติสามข้อที่สำคัญ
รูปร่างของผลลัพธ์ถูกประกาศไว้ก่อนเรียกใช้งาน คุณกำหนดชนิดของคำถามแต่ละข้อไว้ล่วงหน้า และโมเดลตอบได้แค่ภายในกรอบนั้น ไม่มีข้อความให้ต้อง parse และไม่มีปัญหา schema ไม่ตรงกันให้ต้องคอยจับ
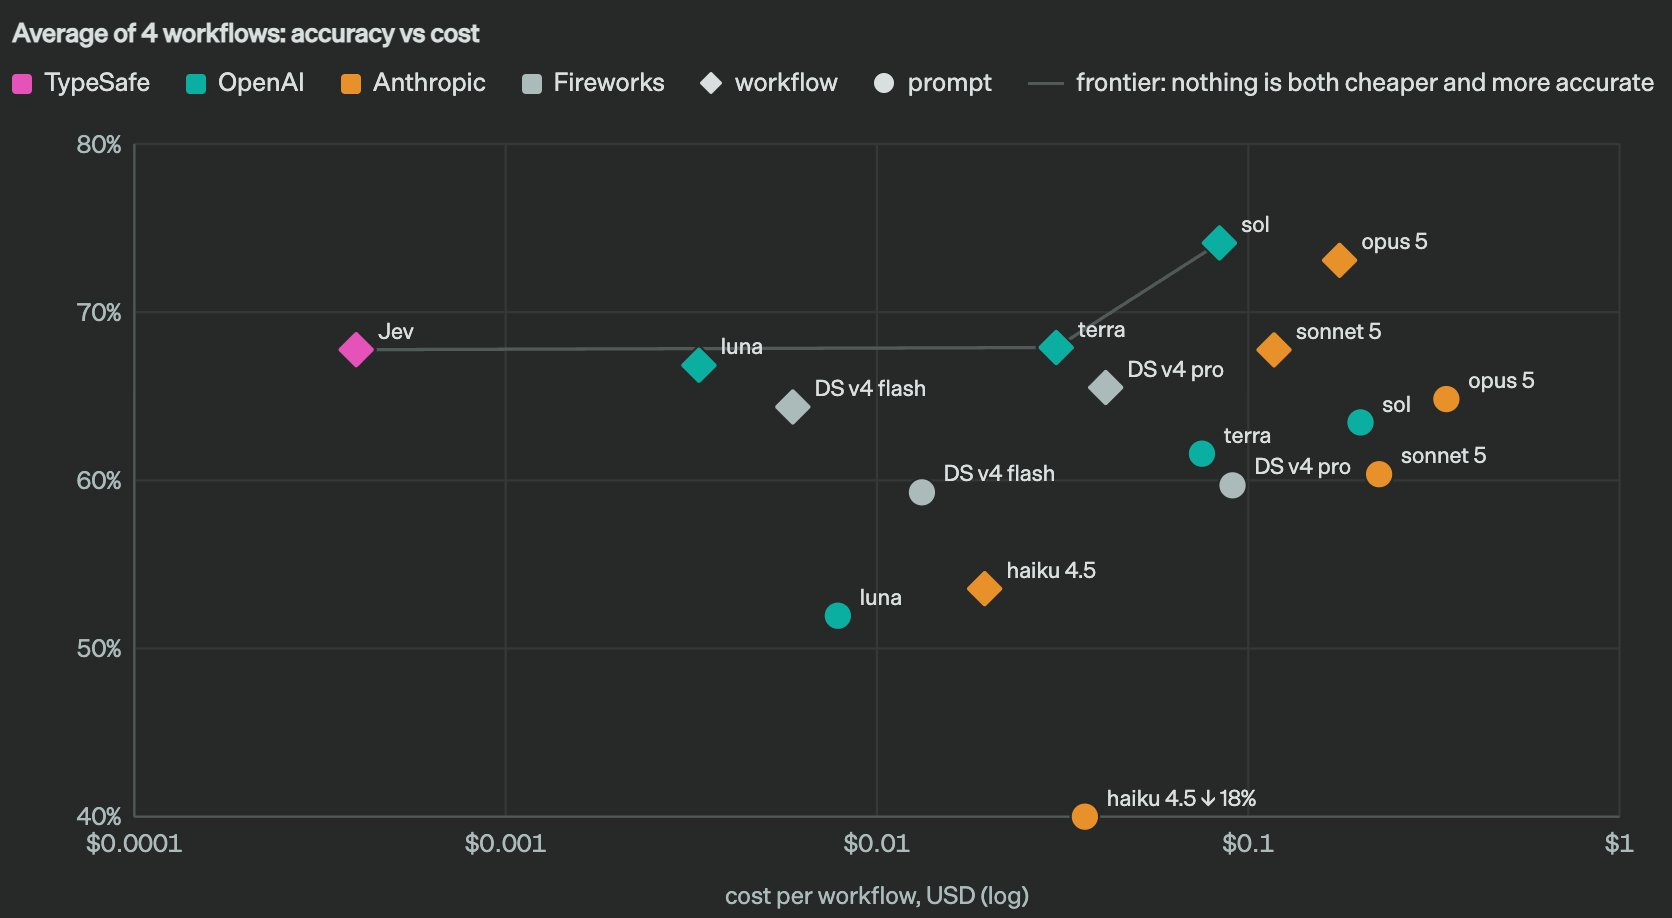
ทุกคำตอบมาพร้อมความน่าจะเป็น คำถามแบบใช่/ไม่ใช่จะคืนค่า 0.97 ไม่ใช่ true ส่วนคำถามแบบตัวเลือกจะคืนการกระจายความน่าจะเป็นเต็มรูปแบบของทุกตัวเลือก TypeSafe ฝึกโมเดลนี้ด้วยวิธีที่เรียกว่า Reinforcement Learning for Calibrated Decisions โดยอ้างว่าความมั่นใจที่สูงขึ้นหมายถึงความแม่นยำที่สูงขึ้น คุณจึงตั้ง threshold ได้: สูงกว่านั้นให้ทำงานอัตโนมัติ ที่เหลือส่งให้คน
คำถามทุกข้อได้รับคำตอบพร้อมกันในคำขอเดียว นี่คือเหตุผลที่ TypeSafe ระบุเวลาตั้งแต่ต้นจนจบไว้ที่ 70ms ถึง 500ms ซึ่งเป็นตัวเลขของผู้ขาย ไม่ใช่ผลทดสอบที่เป็นอิสระ แต่สถาปัตยกรรมก็อธิบายตัวเลขนี้ได้: ไม่มีอะไรถูกสร้างขึ้นทีละ token
คำถามสามประเภท
API ของ Jev เปิดให้ใช้ primitive สามแบบ แต่ละแบบเป็นออบเจกต์ JSON ภายใต้คีย์ที่คุณตั้งเอง โดยทั้งหมดถูกประเมินเทียบกับ state ตัวเดียวกัน
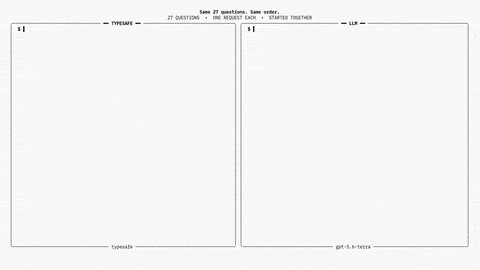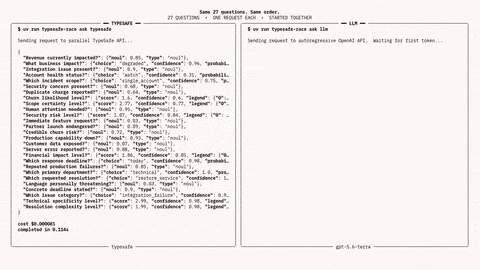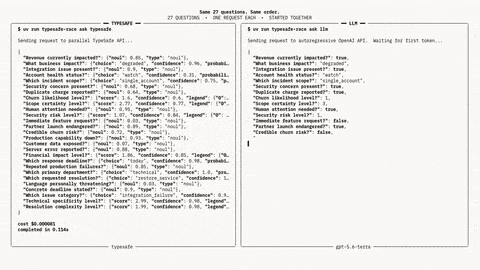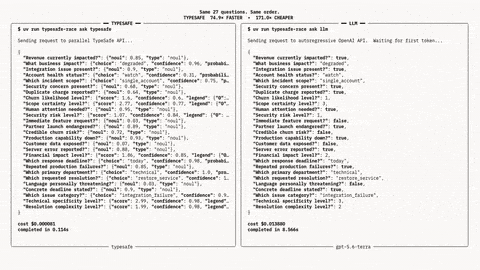
Noul คือความน่าจะเป็นแบบใช่/ไม่ใช่ {"type": "noul", "instructions": "Does this run need a human before merge?"} จะคืนค่า {"noul": 0.91} แล้วคุณตั้ง threshold ในโค้ดเอง
Choice เลือกหนึ่งตัวเลือกจากชุดที่มีชื่อได้สูงสุด 255 ตัว คุณส่ง criteria ที่จับคู่ชื่อตัวเลือกกับคำอธิบาย แล้วคำตอบจะมาพร้อมตัวเลือกที่ถูกเลือก การกระจายความน่าจะเป็นทั้งหมด และค่าความมั่นใจ
Score จัดวาง state ลงบนเกณฑ์แบบเรียงลำดับ 2 ถึง 10 ระดับ คำตอบคือตำแหน่งที่ถ่วงน้ำหนักด้วยความน่าจะเป็น บั๊กตัวหนึ่งจึงได้คะแนน 1.3 ซึ่งอยู่ระหว่าง “พอมีทางเลี่ยงได้” กับ “บล็อกงาน”
เมื่อใช้ผ่าน Vercel AI SDK ชนิดใช่/ไม่ใช่จะเรียกว่า boolean และฟิลด์คือ probability ส่วนเมื่อยิงไปที่ endpoint ของ TypeSafe เองจะเรียกว่า noul แนวคิดเดียวกัน แต่คีย์ต่างกัน
โมเดลตัดสินใจอยู่ตรงไหนเหนือเอเจนต์ของคุณ
นี่คือ mental model ที่เราใช้ โมเดลสร้าง token เอเจนต์เขียนโค้ด (Claude Code, Codex, Gemini CLI, OpenCode) เปลี่ยน token ให้กลายเป็นการเปลี่ยนแปลงบน Computer ส่วนชั้นการจัดการเป็นตัวตัดสินว่าใครทำอะไร และจะเกิดอะไรขึ้นกับผลลัพธ์ Jev อยู่ในชั้นบนสุด ไม่ใช่ชั้นกลาง มันไม่ใช่เอเจนต์และแก้ไขไฟล์ไม่ได้ มันคือคำตอบแบบมีชนิดข้อมูลที่รวดเร็วสำหรับคำถามด้านการจัดการ
มีสามคำถามที่โผล่ขึ้นบนบอร์ดทุกบอร์ดที่รันเอเจนต์แบบขนาน และแต่ละข้อก็จับคู่กับ primitive ของ Jev
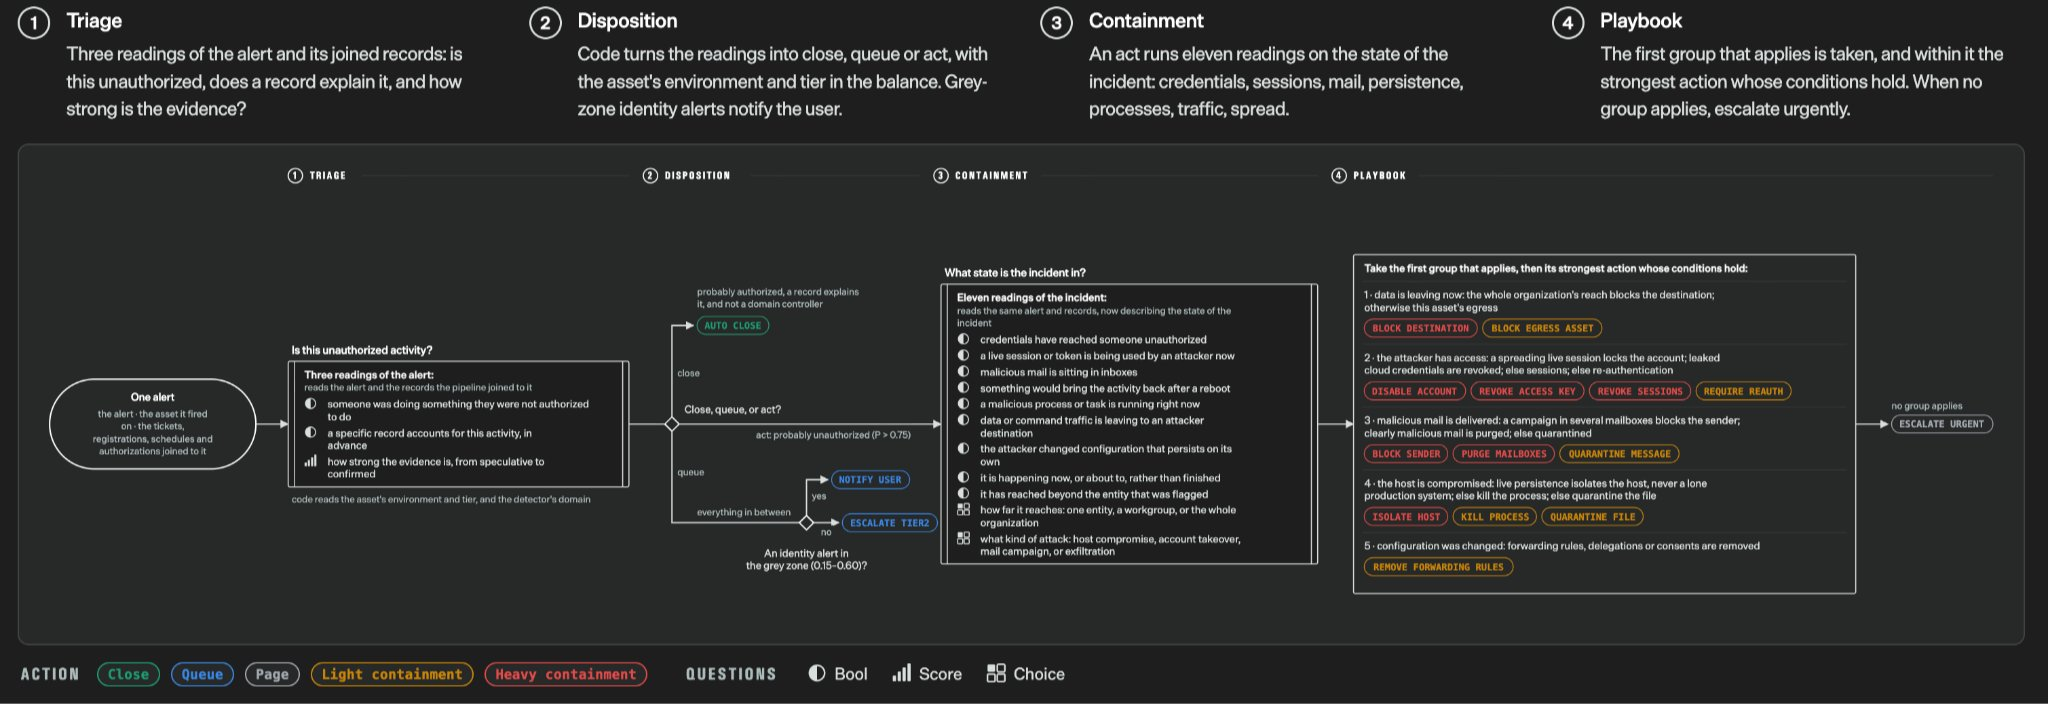
Assignee คนไหนควรรับ Task นี้? ใช้ Choice เลือกจาก Agent ของคุณ โดย criteria อธิบายว่าแต่ละตัวถนัดอะไร state คือชื่อ Task คำอธิบาย และ repository ที่เชื่อมไว้ นี่คือขั้นตอน triage ที่เราอธิบายไว้ใน AI backlog management and triage แต่ทำในคำขอเดียว 100ms แทนที่จะให้คนมานั่งอ่านตั๋วสี่สิบใบ
รอบนี้ต้องให้คนดูก่อน merge ไหม? ใช้ Noul กับ diff summary ของรอบนั้น ผลการทดสอบ และพาธที่ถูกแตะ ถ้าสูงกว่า 0.85 ให้กักไว้รอรีวิว ถ้าต่ำกว่า 0.15 ปล่อยให้ผ่าน approval gate ไปได้ ส่วนค่าที่อยู่ตรงกลางให้ตีธงไว้ จุดประสงค์ไม่ใช่การตัดคนรีวิวออก แต่เพื่อให้แน่ใจว่าช่วงบ่ายของคนรีวิวหมดไปกับรอบที่ต้องการจริง ๆ
การเปลี่ยนแปลงนี้เสี่ยงแค่ไหน? ใช้ Score ตั้งแต่ “แค่เรื่องหน้าตา” ไปจนถึง “แตะ auth หรือระบบชำระเงิน” กับ state ตัวเดียวกัน ตัวเลขนี้ใช้จัดเรียงคิวรีวิว ซึ่งเป็นประโยชน์หลักของ การติดตามงานที่เอเจนต์เขียนโค้ดทำเสร็จ
คอมมูนิตี้ไปถึงจุดนี้ก่อน ในสัปดาห์หลังการเปิดตัว นักพัฒนาปล่อย staged code-review workflow ที่สร้างบน Jev, ปลั๊กอิน Claude Code ที่เปลี่ยน compaction summary มาเป็นคำตัดสินของ Jev ว่า tool call ไหนควรเก็บไว้ และ “software factory foreman” ที่ใช้ Jev ในการจัดเส้นทางงาน ทุกตัวล้วนเป็นชั้นตัดสินใจที่อยู่เหนือเอเจนต์ ซึ่งเป็นแพตเทิร์นที่สำคัญ
หลักการตัดสินใจที่ซื่อตรง
ใช้ Jev เมื่อคำถามมีชุดคำตอบที่แน่นอนและคุณต้องการความน่าจะเป็นกำกับ เช่น การจัดเส้นทางงาน ความรุนแรงของปัญหา “ต้องรีวิวไหม” “ติดขัดหรือเปล่า” “คำอธิบาย PR นี้ตรงความจริงไหม” พวกนี้คือคำถามที่บอร์ดถามวันละร้อยครั้ง
อย่าใช้ Jev เมื่อคำถามต้องอาศัยดุลยพินิจที่ไม่ได้อยู่ใน state “สถาปัตยกรรมนี้ถูกต้องไหม” ไม่ใช่ Choice “ลูกค้าจะยอมรับไหม” ไม่ใช่ Score ความน่าจะเป็นกับคำถามพวกนั้นเป็นแค่ตัวเลขที่ดูเหมือนการตัดสินใจ ให้เก็บคน หรือ language model ที่อธิบายเหตุผลของตัวเองได้ ไว้ฝั่งนั้นของเส้นแบ่ง
และอย่าปล่อยให้ความน่าจะเป็นมาแทนที่ review gate ค่า 0.96 ในคำถาม “ปลอดภัยพอจะ merge ไหม” เป็นสัญญาณแรงที่ควรจัดรอบนั้นไว้บนสุดของคิวคน ไม่ใช่เหตุผลที่จะข้ามคนไปเลย เส้นแบ่งที่ Sharkly ลากไว้คือ automation หยุดตรงจุดที่ต้องใช้ดุลยพินิจของทีม และโมเดลตัดสินใจไม่ได้เลื่อนเส้นนั้น มันแค่ทำให้คิวฝั่งคนสั้นลงและเรียงลำดับได้ดีขึ้น
การเรียกใช้งาน
แบบตรง: POST https://api.typesafe.ai/v1/systemone พร้อม Bearer key จาก console.typesafe.ai ใช้โมเดล jev-latest (ปัจจุบันคือ jev-1.13.0) ผ่าน Vercel AI Gateway: ใช้โมเดล typesafe-ai/jev ผ่าน experimental_evaluate ใน AI SDK 7 และสังเกตว่าเอกสารของ Gatewayระบุว่าฟีเจอร์ evaluation ใช้ได้ผ่าน AI SDK เท่านั้น ไม่ใช่ผ่าน endpoint ที่รองรับ OpenAI
คำขอ triage ที่ตอบทั้งสามคำถามพร้อมกัน:
{
  "model": "jev-latest",
  "state": { "task": "Fix double charge on retry", "diff_summary": "touches billing/retry.ts, adds idempotency key", "tests": "42 passed" },
  "questions": {
    "assignee": { "type": "choice", "instructions": "Which Agent should take this?",
      "criteria": { "codex": "backend and payments", "claude_code": "refactors and tests", "gemini_cli": "frontend" } },
    "needs_review": { "type": "noul", "instructions": "Does this change need a human before merge?" },
    "risk": { "type": "score", "instructions": "How risky is this change?",
      "criteria": ["cosmetic", "logic change with tests", "touches auth, billing, or data"] }
  }
}
ราคาตามหน้า modelsของ TypeSafe: $0.042 ต่อล้าน input token, output ไม่คิดเงิน, 64k token ต่อคำขอ โดยเป็น state ได้ 32k, รองรับข้อความเท่านั้น ด้วยราคานี้ คำขอ triage ข้างต้นมีค่าใช้จ่ายแค่เศษเสี้ยวของหนึ่งเซนต์ ซึ่งเป็นสิ่งที่ทำให้การรันมันกับทุก Task และทุกรอบเป็นเรื่องที่เป็นไปได้จริง
สิ่งนี้เกี่ยวข้องกับ Sharkly อย่างไร
Sharkly ไม่ได้เรียก Jev ให้คุณ และมันก็ไม่ใช่โมเดลตัดสินใจ Sharkly คือชั้นที่ใช้ร่วมกันสำหรับ Task, Computer, context และการรีวิวที่อยู่รอบ ๆ เอเจนต์ที่คุณรันอยู่แล้ว สิ่งที่โมเดลอย่าง Jev มอบให้คือวิธีที่ประหยัดและมีชนิดข้อมูลในการตัดสินใจเรื่องการจัดเส้นทางและการรีวิวที่ชั้นนั้นเปิดขึ้นมา: Assignee คนไหน คิวไหน เร่งด่วนแค่ไหน จะต่อมันเข้ากับ Automation ที่สร้าง Task แล้วเลือก Agent หรือจะรันมันกับ output ของรอบที่เสร็จแล้วก่อนที่ผลลัพธ์จะถึงมือคนรีวิวก็ได้ ไม่ทางไหนก็ตาม การตัดสินใจจะไปลงที่จุดที่คนมองเห็นได้ ซึ่งเป็นส่วนที่ต้องคงไว้ไม่ว่าความน่าจะเป็นจะบอกอะไร
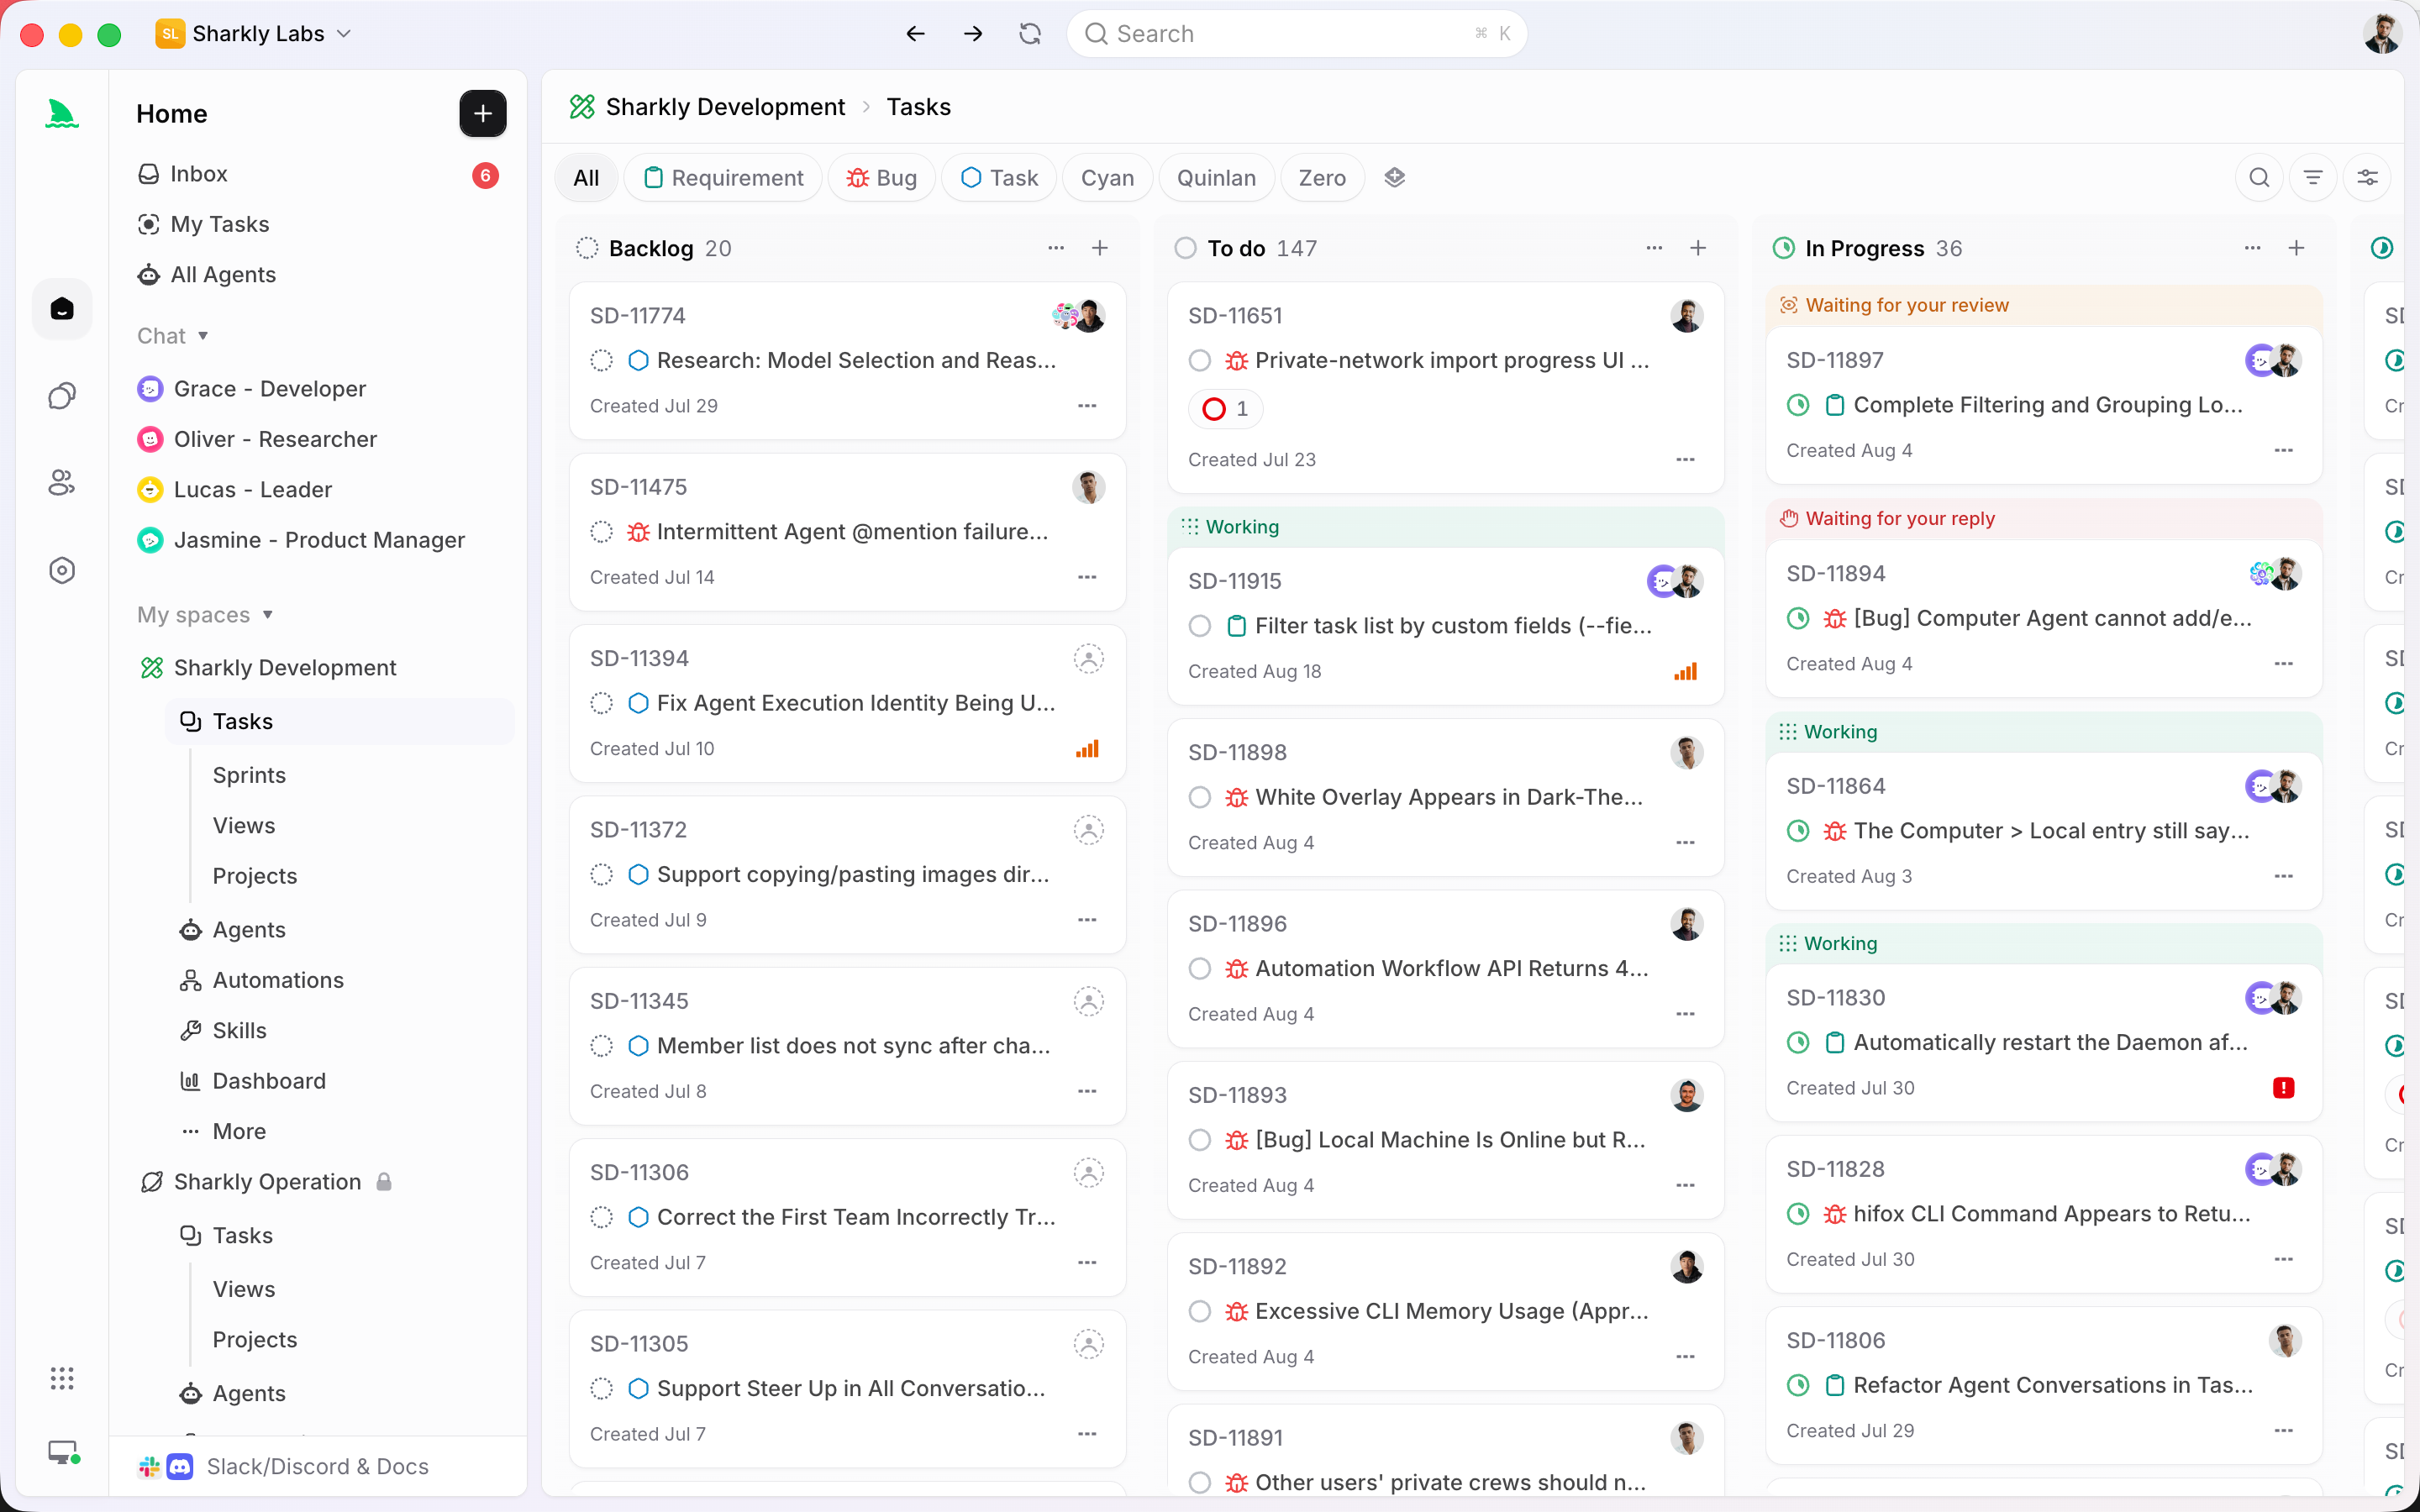
ถ้าคุณรันเอเจนต์มากกว่าหนึ่งตัวและคิวรีวิวคือจุดที่เจ็บปวด เริ่มต้นใช้งาน Sharkly ครอบคลุมเรื่องบอร์ด, Computers และ flow การรีวิวที่โมเดลตัดสินใจเข้าไปเสียบต่อได้
คำถามที่พบบ่อย
Jev เป็นเอเจนต์เขียนโค้ดหรือไม่
ไม่ใช่ มันสร้างโค้ดหรือแก้ไขไฟล์ไม่ได้ มันตอบคำถามที่ประกาศไว้เกี่ยวกับ state ที่คุณป้อนให้ พร้อมความน่าจะเป็น เอเจนต์เป็นตัวสร้างงาน ส่วน Jev ช่วยตัดสินใจว่าจะทำอย่างไรกับงานนั้น
มันแทนที่การรีวิวโค้ดได้ไหม
ไม่ได้ และก็ไม่ควรด้วย มันจัดอันดับคิวรีวิวและดึงเคสที่ชัดเจนออกมาได้ แต่การตัดสินใจ merge ยังอยู่ที่คน ซึ่งเป็นเส้นแบ่งที่ workflow ทั้งหมดนี้พึ่งพาอยู่
คำว่า calibrated หมายถึงอะไร
ถ้า Jev บอก 0.9 มันควรถูกประมาณ 90% ของเวลาในคำถามประเภทนั้น ลองทดสอบกับรอบงานของคุณเองก่อนจะเชื่อ threshold: diff ที่ติดป้ายกำกับแค่ไม่กี่สิบอันก็เพียงพอที่จะดูว่าตัวเลขนี้หมายความอย่างที่มันพูดจริงหรือไม่
ต้องใช้ Vercel ถึงจะใช้มันได้ไหม
ไม่ต้อง API แบบตรงใช้ได้ด้วย Bearer key ส่วน Gateway เป็นความสะดวกถ้าคุณใช้ AI SDK อยู่แล้ว


