
ทีมส่วนใหญ่ที่มองหาตัวเลือกแทน Devin ไม่ได้ไม่พอใจเรื่องการทำงานอัตโนมัติของมัน พวกเขากำลังนั่งคิดเลขกันต่างหาก
คุณจ่ายค่า Claude Code ไปแล้ว มีคนในทีมมีแพ็กเกจ ChatGPT ที่รวม Codex ไว้ด้วย อาจจะมีค่าสมาชิก Cursor อีกอัน จากนั้นเอเจนต์แบบคิดตามการใช้งานตัวที่สองก็โผล่มา พร้อมโมเดลการคิดค่าบริการเป็นของตัวเอง คำถามจึงไม่ใช่ “เอเจนต์ตัวนี้ดีไหม” อีกต่อไป แต่กลายเป็น “ทำไมฉันต้องซื้อความสามารถของเอเจนต์ซ้ำสองรอบ” คำถามนี้มีคำตอบที่ดี และคำตอบนั้นไม่ใช่ “เลิกใช้ Devin” เสมอไป คู่มือนี้จะพูดถึงว่าเมื่อไหร่ Devin คือเครื่องมือที่ใช่ ตัวเลือกอื่นที่ใช้ได้จริงมีอะไรบ้าง และ Sharkly เข้ามาเติมเต็มตรงไหนด้วยการประสานงานเอเจนต์ที่คุณจ่ายเงินอยู่แล้ว แทนที่จะเพิ่มเอเจนต์เข้าไปอีกตัว
สรุปสั้น ๆ
Devin คือวิศวกรซอฟต์แวร์อัตโนมัติของ Cognition ที่คิดค่าบริการผ่าน Agent Compute Units ซึ่งวัดจากเวลาทำงานจริงของเอเจนต์ ไม่ใช่แค่จำนวนที่นั่ง โมเดลนี้เหมาะกับงานที่คุณอยากมอบหมายให้ทำตั้งแต่ต้นจนจบ แต่จะเข้ากันได้น้อยลงเมื่อนักพัฒนาของคุณมีสมาชิกเอเจนต์ที่เก่งอยู่แล้ว และสิ่งที่ขาดไปคือการประสานงาน ไม่ใช่เอเจนต์อีกตัว Sharkly คือทางเลือกสำหรับกรณีหลังนี้: มันรัน Runtimes ที่ทีมของคุณมีอยู่แล้ว บน Computers ที่คุณเชื่อมต่อ โดยมี Task กลางที่เก็บทั้ง execution trace และการรีวิวของมนุษย์ ตัวเลือกจริงอื่น ๆ ได้แก่ Conductor สำหรับการรันแบบขนานบนเครื่อง macOS, Tembo สำหรับเซสชันแบบโฮสต์ที่เข้าถึงผ่านเครื่องมือที่คุณใช้อยู่ และ Linear สำหรับการมอบหมายงานหากเอเจนต์ของคุณอยู่ในรายชื่อของมันอยู่แล้ว
Devin เก่งเรื่องอะไรจริง ๆ
หน้าสังเทียบตัวเลือกที่ขึ้นต้นด้วยการด่าเจ้าตลาดไม่ใช่เรื่องมีประโยชน์ ดังนั้นนี่คือเหตุผลที่ควรอยู่ต่อ
Devin ถูกสร้างมาเพื่องานที่มอบหมายให้ทำได้ทั้งกระบวนการ คุณอธิบายผลลัพธ์ที่ต้องการ แล้วเอเจนต์จะวางแผน เขียนโค้ด รัน ดีบัก และวนปรับปรุงเองโดยไม่ต้องมีคนคอยกำกับทุกขั้นตอน นั่นเป็นรูปแบบผลิตภัณฑ์ที่ต่างจากเครื่องมือ CLI ที่คุณต้องนั่งเฝ้าข้าง ๆ เมื่อโจทย์ชัดเจนและมอบหมายได้จริง ความเป็นอัตโนมัตินั้นแหละคือจุดขาย และตัวเลือกอื่นในบทความนี้ไม่ได้จำลองความสามารถนั้นด้วยการไปประสานงานอย่างอื่นแทน
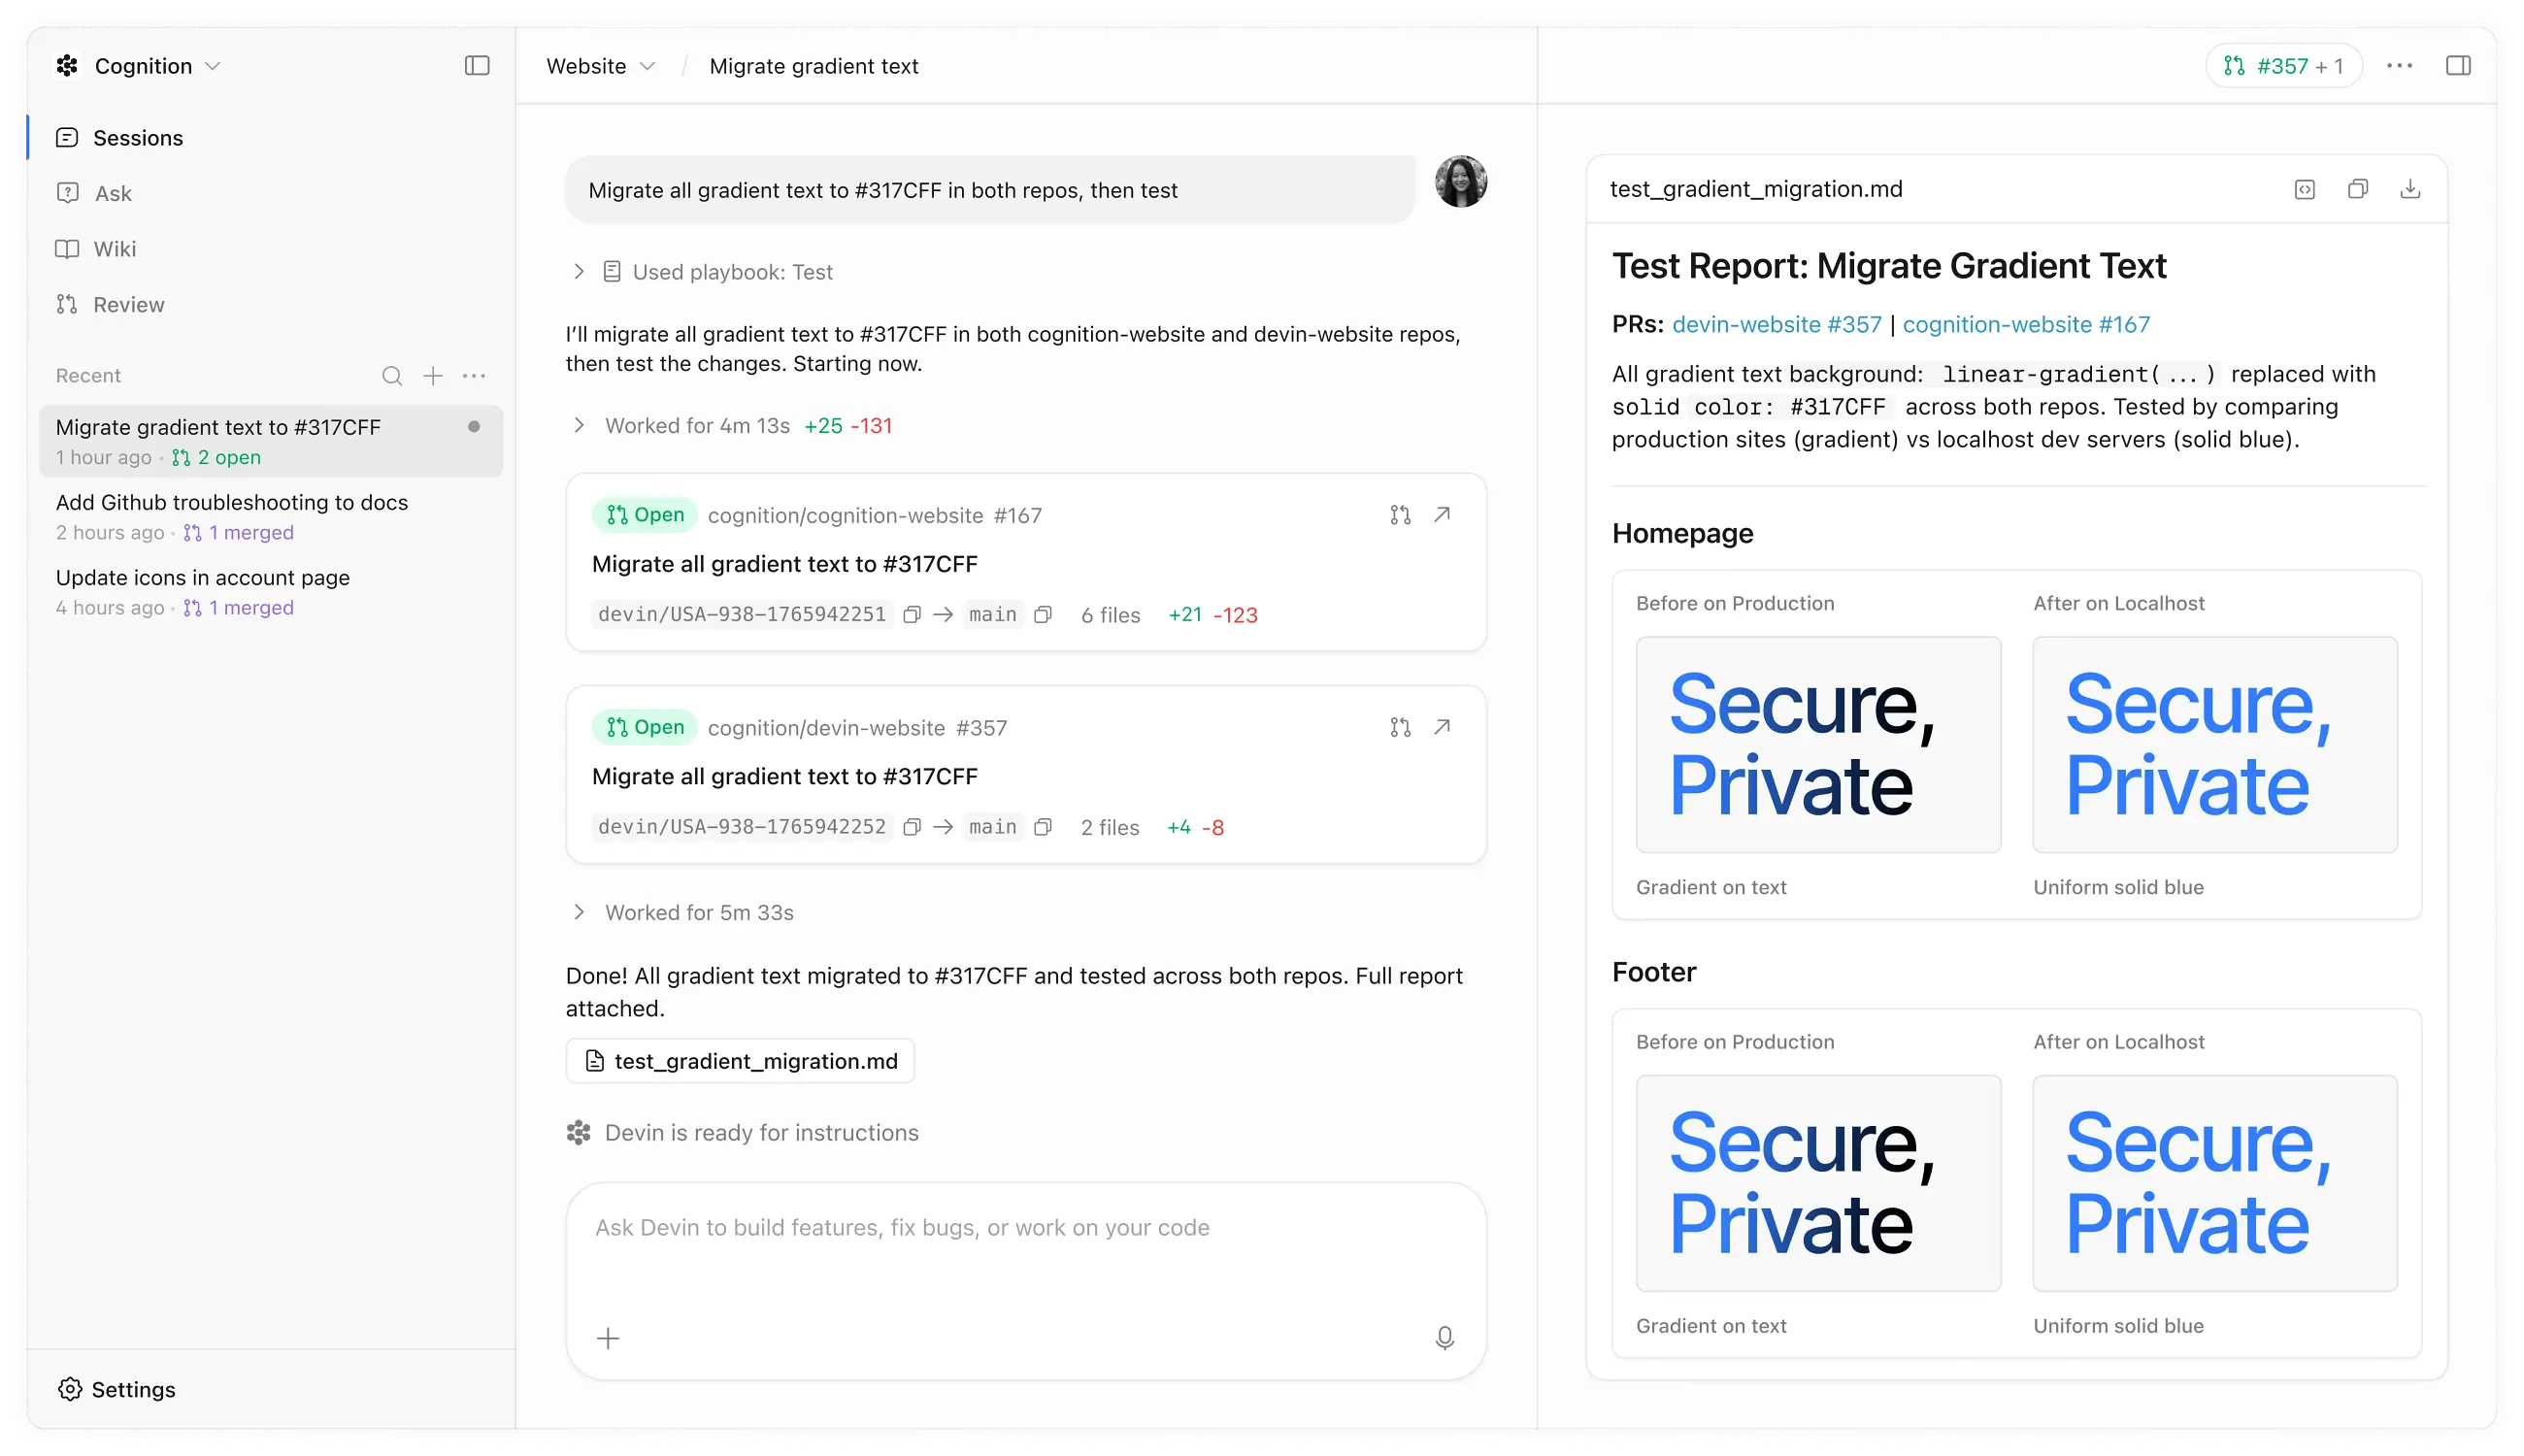
Cognition ยังคิดค่าบริการอย่างตรงไปตรงมาด้วย ราคาคิดตาม Agent Compute Units ซึ่งวัดงานอัตโนมัติที่เอเจนต์ทำจริง แทนที่จะทำเป็นว่างานซับซ้อนกับงานแก้บรรทัดเดียวมีค่าใช้จ่ายเท่ากัน Cognition เผยแพร่แพ็กเกจปัจจุบันและรายละเอียด ACU ไว้บนหน้าราคา ส่วนข้อตกลงระดับองค์กรจะเพิ่มการควบคุมด้านการดีพลอยและตัวตนตามที่องค์กรขนาดใหญ่ต้องการ
Devin ยังเข้าร่วมกับระบบนิเวศโดยรวม แทนที่จะบังคับให้คุณต้องอยู่ในระบบของมันเท่านั้น มันปรากฏอยู่ในรายชื่อเอเจนต์ของ Linear ดังนั้นคุณจึงมอบหมาย issue ให้มันได้จากตัวติดตามงานที่ทีมใช้อยู่แล้ว
ถ้าคอขวดของคุณคือ “เรามีงานที่ระบุชัดเจนมากกว่าจำนวนวิศวกรที่จะเริ่มทำได้” Devin ก็เล็งเป้ามาที่ปัญหานั้นโดยตรง เก็บมันไว้ได้เลย
สามเหตุผลที่ทีมมองหาตัวเลือกอื่น
จ่ายค่าความสามารถของเอเจนต์ซ้ำสองรอบ นี่คือเหตุผลที่พบบ่อยที่สุด ทีมที่มีสมาชิก Claude Code และ Codex อยู่แล้วก็มีเอเจนต์ที่เก่ง ติดตั้งและตั้งค่าเรียบร้อย พร้อมบริบทของโปรเจกต์ในเครื่อง การเพิ่มเอเจนต์ที่คิดเงินแยกอีกตัวหมายถึงงบสองก้อนเพื่อความสามารถที่ทับซ้อนกัน และงบก้อนที่สองนั่นแหละที่ผันแปรได้
การใช้งานที่คาดการณ์ยาก การคิดค่าบริการตามเวลาทำงานของเอเจนต์นั้นยุติธรรม แต่มันก็คาดเดาไม่ได้เมื่องานออกทะเล การรันที่ต้องลองใหม่เพราะ integration test ไม่เสถียรมีค่าใช้จ่ายสูงกว่าการรันเดียวกันบนเทสต์ที่นิ่ง และส่วนต่างนั้นจะโผล่มาให้เห็นหลังจากจ่ายไปแล้ว ทีมที่ต้องการตัวเลขรายเดือนที่อธิบายกับใคร ๆ ได้จะรู้สึกอึดอัดกับเรื่องนี้
ช่องว่างไม่เคยอยู่ที่ตัวเอเจนต์ หลายทีมค้นพบว่าเอเจนต์ของตัวเองไม่ได้มีปัญหา แต่การประสานงานต่างหากที่เป็นปัญหา นักพัฒนาสามคนรันเอเจนต์ในสามเทอร์มินัล ไม่มีบันทึกกลางว่าใครทำอะไรอยู่ งานซ้ำกัน และกระบวนการรีวิวก็มีแค่ pull request ที่โผล่มาแบบไม่ทันตั้งตัว การซื้อเอเจนต์ที่อัตโนมัติกว่ามาไม่ได้แก้ปัญหานี้ แต่กลับทวีคูณมันขึ้น
เหตุผลข้อที่สามนี้คือข้อที่ควรพูดให้ชัด เพราะมันชี้ไปที่เครื่องมืออีกประเภทหนึ่ง
ประเภทของตัวเลือกอื่น ตามความเป็นจริง
เอเจนต์อัตโนมัติอีกตัว Factory, Zencoder และผลิตภัณฑ์ที่คล้ายกันแข่งกันในงานที่เน้นการมอบหมายทั้งกระบวนการแบบเดียวกัน ถ้าคุณต้องการความเป็นอัตโนมัติและ Devin ไม่ตอบโจทย์ นี่คือที่ที่ควรไปดู การสลับไปมาภายในหมวดเดียวกันยังคงรักษาเศรษฐศาสตร์แบบเอเจนต์คิดตามการใช้งานไว้
ตัวรันแบบขนานบนเครื่อง Conductor รันเอเจนต์ Claude Code, Codex และ Cursor แบบขนานในเวิร์กสเปซแยกกันบน Mac ของคุณ มันทำออกมาเนียน และแพ็กเกจฟรีก็ให้คุณใช้สมาชิกและคีย์ของตัวเองได้ ข้อจำกัดอยู่ที่แพลตฟอร์ม: เอกสารของ Conductor ระบุว่ายังไม่รองรับ Windows หรือ Linux
การประสานงานแบบโฮสต์ Tembo รันเอเจนต์เขียนโค้ดในเซสชันคลาวด์ที่เข้าถึงผ่าน Slack, Linear, GitHub และ Sentry โดยมีวงเงินเป็นดอลลาร์ครอบคลุมการใช้งาน gateway และคอมพิวต์ของ VM ที่ใช้ในเซสชัน คุณเลิกจัดการเครื่องไปเลย แล้วหันมาจ่ายค่าคอมพิวต์แทน
การมอบหมายจากตัวติดตามงาน ถ้าเอเจนต์ของคุณอยู่ในรายชื่อของ Linear อยู่แล้ว การมอบหมายงานจาก issue อาจเป็นชั้นการทำงานทั้งหมดที่คุณต้องการ มนุษย์ยังเป็นผู้รับผิดชอบหลัก และเอเจนต์ถูกเพิ่มเข้ามาในฐานะผู้ร่วมงาน
ระบบงานที่มีชั้นการทำงานรองรับอยู่ข้างใต้ นี่คือหมวดที่ Sharkly อยู่ และเป็นหมวดที่ตอบโจทย์กรณี “เราจ่ายค่าเอเจนต์อยู่แล้ว แต่ต้องการการประสานงาน”
บทความรวมรวบเครื่องมือที่ดีที่สุดสำหรับจัดการเอเจนต์เขียนโค้ด AI แบบขนานของเราพูดถึงตัวเลือกเหล่านี้แบบเทียบกันให้เห็นชัดเจนยิ่งขึ้น
คำตอบด้านการประสานงานทำงานอย่างไร
เริ่มจากขอบเขตก่อน เพราะมันจะช่วยไม่ให้คุณเสียเวลาประเมินผิดตัว Sharkly ไม่ใช่ตัวแทนของ Claude Code, Codex หรือเครื่องมือรันอื่น ๆ มันเพิ่มชั้นของ task กลาง, Computer, บริบท, การควบคุม และการรีวิวเข้าไปรอบ ๆ เครื่องมือที่ทีมคุณใช้อยู่ ถ้าคุณอยากได้ผู้ขายรายเดียวที่รับผิดชอบงานทั้งหมดตั้งแต่ต้นจนจบ นั่นคือรูปแบบของ Devin ไม่ใช่ของ Sharkly
สิ่งที่ Sharkly ทำแทนคือทำให้เอเจนต์ที่คุณจ่ายเงินอยู่แล้วทำงานเหมือนสมาชิกในทีม
Computer เป็นโฮสต์สำหรับรันงานของ Agent: คอมพิวเตอร์ในเครื่อง เซิร์ฟเวอร์ระยะไกล คอนเทนเนอร์ หรือโฮสต์คลาวด์ที่รองรับ บริการขนาดเล็กที่รันในเครื่องจะเชื่อมต่อกับ Sharkly ตรวจจับ Runtimes ที่มีอยู่ รับงาน เตรียมไดเรกทอรีของ task เริ่ม Runtime ที่เลือก และสตรีมความคืบหน้ากลับมา Runtime ที่รันก็คือตัวที่นักพัฒนาของคุณติดตั้งและล็อกอินไว้แล้ว ดังนั้นการใช้งานโมเดลจึงยังเดินผ่านสมาชิกหรือ API key ที่ตั้งค่าไว้ในเครื่องมือเหล่านั้น
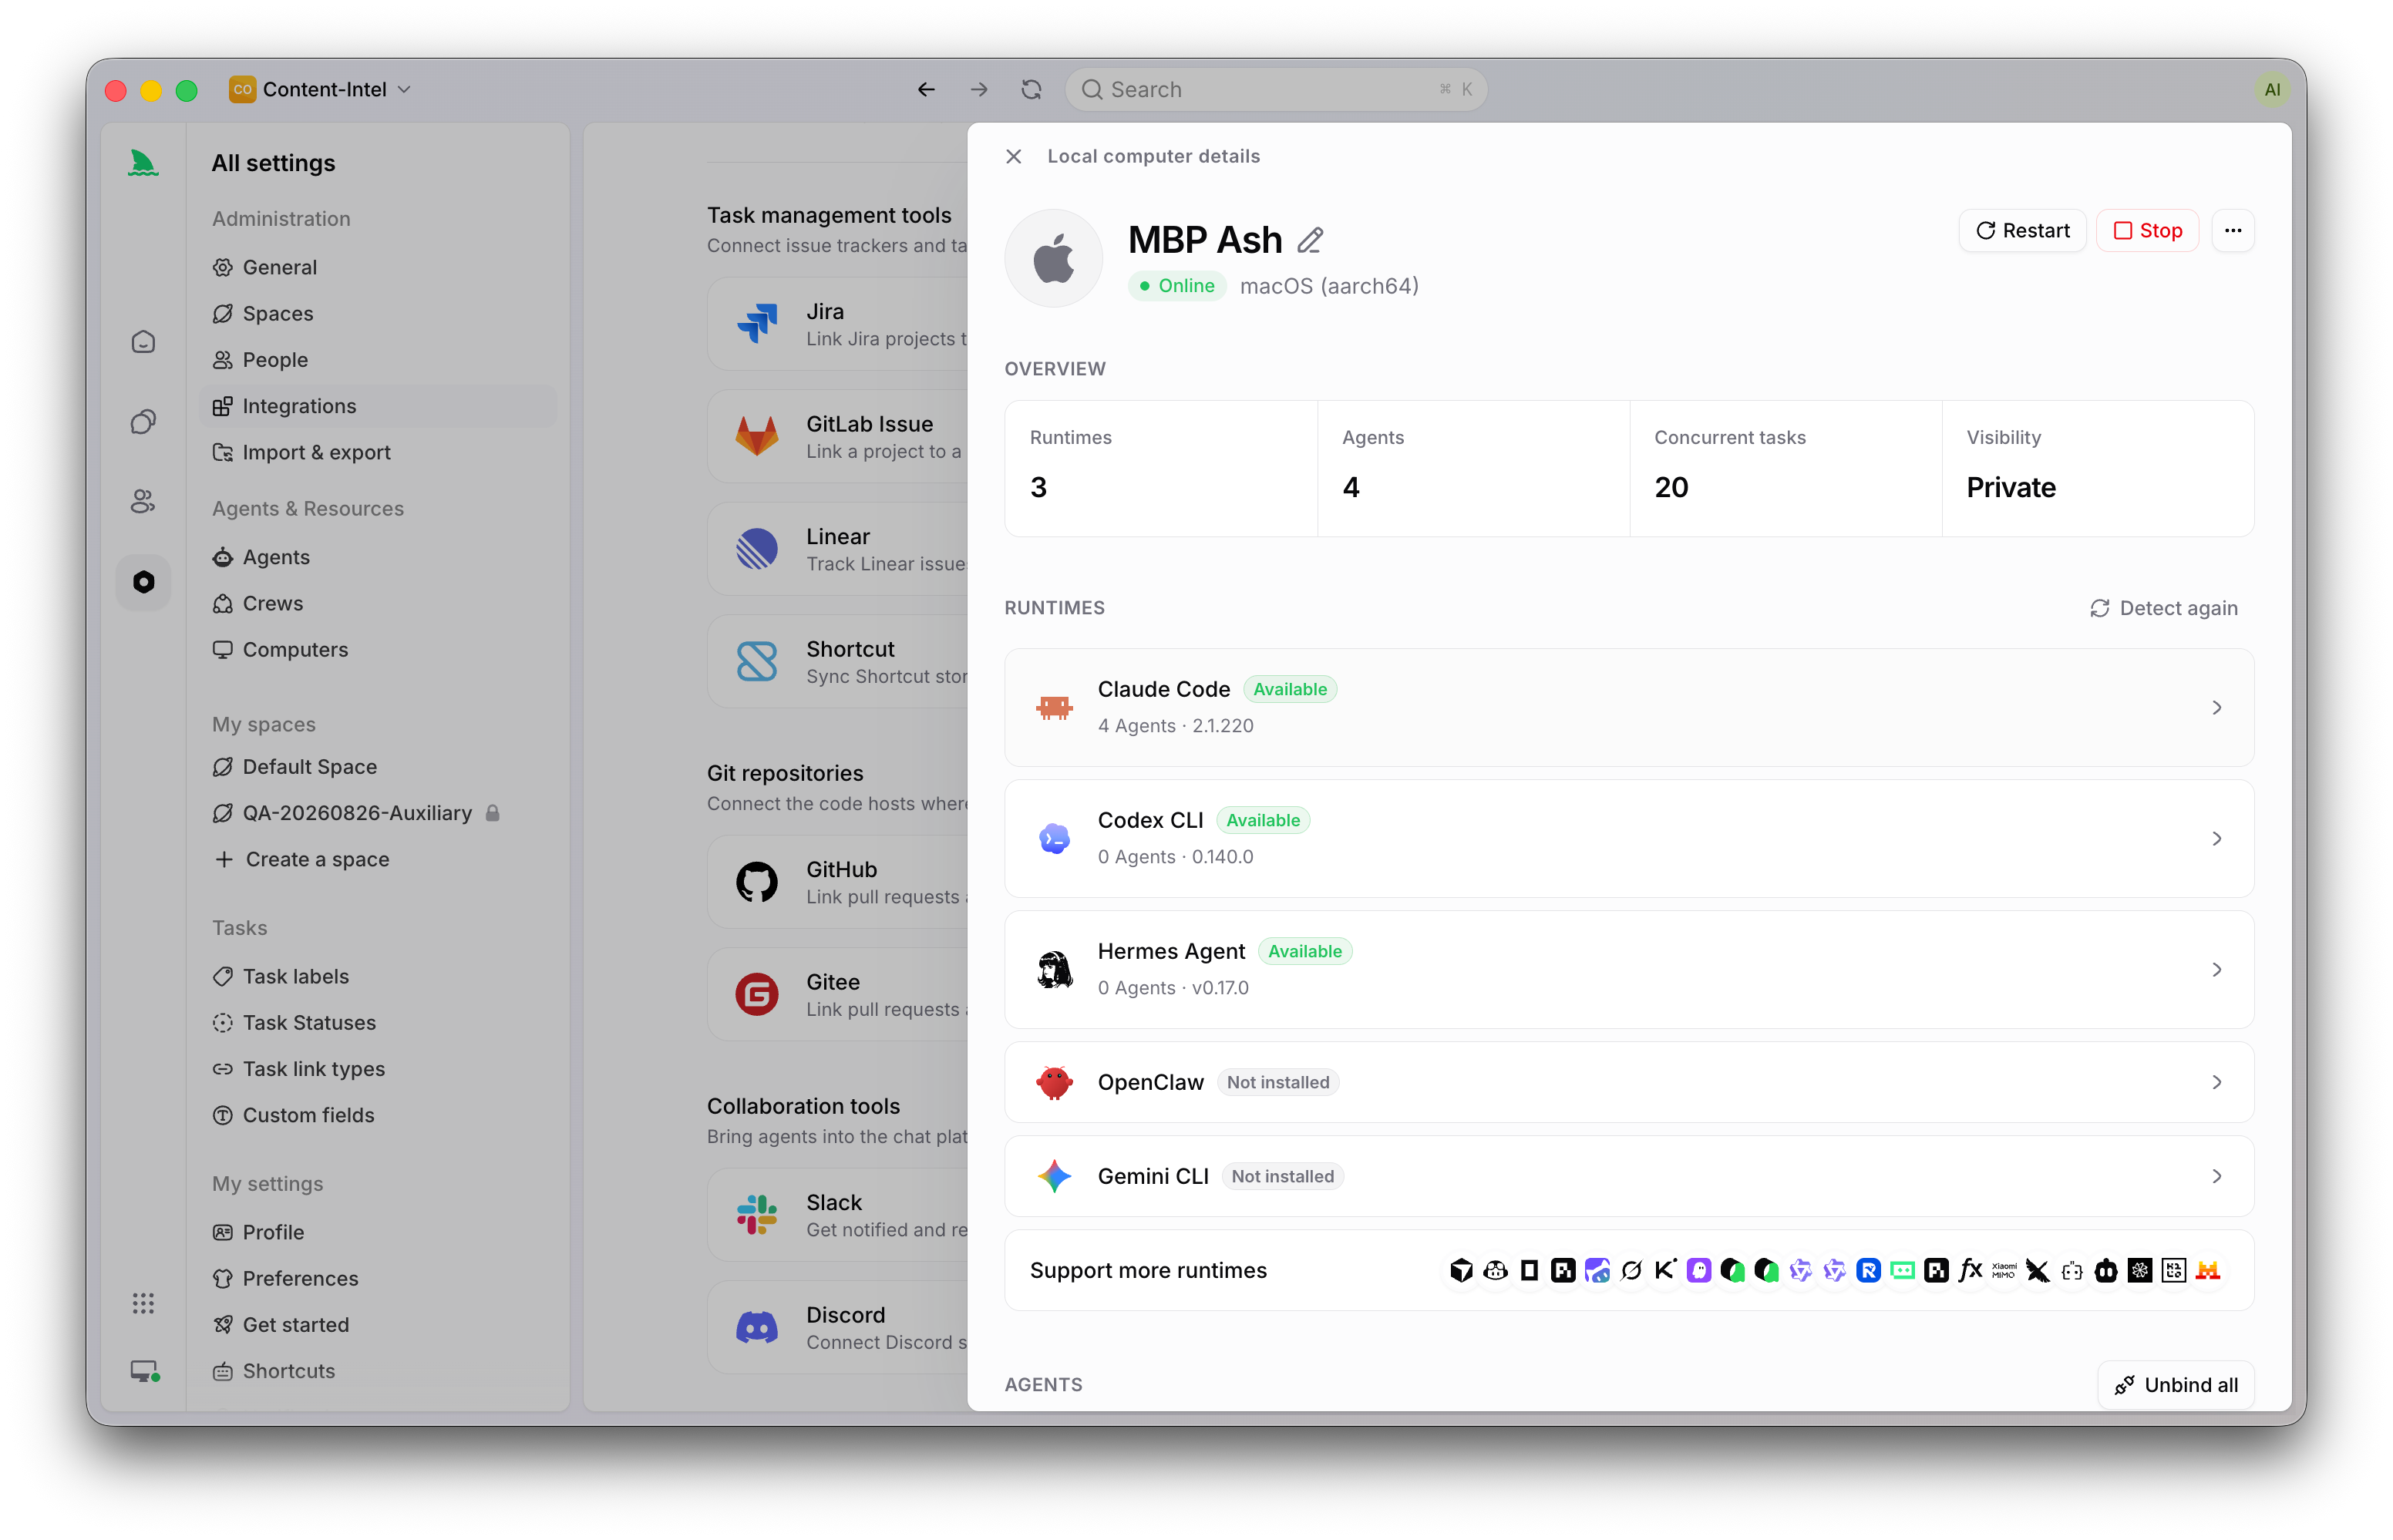
Agent คือชุดการทำงานที่บันทึกไว้ ไม่ใช่พรอมป์ครั้งเดียวจบ: ประกอบด้วยคำสั่ง Runtime, Skills, รีพозитори, สภาพแวดล้อม และการตั้งค่าการรัน ซึ่งเปลี่ยนพรอมป์ที่ใครสักคนกว่าจะตั้งได้ลงตัวให้กลายเป็นสิ่งที่ทั้งทีมมอบหมายงานให้ได้
Task คือหน่วยหลักของงาน มันเก็บเป้าหมาย ผู้รับผิดชอบ Agent หรือ Crew ที่ได้รับมอบหมายให้ทำ ความคิดเห็น ตลอดจนสถานะการทำงานของ Agent, trace และผลลัพธ์ การรีวิวอยู่ข้าง ๆ หลักฐาน แทนที่จะมาในรูปของ pull request ที่ไม่มีใครรู้ที่มา
และเมื่อ Runtime ที่คุณต้องการไม่มีในตัวเลือก คุณสามารถเพิ่ม ACP Runtime แบบกำหนดเองได้จากหน้ารายละเอียด Computer โดยตั้งค่าไอคอน ชื่อ และคำสั่งเริ่มต้น แล้วเลือก Test connection
ตัวอย่างจริง
ทีมขนาดหกคนประเมิน Devin สำหรับคิวงานแก้บั๊กที่ขอบเขตชัดเจน และชอบผลลัพธ์ที่ได้ สิ่งที่ทำให้พวกเขาหยุดคืองบก้อนที่สอง: หกคนมีห้าคนที่มี Claude Code อยู่แล้ว และสองคนมี Codex ผ่าน ChatGPT
ปัญหาจริงของพวกเขา เมื่ออธิบายออกมาชัด ๆ ไม่ใช่คุณภาพของเอเจนต์ แต่คือสามคนรันเอเจนต์พร้อมกันโดยไม่มีมุมมองร่วม สองคนแก้บั๊กซ้ำกันเมื่อสัปดาห์ก่อน และงานรีวิวก็มาในรูป pull request ที่ไม่มีใครมีบริบท
พวกเขาเชื่อมต่อ Computers สองเครื่อง: แล็ปท็อปของนักพัฒนาหนึ่งเครื่อง และเซิร์ฟเวอร์ Linux ที่ใช้ร่วมกันอีกหนึ่งเครื่องซึ่งมีเส้นทางเครือข่ายไปยังสเตจจิง พวกเขาสร้าง Agents สามตัว ตัวหนึ่งสำหรับแก้บั๊ก อีกตัวสำหรับ test coverage และอีกตัวสำหรับเอกสาร โดยแต่ละตัวมีคำสั่งที่เจาะจงและสิทธิ์เข้าถึงรีพอซิทอรีที่เหมาะสม ตั๋วบั๊กกลายเป็น Tasks ที่มอบหมายให้ Agent แก้บั๊ก โดยแต่ละการรันอยู่ใน worktree แยกกัน งานขนานจึงไม่ชนกันอีก คู่มือของเราเรื่องการรันเอเจนต์แบบขนานใน worktree ที่แยกกันอธิบายการตั้งค่านี้ไว้
ค่าใช้จ่ายไม่เปลี่ยน เพราะการรันเหล่านั้นใช้สมาชิกที่พวกเขาจ่ายอยู่แล้ว สิ่งที่เปลี่ยนคือทำงานซ้ำกันหยุดไป อุปสรรคต่าง ๆ มองเห็นได้ก่อนประชุมประจำวัน และผู้รีวิวอ่าน trace ควบคู่กับ diff ได้
สำหรับงานที่มอบหมายได้จริง ๆ อย่างตั๋วสองสามใต่ต่อเดือนที่ไม่มีใครอยากเริ่ม พวกเขาเก็บที่นั่ง Devin ไว้หนึ่งที่ นั่นเป็นผลลัพธ์ที่สมเหตุสมผล ไม่ใช่การประนีประนอม
Devin กับชั้นการประสานงาน: การเปรียบเทียบที่เป็นธรรม
| Devin | Sharkly | |
|---|---|---|
| รูปแบบผลิตภัณฑ์ | วิศวกรซอฟต์แวร์อัตโนมัติที่คุณมอบหมายงานให้ | ชั้นการจัดการงานและการรันที่ครอบเอเจนต์ที่คุณรันอยู่แล้ว |
| เอเจนต์ | ของ Cognition เอง | Claude Code, Codex, Gemini CLI, OpenCode และ Runtimes อื่น ๆ ที่ตรวจพบบน Computer ของคุณ รวมถึง ACP Runtime แบบกำหนดเอง |
| โมเดลการคิดค่าบริการ | Agent Compute Units ที่วัดงานอัตโนมัติที่ทำจริง | การใช้งานโมเดลยังเดินผ่านสมาชิกหรือ API key ที่ตั้งค่าไว้ในเครื่องมือเหล่านั้นอยู่แล้ว |
| งานรันที่ไหน | โครงสร้างพื้นฐานของ Cognition พร้อมตัวเลือกการดีพลอยระดับองค์กร | Computers ที่คุณเชื่อมต่อ: ในเครื่อง เซิร์ฟเวอร์ระยะไกล คอนเทนเนอร์ หรือโฮสต์คลาวด์ที่รองรับ |
| การเข้าถึงสภาพแวดล้อม | จำลองขึ้นใหม่ในสภาพแวดล้อมของเอเจนต์ | สิ่งที่ Computer ที่เชื่อมต่อมีอยู่แล้ว |
| การประสานงาน | แยกตามเซสชัน | Tasks, Projects, Sprints และ Crews ที่มี Agent เป็นหัวหน้า |
| บันทึกการรีวิว | ประวัติเซสชันและ PR ที่ได้ | Task ที่เก็บสถานะการทำงาน, trace, ผลลัพธ์ และความคิดเห็นแบบเธรด |
| เหมาะที่สุดกับ | งานที่ระบุชัดเจนและคุณอยากมอบหมายให้ทำทั้งกระบวนการ | ทีมที่มีสมาชิกเอเจนต์อยู่แล้วแต่ขาดการประสานงาน |
ข้อผิดพลาดที่พบบ่อยตอนเปลี่ยนเครื่องมือ
ซื้อชั้นการประสานงานเพื่อหวังความเป็นอัตโนมัติ ถ้าสิ่งที่คุณอยากได้คือเอเจนต์ที่รับผิดชอบงานเองโดยไม่ต้องมีคนดูแล ชั้นการประสานงานจะทำให้คุณผิดหวัง สองอย่างนี้เป็นผลิตภัณฑ์คนละแบบ
ข้ามคำถามเรื่องสภาพแวดล้อม เหตุผลที่ runtime ในเครื่องมักทำงานได้ดีกว่าแบบโฮสต์บนรีพอซิทอรีของคุณนั้นช่างน่าเบื่อ: มันเข้าถึง private registry, ฐานข้อมูลที่ seed ไว้ และเส้นทางไปสเตจจิงได้ ไม่ว่าคุณจะเลือกเครื่องมือไหน ตัดสินใจก่อนว่าให้สภาพแวดล้อมอยู่ที่ไหน แล้วค่อยไปเทียบคุณภาพของผลลัพธ์
นับจำนวนที่นั่งแต่ลืมนับการรัน เอเจนต์แบบคิดตามการใช้งานมีค่าใช้จ่ายสูงขึ้นในสัปดาห์ที่งานหนัก ส่วน runtime แบบสมาชิกจ่ายเท่าเดิมแต่จะชนลิมิตการใช้งานแทน ไม่มีอันไหนฟรี ทั้งคู่ล้มเหลวคนละแบบ และคุณควรรู้ว่าทีมของคุณรับความล้มเหลวแบบไหนไหว
คิดว่า pilot คือการตัดสินใจแล้ว ตั๋วสามใต่ที่เลือกมาดีจะสำเร็จเกือบทุกที่ ลองรันตั๋วที่ยุ่งเหยิงก่อน ตั๋วที่มี integration test ไม่เสถียรนั่นแหละ ก่อนที่คุณจะเซ็นอะไร
บทสรุป
คำตอบตรง ๆ ของการเปรียบเทียบนี้: ถ้าปัญหาของคุณคือต้องการมอบหมายงานให้ทำทั้งกระบวนการ และยินดีจ่ายเพื่อความเป็นอัตโนมัติแบบคิดตามการใช้งาน Devin ถูกสร้างมาเพื่อสิ่งนั้น และตัวเลือกอื่นในหมวดเดียวกันนั่นแหละที่ควรไปดู
แต่ถ้าปัญหาของคุณคือทีมมีเอเจนต์ที่เก่งอยู่แล้วแต่ไม่มีระบบกลางมารองรับ การซื้อเอเจนต์อีกตัวคือการซื้อผิด สิ่งที่ขาดคือชั้นการทำงานที่ทำให้งานของเอเจนต์มอบหมายได้ แยกจากกันได้ ตรวจสอบย้อนหลังได้ และรีวิวได้: Agents ในฐานะชุดการทำงานที่บันทึกไว้, Computers ที่มีสภาพแวดล้อมจริงของคุณ และ Task ที่แผนงาน, trace และการตัดสินใจของมนุษย์อยู่ร่วมกัน
นั่นคือสิ่งที่ Sharkly ทำได้ เชื่อมต่อ Computer หนึ่งเครื่อง สร้าง Agent หนึ่งตัว และมอบหมาย Task เล็ก ๆ หนึ่งงาน ก่อนที่คุณจะตัดสินใจอะไรที่ใหญ่กว่านั้น
คำถามที่พบบ่อย
Sharkly แทน Devin ได้เลยไหม? ไม่ Devin เป็นเอเจนต์อัตโนมัติ ส่วน Sharkly เป็นชั้นที่ครอบเอเจนต์ไว้ และรันเอเจนต์ที่ทีมของคุณใช้อยู่ ทีมที่อยากได้การมอบหมายงานทั้งกระบวนการสำหรับงานบางส่วนมักเก็บทั้งสองไว้
Sharkly คิดค่าบริการตามการรันเอเจนต์ไหม? การใช้งานโมเดลยังเดินผ่านสมาชิกหรือ API key ที่ตั้งค่าไว้ในเครื่องมือเหล่านั้น โควตาโมเดลขึ้นอยู่กับเครื่องมือเขียนโค้ด AI แพ็กเกจ และบัญชี API ที่ทีมของคุณเชื่อมต่อ
Devin มีค่าใช้จ่ายเท่าไหร่? Cognition คิดค่าบริการ Devin เป็น Agent Compute Units ซึ่งวัดงานอัตโนมัติที่เอเจนต์ทำจริง ควบคู่กับแพ็กเกจแบบเป็นขั้น ดูตัวเลขปัจจุบันได้ที่ devin.ai/pricing เพราะมันเปลี่ยนมาหลายครั้งแล้ว
Sharkly รันเอเจนต์ตัวไหนได้บ้าง? Runtime ใดก็ตามที่บริการในเครื่องตรวจพบบน Computer ที่เชื่อมต่อ และ ACP Runtime แบบกำหนดเองใดก็ได้ที่คุณตั้งค่าด้วยคำสั่งเริ่มต้นของตัวเอง
รันเอเจนต์บนเซิร์ฟเวอร์แทนแล็ปท็อปได้ไหม? ได้ Computer จะเป็นคอมพิวเตอร์ในเครื่อง เซิร์ฟเวอร์ระยะไกล คอนเทนเนอร์ หรือโฮสต์คลาวด์ที่รองรับก็ได้ และตัว CLI กับบริการในเครื่องติดตั้งได้บน macOS, Linux และ Windows
ถ้าทีมของฉันใช้ Windows ล่ะ? ตัวติดตั้งของ Sharkly รองรับ Windows โดยตัวติดตั้ง Windows ปัจจุบันรองรับเฉพาะ AMD64 เรื่องนี้ควรเอาไปเทียบกับตัวเลือกอื่น เพราะเครื่องมือบางตัวในหมวดนี้รองรับแค่ macOS


