
การทำเว็บสแครปปิงฟรีสำหรับ AI agent ตอนนี้ทำงานบนฮาร์ดแวร์ของคุณเองแล้ว Firecrawl Local คือไบนารี Rust ตัวเดียวที่สแครป Crawl และ Map เว็บไซต์ออกมาเป็น markdown เชื่อมต่อกับ Claude Code, Codex, Cursor หรือ Gemini CLI ในฐานะ MCP server และตอบสนอง Firecrawl v2 API บน localhost ตั้งค่า FIRECRAWL_CLOUD=off แล้วจะไม่มีหน้าเว็บ คำค้นหา หรือ URL ใดออกจากเครื่องของคุณเลย
สรุปสั้น ๆ
- ติดตั้ง:
cargo install firecrawl-local(ต้องมี Rust และ C compiler) บิลด์ของเราใช้เวลา 5 นาที 55 วินาที และได้ไบนารีขนาด 19 MB - เชื่อมต่อ:
firecrawl-local initจะเพิ่ม MCP server ให้กับทุกเครื่องมือ agent ที่รองรับซึ่งตรวจพบ - ค่าใช้จ่าย: $0 สำหรับ scrape, crawl, map และ batch scrape ส่วน search, หน้าเว็บที่ถูกบล็อก และ Alexandria data providers จะวิ่งไปที่ Firecrawl Cloud เว้นแต่คุณจะปิดมัน
- สวิตช์ความเป็นส่วนตัว:
FIRECRAWL_CLOUD=offทำให้ทุกอย่างอยู่ในเครื่อง - การตั้งค่าสำหรับทีม: ติดตั้งครั้งเดียวต่อ Computer ที่ agent ของคุณรันอยู่ แล้วทุก agent บน Computer นั้นจะได้ตัวสแครปเปอร์ตัวเดียวกัน
Firecrawl Local คืออะไร
Firecrawl Local คือไบนารีตัวเดียวจากทีม Firecrawl ที่ดึงหน้าเว็บ ตัดแต่งให้เป็น markdown ที่สะอาด และส่งคืน JSON แบบเดียวกับที่ Firecrawl API แบบโฮสต์ตอบกลับ ไม่ต้องใช้ดาต้าเบส คิว หรือคอนเทนเนอร์ Firecrawl ประกาศเปิดตัวเมื่อวันที่ 18 พฤศจิกายน 2026 และ crate บน crates.io ขึ้นก่อนหน้านั้นหนึ่งสัปดาห์ในเวอร์ชัน 0.1.0
README อธิบายวิธีใช้งานสามแบบ: CLI, MCP server สำหรับ agent และสำเนา v2 API ในเครื่อง โค้ดทำความสะอาดถูกคอมไพล์จากซอร์สเดียวกับที่ API แบบโฮสต์ใช้ ดังนั้นหน้า markdown จากแล็ปท็อปของคุณจะตรงกับสิ่งที่คลาวด์จะส่งคืนสำหรับหน้าที่ทั้งสองเข้าถึงได้
โพสต์เปิดตัวของ Firecrawl อ้างว่า scrape primitive เร็วกว่า Firecrawl แบบ self-hosted 37 เท่า และใช้หน่วยความจำน้อยกว่า 230 เท่า ที่ 11 MB ตอน idle นั่นคือตัวเลขของ Firecrawl เอง README ไม่ได้เผยวิธีการวัด ส่วนหน่วยความจำเราได้ทดสอบเองด้านล่าง
ถ้าคุณรัน coding agent หลายตัวอยู่แล้ว นี่คือสแครปเปอร์ตัวแรกที่คุณมอบให้ทุกตัวได้โดยไม่มีบิลต่อการเรียก ที่เหลือของคู่มือนี้ครอบคลุมการตั้งค่า สวิตช์ความเป็นส่วนตัว และวิธีมอบเครื่องมือเดียวกันให้ agent ทั้งทีมบน Sharkly
ทำไม agent ถึงต้องมีสแครปเปอร์ในเครื่อง
Agent ที่อ่านเว็บไม่ได้จะทำงานจากข้อมูลเทรนที่เก่า มันเดา API ที่ไม่เคยเห็น หรือขอให้คุณแปะเอกสารลงในแชท
API สแครปปิงแบบโฮสต์แก้ปัญหานี้ได้ แต่เพิ่มต้นทุนสองอย่าง ทุกหน้าเว็บคือการเรียกที่คิดเงิน ดังนั้นการ crawl เว็บเอกสาร 400 หน้าจึงกลายเป็นรายการในใบแจ้งหนี้ และทุก URL ที่ agent เปิดจะผ่านเซิร์ฟเวอร์ของคนอื่น ซึ่งสำคัญมากเมื่อ agent กำลังค้นคว้าโดเมนของลูกค้าหรือหน้าคู่แข่งที่ยังไม่เปิดตัว
สแครปเปอร์ในเครื่องกำจัดทั้งสองอย่าง หน้าเว็บถูกดึงจากเครือข่ายของคุณเองและทำความสะอาดบน CPU ของคุณเอง ข้อแลกเปลี่ยนคือคุณต้องดูแลการติดตั้งและขีดจำกัดที่มาพร้อมแล็ปท็อป
ติดตั้ง Firecrawl Local
คุณต้องมี Rust และ C compiler บน macOS xcode-select --install จัดการคอมไพเลอร์ให้ บน Debian หรือ Ubuntu ให้ติดตั้ง build-essential ติดตั้ง Rust ได้จาก rustup
cargo install firecrawl-local
firecrawl-local --version
# firecrawl-local 0.1.0
มีสองอย่างที่เสริมได้หรือไม่ก็ได้ Chrome หรือ Chromium ทำให้เรนเดอร์หน้าที่ต้องใช้ JavaScript ได้ ถ้าไม่มี หน้ามาตรฐานก็ยังทำงานได้และหน้าที่ใช้สคริปต์หนักจะส่งคืนพร้อมคำเตือน ส่วน Node.js 22 ขึ้นไปจำเป็นสำหรับ MCP server เพราะ firecrawl-local mcp รันแพ็กเกจ npm firecrawl-mcp ผ่าน npx
Scrape, crawl และ map จาก CLI
สามคำสั่งครอบคลุมงานของ agent ส่วนใหญ่
# One page as markdown
firecrawl-local scrape https://example.com --markdown

# Up to 50 pages, one markdown file each
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages

# Every URL a site exposes
firecrawl-local map https://firecrawl.dev
เรารันแต่ละคำสั่งเมื่อวันที่ 19 พฤศจิกายน 2026 โดยปิดคลาวด์ การ scrape ครั้งเดียวของ example.com เสร็จใน 1.6 วินาที การ crawl 10 หน้าของเอกสาร Firecrawl เองใช้เวลา 4.2 วินาทีและเขียน markdown 144 KB ส่วน map ส่งคืนรายการ URL ของเอกสารใน 3.9 วินาที
| คำสั่ง | แฟล็กที่มีประโยชน์ |
|---|---|
scrape |
--markdown, --format markdown,links, --full-page, --timeout |
crawl |
--limit (ค่าเริ่มต้น 100), --max-depth, --include, --exclude, --out |
map |
--search, --limit |
| ทุกคำสั่ง | --browser auto|never|always |
จุดพลาดหนึ่งจากการรันของเรา: บนเครือข่ายที่เข้าถึงเว็บได้ผ่านพร็อกซี่เท่านั้น การ scrape ครั้งแรกผิดพลาดด้วย TLS error การตั้งค่า HTTPS_PROXY แก้ได้ เพราะไบนารีรองรับตัวแปรพร็อกซี่มาตรฐาน
เชื่อมต่อกับ AI agent ผ่าน MCP
MCP (Model Context Protocol) คือมาตรฐานที่เครื่องมือ agent ใช้โหลดเครื่องมือภายนอก Firecrawl Local ลงทะเบียนตัวเองเป็นหนึ่งในนั้น
firecrawl-local init --dry-run   # show what would change
firecrawl-local init             # write it, backing up each config first
Dry run บน Mac ของเราแสดงเป้าหมายห้าจุด: Claude Code ใน ~/.claude.json, Claude Desktop, Cursor ใน ~/.cursor/mcp.json, Gemini CLI ใน ~/.gemini/settings.json และ Codex ใน ~/.codex/config.toml ส่วน Windsurf ก็รองรับหากติดตั้งไว้ รีสตาร์ทแต่ละเครื่องมือหลัง init เพื่อให้โหลดเซิร์ฟเวอร์ ใช้ --agent cursor เพื่อตั้งค่าเฉพาะเครื่องมือเดียว
ถ้าจะเพิ่มด้วยมือ ให้ลงทะเบียนไบนารีเป็น stdio server:
{
  "mcpServers": {
    "firecrawl": {
      "command": "/Users/you/.cargo/bin/firecrawl-local",
      "args": ["mcp", "--public-only"]
    }
  }
}
Agent จะได้เครื่องมือ Firecrawl MCP มาตรฐาน Scrape, crawl, map และ batch scrape รันในเครื่อง ส่วนที่เหลือไปที่ Firecrawl Cloud แฟล็ก --public-only เป็นสิ่งที่เราเพิ่มเอง อธิบายไว้ในหัวข้อความปลอดภัยด้านล่าง
ปิดคลาวด์ไว้เพื่อความเป็นส่วนตัว
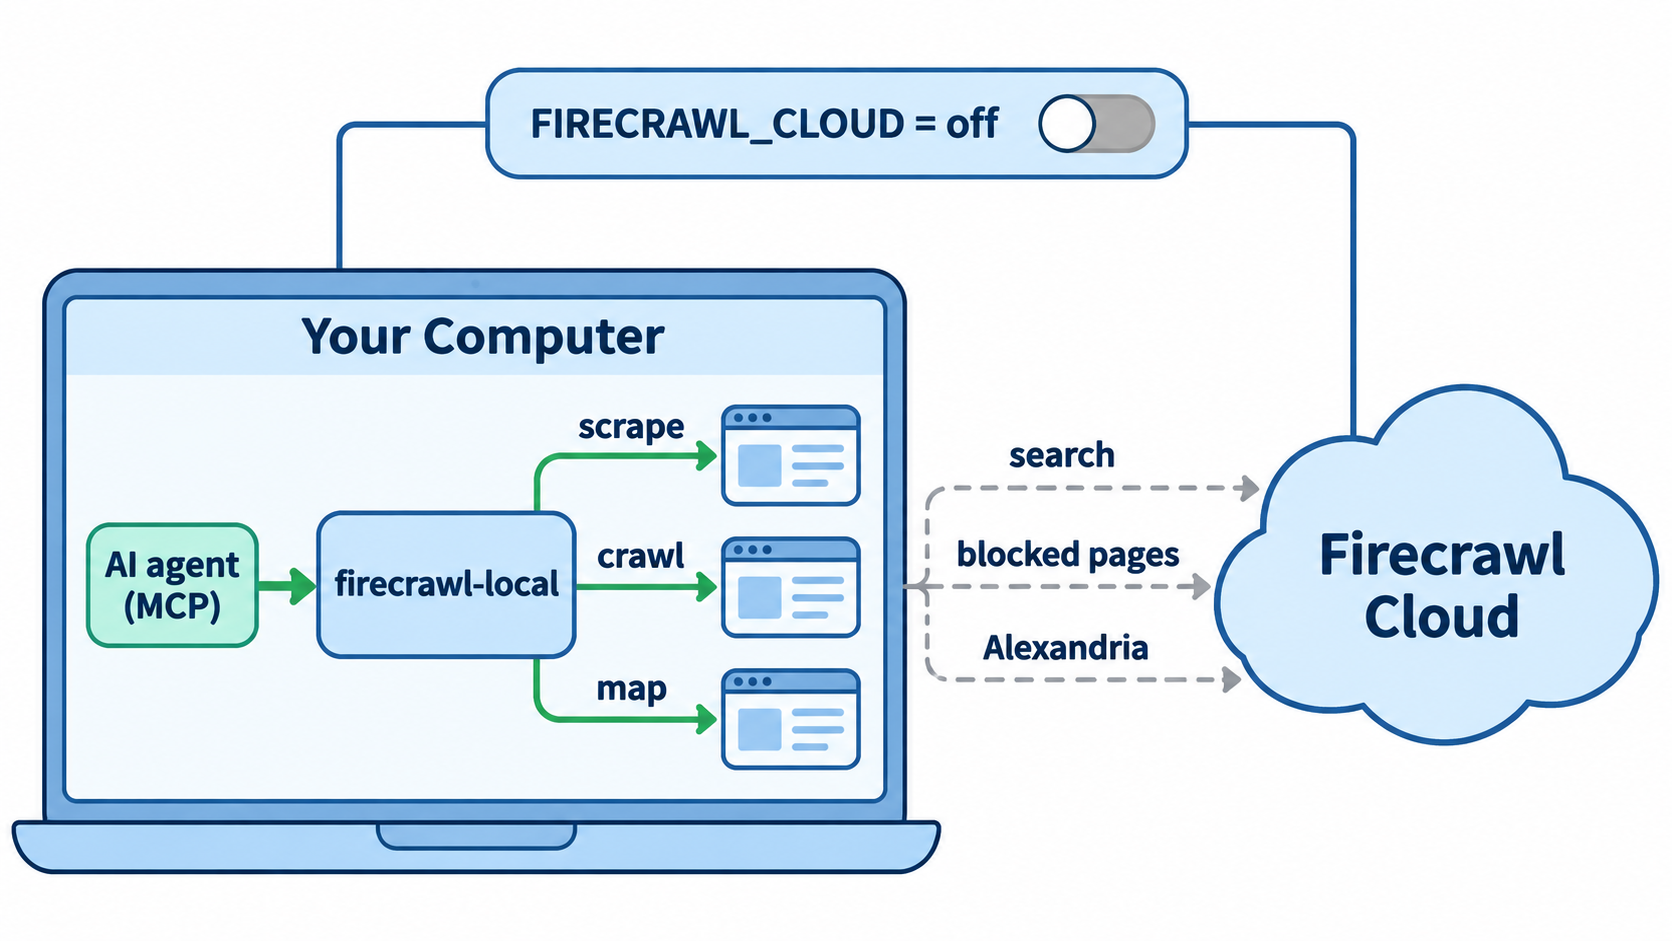
มีสามงานที่ต้องใช้ Firecrawl Cloud เพราะแล็ปท็อปไม่มีดัชนีค้นหาและไม่มีทางเลี่ยงเว็บที่บล็อกมัน
| ส่งไปที่ Firecrawl Cloud | เหตุผล | บัญชี |
|---|---|---|
| คำค้นหา | ไม่มีดัชนีค้นหาในเครื่อง | ไม่ต้อง; search แบบไม่ใช้คีย์มีอัตราจำกัด |
| URL ของหน้าที่บล็อกคุณ | คลาวด์ดึงมาให้ | ไม่ต้อง |
| Alexandria data providers | ผู้ให้บริการรันบนคลาวด์ | ต้องใช้บัญชีฟรีผ่าน firecrawl-local login |
| install ID แบบสุ่มและชื่อเครื่องมือของคุณ | นับจำนวนการติดตั้ง | ไม่ต้อง |
ตัวแปร FIRECRAWL_CLOUD ควบคุมการส่งต่อ auto (ค่าเริ่มต้น) อนุญาตทั้งหมดข้างต้น search ส่งเฉพาะคำค้นหา off ไม่ส่งอะไรเลย และค่าที่ไม่รู้จักก็ถือเป็น off ด้วย หน้าที่ถูกดึงผ่านคลาวด์จะถูกติดแท็ก "source": "firecrawl-cloud" คุณจึงตรวจสอบได้ว่ามีอะไรออกไป
สำหรับงานของ agent บนเว็บลูกค้าหรือการวิจัยภายใน ให้เริ่มด้วย off Agent ของคุณจะเสีย web search ไป จึงควรจับคู่กับเครื่องมือค้นหาที่คุณไว้ใจอยู่แล้ว
รัน Firecrawl API ในเครื่อง
firecrawl-local serve ตอบสนอง Firecrawl v2 API บนพอร์ต 3002 โดยไม่ต้องใช้ API key สำหรับ route ในเครื่อง โค้ด SDK ที่มีอยู่สลับได้ด้วยการเปลี่ยน URL เดียว
from firecrawl import Firecrawl

app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)
Route ในเครื่องได้แก่ POST /v2/scrape, POST /v2/map, crawl และ batch scrape พร้อม endpoint สถานะและการยกเลิก และ GET /health Route /v2 อื่น ๆ เช่น /v2/search จะถูกส่งต่อไปยังคลาวด์ ส่วน v0 และ v1 ไม่ได้ให้บริการ
เราวัดหน่วยความจำระหว่างที่มันรัน: โปรเซส serve อยู่ที่ 10 MB resident ตอน idle และ 16 MB หลัง scrape หนึ่งครั้ง ใกล้เคียงกับที่ Firecrawl อ้างไว้ 11 MB การ scrape ผ่าน API ส่งคืน "creditsUsed": 0 และ "engine": "local-fetch"
ค่าเริ่มต้นด้านความปลอดภัยที่สำคัญสำหรับ agent
Agent ที่อ่านหน้าที่มีคำสั่งซ่อนอยู่สามารถถูกชี้นำให้ดึง URL ภายในได้ OWASP จัดประเภทการโจมตีแบบนี้ว่าเป็น prompt injection และสแครปเปอร์คือช่องทางที่ชัดเจนที่สุด
serveผูกกับ127.0.0.1และปฏิเสธ localhost และที่อยู่ private เว้นแต่คุณจะส่ง--allow-privateเราให้มัน scrape127.0.0.1:22แล้วได้BLOCKED_TARGET- การผูกกับโฮสต์อื่นด้วย
--hostต้องใช้--token - ที่อยู่ link-local และ cloud metadata ถูกบล็อกในทุกโหมด รวมถึงหลังจาก redirect
scrape,crawlและmcpเข้าถึงเครือข่าย private ของคุณได้โดยค่าเริ่มต้น เพราะรันให้คนที่นั่งหน้าแป้นพิมพ์ เพิ่ม--public-onlyเมื่อ agent ท่องเว็บที่คุณไม่ไว้ใจ- การ crawl อ่าน
robots.txt(มาตรฐาน RFC 9309) และเจ้าของเว็บสามารถระบุตัว crawler ในชื่อFirecrawlLocal
ข้อจำกัดที่ต้องวางแผนรับมือ
- ไม่มีฟอร์แมต
jsonหรือsummaryและไม่มีactionsของเบราว์เซอร์ในเครื่อง คำขอsummaryของเราได้ metadata กับคำเตือนว่าฟอร์แมตนั้นถูกข้ามไป - Screenshot ต้องใช้ Chrome
- งาน crawl และ batch อยู่ในหน่วยความจำหมดอายุหนึ่งชั่วโมงหลังเริ่ม และจบเมื่อ
serveหยุด - สัญญาอนุญาต: repo ใช้ AGPL-3.0 ปรึกษาทีมกฎหมายก่อนเผยแพร่สำเนาที่ดัดแปลงภายในผลิตภัณฑ์แบบโฮสต์
สำหรับคิว worker และทุกฟอร์แมต คู่มือ self-hostingของ Firecrawl ครอบคลุมเซิร์ฟเวอร์เต็มรูปแบบ
มอบสแครปเปอร์เดียวกันให้ทุก agent ในทีม
นักพัฒนาคนเดียวกับ agent ตัวเดียวหยุดตรงนี้ได้ แต่ทีมที่รัน agent หลายตัวเจอปัญหาต่างออกไป: เครื่องมือของ agent แต่ละตัวอยู่ในคอนฟิกของคอมพิวเตอร์ที่มันรัน และไม่มีใครติดตามว่า agent ตัวไหนอ่านเว็บได้
ใน Sharkly Agent รันบน Computer (แล็ปท็อป เซิร์ฟเวอร์ หรือคอนเทนเนอร์ที่คุณเชื่อมต่อ) ผ่าน Runtime ซึ่งเป็นเครื่องมือ agent ที่ติดตั้งอยู่ที่นั่น เช่น Claude Code หรือ Codex คุณติดตั้งเครื่องมือบน Computer เหมือนที่ทำเมื่อใช้โดยตรง จากนั้นการตั้งค่า Tools, Knowledge & MCP ของ Agent จะแสดง MCP server ที่มันสืบทอดมาจาก Claude Code บน Computer นั้น รวมถึง stdio server ใน user-config ซึ่งเป็น scope ที่ init เขียนไป
ดังนั้นการตั้งค่าคือ: ติดตั้ง Firecrawl Local บน Computer รัน init เปิดการตั้งค่าของ Agent แล้วคลิก Check เรายืนยันว่าแผงแสดง stdio server ใน user-config แต่ยังไม่ได้รัน Firecrawl scrape ภายใน Sharkly Task所以我们 ลอง Task แบบอ่านอย่างเดียวหนึ่งครั้งก่อน
วางสแครปเปอร์ไว้บน Computer ที่เปิดตลอด
แล็ปท็อปหลับได้ เซิร์ฟเวอร์ Linux ขนาดเล็กที่ลงทะเบียนเป็น Computer (sharkly computer register ด้วย install token sit_ ตามที่ระบุใน เอกสาร Computers) เปิดอยู่ตลอด ทุก Agent ที่ชี้มาที่มันจึงใช้สแครปเปอร์ตัวเดียวและนโยบาย FIRECRAWL_CLOUD เดียว ตั้งค่าตัวแปรใน Runtime environment ของ Agent เพื่อให้นโยบายติดไปกับ Agent ไม่ใช่ติดกับคนที่ล็อกอินล่าสุด
จากตรงนั้น การวิจัยกลายเป็นงานที่มอบหมายได้ หัวหน้า Crew แบ่ง "map เอกสารของห้าผู้ขายเหล่านี้" เป็น Task แต่ละ Agent crawl ส่วนของตัวเองในเครื่อง และผลลัพธ์ไปอยู่บนบอร์ดรอคนตรวจ Sharkly ฟรีสำหรับองค์กรไม่เกิน 5 คนในตอนนี้ และ Agent กับ Computer ไม่กินที่นั่ง ส่วนโมเดลยังใช้การสมัครสมาชิกของคุณเอง
การใช้งานจริง
- การนำเข้าเอกสาร: crawl เอกสารของไลบรารีเป็น markdown ก่อน agent อัปเกรด dependency
- การวิจัยลีด: จับคู่การสแครปในเครื่องกับ Alexandria providers เหมือนในบทแนะนำการสร้างลิสต์ลีดของเรา
- การเฝ้าดู changelog: Task ที่ตั้งเวลาไว้จะ map เว็บของผู้ขายทุกวันและแจ้ง URL ใหม่
- การวิจัยส่วนตัว: สแครปหน้าเว็บของลูกค้าหรือก่อนเปิดตัวโดยปิดคลาวด์ ไม่มีอะไรออกจากเครือข่ายของคุณ บทความของเราเรื่องทำไมการปิด web search ไม่หยุดการรั่วไหลข้อมูลของ AI agentครอบคลุมช่องทางออกอื่น ๆ
บทสรุป
Firecrawl Local ทำให้การทำเว็บสแครปปิงฟรีสำหรับ AI agent เป็นเพียงการบิลด์หกนาทีและคำสั่ง init หนึ่งคำสั่ง เก็บ FIRECRAWL_CLOUD=off ไว้สำหรับงานส่วนตัว เพิ่ม --public-only สำหรับเว็บที่ไม่ไว้ใจ และถือว่าข้ออ้างเรื่องความเร็วเป็นของ Firecrawl จนกว่าคุณจะวัดเอง
ก้าวต่อไปของคุณ: ติดตั้งมันบน Computer ที่ agent ของคุณใช้อยู่ แล้วเชื่อมต่อ Computer นั้นกับ Sharklyเพื่อให้ทุก Agent ในทีมได้สแครปเปอร์และกฎเดียวกัน สำหรับการตั้งค่า $0 เพิ่มเติม ดูAI agent ฟรีสำหรับทีม
คำถามที่พบบ่อย
Firecrawl Local ฟรีหรือไม่? ฟรี Scrape, crawl, map และ batch scrape รันในเครื่องโดยไม่ต้องใช้ API key และการทดสอบ scrape ของเรารายงานว่าใช้ 0 credits ส่วน search และ Alexandria ใช้ Firecrawl Cloud
Firecrawl Local ต้องใช้ Docker หรือไม่? ไม่ต้อง เป็นไบนารีตัวเดียวที่ไม่ต้องมีดาต้าเบส คิว หรือคอนเทนเนอร์ Docker เป็นเพียงทางเลือก และการเรนเดอร์ JavaScript ในคอนเทนเนอร์ต้องใช้ seccomp profile ที่อนุญาต sandbox ของ Chrome
firecrawl-local init รองรับ agent ตัวไหนบ้าง? Claude Code, Claude Desktop, Cursor, Windsurf, Gemini CLI และ Codex MCP client อื่นใดลงทะเบียน firecrawl-local mcp เป็น stdio server ได้
เก็บการสแครปทั้งหมดออกจากเซิร์ฟเวอร์ของ Firecrawl ได้ไหม? ได้ ตั้ง FIRECRAWL_CLOUD=off คุณจะเสีย search, ตัวสำรองสำหรับหน้าที่ถูกบล็อก และ Alexandria
Firecrawl Local เร็วกว่า Firecrawl แบบ self-hosted หรือไม่? Firecrawl บอกว่าเร็วกว่า 37 เท่าและใช้หน่วยความจำน้อยกว่า 230 เท่า เราวัดได้ 10 MB ตอน idle ซึ่งตรงกับข้ออ้างเรื่องหน่วยความจำ แต่เราไม่ได้เปรียบเทียบความเร็วกับเซิร์ฟเวอร์ self-hosted
Firecrawl Local เป็นโอเพนซอร์สหรือไม่? Repo ใช้สัญญาอนุญาต AGPL-3.0 อ่านสัญญาอนุญาตก่อนเผยแพร่สำเนาที่ดัดแปลงเป็นส่วนหนึ่งของบริการแบบโฮสต์


