GPT-6.2 Astra กับ Fable 5.2 สูสีกันกว่าที่พาดหัวข่าวบอก ทั้งคู่ตั้งราคา $8 ต่อล้านโทเค็นอินพุต และ $40 ต่อล้านโทเค็นเอาต์พุต Anthropic เผยแพร่คะแนน agentic coding ที่สูงกว่าสำหรับ Fable 5.2 ส่วน OpenAI ไม่ได้เผยแพร่ benchmark ด้าน coding สำหรับ Astra ราคาแคช ค่าธรรมเนียมบริบทขนาดใหญ่ และอัตราการยอมรับการเปลี่ยนแปลงของคุณเองคือสิ่งที่ตัดสินผู้ชนะสำหรับทีมคุณ
OpenAI เปิดตัว GPT-6.2 Astra เมื่อวันที่ 17 พฤศจิกายน 2026 แปดวันหลังจากที่ Anthropic ปล่อย Claude Fable 5.2 ทั้งคู่เป็นโมเดล frontier ที่มุ่งเป้าสู่งานเอเจนต์ที่ยาวและยาก หากคุณใช้งานเอเจนต์เขียนโค้ด ตอนนี้คุณมีตัวเลือกเรือธงสองตัวในราคาเท่ากัน
ลีดเดอร์บอร์ดไม่สามารถตัดสินแทนคุณได้ แต่ dependencies, ชุดทดสอบ และรีวิวเวอร์ของคุณทำได้ คู่มือนี้เปรียบเทียบตัวเลขที่เผยแพร่ แสดงให้เห็นว่าค่าใช้จ่ายแตกต่างกันตรงไหน และให้การทดสอบแบบตัวต่อตัวที่คุณรันบนรีโปของคุณเองได้ หากคุณรัน Codex และ Claude Code เคียงกันอยู่แล้ว Sharkly คือที่ที่คุณมอบหมายงานเดียวกันให้ทั้งสองและเก็บผลลัพธ์ไว้ด้วยกัน
GPT-6.2 Astra vs Fable 5.2: เปรียบเทียบสเปกเคียงข้างกัน
GPT-6.2 Astra คือโมเดล frontier ของ OpenAI ในตระกูล GPT-6.2 ส่วน GPT-6.2 Sol เป็นรุ่นน้องที่ราคาถูกกว่าสำหรับงานประจำวัน Claude Fable 5.2 คือโมเดลระดับสูงสุดที่เปิดให้ใช้งานทั่วไปของ Anthropic โดยมี Mythos 5.2 ถูกจำกัดการเข้าถึงไว้เป็นรุ่นพิเศษ นี่คือข้อมูลที่แต่ละผู้ให้บริการเผยแพร่ ณ วันที่ 20 พฤศจิกายน 2026
| GPT-6.2 Astra | Claude Fable 5.2 | |
|---|---|---|
| เปิดตัว | 17 พฤศจิกายน 2026 | 9 พฤศจิกายน 2026 |
| API model ID | gpt-6.2-astra |
claude-fable-5-2 |
| อินพุต ต่อ 1M โทเค็น | $8 | $8 |
| เอาต์พุต ต่อ 1M โทเค็น | $40 | $40 |
| อินพุตแคช (cache hit) | $0.40 | $0.20 |
| Cache write | $10 (30 นาที) | $10 (5 นาที), $16 (1 ชั่วโมง) |
| Batch | 50% ของราคาปกติ | $4 อินพุต, $20 เอาต์พุต |
| Fast mode | 2 เท่าของราคาปกติ | $16 อินพุต, $80 เอาต์พุต |
| Context window | 1,050,000 โทเค็น (อินพุตสูงสุด 922,000) | 1M โทเค็นในราคาปกติ |
| เอาต์พุตสูงสุด | 128,000 โทเค็น | 128,000 โทเค็น |
| ค่าธรรมเนียมอินพุตขนาดใหญ่ | เกิน 272K อินพุต: อัตราอินพุตและแคชเพิ่มเป็นสองเท่า เอาต์พุต 1.5 เท่า | ไม่มีระบุ |
| เอเจนต์เขียนโค้ดที่ใช้บ่อย | Codex | Claude Code |
แหล่งที่มา: หน้าโมเดล GPT-6.2 Astra ของ OpenAI, เอกสารราคาของ Anthropic และ ภาพรวมโมเดล
สองแถวที่สำคัญที่สุดสำหรับเอเจนต์ เอเจนต์เขียนโค้ดส่งบริบทซ้ำทุกเทิร์น ดังนั้นอัตรา cache hit จึงเป็นตัวกำหนดค่าใช้จ่ายส่วนใหญ่ และเอเจนต์ที่อ่านรีโปขนาดใหญ่อาจมีอินพุตเกิน 272K โทเค็น ซึ่งเป็นจุดที่อัตราของ Astra เปลี่ยนไป
สิ่งที่ benchmark ด้าน coding บอก และสิ่งที่ไม่บอก
ประกาศเปิดตัว Fable 5.2 ของ Anthropic รายงานคะแนน 69.9% บน FrontierSWE v2 และ 49.1% บน FrontierCode 2.0 ที่ระดับ effort Xhigh ในตารางเดียวกัน คอลัมน์เปรียบเทียบของ OpenAI ระบุว่าเป็น GPT-6 Astra ซึ่งเป็นรุ่นก่อนหน้า ที่ 65.5% และ 42.8%
ตารางนั้นไม่รวม GPT-6.2 Astra และหน้าโมเดลของ OpenAI ก็ไม่แสดงคะแนน coding แบบ SWE สำหรับโมเดลนี้เช่นกัน บทความเปิดตัวของ Simon Willison launch write-up ตั้งข้อสังเกตว่า "Astra 6.2 ทำคะแนนได้ไม่สูงเท่า Fable 5.2 บน benchmark ต่างๆ" และผู้ใช้บางคนรู้สึกว่าสไตล์การสื่อสารของโมเดล "อาจสับสนได้"
ดังนั้นการอ่านอย่างตรงไปตรงมาจึงมีสามส่วน:
- Fable 5.2 มีคะแนน agentic coding ที่เผยแพร่โดยผู้ให้บริการ ซึ่งนำหน้า Astra รุ่นก่อน
- ยังไม่มีผู้ให้บริการรายใดเผยแพร่การเปรียบเทียบ coding โดยตรงกับ GPT-6.2 Astra
- ตัวเลขทั้งหมดข้างต้นรันโดยผู้ให้บริการของโมเดลเอง บน harness ของตัวเอง ที่ระดับ effort ที่เลือกเอง
มอง benchmark เป็นตัวกรองขั้นต้น บทความนี้ไม่มีผลการทดสอบอิสระของโมเดลใดเลย
จุดที่ค่าใช้จ่ายแตกต่าง
ราคาต่อหน่วยเท่ากันไม่ได้หมายความว่าใบแจ้งหนี้จะเท่ากัน กลไกสามอย่างทำให้ต่างกัน
Cache hits
Fable 5.2 คิด $0.20 ต่อล้านโทเค็นเมื่อ cache hit ส่วน Astra คิด $0.40 สำหรับเอเจนต์ที่ส่ง prefix แคชขนาด 100,000 โทเค็นซ้ำ 50 ครั้งในหนึ่งเซสชัน prefix นั้นจะมีค่าใช้จ่าย $1.00 บน Fable และ $2.00 บน Astra ก่อนที่จะนับอินพุตใหม่และเอาต์พุต Simon Willison ยังคงเรียกอัตราแคชของ Astra ว่า "ข่าวดีสำหรับเซสชันเอเจนต์ที่รันยาวนาน" เพราะต่ำกว่าอัตรา $8 แบบไม่แคชมาก
บริบทขนาดใหญ่
อัตราของ Astra จะเพิ่มขึ้นเมื่อคำขอมีอินพุตเกิน 272K โทเค็น ส่วน Anthropic ระบุว่าบริบท 1M เต็มคิดในราคาปกติสำหรับ Fable หากเอเจนต์ของคุณอ่าน monorepo ครึ่งหนึ่งเป็นประจำ ควรคำนวณจุดเปลี่ยนนี้ก่อนตัดสินใจ
Effort และจำนวนโทเค็นต่องาน
ทั้งสองโมเดลมีระดับ effort และ effort ที่สูงขึ้นจะใช้โทเค็นมากขึ้น การทดสอบ SVG แบบไม่เป็นทางการของ Simon แสดงความแตกต่างในหนึ่ง prompt: GPT-6.2 Astra มีค่าใช้จ่าย 11.55 เซนต์ที่ High effort และ 88.71 เซนต์ที่ Max นั่นเป็นเพียง prompt ทดลอง ไม่ใช่ benchmark ด้าน coding แต่ช่องว่าง 7 เท่าแสดงให้เห็นว่าทำไมคุณควรกำหนดระดับ effort ให้คงที่ก่อนเปรียบเทียบค่าใช้จ่าย
บทวิเคราะห์ราคา Fable 5.2 ของเราอธิบายเรื่องการลองใหม่และเวลารีวิว ส่วนคู่มือ rate limit ของ GPT-6.2 ครอบคลุมเพดานโทเค็นต่อนาทีที่เอเจนต์ Astra จะชนก่อน
วิธีรันการทดสอบ GPT-6.2 Astra vs Fable 5.2 บนรีโปของคุณเอง
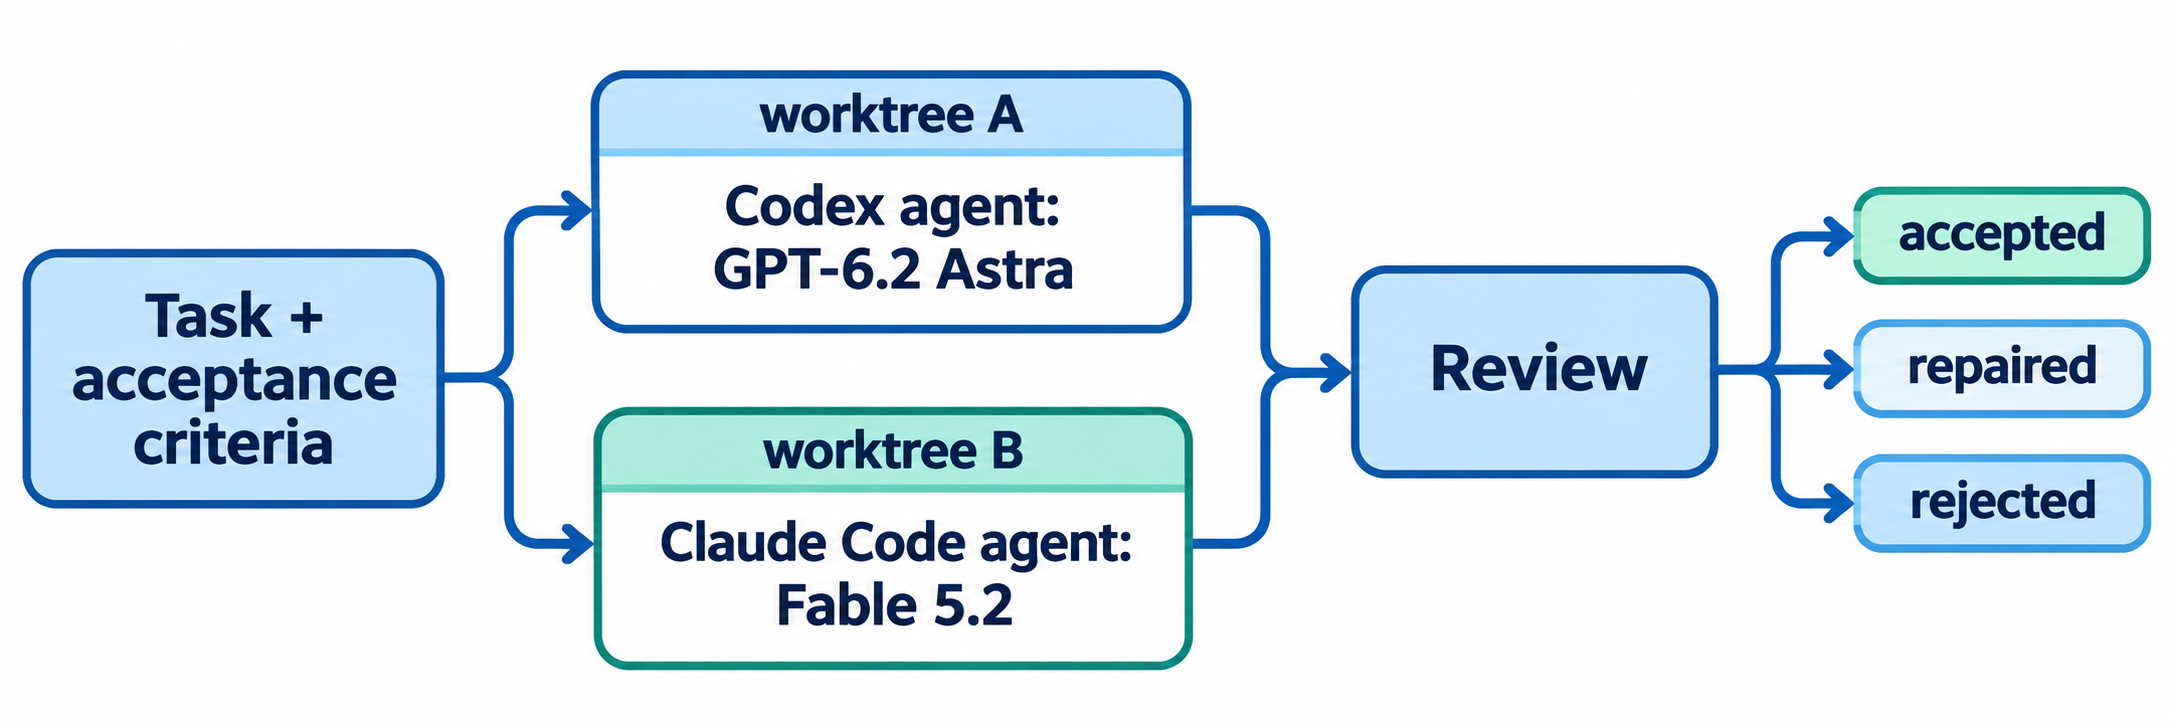
การทดสอบตัวต่อตัวบนโค้ดของคุณเองดีกว่าตารางที่เผยแพร่ใดๆ วิธีการด้านล่างอ้างอิงจากคู่มือการประเมิน Fable 5.2 บนโค้ดเบสของคุณฉบับเต็มของเรา โดยที่นี่รันเป็นการดวลสองโมเดล
- เลือกงาน 10 ถึง 12 งานล่าสุดจาก backlog ของคุณ: การแก้บั๊ก การเพิ่มฟีเจอร์เล็กๆ การ refactor และการตรวจสอบหนึ่งงาน
- เขียนเกณฑ์การยอมรับก่อนก่อนที่เอเจนต์ใดจะเริ่ม เพื่อให้ผลลัพธ์ไม่ส่งผลต่อมาตรฐานที่ตั้งไว้
- กำหนด harness ให้คงที่ Astra ทำงานได้ดีที่สุดใน Codex และ Fable ใน Claude Code ดังนั้นคุณกำลังเปรียบเทียบ workflow ทั้งหมดสองชุด ระบุเรื่องนี้ในบันทึกของคุณ
- กำหนดระดับ effort ให้คงที่ เลือก High ทั้งคู่ หรือระบุการตั้งค่าที่ใช้จริง
- แยกทุกความพยายามใน git worktree ใหม่ เพื่อไม่ให้เอเจนต์ตัวใดสืบทอดการแก้ไขของอีกตัว
- รันแต่ละงานบนทั้งสองโมเดล สลับลำดับว่าตัวไหนเริ่มก่อน
- รีวิวแบบไม่ระบุตัวตนเมื่อทำได้ และให้คะแนนแต่ละผลลัพธ์เป็น ยอมรับ, ยอมรับหลังแก้ไข หรือปฏิเสธ
- หารค่าใช้จ่ายรวมด้วยจำนวนการเปลี่ยนแปลงที่ยอมรับ รวมถึงความพยายามที่ล้มเหลวด้วย
ค่าใช้จ่ายต่อการเปลี่ยนแปลงที่ยอมรับคือตัวเลขที่ใช้ตัดสิน โมเดลที่ถูกกว่า 20% ต่อโทเค็นแต่ต้องแก้ไขเพิ่มอีกรอบต่อหนึ่งงาน คือโมเดลที่แพงกว่าสำหรับทีมคุณ
รันทั้งสองโมเดลเป็น Agents ใน Sharkly
Sharkly รันเอเจนต์เขียนโค้ดที่คุณใช้อยู่แล้ว ไม่ได้มาแทนที่ Agent ใน Sharkly คือเพื่อนร่วมทีม AI ที่กำหนดค่าไว้ ซึ่งรัน Tasks ผ่าน Runtime เช่น Codex หรือ Claude Code บน Computer ที่คุณเชื่อมต่อ
ตั้งค่าการดวลด้วย Agents สองตัว:
- Astra Agent: Codex Runtime ที่กำหนดค่าสำหรับ
gpt-6.2-astra - Fable Agent: Claude Code Runtime ที่กำหนดค่าสำหรับ
claude-fable-5-2
แต่ละ Agent มีโมเดลเริ่มต้น เลือกได้ภายใต้ Computer, Runtime และ Working directory จากโมเดลที่ Runtime รายงาน ตรวจสอบศูนย์ช่วยเหลือ Sharkly สำหรับการตั้งค่า Agent ล่าสุด
กำหนดขีดจำกัดการรันแบบเดียวกันทั้งสอง Agent เพื่อไม่ให้ตัวใดได้รับการรันแบบขนานมากกว่าหรือมีเวลามากกว่าอีกตัว

ใช้โหมด Temporary working-directory เพื่อให้แต่ละ Task ได้ไดเรกทอรีแยก และการรันที่อิงกับรีโปสามารถเตรียม worktree ใหม่ได้ ใส่เกณฑ์การยอมรับในคำอธิบาย Task แต่ละ Agent จะรายงาน patch และการตรวจสอบกลับไปยัง Task ของตัวเอง ซึ่งเก็บทุกความพยายามไว้ข้างคำตัดสินของรีวิวเวอร์
การใช้โมเดลยังคงอยู่บน subscription และ API key ของคุณเอง Sharkly ไม่ได้ขายโทเค็น และโควต้าโมเดลขึ้นอยู่กับเครื่องมือ แพลน และบัญชี API ที่ทีมคุณเชื่อมต่อ
ทางเลือกแทนการเลือก Astra vs Fable แบบตรงตัว
คุณไม่จำเป็นต้องเลือกโมเดลเดียว
- แบ่งตามประเภทงาน ใช้ Fable 5.2 ในหมวดที่ชนะการทดสอบของคุณ ใช้ Astra ในส่วนที่เหลือ
- นำด้วยตัวหนึ่ง เสริมด้วยอีกตัว โมเดล frontier วางแผนและรีวิว ส่วนโมเดลที่ถูกกว่าทำงานประจำ รูปแบบเดียวกับGPT-6 Astra ในฐานะ Crew leader
- ลดระดับลงหนึ่งขั้น GPT-6.2 Sol ตั้งราคาที่ $2 อินพุต และ $10 เอาต์พุตต่อล้านโทเค็น สำหรับงานบำรุงรักษาประจำวันอาจผ่านเกณฑ์ของคุณในราคาเพียงหนึ่งในสี่
- เปิดใช้งานทั้งคู่ ความเป็นกลางของผู้ให้บริการคือประเด็นสำคัญ เพราะไม่มีโมเดลใดจะดีที่สุดได้ตลอดไป ตามที่Argon, Astra และ Opusได้โต้แย้งไว้
กรณีการใช้งานจริง
- การย้ายระบบขนาดใหญ่ Anthropic รายงานว่าทีมเอเจนต์ Fable 5.2 ย้ายบริการ production จาก Python ไป Rust ได้ ทดสอบงานประเภทนั้นกับส่วนเสี้ยวของคุณเองก่อนจะไว้วางใจโมเดลใด
- การตรวจสอบรีโปขนาดใหญ่ เมื่ออินพุตเกิน 272K โทเค็น ราคา Astra จะเปลี่ยนไป ลองคำนวณต้นทุนด้วยขนาดบริบทจริงของคุณ
- คิวบั๊กแบบขนาน การแก้เล็กๆ สิบงานที่แบ่งให้ทั้งสอง Agent จะให้อัตราการยอมรับต่อโมเดลภายในหนึ่งสัปดาห์
สรุป
GPT-6.2 Astra และ Fable 5.2 มีราคาต่อโทเค็นเท่ากันบนกระดาษ Fable มีคะแนน coding ที่เผยแพร่สูงกว่าและ cache hit ที่ถูกกว่า Astra มี context window ใหญ่กว่าเล็กน้อยแต่อัตราสูงชันกว่าเมื่ออินพุตเกิน 272K ไม่มีข้อเท็จจริงใดบอกคุณได้ว่าโมเดลไหนจะส่งโค้ดที่ยอมรับได้มากกว่าในรีโปของคุณ
ลองดวลดู เชื่อมต่อ Computer หนึ่งเครื่องกับ Sharkly สร้าง Codex Agent บน GPT-6.2 Astra และ Claude Code Agent บน Fable 5.2 แล้วมอบหมายงานห้างานเดียวกันให้ทั้งสองภายในสัปดาห์นี้ เก็บโมเดลที่ชนะด้านค่าใช้จ่ายต่อการเปลี่ยนแปลงที่ยอมรับไว้
คำถามที่พบบ่อย
GPT-6.2 Astra ถูกกว่า Claude Fable 5.2 หรือไม่?
ไม่ ทั้งคู่ตั้งราคาที่ $8 ต่อล้านโทเค็นอินพุต และ $40 ต่อล้านโทเค็นเอาต์พุต cache hit ของ Fable ถูกกว่า ($0.20 vs $0.40) และอัตราของ Astra จะเพิ่มขึ้นเมื่ออินพุตเกิน 272K โทเค็น
ตัวไหนดีกว่าสำหรับการเขียนโค้ด GPT-6.2 Astra หรือ Fable 5.2?
Anthropic รายงานคะแนน agentic coding ที่สูงกว่าสำหรับ Fable 5.2 เมื่อเทียบกับ GPT-6 Astra รุ่นก่อน ไม่มี benchmark ที่เผยแพร่เปรียบเทียบ Fable 5.2 กับ GPT-6.2 Astra โดยตรง ดังนั้นควรทดสอบทั้งคู่บนงานของคุณเอง
Context window ของ GPT-6.2 Astra และ Fable 5.2 คือเท่าไร?
GPT-6.2 Astra ระบุ 1,050,000 โทเค็น โดยมีเพดานอินพุต 922,000 โทเค็น Fable 5.2 มีบริบท 1M โทเค็นในราคาปกติ ทั้งคู่จำกัดเอาต์พุตที่ 128,000 โทเค็น
ใช้ GPT-6.2 Astra ใน Claude Code หรือ Fable 5.2 ใน Codex ได้หรือไม่?
โดยปกติแต่ละโมเดลจะรันในเอเจนต์เขียนโค้ดของผู้ให้บริการตัวเอง: Astra ใน Codex, Fable ใน Claude Code การเปรียบเทียบมักหมายถึงการเปรียบเทียบ workflow ทั้งหมดสองชุด คือโมเดลบวก harness
จะเปรียบเทียบโมเดลเขียนโค้ดสองตัวอย่างยุติธรรมได้อย่างไร?
ใช้งานเดียวกัน เกณฑ์การยอมรับที่เขียนไว้ ระดับ effort ที่คงที่ และ worktree ที่แยกจากกัน ให้คะแนนผลลัพธ์เป็นยอมรับ แก้ไขแล้ว หรือปฏิเสธ และหารค่าใช้จ่ายรวมด้วยจำนวนการเปลี่ยนแปลงที่ยอมรับ
Sharkly เลือกโมเดลให้ Agent ของฉันหรือไม่?
ไม่ คุณเลือกโมเดลเริ่มต้นของแต่ละ Agent จากโมเดลที่ Runtime รายงาน Sharkly ไม่ได้กำหนดเส้นทางงานระหว่างโมเดลโดยอัตโนมัติ