
TL;DR: หากต้องการให้ AI agent ของคุณมีเสียงพูด ให้วาง GPT-Live-1.1 ของ OpenAI ไว้ข้างหน้าเป็น front end สำหรับเสียง แล้วปล่อยให้งานจริงยังคงอยู่กับ agent ที่คุณใช้งานอยู่แล้ว GPT-Live ฟังไปพร้อมกับพูดไป และส่งงานวิเคราะห์และการเรียกใช้เครื่องมือ (tool calls) ไปยัง backend ผ่านกลไก delegation ในโหมด client delegation แอปของคุณจะดักจับการส่งงานแต่ละครั้ง เริ่ม Sharkly Automation ผ่าน webhook ของมัน แล้วนำผลลัพธ์กลับมาพูดให้ฟัง
GPT-Live-1.1 คืออะไร?
GPT-Live-1.1 คือโมเดลเสียงแบบ full-duplex ของ OpenAI สำหรับบทสนทนาหลายภาษา ซึ่งสามารถฟังไปพร้อมกับพูดไป ทำให้ผู้ใช้ขัดจังหวะได้เหมือนขัดจังหวะเพื่อนร่วมงาน โมเดลนี้ทำงานบน endpoint v1/live/sessions รองรับ function calling และ streaming และสามารถส่งงานวิเคราะห์และการใช้เครื่องมือไปยัง backend agent แทนที่จะทำเอง
หน้า GPT-Live-1.1 model page ของ OpenAI ระบุว่าโมเดลนี้ถอดเสียงพูดได้แม่นยำกว่า GPT-Live-1 และรักษาสำเนียงกับน้ำเสียงให้สม่ำเสมอกันข้ามภาษาได้ดีกว่า รับและส่งข้อมูลได้ทั้งแบบเสียงและข้อความ แต่ไม่รองรับรูปภาพโดยตรง
สิ่งที่สำคัญสำหรับทีม agent คือการ delegation โมเดลเสียงถูกออกแบบมาเพื่อพูดคุย ไม่ใช่เพื่อรันการ refactor นาน 20 นาที มันจะส่งงานนั้นไปให้อย่างอื่นทำ และคุยกับผู้ใช้ต่อไประหว่างรอ
ถ้าทีมของคุณมอบหมายงานให้ coding agent บน board ร่วมอยู่แล้ว Sharkly สามารถเป็น "อย่างอื่น" นั้นได้ ส่วนที่เหลือของคู่มือนี้จะแสดงวิธีเชื่อมต่อ
ทำไม voice agent จึงต้องมีทีม backend
อินเทอร์เฟซแบบเสียงมีงบเวลา (latency budget) ที่จำกัดมาก คนทั่วไปคาดหวังคำตอบภายในประมาณหนึ่งวินาที ถ้าเงียบนานกว่านั้นจะรู้สึกเหมือนระบบพัง แต่งาน agent จริงไม่สามารถจบในกรอบเวลานั้นได้: การอ่าน repository, รันเทสต์ หรือ triage งานในคิว ใช้เวลาเป็นนาที
ดังนั้น voice agent ที่พยายามทำทุกอย่างเองจะล้มเหลวในสองลักษณะ คือตอบเร็วแต่ตื้นเขิน หรือเงียบไปเพราะกำลังคิด ซึ่งไม่มีแบบไหนมีประโยชน์เมื่อคุณกำลังเดินไปประชุมและอยากรู้ว่า agent runs ของคืนวันก่อนผ่านหมดหรือเปล่า
ทางแก้คือการแยกส่วนที่คุณอาจใช้อยู่แล้วกับข้อความ: front end ที่รวดเร็วดูแลบทสนทนา และ backend ที่ช้ากว่าทำงานจริง GPT-Live สร้างการแยกนี้ไว้ใน API เลย ถ้าคุณอ่านบทความของเราเรื่อง การส่งงานระหว่าง agent กับ agent และระหว่าง agent กับมนุษย์ มาแล้ว นี่คือ pattern เดียวกันแค่เพิ่มไมโครโฟนเข้าไป
การ delegation ของ GPT-Live ทำงานอย่างไร
GPT-Live มีโหมด delegation สองแบบ ซึ่งเลือกตอนสร้าง session ถ้าต้องการเปลี่ยนโหมด ต้องเริ่ม session ใหม่
| Responses delegation | Client delegation | |
|---|---|---|
| ใครรัน backend | OpenAI ผ่าน Responses API | แอปพลิเคชันของคุณ |
| Config | delegation.type: "responses" พร้อม model, instructions, tools |
delegation.type: "client" |
| โมเดล backend | โมเดลที่คุณกำหนด เช่น gpt-6-luna |
อะไรก็ได้ที่คุณเรียกใช้ได้ |
| วิธีส่งผลลัพธ์กลับ | OpenAI จัดการให้ | session.commentary.append หรือ session.thinking.append |
| เหมาะกับ | การค้นหาและ tool calls ที่ OpenAI รันได้ | งานที่อยู่ในระบบของคุณเอง |
Responses delegation เป็นทางสั้น คุณระบุโมเดล backend แล้ว OpenAI จะรันให้พร้อมเครื่องมือที่คุณระบุ delegation guide แนะนำให้เริ่มด้วย gpt-6-luna และลอง gpt-6-sol สำหรับงาน backend ที่ซับซ้อนกว่า
Client delegation เป็นทางสำหรับ agent ที่คุณใช้งานอยู่แล้ว เมื่อโมเดลเสียงตัดสินใจว่าต้องการความช่วยเหลือ แอปของคุณจะได้รับ event session.delegation.created พร้อม delegation ID ซึ่ง event นี้ไม่ได้แนบคำพูดของผู้ใช้มาด้วย ดังนั้นแอปต้องสร้าง request ขึ้นใหม่จาก transcript events และ state ของตัวเอง เมื่องานเสร็จ คุณส่งผลลัพธ์กลับด้วย delegation ID เดิม และ GPT-Live จะเรียบเรียงให้พูดออกมา
Pattern นี้คือ: GPT-Live พูด ทีม agent ของคุณทำงาน
นี่คือโครงสร้างของ voice front end ที่วางอยู่บน Sharkly Sharkly ทำหน้าที่อยู่เหนือ coding agent ของคุณ (Claude Code, Codex, Gemini CLI และอื่น ๆ) เป็นชั้นที่มอบหมายงาน รันบน Computers ที่เชื่อมต่อไว้ และรับการตรวจสอบ โมเดลเสียงไม่ได้แตะ repository โดยตรง มันแค่ขอให้ทำงาน แล้ว board จะบันทึกงานนั้นไว้
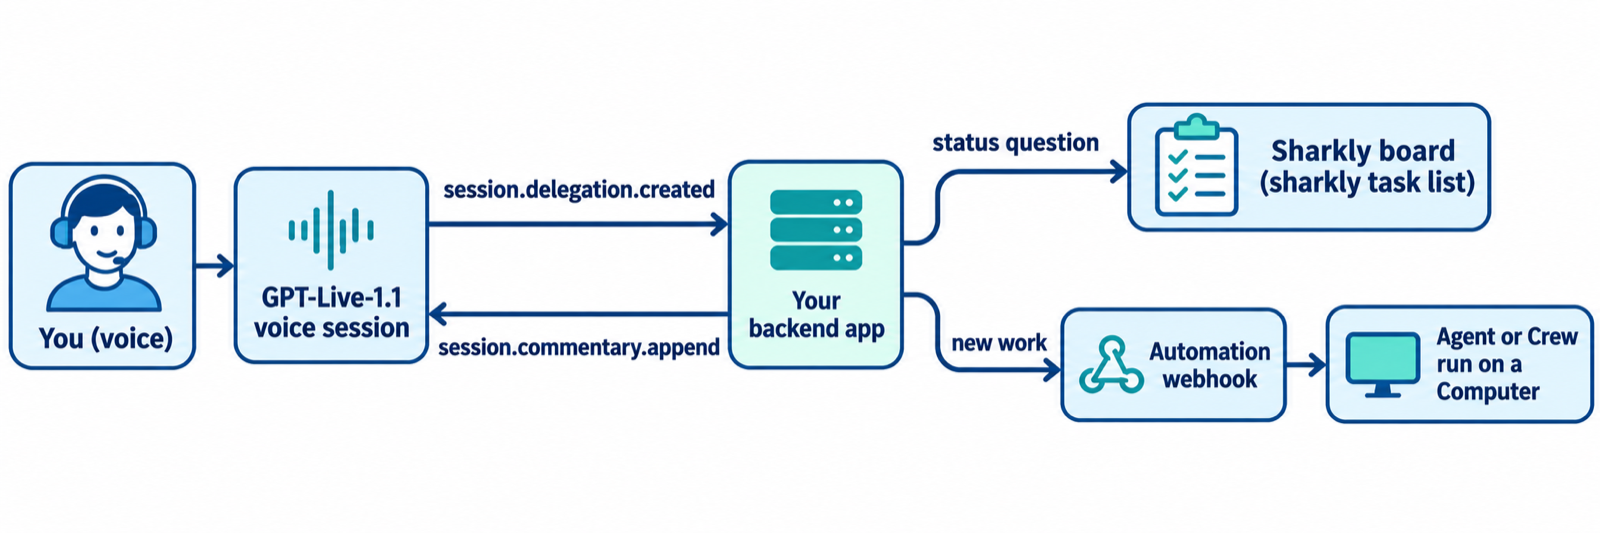
คำขอสามประเภทนี้ครอบคลุมสิ่งที่คนส่วนใหญ่ถาม voice agent เกี่ยวกับทีม agent ของตน:
- คำถามสถานะ ("รันเทสต์คืนนี้ผ่านไหม?") backend ของคุณอ่านคำตอบจาก board ด้วย CLI
sharklyและตอบได้ภายในไม่กี่วินาที - งานใหม่ ("ให้ agent ไปดูเทสต์ login ที่ flaky หน่อย") backend ของคุณเรียก Sharkly Automation webhook แล้ว Agent หรือ Crew จะเริ่มรัน
- การตัดสินใจ ("Merge เลย") backend ของคุณปฏิเสธ และบอกผู้ใช้ว่าต้องไปตรวจสอบที่ไหน เสียงพูดไม่ใช่สถานที่ที่เหมาะกับการอนุมัติการเปลี่ยนแปลง
กฎข้อที่สามเป็นการตัดสินใจด้านดีไซน์ ไม่ใช่ข้อจำกัดของผลิตภัณฑ์ใด "yes" ที่พูดออกมาฟังผิดง่ายและตรวจสอบย้อนหลังยาก ให้เก็บการอนุมัติไว้ที่ที่หลักฐานอยู่ ซึ่งคู่มือ human-in-the-loop coding agents ของเราอธิบายไว้อย่างละเอียด
ให้ AI agent ของคุณมีเสียง: การตั้งค่าทีละขั้นตอน
ขั้นตอนที่ 1: สร้าง Automation และ webhook trigger
ใน Sharkly Automation คือนิยามที่เป็นของ Space สำหรับงาน Agent หรือ Crew ที่ทำซ้ำได้: ประกอบด้วยคำสั่ง ผู้รับผิดชอบ trigger และประวัติการรัน webhook trigger จะสร้าง URL ลับที่รับ POST request จากบริการภายนอก Automations docs ระบุว่า URL เต็มจะแสดงเพียงครั้งเดียว ตอนสร้างหรือสร้างใหม่ ดังนั้นให้เก็บไว้เป็น secret ทันที
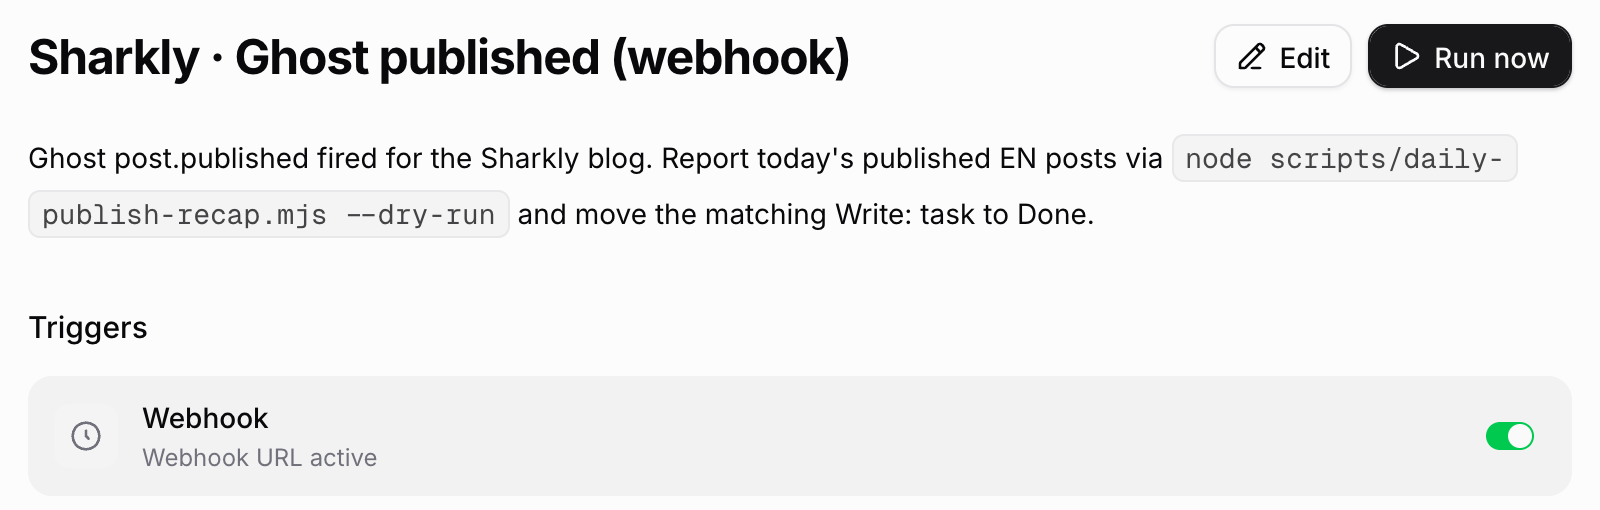
เขียนคำสั่งให้ Agent อ่านคำขอจาก trigger payload และบันทึกผลลัพธ์เป็น task comment ระบุให้ชัดว่ามันเปลี่ยนอะไรได้ และกรณีไหนมนุษย์ต้องตัดสินใจ จากนั้นใช้ Run now เพื่อทดสอบ Agent และ Computer ของมันก่อนเชื่อมต่อ traffic แบบเสียง บทความ Automations ใน Sharkly ของเราแสดง trigger ประเภทอื่นเพิ่มเติม
ขั้นตอนที่ 2: สร้าง GPT-Live session ในโหมด client
ใน session config ของคุณ ระบุโมเดลเสียงและเปิด client delegation การตั้งค่า acknowledgement_delay_ms ให้เวลาแอปของคุณส่งอัปเดตของตัวเองก่อนที่ GPT-Live จะพูดคำตอบรับทั่วไปออกมา
export const session = {
  model: "gpt-live-1.1",
  instructions:
    "You are the voice front end for an engineering team's agent board. " +
    "Delegate status questions and new work requests. Never approve, merge, or deploy.",
  delegation: {
    type: "client",
    acknowledgement_delay_ms: 800,
  },
};
OpenAI แนะนำ WebRTC สำหรับเสียงในเบราว์เซอร์ มือถือ และแอปฝั่ง server โดยมี WebSockets เป็นทางเลือกที่รองรับ GPT-Live getting started guide อธิบายการตั้งค่าการเชื่อมต่อไว้แล้ว
ขั้นตอนที่ 3: ส่งต่อการ delegation แต่ละครั้งไปยัง Sharkly
เมื่อ session.delegation.created มาถึง ให้บันทึก delegation ID สร้าง request ขึ้นใหม่จาก transcript แล้วตัดสินใจว่าคำขอนั้นจะไปทางไหน โค้ด Node ด้านล่างส่งงานใหม่ไปยัง Automation webhook และตอบคำถามสถานะจาก board
import { execFile } from "node:child_process";
import { promisify } from "node:util";
const run = promisify(execFile);

const WEBHOOK_URL = process.env.SHARKLY_AUTOMATION_WEBHOOK_URL!; // stored secret

async function handleDelegation(connection, delegationId: string, request: string) {
  // Quiet note so the voice model knows work started; not spoken on append.
  connection.send({
    type: "session.thinking.append",
    event_id: `start_${delegationId}`,
    delegation_id: delegationId,
    content: "Request received. Checking the agent board.",
  });

  if (isStatusQuestion(request)) {
    const { stdout } = await run("sharkly", ["task", "list", "--status", "In Progress", "--output", "json"]);
    const tasks = JSON.parse(stdout);
    return speak(connection, delegationId, `${tasks.length} tasks are in progress right now.`);
  }

  const res = await fetch(WEBHOOK_URL, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({ source: "voice", request }),
  });
  if (!res.ok) {
    return speak(connection, delegationId, "I couldn't start that run. Nothing was assigned.");
  }
  return speak(connection, delegationId, "An agent run has started. The result will land on the board.");
}

function speak(connection, delegationId: string, content: string) {
  connection.send({
    type: "session.commentary.append",
    event_id: `result_${delegationId}`,
    delegation_id: delegationId,
    content, // 500-token limit per append
  });
}
สังเกตว่าคำตอบเสียงสัญญาอะไร มันบอกว่ารันเริ่มขึ้นแล้ว ไม่ใช่ว่างานเสร็จแล้ว คู่มือของ OpenAI ก็ชี้ประเด็นเดียวกันกับการจอง: ส่งผลลัพธ์เฉพาะหลังจาก action สำเร็จแล้วเท่านั้น
ขั้นตอนที่ 4: อ่านผลลัพธ์จาก board ไม่ใช่ด้วยหู
Agent runs ใช้เวลาเป็นนาที และ session เสียงอาจจบก่อนงานเสร็จ ดังนั้น board คือบันทึกที่แท้จริง Agent โพสต์ผลลัพธ์ลงบน task ประวัติการรันแสดง trigger payload และ output และมนุษย์ตรวจสอบที่นั่น ครั้งหน้าเมื่อคุณถาม "เทสต์ flaky นั้นเป็นยังไงบ้าง?" เส้นทางคำถามสถานะจะอ่านผลลัพธ์นั้นกลับมาให้คุณฟัง
ค่าใช้จ่ายและข้อจำกัดที่ต้องวางแผน
| รายการ | GPT-Live-1.1 (เอกสาร OpenAI, 2026-11-20) |
|---|---|
| Endpoint | v1/live/sessions |
| Session ที่กำลังใช้งาน | $0.05 ต่อนาที |
| Standby | $0.02 ต่อนาที (WebRTC sessions ระหว่างที่ inference หยุดชั่วคราว) |
| การเรียกเก็บเงิน | ตามระยะเวลา หน้าราคาของ OpenAI ระบุว่า GPT-Live คิดเงินเป็นวินาที |
| Session พร้อมกัน | แยกจากขีดจำกัดของ GPT-Live-1 ดูที่หน้า limits ขององค์กรคุณ |
| การเรียก backend | คิดค่าใช้จ่ายตามอัตราปกติของโมเดลที่ตั้งค่าไว้ |
การ check-in standup 10 นาทีมีค่าใช้จ่ายเสียง $0.50 ที่อัตรา active ก่อนหักค่าเรียก backend ใด ๆ เพื่อเปรียบเทียบ GPT-Live-1 model page ระบุ session พร้อมกันที่ 50, 300 และ 500 บน tier Build, Launch และ Grow และไม่เปิดให้ใช้บน tier Free GPT-Live-1.1 มีขีดจำกัดของตัวเอง
Agent runs ฝั่ง Sharkly คิดค่าใช้จ่ายกับแผน Claude Code, Codex หรือ API ที่ผูกไว้กับ Runtime แต่ละตัวอยู่แล้ว Sharkly ไม่ขาย token ถ้าคุณส่งคำถามสถานะไปยังโมเดล backend ราคาถูก บันทึกของเราเรื่อง การรัน GPT-6 Luna agents ใน Sharkly ใช้ได้ตรงเลย
Guardrails ที่ควรใส่ตั้งแต่วันแรก
- การขัดจังหวะไม่ได้ยกเลิกงาน คู่มือของ OpenAI ระบุว่าการขัดจังหวะบทสนทนาที่พูดอยู่ไม่ได้หยุดงาน backend ถ้ามีคนพูดว่า "เอาไม่ต้องแล้ว" backend ของคุณต้องจัดการเรื่องนี้เอง ไม่งั้นรันจะดำเนินต่อไป
- ถือว่า webhook URL เป็นรหัสผ่าน เอกสารของ Sharkly อธิบายว่าโดยค่าเริ่มต้นมันคือ bearer secret เพิ่ม signing secret และ regenerate URL ใหม่ถ้ามันรั่วไหล
- จำกัดขอบเขตของ Automation เริ่มจากงานที่สังเกตผลได้และย้อนกลับได้ ตามที่เอกสาร Sharkly แนะนำ และตรวจสอบหลายรันก่อนขยายขอบเขต
- ให้การ delegation ของ Crew อยู่ภายใน Sharkly ถ้าคำขอหนึ่งต้องใช้หลาย agent ให้ชี้ webhook ไปที่ Sharkly Crew แล้วให้ leader ของ Crew แบ่งงานเอง
เมื่อไหร่ที่ voice front end ไม่ใช่เครื่องมือที่เหมาะสม
ข้ามมันไปเมื่อคำขอต้องใช้ diff, log หรือ screenshot จึงจะเข้าใจได้ เสียงพูดแสดงเทสต์ที่ล้มเหลวให้ดูไม่ได้ นอกจากนี้ยังไม่ใช่ช่องทางที่เหมาะกับสิ่งที่ต้องมีลายเซ็น: การอนุมัติ การ deploy และการเปลี่ยนสิทธิ์การเข้าถึง ควรอยู่บน task ที่หลักฐานอยู่
เสียงพูดคุ้มค่าในกรณีเช็กสถานะรวดเร็ว เริ่มรันที่นิยามชัดเจน และช่วงเวลาที่มือไม่ว่าง ให้มองมันเป็นรีโมตควบคุม agent board ของคุณ ไม่ใช่สิ่งที่มาแทนที่ board
สรุป
GPT-Live-1.1 ดูแลส่วนของ voice agent ที่ยากต่อการสร้างเอง: บทสนทนาแบบ full-duplex ที่ขัดจังหวะได้ การ delegation ส่งทุกอย่างที่เหลือไปยัง backend วางทีม agent ที่คุณมีอยู่แล้วไว้หลัง backend นั้น แล้วคุณจะถามเรื่องการรันและเริ่มรันใหม่ด้วยเสียงได้ ในขณะที่ผลลัพธ์ทุกชิ้นยังคงตกลงบน board ที่มนุษย์ตรวจสอบ
ก้าวถัดไปของคุณ: สร้าง Automation หนึ่งตัวพร้อม webhook trigger ใน Sharkly ทดสอบด้วย Run now แล้วชี้ GPT-Live session โหมด client ไปที่มัน เอกสาร Sharkly อธิบาย Agents, Computers และ Automations อย่างละเอียด
FAQ
ฉันจะให้ AI agent ของฉันมีเสียงได้อย่างไร?
วางโมเดลเสียงอย่าง GPT-Live-1.1 ไว้ข้างหน้า agent แล้วให้มัน delegate โมเดลเสียงดูแลการฟังและพูด ส่วน backend ของคุณรัน agent และส่งผลลัพธ์สั้น ๆ กลับมาให้โมเดลเสียงพูด
GPT-Live-1.1 ใช้ได้ใน API หรือไม่?
ใช้ได้ OpenAI ระบุ gpt-live-1.1 พร้อม endpoint v1/live/sessions, function calling และ streaming ไม่รองรับ v1/realtime หรือ v1/responses โดยตรง
GPT-Live-1.1 ราคาเท่าไหร่?
OpenAI ระบุ $0.05 ต่อนาทีสำหรับ session ที่ใช้งาน และ $0.02 ต่อนาทีในโหมด standby การเรียกโมเดล backend ผ่าน delegation คิดค่าใช้จ่ายแยกตามอัตราปกติของแต่ละโมเดล
Responses delegation กับ client delegation ต่างกันอย่างไร?
ใน Responses delegation OpenAI เป็นผู้รันโมเดล backend ที่คุณตั้งค่าไว้ ส่วนใน client delegation แอปของคุณรับคำขอแต่ละรายการและส่งผลลัพธ์กลับด้วย session.commentary.append หรือ session.thinking.append
GPT-Live-1.1 รัน coding agent ได้โดยตรงไหม?
ไม่ได้ มัน delegate เท่านั้น backend ของคุณเป็นผู้ตัดสินใจว่าอะไรจะรัน เช่น โดยเรียก Sharkly Automation webhook ที่เริ่มการรัน Agent หรือ Crew บน Computer ที่เชื่อมต่อไว้
จะเกิดอะไรขึ้นถ้าฉันขัดจังหวะ voice agent กลางงาน?
บทสนทนาหยุด แต่งาน backend ไม่หยุด ให้จัดการการยกเลิกใน backend ของคุณ เช่น หยุดการรันชั่วคราวหรือคอมเมนต์ลงบน task


