

TL;DR: ราคา GPT-6.2 สำหรับ Astra อยู่ที่ $8 ต่อ input tokens ล้านตัว และ $40 ต่อ output tokens ล้านตัว ส่วน Sol อยู่ที่ $2 และ $10 ตามลำดับ การอ่าน cached input มีราคา $0.40 และ $0.10 ตัวอย่างงาน agent แบบ 20 เทิร์นหนึ่งงาน มีค่าใช้จ่ายประมาณ $3.23 บน Astra และ $0.81 บน Sol เมื่อ prompt caching ทำงานปกติ และสี่เท่าของจำนวนนั้นหากไม่มี caching
OpenAI เปิดตัว GPT-6.2 Astra และ GPT-6.2 Sol เมื่อวันที่ 17 พฤศจิกายน 2026 Astra คือโมเดลระดับ frontier สำหรับงานที่ยากที่สุด ส่วน Sol คือโมเดลสำหรับใช้งานประจำวัน โดยหน้าของโมเดลระบุว่าออกแบบมาเพื่อ "powering agents at scale" หรือการรัน agents จำนวนมาก
ราคาต่อโทเคนล้านตัวบอกอะไรเกี่ยวกับค่าใช้จ่ายของทีม agent ได้น้อยมาก เพราะ agents ต้องส่ง context ซ้ำทุกเทิร์น ทำให้บิลขึ้นอยู่กับ caching, ความยาวของ context และจำนวน agents ที่รันพร้อมกัน คู่มือนี้แปลงราคาของ GPT-6.2 เป็นตัวเลขต่องานและต่อเดือน จากนั้นจะแสดงเพดานต่าง ๆ ที่ช่วยให้ค่าใช้จ่ายคาดการณ์ได้ หากคุณรัน coding agents หลายตัวควบคู่กันอยู่แล้ว Sharkly คือที่ที่คุณกำหนดเพดานเหล่านี้ต่อ Agent ได้
ราคา GPT-6.2 สำหรับ Astra และ Sol
นี่คือตารางราคา API มาตรฐานจาก หน้าของโมเดล Astra และ หน้าของโมเดล Sol ตรวจสอบเมื่อวันที่ 20 พฤศจิกายน 2026 ราคาทั้งหมดอยู่ที่ต่อโทเคนล้านตัว
| ราคาต่อโทเคน 1 ล้านตัว | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Input | $8.00 | $2.00 |
| Cached input (การอ่าน) | $0.40 | $0.10 |
| Cache writes (เก็บไว้ 30 นาที) | $10.00 | $2.50 |
| Cache writes (เก็บไว้ 12 ชั่วโมง) | $20.00 | $5.00 |
| Output | $40.00 | $10.00 |
| Context window | 1,050,000 | 1,050,000 |
ราคาของ Sol เท่ากับหนึ่งในสี่ของ Astra ในทุกบรรทัด ทั้งสองโมเดลมี context window และ rate limits เหมือนกัน ดังนั้นราคาคือสิ่งเดียวที่แยกพวกมันออกจากกันในใบเสร็จ
กฎการตั้งราคาที่เปลี่ยนยอดรวม
ห้ากฎในหน้าโมเดลที่กระทบบิลของ agent มากกว่าราคาที่ประกาศ:
- ค่าธรรมเนียม long context. คำขอที่มี input tokens เกิน 272K จะถูกคิดค่า input และ cache เป็นสองเท่า และค่า output เป็น 1.5 เท่า กับทั้งคำขอ
- การเขียน cache มีค่าใช้จ่ายเพิ่ม. การเขียน prefix ลง cache มีค่าใช้จ่าย 1.25 เท่าของ input ปกติสำหรับ 30 นาที หรือ 2.5 เท่าสำหรับ 12 ชั่วโมง
- การอ่าน cache ถูกมาก. บน GPT-6.2 การอ่านจาก cache มีค่าใช้จ่าย 0.05 เท่าของ input ปกติ ตามคู่มือ prompt caching ของ OpenAI
- Batch มีราคา 50 เปอร์เซ็นต์ ของราคามาตรฐาน
- ความเร็วมีราคาแพงกว่า. โหมด Fast มีราคา 2 เท่าของราคามาตรฐาน Ultrafast มีราคา 3 เท่าจนถึงวันที่ 28 กุมภาพันธ์ 2027 และ 6 เท่าตั้งแต่วันที่ 1 มีนาคม 2027
GPT-6.2 ไม่รองรับ Flex processing โดยมีรูปแบบทดแทนคือช่วงเวลา background completion ที่ลดราคา ซึ่งจะกล่าวถึงด้านล่าง
งาน agent หนึ่งงานบน GPT-6.2 มีค่าใช้จ่ายเท่าไร
ลองยกตัวอย่างงาน coding หนึ่งงาน: 20 เทิร์น, 60,000 input tokens ต่อเทิร์น และ 2,000 output tokens ต่อเทิร์น รวมทั้งงานคือ 1.2 ล้าน input tokens และ 40,000 output tokens ตัวเลขของคุณจะไม่เหมือนกัน จึงสามารถนำตัวเลขของคุณมาแทนได้
| สถานการณ์ | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| ไม่มี cache hits | $11.20 | $2.80 |
| cache hits 90 เปอร์เซ็นต์ | $3.23 | $0.81 |
| cache hits 90 เปอร์เซ็นต์, ช่วง background 8 ชั่วโมง | $1.94 | $0.49 |
แถวที่มี cache สมมติว่า input ร้อยละ 90 อ่านจาก cache และอีกร้อยละ 10 ถูกคิดค่าเป็น cache write แบบ 30 นาที ซึ่งเป็นกรณีที่เลวร้ายที่สุด การรันที่มี caching จริงจึงควรมีค่าใช้จ่ายเท่ากับหรือต่ำกว่าตัวเลขเหล่านี้
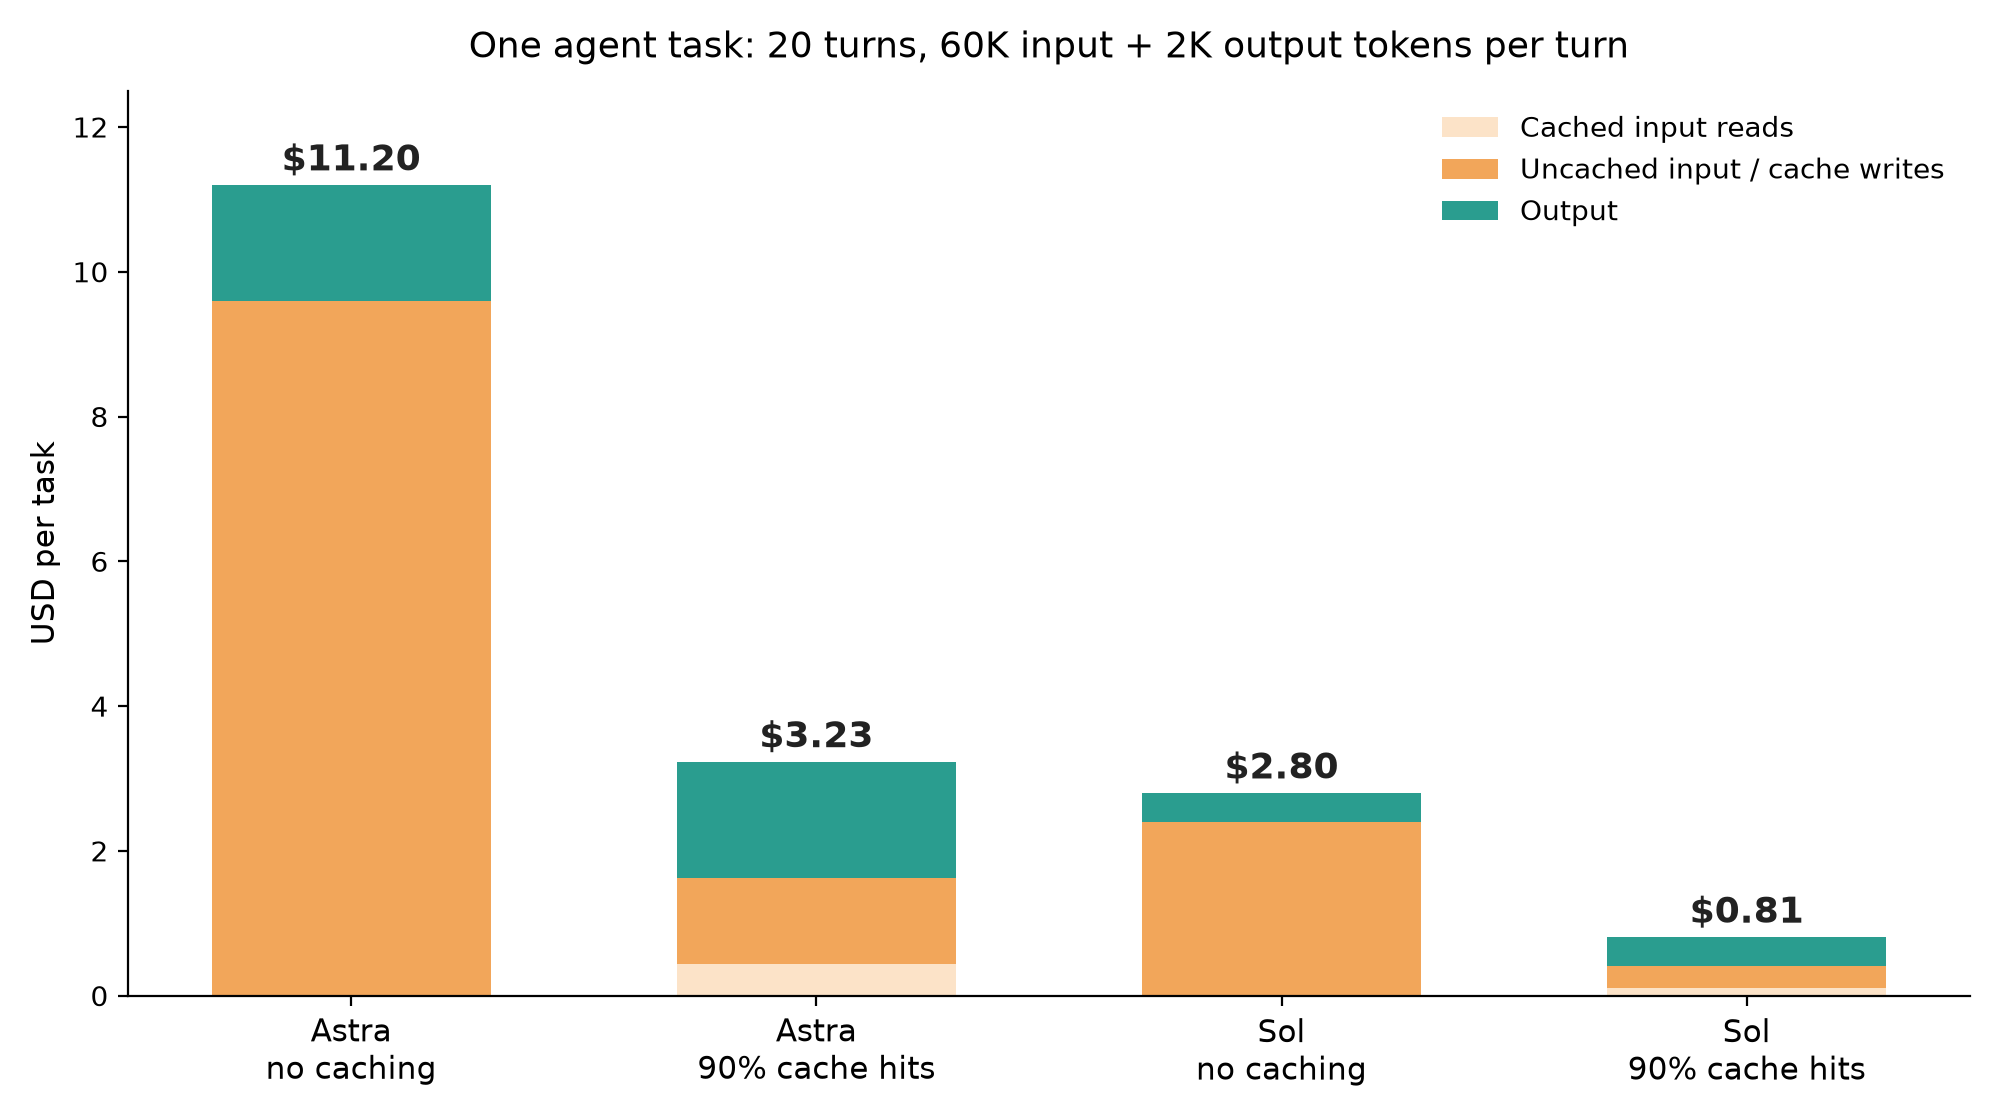
มีสองตัวเลขที่โดดเด่น การทำ caching ลดค่าใช้จ่ายต่องานลงราว 71 เปอร์เซ็นต์ในทั้งสองโมเดล และงาน Astra ที่มี cache มีค่าใช้จ่ายเพียงเล็กน้อยเหนือกว่างาน Sol ที่ไม่มี cache โมเดลราคาถูกที่ cache พังมีค่าใช้จ่ายเกือบเท่ากับโมเดลราคาแพงที่ cache ทำงานปกติ
จุดที่ค่าธรรมเนียม long context เริ่มกัด
Coding agents ที่อ่าน repository ครึ่งหนึ่งอาจมี input tokens ต่อเทิร์นเกิน 272K เปรียบเทียบสองเทิร์นบน Sol ทั้งคู่มี output tokens 2,000 ตัวและไม่มี cache:
- 270,000 input tokens: $0.54 สำหรับ input บวก $0.02 สำหรับ output รวม $0.56
- 300,000 input tokens: $1.20 สำหรับ input บวก $0.03 สำหรับ output รวม $1.23
Context ที่ใหญ่ขึ้นเพียง 11 เปอร์เซ็นต์มีค่าใช้จ่ายมากกว่าสองเท่า หาก agent harness ของคุณทำ context compaction ควรเก็บไว้ต่ำกว่า 272K ตรรกะเดียวกันนี้คือหัวใจของบทความของเราเรื่อง ทำไมโมเดลราคาถูกอาจมีค่าใช้จ่ายมากกว่า: ราคาต่อการเปลี่ยนแปลงที่ยอมรับสำคัญกว่าราคาต่อโทเคน
ค่าใช้จ่าย GPT-6.2 ต่อเดือนของทีม agent
ต่อไปขยายตัวเลขแบบมี cache สมมติว่า agents ห้าตัวแต่ละตัวทำงานเสร็จ 8 งานต่อวัน นาน 22 วันทำการ รวมเป็น 880 งานต่อเดือน
| การตั้งค่าทีม | งานต่อเดือน | ค่าโมเดลต่อเดือน |
|---|---|---|
| Agents ทั้งห้าตัวใช้ Astra | 880 | $2,842 |
| Astra หนึ่งตัวเป็นหัวหน้า, Sol สี่ตัว | 176 + 704 | $1,139 |
| Agents ทั้งห้าตัวใช้ Sol | 880 | $713 |
การตั้งค่าแบบผสมมีค่าใช้จ่ายน้อยกว่าแบบใช้ Astra ทั้งหมด 60 เปอร์เซ็นต์ โดยเก็บโมเดล frontier ไว้ใช้ในการวางแผนและตรวจงานที่ยาก แล้วส่งงานประจำไปให้ Sol เราพูดถึงบทบาทหัวหน้าใน GPT-6 Astra เป็นหัวหน้า Crew ของคุณ และเหตุผลเดียวกันนี้สนับสนุนแนวคิด งบเท่าเดิม ได้ agents มากขึ้นด้วย GPT-6 Sol
ราคาเป็นเพียงเพดานเดียว Tokens per minute สามารถทำให้ทีม agent หยุดก่อนเงินจะหมดใน usage tiers ระดับล่าง ซึ่งคู่มือ rate limits ของ GPT-6.2อธิบายไล่ทีละ tier
แผน Codex เทียบกับ API keys
หาก agents ของคุณรัน Codex บนแผน ChatGPT คุณไม่ต้องจ่ายต่อโทเคน แต่ใช้จากโควตาที่ได้รับ หน้า pricing ของ Codex ประมาณการไว้ว่า GPT-6.2 Astra บน Plus และ Standard Business สามารถใช้ได้ 6 ถึง 50 ข้อความ local ต่อช่วงห้าชั่วโมง และ Sol อยู่ที่ 17 ถึง 180 ข้อความ การใช้ session ยาวจะใช้โควตาเร็วขึ้น ดังนั้นการคำนวณโทเคนข้างต้นยังคงบอกได้ว่างานประเภทใดจะหมดก่อน
คู่มือ GPT-6.2 Codex ของเราอธิบายการตั้งค่าสำหรับทั้งสองโมเดล
วิธีลดค่าใช้จ่าย GPT-6.2 สำหรับทีม agent
ลำดับด้านล่างนี้จัดเรียงตามสิ่งที่ประหยัดเงินได้มากที่สุดก่อน:
- ทำให้ caching ทำงานได้. วางคำสั่งที่คงที่ไว้ในข้อความ
developerที่ต้นของ input และอย่าเขียนเทิร์นก่อนหน้าใหม่ prefix ที่ถูกแก้ไขคือ cache miss - ใช้ Sol เป็นค่าเริ่มต้น. ยกระดับงานขึ้น Astra เฉพาะเมื่องานข้าม service หรือ Sol ล้มเหลวในงานประเภทเดียวกันสองครั้ง
- คง input tokens ไว้ต่ำกว่า 272K ต่อคำขอ
- ย้ายงานจำนวนมากไปในช่วง background windows เมื่อเรียก API จาก harness ของคุณเอง
- ใช้ Batch สำหรับ evals และงานออฟไลน์ ไม่ใช่สำหรับ interactive agent
- ปิด Fast และ Ultrafast ยกเว้นกรณีที่มีคนรอผลลัพธ์อยู่
ช่วง background ที่ลดราคาแทนที่ Flex
คู่มือ background mode ของ OpenAI ระบุช่วง completion ที่ลดราคาสองช่วงสำหรับ Responses API บน GPT-6.2 (public beta): 2h ที่ถูกกว่าราคามาตรฐาน 30 เปอร์เซ็นต์ และ 8h ที่ถูกกว่า 40 เปอร์เซ็นต์ ทั้งคู่ใช้ rate limit ร่วมกับ Batch ไม่ใช่ token limit แบบเรียลไทม์ของคุณ
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "You write unit tests for the payments service."},
        {"role": "user", "content": "Add tests for refund edge cases in refunds.py."},
    ],
    background=True,
    background_options={"completion_window": "8h"},
)
print(response.id, response.status)
Poll response ID ทีหลัง หรือใช้ webhook วิธีนี้เหมาะกับการสร้าง tests, การอัปเกรด dependencies และการตรวจเอกสารที่ไม่มีใครต้องใช้ก่อนเช้าวันรุ่งขึ้น
ควบคุมค่าใช้จ่าย GPT-6.2 ต่อ Agent ใน Sharkly
Sharkly ไม่ได้ขายโทเคนต่อ ทุกการรันจะถูกเรียกเก็บกับแผน Codex หรือ API key ที่ผูกกับ Runtime อยู่แล้ว ทำให้ใบแจ้งหนี้ OpenAI ของคุณยังคงเป็นแหล่งข้อมูลหลักเพียงแหล่งเดียว สิ่งที่ Sharkly มอบให้คือการควบคุมว่างานเท่าไรที่จะไปถึงใบแจ้งหนี้นั้น
แต่ละ Agent มีแถว Default model ที่แสดงโมเดลที่ Runtime ของมันรายงาน ตั้ง Agents ที่ทำงานประจำเป็น Sol และ Agent หัวหน้าเป็น Astra เมื่องานบางอย่างต้องการมากกว่านั้น เอกสารของ Sharklyอธิบายการ override ต่องาน: วางเมาส์เหนือ Agent ใน Assignee picker แล้วเลือกโมเดลสำหรับการรันนั้นเท่านั้น
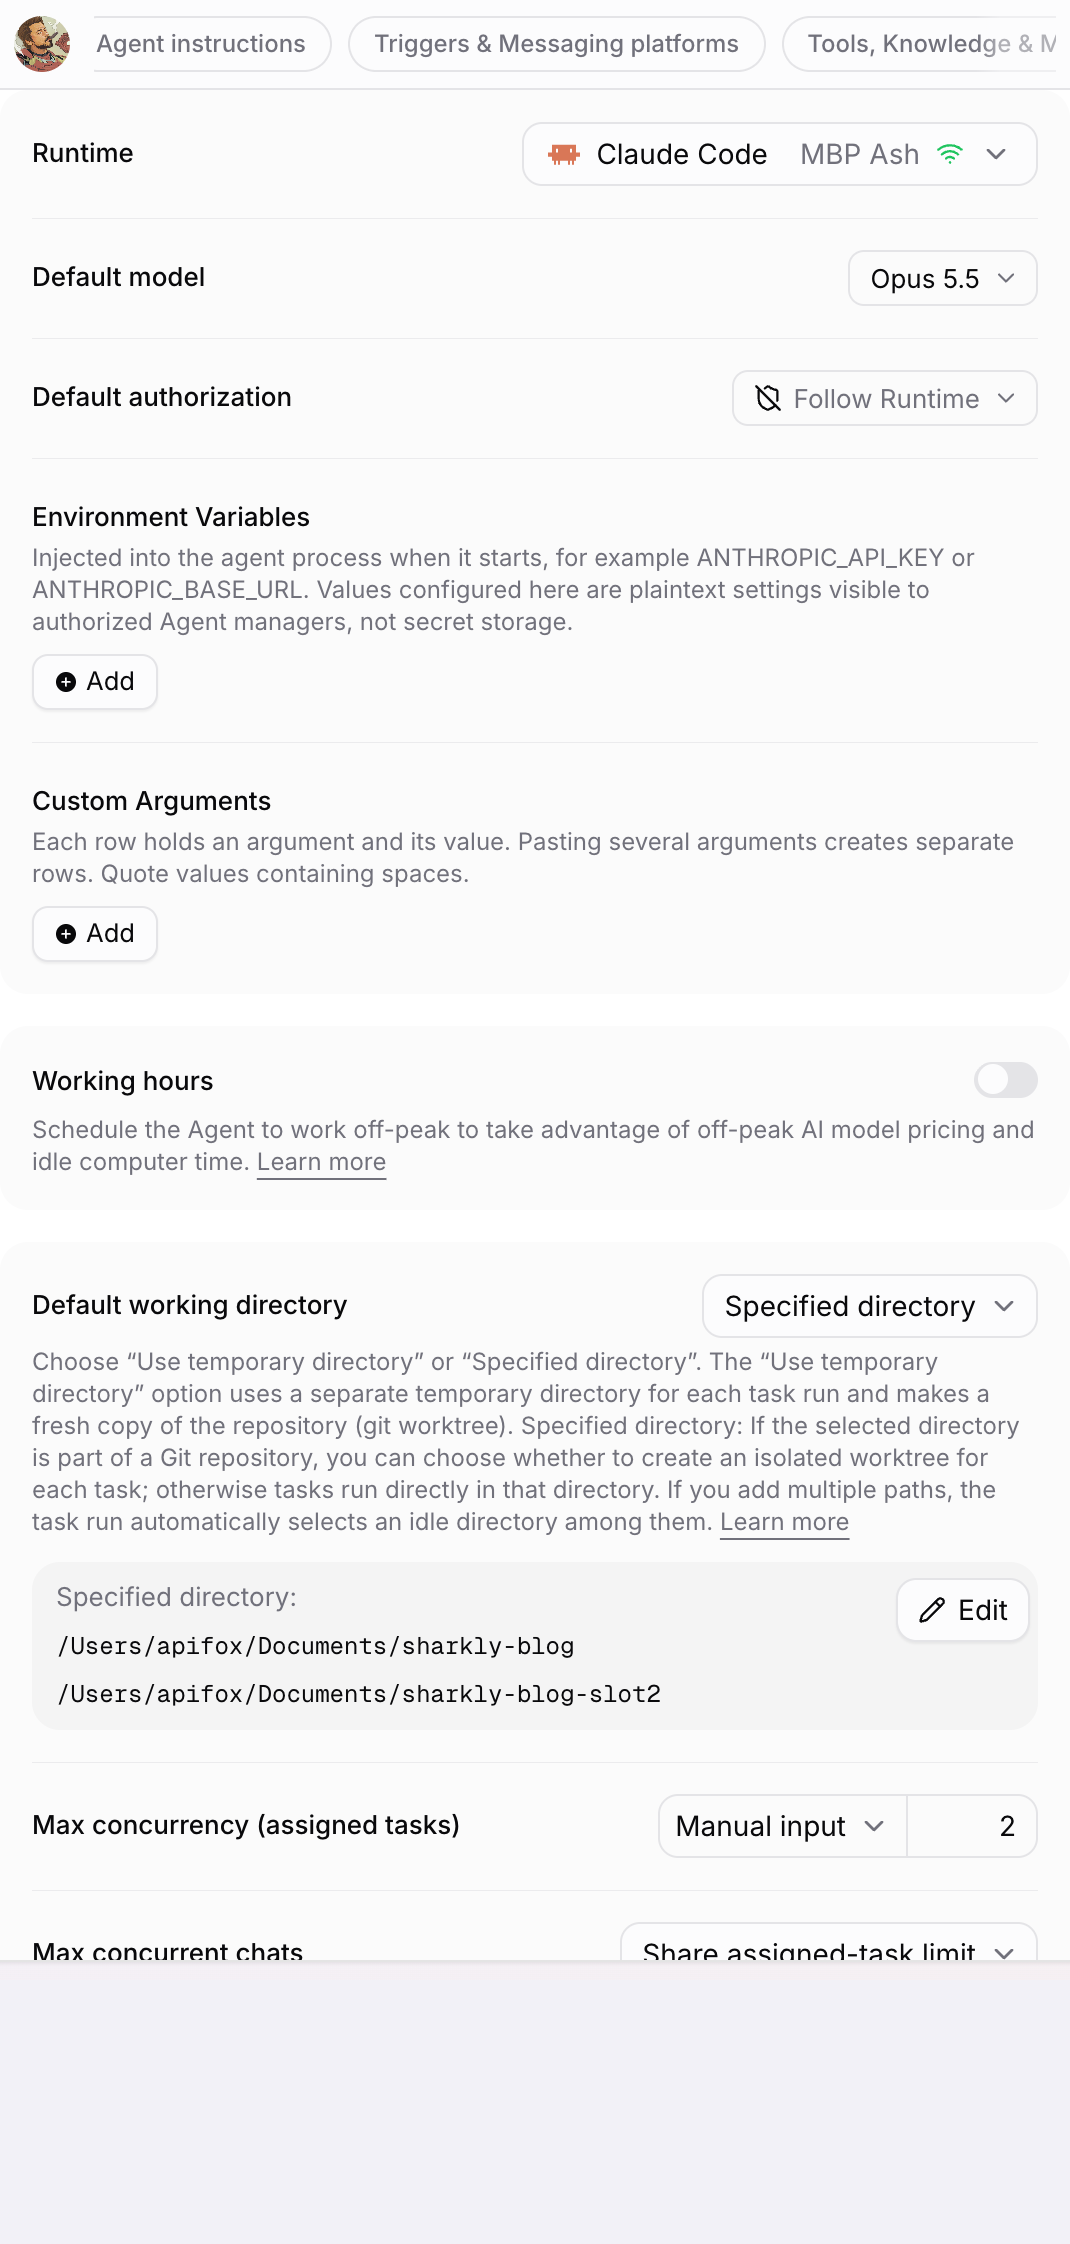
แผงเดียวกันนี้ยังมี Environment Variables ที่จะถูกแทรกเข้าสู่กระบวนการของ agent ตอนเริ่มต้น ให้แต่ละกลุ่ม Agent ใช้ API key จาก OpenAI project ของตัวเอง แล้วหน้า usage ของ OpenAI จะแยกค่าใช้จ่ายตามกลุ่ม Working hours ช่วยจัดตารางให้ Agent ทำงานในช่วง off-peak งานจำนวนมากจึงรันตอนกลางคืน เหลือ capacity ช่วงกลางวันไว้ให้คนที่รอผลลัพธ์อยู่
ค่าใช้จ่ายยังต้องมีเพดาน Max concurrency จำกัดจำนวนงานที่ Agent รันพร้อมกัน, Max run duration หยุดการรันที่วนลูป, และ Queue timeout ทิ้งงานที่รอนานเกินไป
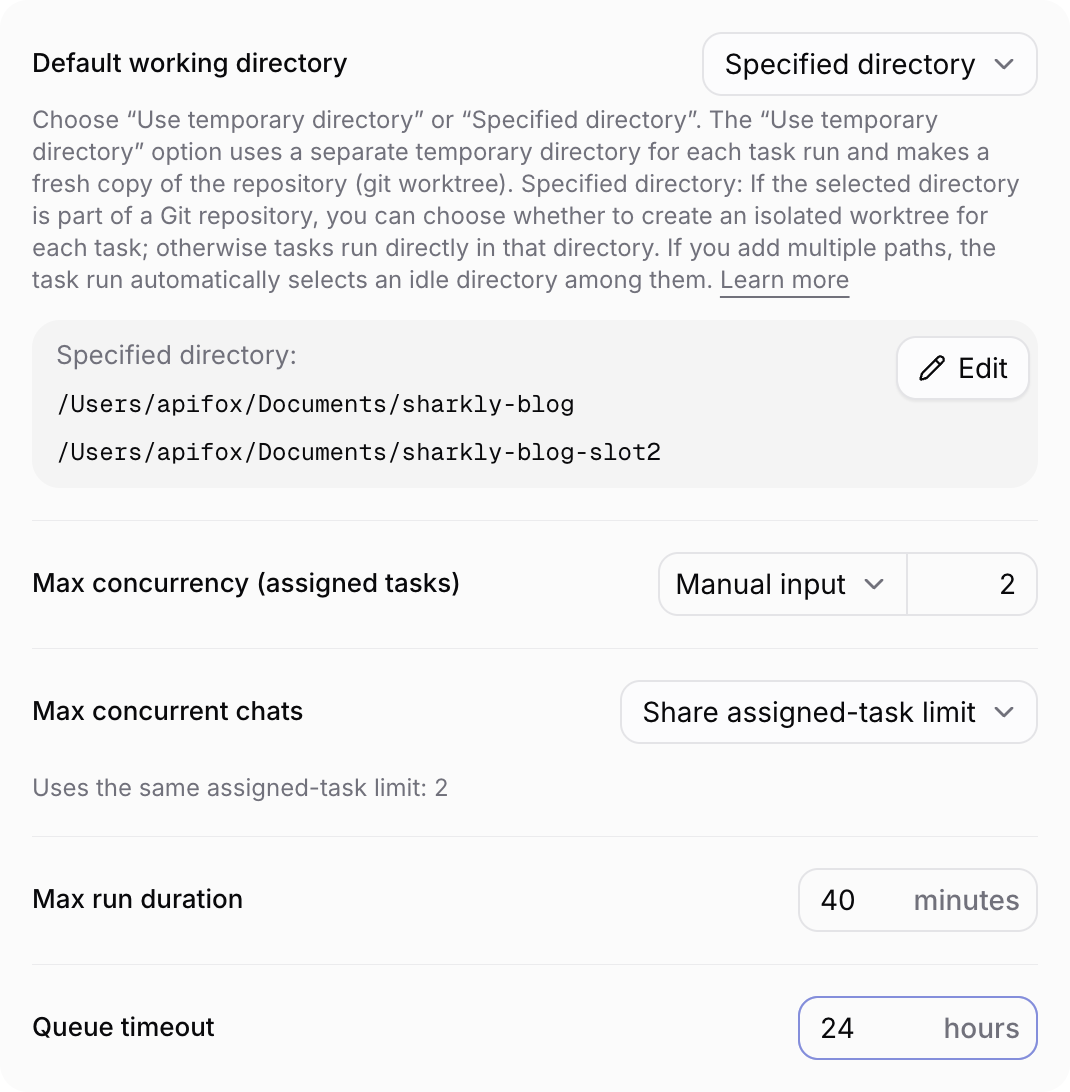
การจำกัดเวลารันที่ 40 นาทีบน Agent ที่ใช้ Sol ช่วยจำกัดกรณีเลวร้ายที่สุด รายการการรันของแต่ละ Agent แสดงจำนวนโทเคนที่ทุกการรันใช้ คุณจึงมองเห็นประเภทงานที่กินโทเคนมากกว่างานอื่นสามเท่าได้ งานแบบนั้นต้องการคำอธิบายที่กระชับขึ้นหรือโมเดลที่ถูกกว่า
สรุป
ราคา GPT-6.2 ดูเรียบง่าย: Astra แพงกว่า Sol สี่เท่าในทุกบรรทัด แต่บิลของ agent ไม่เรียบง่าย การทำ caching เปลี่ยนค่าใช้จ่ายต่องานราว 71 เปอร์เซ็นต์ เกณฑ์ 272K สามารถทำให้เทิร์นหนึ่งแพงขึ้นเป็นสองเท่า และ concurrency คูณทุกอย่างขึ้นมา วัดจากงานจริงหนึ่งงาน เพิ่ม cache hit rate ให้สูงขึ้น ส่งงานประจำไปที่ Sol และกำหนดเพดานการรันพร้อมกัน
ลองกับ Agent เดียวก่อน เชื่อมต่อ Computer, สร้าง Codex Agent บน GPT-6.2 Sol, ตั้ง Max concurrency เป็น 2 และ Max run duration เป็น 40 นาที แล้วมอบงานประจำหนึ่งงานให้ จากนั้นดูโทเคนที่การรันใช้ไป อ่านเพิ่มเติมเรื่องการรันทีมควบคู่กันได้ที่ วิธีรัน AI coding agents 10 ตัวพร้อมกัน
FAQ
GPT-6.2 มีราคาเท่าไร?
GPT-6.2 Astra มีราคา $8 ต่อ input tokens ล้านตัว และ $40 ต่อ output tokens ล้านตัว GPT-6.2 Sol มีราคา $2 และ $10 การอ่าน cached input มีราคา $0.40 บน Astra และ $0.10 บน Sol
GPT-6.2 Sol ถูกกว่า Astra หรือไม่?
ใช่ Sol มีราคาหนึ่งในสี่ของ Astra ทั้ง input, output, cached reads และ cache writes ทั้งสองมี context window 1,050,000 โทเคนและ rate limits เหมือนกัน
ราคา long context ของ GPT-6.2 เป็นอย่างไร?
คำขอที่มี input tokens เกิน 272K จะถูกคิดค่า input และ cache เป็นสองเท่า และค่า output เป็น 1.5 เท่า กับทั้งคำขอ ไม่ใช่เฉพาะโทเคนที่เกินเกณฑ์
GPT-6.2 รองรับ Flex processing หรือไม่?
ไม่ OpenAI แนะนำงานที่รันนานให้ใช้ช่วง background completion ที่ลดราคาแทน: 2h ลด 30 เปอร์เซ็นต์ และ 8h ลด 40 เปอร์เซ็นต์ ในช่วง public beta
GPT-6.2 Batch มีค่าใช้จ่ายเท่าไร?
Batch มีราคา 50 เปอร์เซ็นต์ของราคามาตรฐานในทั้งสองโมเดล เหมาะกับ evals และงานออฟไลน์ ไม่เหมาะกับ interactive agents
Sharkly เก็บค่าโทเคน GPT-6.2 หรือไม่?
ไม่ Sharkly รัน coding agents ที่คุณใช้งานอยู่แล้ว และการใช้โมเดลถูกเรียกเก็บกับแผน Codex หรือ API key ของคุณเอง Sharkly ควบคุมว่าแต่ละ Agent ใช้โมเดลใดและรันงานพร้อมกันกี่งาน


