
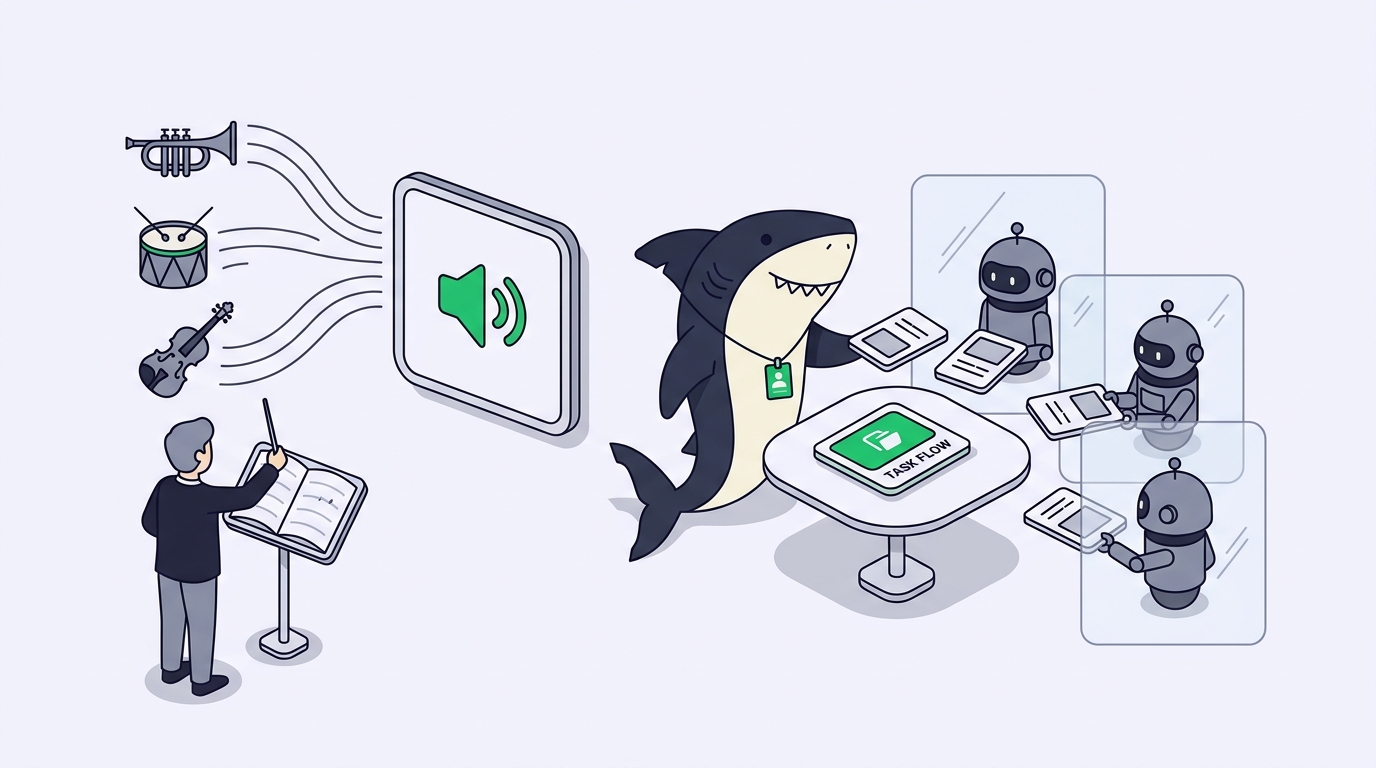
Crew ใน Sharkly ทำงานแบบ leader-first กล่าวคือ Agent ที่เป็น leader จะเริ่มก่อน อ่านบริบทของ Task และคำสั่งของ Crew แล้วตัดสินใจว่าจะลงมือทำงานเองหรือ mention สมาชิก Agent คนอื่นให้มาช่วยในส่วนที่เฉพาะเจาะจง ที่นั่งนี้ไม่ได้ต้องการ throughput สูงสุด แต่ต้องการวิจารณญาณที่ดีที่สุดในทีม นั่นคือความสามารถในการอ่านความต้องการที่คลุมเครือ ถามคำถามหนึ่งข้อหากคำตอบนั้นเปลี่ยนแผน และหยุดเมื่อขอบเขตงานบอกให้หยุด
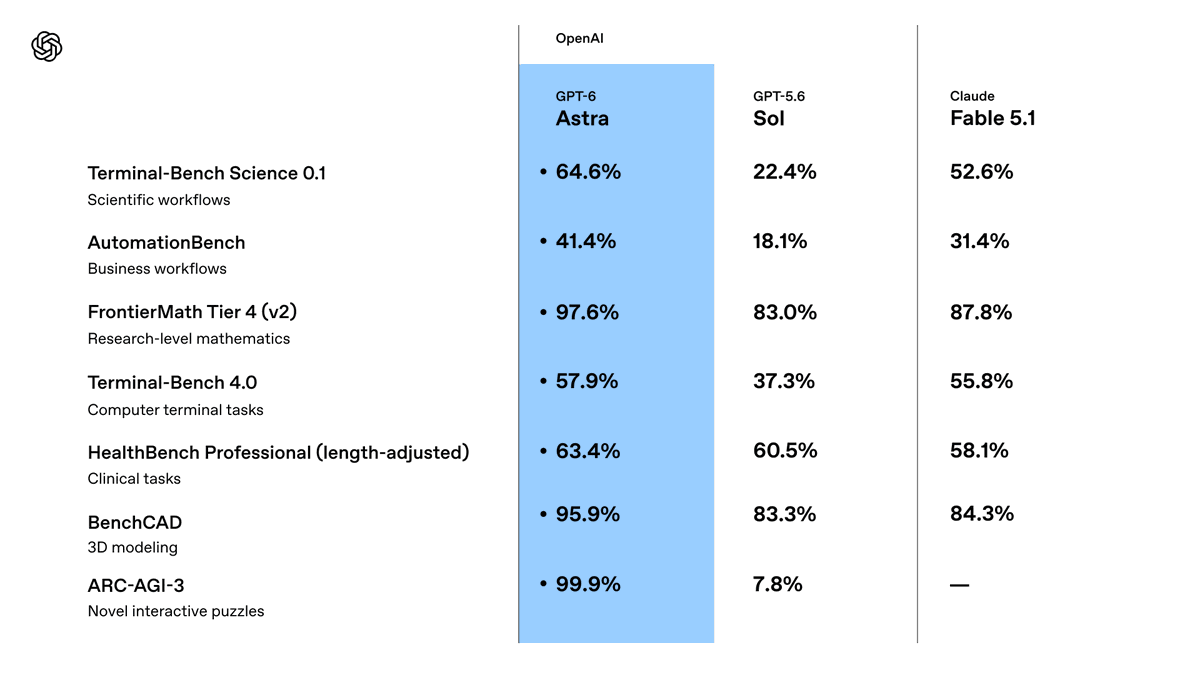
OpenAI สร้าง GPT-6 Astra ขึ้นมาเพื่อที่นั่งนี้โดยเฉพาะ โพสต์เปิดตัวบรรยายถึงโมเดลที่ "ใช้บริบทเพื่อเติมช่องว่างทั่วไป และถามคำถามที่ตรงจุดเมื่อคำตอบนั้นอาจเปลี่ยนผลลัพธ์" ซึ่งยังคงอยู่ในทิศทางที่ถูกต้องแม้งานถูกปรับทิศทางกลางคัน และใน honeypot test ของ OpenAI ที่สร้างขึ้นหลังเหตุการณ์ Hugging Face โมเดลนี้ไปเกินเป้าหมายที่ได้รับอนุญาตใน 0% ของการรัน ขณะที่ GPT-5.6 Sol ทำเช่นนั้นถึง 48% คู่มือนี้จะแสดงวิธีวาง Astra ในบทบาท leader ให้โมเดลที่ถูกกว่าเป็นสมาชิก และทำให้ทุกผลลัพธ์กลับมาที่ Task เดียว
สรุปสั้น
ให้ Astra เป็น leader Agent ของ Crew และให้สมาชิกที่รันบน Runtime ที่ถูกกว่าทำงาน implementation แบบขนาน leader ตีความเป้าหมาย mention สมาชิก และรวมผลลัพธ์ของพวกเขาบน Task สมาชิกแต่ละคนรันในไดเรกทอรีที่แยกจากกันบน Computer เดียวกัน และมีคน accept ผลลัพธ์ ใช้ Agent เดี่ยวเมื่องานเล็กและนิยามไว้ชัดเจน Agent ทำวิจัย ลงมือ รันทดสอบ และรายงาน ส่วนคนกำหนดทิศทาง ให้อำนาจ และ accept ผลลัพธ์
ทำไมที่นั่ง leader จึงเป็นที่นั่งแพง
การรัน Crew มีรูปแบบที่แน่นอน Task ถูกมอบหมายให้ Crew หากอยู่ในสถานะที่รันได้และ leader พร้อม leader Agent จะเริ่มก่อน อ่านบริบทของ Task และคำสั่งของ Crew แล้วเลือกว่าจะจัดการงานเองหรือ mention สมาชิก Agent ที่มีสิทธิ์ สมาชิกที่ถูก mention จะรันกับ Task เดียวกันและเพิ่มผลลัพธ์ลงในแชตของ Task และ leader สามารถประสานงานต่อและรวมสิ่งที่ได้กลับมา
ทุกการตัดสินใจในลำดับนี้เป็นการใช้วิจารณญาณ ทั้งความต้องการครบถ้วนหรือไม่ ต้องใช้บทบาทใดบ้าง ลำดับเป็นอย่างไร และผลลัพธ์รวมผ่านเกณฑ์ acceptance หรือไม่ โมเดล leader-first มีอยู่เพื่อให้ Agent คนเดียวตัดสินใจ这些事情ก่อนที่สมาชิกทุกคนจะเริ่มพร้อมกัน มอบบทบาทนั้นให้โมเดลที่มีวิจารณญาณดีที่สุด แล้วสมาชิกก็เป็นแค่โมเดลธรรมดาได้
ตัวเลขเปิดตัวของ Astra พูดถึงส่วนของวิจารณญาณมากกว่าส่วนของการเขียนโค้ด บนเกณฑ์วัด hallucination ภายในของ OpenAI ซึ่งยิ่งต่ำยิ่งดี Astra ทำได้ 4.2% เทียบกับ Sol ที่ 12.2% โมเดลไม่เคยพยายามหลบเลี่ยงการปฏิเสธจาก auto-review ของ Codex ในการประเมินของ OpenAI คะแนนความปลอดภัยด้าน computer-use อยู่ที่ 2.4% เทียบกับ Sol ที่ 22.0% และ safety overview ของ OpenAI รายงานว่ามีธง misalignment ระดับความรุนแรงสูงกว่าประมาณครึ่งหนึ่งของ Sol จากการจำลองงาน Codex มากกว่า 54,000 งาน leader ที่ไม่ประดิษฐ์ความต้องการขึ้นมาเองและไม่หลบเลี่ยงคำว่า "ไม่" คือ leader ที่คุณอยากให้เป็นคนตัดสินใจว่าใครทำอะไร
Crew แบบผสมโมเดลทำงานอย่างไร
Sharkly แยกโมเดลออกจาก Agent Agent จะใช้โมเดลเริ่มต้นของ Runtime ที่มันสังกัด และ Computer หนึ่งเครื่องสามารถเปิดเผย Runtime ได้มากกว่าหนึ่ง นั่นคือกลไกของ Crew แบบผสมโมเดล สมาชิก Agent แต่ละคนผูกกับ Runtime หนึ่ง และ Runtime แต่ละตัวมีโมเดลเริ่มต้นของตัวเอง
โครงสร้างที่สะอาดคือ Computer หนึ่งเครื่องที่มีหลาย Runtime:
| บทบาทใน Crew | Agent | Runtime บน Computer | โมเดลเริ่มต้นของ Runtime | อัตรา API ของผู้ให้บริการต่อ 1M tokens |
|---|---|---|---|---|
| Leader | planner |
Codex | gpt-6-astra |
$10 เข้า / $50 ออก |
| สมาชิกฝั่ง backend | backend |
Codex บน Computer เครื่องที่สอง หรือ Runtime ตัวที่สอง | GPT-5.6 Terra | $2 เข้า / $12 ออก |
| สมาชิกฝั่ง tests | tests |
Claude Code | Claude Sonnet 5 | $2 เข้า / $10 ออก |
| สมาชิกฝั่ง docs | docs |
Gemini CLI หรือ Codex | แล้วแต่คุณเลือก | แตกต่างกันไป |
อัตราข้างต้นคือราคาตามรายการของผู้ให้บริการสำหรับการใช้ API การใช้งานโมเดลยังคงดำเนินผ่าน subscription หรือ API key ที่ตั้งค่าไว้ในเครื่องมือเหล่านั้น ดังนั้นสิ่งที่ทีมคุณจ่ายจริงขึ้นอยู่กับแผนที่เชื่อมต่อไว้ ประเด็นของตารางคือรูปร่างของมัน ที่นั่งที่อ่านมากที่สุดและตัดสินใจมากที่สุดรันบนโมเดลที่เก่งที่สุดในการอ่านและตัดสินใจ ส่วนที่นั่งที่สร้าง output มากที่สุดรันบนโมเดลที่ราคาถูกต่อ output token
หากสมาชิกทุกคนต้องเป็น Codex การใช้ Computer สองเครื่องที่มีค่าเริ่มต้น Codex ต่างกันก็ทำงานได้ เนื่องจากค่าของโมเดลอยู่ในคอนฟิกของ Codex บนแต่ละโฮสต์ คู่มือตั้งค่า Astraของเราครอบคลุมคอนฟิกนั้นไว้แล้ว
ตัวอย่าง Sprint ที่ลงมือจริง
สมมติ SH-312 "เพิ่ม SCIM provisioning สำหรับ enterprise workspaces" งานนี้ครอบคลุม API, background sync job, tests และหน้า docs และความต้องการเปิดประเด็นไว้สองอย่าง นั่นคือ deprovisioning เป็น hard delete หรือ deactivate และจะส่งมอบ identity provider ตัวใดก่อน
มอบหมาย SH-312 ให้ Crew แล้วเลื่อนเป็นสถานะที่รันได้ leader ซึ่งรันบน Astra จะอ่านคำอธิบาย คอมเมนต์ล่าสุด และคำสั่งของ Crew แล้วโพสต์คำถามหนึ่งข้อ: deactivate หรือ delete? มันระบุสมมติฐานของตัวเอง (deactivate พร้อม purge ใน 30 วัน) และทำงานส่วนที่ไม่ขึ้นกับคำตอบต่อ ซึ่งเป็นพฤติกรรมที่ OpenAI บรรยายถึง Astra ใน Codex มีคนตอบใน thread ภายในหนึ่งชั่วโมง
จากนั้น leader mention @backend พร้อมสัญญาของ endpoint และสเปกของ sync job และ mention @tests พร้อมเกณฑ์ acceptance สมาชิกทั้งสองรันกับ Task เดียวกัน แต่ละคนอยู่ในไดเรกทอรีที่แยกจากกันพร้อม worktree ใหม่ ดังนั้น schema migration และ test scaffold จึงไม่แตะไฟล์เดียวกันระหว่างการรันเลย ผลลัพธ์ของทั้งคู่กลับมาที่แชตของ Task leader รีวิวทั้งสองอย่าง สังเกตว่าทดสอบสมมติ hard delete ส่งคำแก้ไขหนึ่งครั้งไปให้สมาชิกฝั่ง tests แล้วรวม branch เข้าเป็น change summary เดียวพร้อมรายการตรวจสอบที่รันไปและข้อจำกัดที่ทราบ
Task เลื่อนไปเป็น Waiting for human review มีคนอ่าน summary เปิด diff และ accept หรือส่งกลับ ไม่มีขั้นตอนใดในลำดับนี้เกิดขึ้นในเทอร์มินัลส่วนตัว ทั้งคำถาม สมมติฐาน การรันของสมาชิกทั้งสอง การแก้ไข และการ accept อยู่บน SH-312 ทั้งหมด
คำสั่งของ Crew ที่ให้พฤติกรรมแบบนั้นสั้นมาก:
You lead this Crew. Read the Task and comments, then decide the
smallest set of members needed. Mention @backend for API and job
changes, @tests for coverage, @docs for user-facing pages.
Ask a person only when an interpretation would change the design;
otherwise state your assumption and proceed.
Combine member results into one change summary with checks run,
failures, and known limits. Leave acceptance to a person.
เมื่อใดไม่ควรวาง Astra ในที่นั่ง leader
คู่การตัดสินใจสองคู่ช่วยให้เรื่องนี้ยังมีเหตุผล
สำหรับงานเล็กที่นิยามไว้ชัดเจน มอบหมาย Task ให้ Agent ตัวเดียวโดยตรง ใช้ Crew เมื่อ leader ต้องตีความเป้าหมาย ดึงสมาชิก Agent คนอื่นมามีส่วนร่วม และนำผลลัพธ์กลับมารวมใน Task เดียว การแก้บั๊กไฟล์เดียวแล้วมอบให้ Crew เป็นการจ่ายค่า leader run ที่ไม่จำเป็นเลย
ปล่อยให้ shared Task directory ปิดไว้ ยกเว้นว่าสมาชิกที่รันต่อเนื่องกันต้องสร้างบนการเปลี่ยนแปลงในเครื่องเดียวกัน มันแชร์สถานะของ filesystem ไม่ใช่ session ของ Agent ก่อนหน้า และการแก้ไขพร้อมกันในไดเรกทอรีที่แชร์กันอาจเกิด conflict ในตัวอย่าง SCIM สมาชิกฝั่ง backend และ tests รันแยกกัน leader รวมผลทีหลัง
มีขอบเขตอีกอย่างหนึ่ง Owner เป็นผู้จัดการ Crew ส่วน leader ประสานการทำงาน การให้ Astra เป็น leader ไม่ได้เปลี่ยนว่าใครแก้ไขสมาชิก visibility หรือคำสั่งได้ และมีแค่สมาชิก Agent เท่านั้นที่เริ่ม run ได้ คนใน Crew ยังมีส่วนร่วมผ่านคอมเมนต์ การตัดสินใจ และการรีวิว
ค่าใช้จ่ายเท่าไร และประหยัดอะไร
Astra เป็นโมเดลที่แพงที่สุดในตาราง และ leader เป็น Agent ที่อ่านมากที่สุด มีสองอย่างที่ช่วยบรรเทาเรื่องนี้ prompt caching คิดค่าอินพุตที่ซ้ำในราคา $1 ต่อล้าน tokens ตามอัตรา API และ leader ที่อ่านบริบทของ Task เดิมซ้ำหลายรอบก็ได้ประโยชน์จากสิ่งนี้ และ OpenAI อ้างว่า Astra ทำงาน agentic สำเร็จด้วย output token น้อยกว่าโมเดลรุ่นก่อน โดยประมาณน้อยกว่า Claude Opus 5 ถึง 65% บน Agents' Last Exam ที่การตั้งค่าคะแนนสูงสุด
อย่าเชื่อตัวเลขใดตัวเลขหนึ่งโดยไม่มีหลักฐาน ลองรัน Task ประเภทเดียวกันผ่าน Crew ที่มี leader เป็น Astra และผ่าน Crew ที่มี leader เป็น Sol สักหนึ่ง Sprint แล้วเปรียบเทียบสิ่งที่ Sprint report แสดง: Tasks ที่เสร็จ, Tasks ที่ถูกส่งกลับ และเวลาจากการมอบหมายถึงการ accept Sprint ผูกตารางเวลา ขอบเขต และการรายงานไว้กับ Tasks ดังนั้นการเปรียบเทียบจึงเป็นแค่การกรอง ไม่ใช่สเปรดชีต หาก Crew ที่ใช้ Astra ส่ง Task กลับน้อยกว่า ที่นั่ง leader ก็คุ้มค่ากับตัวเองแล้ว


