
OpenAI เปิดตัว GPT-6 Luna เมื่อวันที่ 22 กันยายน ในราคา 0.10 ดอลลาร์ต่ออินพุต 1 ล้านโทเคน และ 0.50 ดอลลาร์ต่อเอาต์พุต 1 ล้านโทเคน ใช้ API id ว่า gpt-6-luna พร้อม context window ขนาด 1M ด้วยราคาระดับนี้ คำถามที่น่าสนใจจึงไม่ใช่เรื่องที่ว่าโมเดลนี้ดีพอในเชิงทฤษฎีหรือไม่ anymore แต่กลายเป็นว่าเลนไหนบนบอร์ดของคุณที่คุณยอมยกให้มันทำงาน และเลนราคาถูกกับเลนราคาแพงจะรันบน Computer เครื่องเดียวกันได้อย่างไรโดยที่ไม่มีใครหลงว่าผลลัพธ์ชิ้นไหนมาจากเลนไหน
นี่เป็นปัญหาการตั้งค่าก่อนที่จะเป็นปัญหาเรื่องโมเดล ทีมที่ผูก Luna ไว้ทุกงานจะประหยัดเงินได้ แล้วก็จ่ายคืนกลับไปในขั้นตอนรีวิว ส่วนทีมที่ไม่เคยผูกมันเลยก็จะยังจ่ายราคาพรีเมียมเพื่อให้ Agent เปลี่ยนชื่อไฟล์เทสต์ คู่มือนี้จะพาไปตามเส้นทางที่สั้นและได้ผลที่สุด: ติดตั้ง gpt-6-luna บน Computer หนึ่งเครื่อง แยกมันไว้ในเลนของตัวเอง มอบ Task จริงให้หนึ่งงาน แล้วอ่านผลลัพธ์ในจุดที่ทั้งทีมมองเห็นได้
สรุปสั้น ๆ
ผูก gpt-6-luna เป็นโมเดลเริ่มต้นของ Runtime บน Computer ที่เชื่อมต่ออยู่ ยืนยันว่า Runtime นั้นขึ้นสถานะ Available ใน Sharkly แล้วมอบ Agent แยกให้มันแทนที่จะใช้ Agent ตัวแพงร่วมกัน เพิ่ม timeout ต่อ Task ก่อนจะไว้ใจการรันแบบยาว ๆ และให้ Luna ทำงานที่คนสามารถตรวจผลลัพธ์ได้ในไม่ถึงหนึ่งนาที Sharkly จะไม่แสดงชื่อโมเดล แต่จะแสดงการรัน บันทึก คำถาม และผลลัพธ์บน Task ส่วน Agent ทำหน้าที่ค้นคว้า ลงมือทำ ทดสอบ และรายงานผล คนเป็นคนกำหนดทิศทาง ให้อำนาจ และตอบรับผลลัพธ์
การตั้งค่าโมเดลอยู่ตรงไหน
Sharkly ไม่ได้เป็นตัวเลือกโมเดล เอกสาร Agent และ Computer ระบุไว้ชัดเจนว่า “Agent จะใช้โมเดลเริ่มต้นของ Runtime โดยไม่สัญญาและไม่แสดงชื่อโมเดลที่เจาะจง ต้องเปลี่ยนโมเดลในการตั้งค่า Runtime หรือเครื่องมือของ Computer ไม่ใช่ที่ Agent”
ดังนั้นจึงไม่มีดропดาวน์ให้เลือกโมเดลบน Agent และไม่มีการควบคุมระดับความลึกในการคิดเช่นกัน มีสี่บทบาท แต่ละบทบาทมีหน้าที่เดียว Agent กำหนดว่างานควรถูกจัดการอย่างไร Computer จัดหาโฮสต์และทรัพยากรในเครื่อง Runtime ทำหน้าที่รันเซสชันของ agent จริง ๆ ส่วน Task ยังคงเป็นบันทึกที่ทีมใช้ร่วมกัน ขั้นตอนแบบละเอียดของ setup นั้นอยู่ใน คู่มือ GPT-6 Sol ของเรา ส่วนโพสต์นี้จะครอบคลุมเฉพาะส่วนที่เกี่ยวกับการเอาโมเดลราคาถูกขึ้นบอร์ด
ขั้นที่ 1: ผูก gpt-6-luna บน Computer
บน Computer ที่จะรันมัน ให้อัปเดต agent tool ของคุณและลงชื่อเข้าใช้ด้วยบัญชีหรือ API key ที่เข้าถึง Luna ได้ OpenAI เปิดให้ใช้ Luna ใน ChatGPT Work และใน Codex สำหรับแผน Plus, Pro, Business, Enterprise และ Edu ให้ผู้ใช้ Free และ Go เข้าถึง Luna ผ่านแอปเดสก์ท็อป และยังไม่ได้ใส่ไว้ใน Chat หาก codex -m gpt-6-luna เริ่มเซสชันได้ในเทอร์มินัลธรรมดาบนโฮสต์นั้น Sharkly ก็ใช้งานมันได้
จากนั้นตั้งค่าเริ่มต้นเพื่อให้การรันบน Runtime นั้นหยิบมันไปใช้:
# ~/.codex/config.toml
model = "gpt-6-luna"
model_provider = "openai"
model_reasoning_effort = "high"
มีข้อควรระวังสองข้อใน snippet นั้น ชื่อคีย์ reasoning-effort แตกต่างกันไปตามเวอร์ชันของ Codex ดังนั้นให้ตรวจเทียบกับไฟล์ config ตัวอย่างของบิลด์ที่ติดตั้งบน Computer เครื่องนั้น และ high ที่ใส่ไว้ตรงนั้นก็ตั้งใจใส่ ไม่ได้ใส่เป็นค่าเริ่มต้น เพราะผลลัพธ์ Luna ทุกตัวที่เผยแพร่ด้านล่างนี้วัดที่ effort ระดับ high หรือ max ไม่ใช่ที่ค่าที่คุณจะเลือกเพื่อทำให้โมเดลถูกลงไปอีก [VERIFY]
กลับมาที่ Sharkly เปิดหน้ารายละเอียด Computer แล้วกด rescan หรือทดสอบการเชื่อมต่อ Runtime ควรขึ้นสถานะ Available ถ้า Computer แสดงแค่ว่า online นั่นหมายความว่าบริการในเครื่องส่ง heartbeat อยู่เท่านั้น ส่วนสถานะความสามารถของ Runtime ต่างหากที่บอกคุณได้ว่าการรันเริ่มได้
ขั้นที่ 2: แยกเลนราคาถูกให้เห็นชัด ๆ
Computer หนึ่งเครื่องสามารถเปิด Runtime ได้หนึ่งตัวหรือมากกว่า โดยแต่ละตัวรายงานสถานะการเชื่อมต่อของตัวเอง และสามารถเพิ่ม ACP Runtime แบบกำหนดเองได้จากหน้ารายละเอียด Computer พร้อมชื่อและคำสั่งเริ่มต้นของตัวเอง นี่คือจุดที่ควรใช้ให้เป็นประโยชน์ ให้เลน Luna มี Runtime ของตัวเองและ Agent ของตัวเอง ตั้งชื่อตามเลน ไม่ใช่ตามชื่อโมเดล แล้วบอร์ดจะบอกคุณได้ว่า Task ไหนรันในเลนไหน โดยไม่ต้องมีใครไปอ่าน execution log
นี่ไม่ใช่เรื่องของความสวยงาม Sharkly ไม่สามารถอ่านได้อย่างน่าเชื่อถือว่า Runtime กำลังใช้โมเดลอะไรอยู่จริง ซึ่งเป็นเหตุผลตรง ๆ ที่ว่า Agent จึงใช้ค่าเริ่มต้นของ Runtime และไม่แสดงชื่อโมเดล ถ้า Agent ตัวหนึ่งเปลี่ยนโมเดลเงียบ ๆ ระหว่างวันอังคารถึงวันพฤหัสเพราะมีคนไปแก้ไฟล์ config การรันสองครั้งที่ดูเหมือนกันเป๊ะบน Task ก็ไม่เหมือนกันจริง การมีเลนแยกตามระดับราคาทำให้เรื่องนี้มองเห็นได้ในจุดเดียวที่ทีมมองอยู่แล้ว ดู Computer ใน Sharkly สำหรับวิธีตรวจหาและทดสอบ Runtime
ลองชั่งน้ำหนักกันสักหน่อย เพราะการมีสองเลนก็มีต้นทุนในการดูแล แยก Runtime เมื่อมีมากกว่าหนึ่งคนมอบหมายงานบน Computer เครื่องนั้น และความต่างระหว่างการรันราคา 0.10 ดอลลาร์กับ 10 ดอลลาร์มีความหมายกับใครสักคน ไม่ต้องแยกเมื่อมีวิศวกรคนเดียวรัน Task ไม่กี่งานต่อสัปดาห์ การใช้ Runtime เดียวแล้วตัดสินใจเป็นราย Task ไปนั้นดูแลง่ายกว่า และ การแยก worktree ก็ช่วยไม่ให้การรันชนกันอยู่แล้ว
ขั้นที่ 3: ตั้งขนาดการรันให้เหมาะกับโมเดลที่ออกตัวช้า
ถูกไม่เท่ากับเร็ว และนี่คือค่าที่คนมักตั้งผิดเป็นอันดับแรก Artificial Analysis ซึ่งเป็นบุคคลที่สาม ไม่ใช่ฝ่ายใดฝ่ายหนึ่ง วัดได้ 153.9 เอาต์พุตโทเคนต่อวินาทีสำหรับ GPT-6 Luna เวอร์ชัน max reasoning โดยใช้เวลา 124.23 วินาทีถึงโทเคนแรก นานกว่าที่คนส่วนใหญ่จะรอก่อนจะสรุปว่าโปรเซสค้างไปแล้ว
ดังนั้นจงตั้ง timeout ต่อ Task อย่างตั้งใจ และเก็บ working directory ไว้ในโหมด Temporary เพื่อให้แต่ละ Task ได้ไดเรกทอรีแยกของตัวเองและ worktree ใหม่ สองการรัน Luna บนรีโพเดียวกันจึงเขียนทับกันไม่ได้ และการรันที่กำลังคิดอยู่ก็ดูต่างจากการรันที่ตายไปแล้ว เพราะ Task มีสถานะติดอยู่ ส่วน scrollback ในเทอร์มินัลไม่มี
Runtime ราคาถูกควรอยู่ตรงไหนใน Crew
Crew คือกลุ่มของ People และ Agents ที่ใช้ซ้ำได้ โดยมี Agent หัวหน้าหนึ่งตัวคอยประสานงาน กฎการจัดวางที่ได้จากตัวเลขของ OpenAI เองก็คือ Luna ควรอยู่กับสมาชิก ไม่ใช่ตำแหน่งหัวหน้า
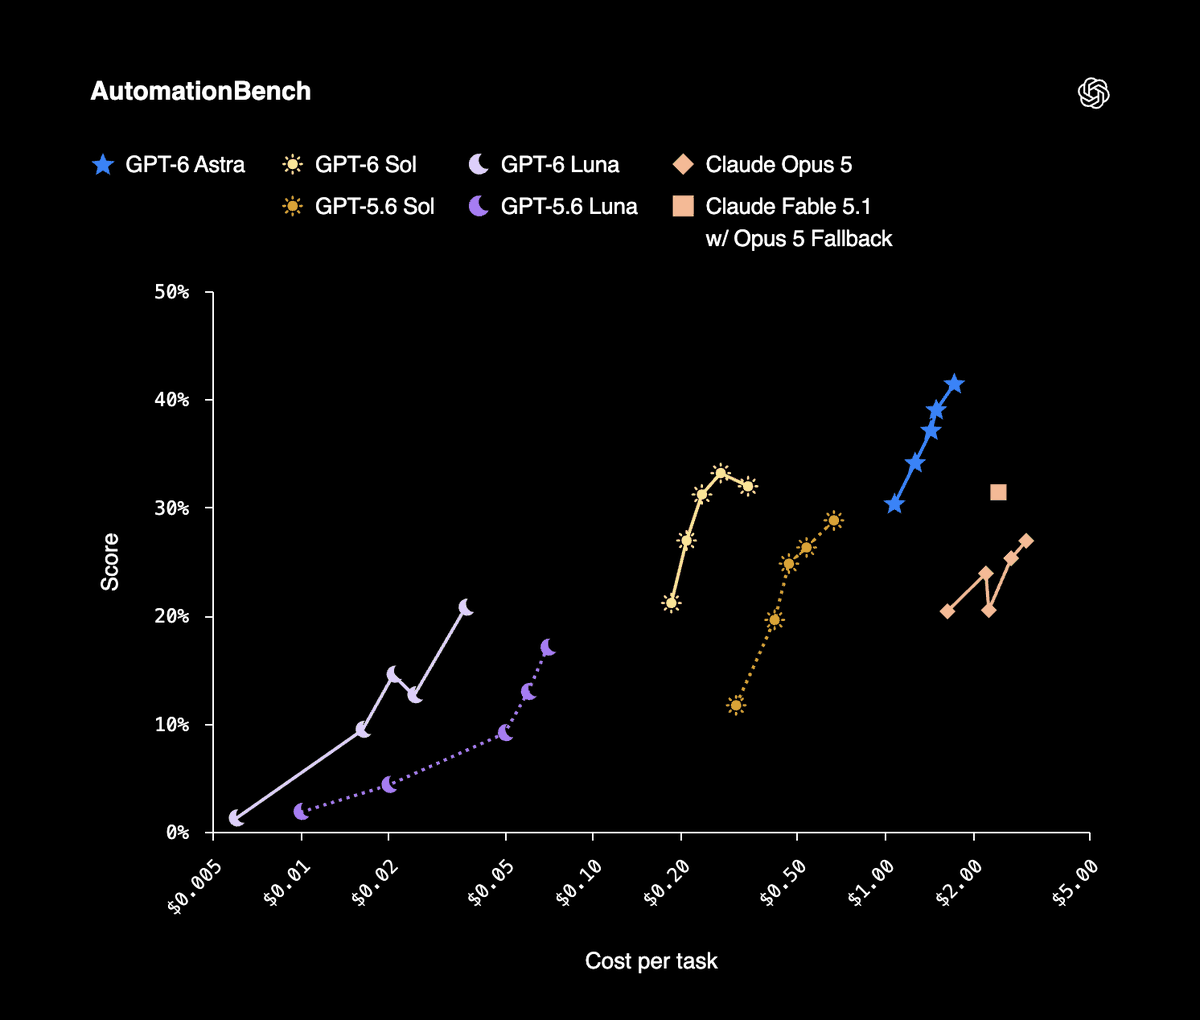
กรณีในฐานะสมาชิกนั้นแข็งแรงมาก บน DeepSWE 1.1 OpenAI รายงานว่า Luna ที่ max effort ได้คะแนน 66.6% เทียบได้กับ Claude Opus 5 และ Fable 5 ที่ medium effort ในต้นทุนต่อ task ต่ำกว่า Opus 5 ถึง 93% และต่ำกว่า Fable 5 ถึง 96% บน OSWorld 2.0 offline นั้น Luna ที่ max เอาชนะ GPT-5.6 Sol ที่ medium ได้ในต้นทุนหนึ่งในสิบ บน AutomationBench 1.0.6 Luna ที่ high ได้คะแนนสูงกว่ารุ่นก่อน 5.4 เปอร์เซ็นต์ที่ต้นทุนต่อ task ต่ำกว่า 58% และในด้าน factuality Luna ที่ effort สูงกว่าเทียบเท่า GPT-5.6 Sol ในต้นทุนประมาณหนึ่งในร้อย OpenAI ยังอธิบายว่า Sol และ Luna นั้นถูกลง 50% จากราคาโปรโมชันของ GPT-5.6 และคำขยายความนั้นก็เป็นของ OpenAI เอง: ฐานที่เทียบคือราคาโปรโมชัน ไม่ใช่ราคาปกติ
กรณีในฐานะหัวหน้านั้นอ่อน และไม่ใช่เพราะ benchmark ใด ๆ หัวหน้าจะตีความเป้าหมาย ตัดสินว่าสมาชิกแต่ละตัวทำอะไร แล้วนำผลลัพธ์กลับมารวมใน Task เดียว การตีความผิดที่ตำแหน่งหัวหน้าไม่ใช่แค่การรันที่แย่หนึ่งครั้ง แต่เป็นสมาชิกทุกตัวที่ถูกชี้ไปผิดทาง และเงินที่ประหยัดได้จากโทเคนของหัวหน้าก็เป็นแค่เศษเสี้ยวเมื่อเทียบกับความเสียหายนั้น คู่มือ Crew leader ของเราให้ข้อโต้แย้งแบบเดียวกันในอีกปลายหนึ่งของช่วงราคา
| งาน | เลน | เหตุผล |
|---|---|---|
| Triage, ติดป้ายกำกับ, จัดระเบียบ backlog | Luna | ปริมาณสูง และคนตรวจคำตัดสินได้ในไม่กี่วินาที |
| โครงเทสต์, โน้ตรีวิวรอบแรก | Luna ที่ high effort | ผลงานที่เผยแพร่ได้นั้นมาจาก high หรือ max ไม่ใช่ค่าที่ต่ำกว่า |
| การแก้โค้ดที่จะขึ้นโปรดักชันจริง | GPT-6 Sol ที่ $2 / $10 | AutomationBench 33.2% ที่ $0.27 ต่อ task |
| การตีความเป้าหมายที่คลุมเครือให้ Crew | GPT-6 Sol หรือ Astra ที่ $10 / $50 | ความผิดพลาดของหัวหน้าจะทวีคูณไปยังสมาชิกทุกตัว |
จดมันไว้เป็นกฎ ไม่ใช่ทำตามความเคยชิน โมเดลไหนเหมาะกับงานเขียนโค้ดแบบไหน ครอบคลุมเรื่องการเลือกเส้นทางไว้ครบถ้วน
ข้อควรระวังหนึ่งข้อในการอ่านตัวเลขส่วนต่างของ OpenAI: โพสต์เปิดตัวของบริษัทเทียบกับ Claude Opus 5 และ Anthropic ก็แทนที่ Opus 5 ด้วย Opus 5.5 ในอีกไม่กี่ชั่วโมงถัดมาในวันเดียวกัน การเปรียบเทียบ Luna ข้างต้นจึงเป็นการวัดเทียบกับโมเดลรุ่นก่อนของชื่อที่ระบุไว้
อะไรที่ Runtime ราคาถูกไม่ได้ทำให้ถูกลง
Luna ลดราคาของการผลิตการเปลี่ยนแปลง แต่ไม่ได้ทำอะไรกับราคาของการตอบรับมันเลย การรันถูก ๆ สิบครั้งให้ diff สิบชุด ผลทดสอบสิบชุด และการตัดสินใจสิบเรื่องที่คนเท่านั้นทำได้ และตัวเลขการใช้จ่ายของ OpenAI เองก็เป็นคำเตือนมากกว่าคำปลอบใจ เพราะรายงานว่านักวิจัยระดับมัธยฐานใช้จ่ายมากกว่า 600 ดอลลาร์ต่อวันกับ coding agent โดยที่เปอร์เซ็นไทล์ที่ 90 อยู่ที่ 7,000 ดอลลาร์ ต้นทุนต่อ task ที่ถูกลงคือวิธีที่บิลแบบนั้นก่อตัวขึ้น
พูดแบบตรงไปตรงมาแล้ว Runtime ราคาถูกคุ้มที่จะผูกก็ต่องานที่คนตรวจสอบได้อย่างรวดเร็ว และเป็นการประหยัดที่หลอกตัวเองเมื่อมันไปเพิ่มคิวหน้ารีวิวเวอร์ของคุณ ให้ context ความคืบหน้า อุปสรรค ผลลัพธ์ และการรีวิวโดยคนมองเห็นได้ตลอดทางตั้งแต่คำขอจนถึงการปล่อย และตัดสินใจเลือกเลนตอนมอบหมายงาน ไม่ใช่ตอนรีวิว การรีวิวโดยคนคือคอขวด มีมุมเรื่องการจัดตารางของเรื่องนี้อยู่
ถ้าคุณรัน coding agent หลายตัวอยู่แล้ว ลองเชื่อมต่อ Computer สักหนึ่งเครื่อง สร้าง Agent หนึ่งตัวบนเลนราคาถูก แล้วมอบงานน่าเบื่อ ๆ ให้มันสักงาน


