
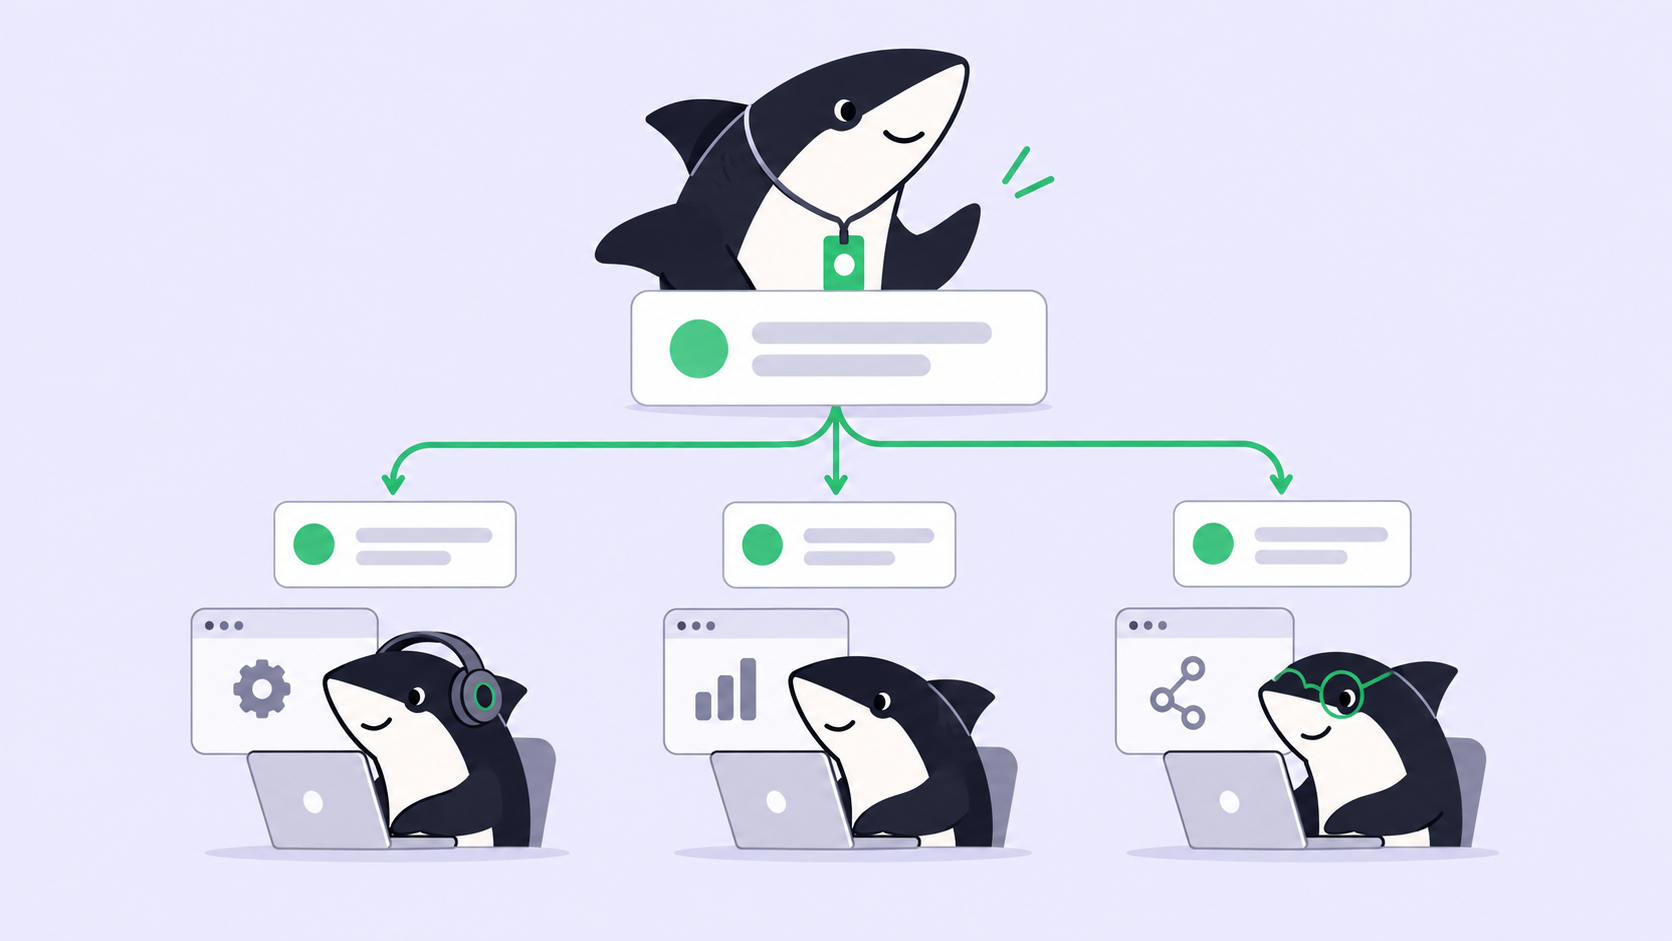
หัวหน้า Crew แทบจะไม่เขียนโค้ดเลย มันอ่าน Task ตัดสินใจว่าใครควรลงมือ พูดถึงสมาชิกที่ต้องการ รอ อ่านสิ่งที่ส่งกลับมา แล้วก็รวมมันเข้าด้วยกันหรือส่งกลับไป บน GPT-6 Astra ที่ราคา 10 ดอลลาร์ต่อล้านโทเค็นอินพุต และ 50 ดอลลาร์ต่อล้านโทเค็นเอาต์พุต Agent ที่ผลิตโค้ดน้อยที่สุดกลับมีอัตราค่าใช้จ่ายสูงที่สุดใน Crew
OpenAI เปิดตัว GPT-6 Sol เมื่อวันที่ 22 กันยายน 2026 ในราคา 2 ดอลลาร์ขาเข้า และ 10 ดอลลาร์ขาออก API id gpt-6-sol คิดเป็นหนึ่งในห้าของอัตรา Astra ทั้งสองขา นั่นไม่ได้ทำให้ Sol กลายเป็นโมเดลที่ฉลาดที่สุดที่มีให้ใช้ แต่มันทำให้ตำแหน่งผู้ประสานงานมีราคาถูกพอที่จะจัดคนนั่งได้ในทุก Crew ที่คุณรัน
เราเคยเสนอกรณีของ Astra ไว้ใน GPT-6 Astra ในฐานะหัวหน้า Crew ของคุณ: มอบตำแหน่งที่ตัดสินใจให้กับวิจารณญาณที่ดีที่สุดในทีม แล้วสมาชิกที่เหลือก็เป็นแค่คนธรรมดาได้ ข้อโต้แย้งนั้นยังใช้ได้ สิ่งที่เปลี่ยนไปคือราคาของการลงมือทำตามนั้น สิ่งที่ไม่เปลี่ยนคือคิวของงานที่เสร็จแล้วรอคนมากดรับ
สรุปสั้น ๆ
Crew คือกลุ่มของ People และ Agents ที่นำกลับมาใช้ใหม่ได้ โดยมี Agent หัวหน้าหนึ่งตัวคอยประสานงาน และการทำงานจะเริ่มจากหัวหน้าก่อน: หัวหน้าจะอ่านบริบทของ Task และคำสั่งของ Crew ก่อนที่สมาชิกคนใดจะเริ่ม ตำแหน่งนี้เน้นการอ่านเป็นหลัก และรันบ่อยกว่าหนึ่งครั้งต่อ Task ดังนั้นค่าใช้จ่ายจึงผูกกับการอ่าน ไม่ใช่การเขียน Sol ในราคา $2 / $10 พร้อมส่วนลด 90% สำหรับการอ่านอินพุตที่แคชไว้ ทำให้การมีหัวหน้าประจำทุก Crew เป็นเรื่องที่จ่ายไหว รักษา Astra หรือ Claude Opus 5.5 ไว้ในตำแหน่งนี้เมื่อตัว requirement เองยังคลุมเครือ Agents ค้นคว้า ลงมือ ทดสอบ และรายงาน People กำหนดทิศทาง มอบอำนาจ และรับผลลัพธ์
ตำแหน่งหัวหน้าใช้จ่ายอะไรจริง ๆ
เอกสาร Sharkly อธิบายการทำงานของ Crew ว่าเป็นลำดับที่ตายตัว หาก Task อยู่ในสถานะที่รันได้และหัวหน้าพร้อม Agent หัวหน้าจะเริ่มก่อน มันจะอ่านบริบทของ Task และคำสั่งของ Crew จากนั้นก็จัดการงานเองหรือพูดถึงสมาชิก Agent ที่มีสิทธิ์เพื่อขอผลงานเฉพาะด้าน ผลลัพธ์ของพวกเขาจะกลับมาที่ Task และหัวหน้าจะรวมสิ่งที่ส่งกลับมาเข้าด้วยกัน
มองสิ่งนี้ในรูปของรูปแบบการคิดค่าบริการ ทุกเทิร์นของหัวหน้าจะเริ่มด้วยการอ่าน: คำอธิบาย คอมเมนต์ตั้งแต่ครั้งล่าสุด คำสั่งของ Crew บทบาทที่มีให้ และอะไรก็ตามที่สมาชิกโพสต์ไว้ก่อนหน้า มันจบด้วยการเขียนการตัดสินใจสั้น ๆ หรือการพูดถึงใครสักคน เน้นอินพุต เบาเอาต์พุต ทำซ้ำไปเรื่อย ๆ
และตำแหน่งนี้ก็ยุ่งกว่าที่ทีมส่วนใหญ่คาดไว้ เพราะหัวหน้าไม่ได้รันแค่ครั้งเดียวต่อ Task บน Task ที่มอบหมายให้ Crew คอมเมนต์ธรรมดาที่เข้าเงื่อนไขจากสมาชิกก็สามารถเริ่มหัวหน้า Crew ได้ ภายใต้เงื่อนไขความพร้อมเดียวกันกับการรันอื่น ๆ Task ที่มีการพูดคุยคึกคักอยู่คือ Task ที่หัวหน้าได้อ่านเธรดหลายรอบแล้ว
| ผู้สมัครสำหรับตำแหน่งหัวหน้า | API id | อินพุต / เอาต์พุต ต่อ 1M | อินพุตที่แคชไว้ |
|---|---|---|---|
| GPT-6 Astra | ไม่ระบุ | $10 / $50 | ไม่ระบุ |
| Claude Opus 5.5 | claude-opus-5-5 |
$4 / $20 | อ่าน $0.20, เขียน $5 |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | ลด 90% สำหรับการอ่าน |
| GPT-6 Luna | gpt-6-luna |
$0.10 / $0.50 | ลด 90% สำหรับการอ่าน |
นี่คือเรต API ของผู้ให้บริการ และมันอยู่ตรงนี้เพื่อดูอัตราส่วนมากกว่าเพื่อดูใบแจ้งหนี้ การใช้งานโมเดลยังคงดำเนินต่อไปผ่านการสมัครสมาชิกหรือ API key ที่ตั้งค่าไว้ในเครื่องมือเขียนโค้ดของคุณ ดังนั้นสิ่งที่ทีมของคุณจ่ายจริงขึ้นอยู่กับแพ็กเกจที่เชื่อมต่อไว้
ต้นทุนต่อ Task ไม่ใช่ต้นทุนต่อโทเค็น
หัวหน้าที่อ่าน requirement ผิดจะทำให้เสียเวลาการรันของสมาชิกไปหนึ่งวัน ดังนั้นตารางราคาจึงไม่ใช่ที่ที่ควรใช้ตัดสินเรื่องนี้ OpenAI เผยแพร่ต้นทุนต่อ Task ควบคู่กับคะแนน ซึ่งใกล้เคียงกับคำถามจริงมากกว่า
| AutomationBench 1.0.6 ตามที่ OpenAI เผยแพร่ | คะแนน | ต้นทุนต่อ Task |
|---|---|---|
| GPT-6 Sol, ความพยายามสูงมาก | 33.2% | $0.27 |
| GPT-6 Astra, ความพยายามต่ำ | 30.3% | 3.9 เท่าของ Sol |
| Claude Opus 5, ความพยายามสูงสุด | 26.9% | 11.1 เท่าของ Sol |
บน Agents’ Last Exam V1 นั้น Sol ที่ความพยายามสูงสุดทำคะแนนได้ 56.4% สูงกว่าผลลัพธ์ที่ดีที่สุดของ Opus 5 ด้วยต้นทุนต่อ Task ที่ต่ำกว่า 60%
มีข้อกำกับตามตรงสามข้อก่อนที่คุณจะใช้ตารางนั้นเป็นเหตุผลในการจ่ายเงินอะไรก็ตาม หนึ่ง นี่คือการรัน benchmark ของ Agent ทั้งตัว ไม่ใช่การรันของหัวหน้า ไม่มีใครเผยแพร่ตัวเลขต้นทุนของการประสานงาน และค่าใช้จ่ายจริงของหัวหน้าคุณขึ้นอยู่กับว่า Task ของคุณช่างคุยมากแค่ไหน สอง แถวของ Astra อยู่ที่ความพยายามในการใช้เหตุผลระดับต่ำ ซึ่งเป็นจุดเปรียบเทียบที่ OpenAI เลือกเอง ไม่ใช่ Astra ที่ทำงานหนัก สาม OpenAI ระบุตรง ๆ ว่า Astra "ยังคงเป็นโมเดลที่ดีที่สุดของเราครอบคลุมทุกด้าน" ขณะที่ Artificial Analysis ซึ่งเป็นบุคคลที่สาม ให้ดัชนีความฉลาดของ Sol อยู่ที่ 48 เทียบกับ 58 ของ Claude Opus 5.5 Sol ไม่ใช่โมเดลที่แข็งแกร่งที่สุดที่คุณจะเอามานั่งในตำแหน่งนี้ได้ แต่มันคือโมเดลที่แข็งแกร่งที่สุดที่คุณจ่ายไหวที่จะปล่อยให้นั่งอยู่ในตำแหน่งนี้ในทุก Crew
การแคชคือส่วนลดที่เจาะจงสำหรับตำแหน่งหัวหน้าโดยเฉพาะ
GPT-6 เพิ่มอัตราการแคชฮิตโดยค่าเริ่มต้น และลดราคาการอ่านอินพุตที่แคชไว้ 90% มีสองการเปลี่ยนแปลงที่สำคัญกับหัวหน้ามากกว่าสมาชิก: การเปลี่ยนระดับความพยายามในการใช้เหตุผลหรือชุดเครื่องมือที่ใช้ได้จะไม่ทำให้แคชเสียอีกต่อไป และ breakpoint แบบระบุชัดเจนช่วยให้คุณเลือกได้ว่า prefix ที่แคชไว้จะสิ้นสุดตรงไหน OpenAI อ้างว่า GitHub มีโทเค็นพรอมป์ที่ต้องประมวลผลใหม่ลดลงมากกว่า 50% ทั่วคำขอหลายพันล้านครั้ง
หัวหน้าคือตัวการที่แย่ที่สุดในเรื่องการส่งบริบทซ้ำใน Crew มันอ่านคำสั่ง Crew เดิม ๆ ธรรมเนียมของ repository เดิม ๆ และเธรด Task ที่ยาวขึ้นเรื่อย ๆ ในทุกเทิร์น และ prefix นั้นแทบจะเหมือนเดิมทุกครั้ง นั่นคือรูปแบบที่ cached prefix ถูกออกแบบมาเพื่อรองรับพอดี การตั้งค่าอยู่ใน Runtime บน Computer ไม่ใช่บน Agent โดย วิธีรัน agent GPT-6 Sol ใน Sharkly อธิบายว่าควรวางไว้ตรงไหน
เมื่อไหร่ที่ Astra หรือ Opus 5.5 ควรนั่งตำแหน่งนี้ต่อ
ใช้ Sol เป็นหัวหน้าเมื่อ Crew ต้องจัดการ Task ที่มีขอบเขตชัดเจนจำนวนมากต่อวัน บทบาทคงที่ และวิจารณญาณส่วนใหญ่สามารถเขียนลงในคำสั่งของ Crew ได้แทนที่จะต้องคิดใหม่ทุกครั้งที่รัน รักษาโมเดลที่แพงกว่าไว้ในตำแหน่งนี้เมื่อตัว requirement เองคลุมเครือ เมื่อการตีความผิดจะทำให้สมาชิกสามคนเดินผิดทาง หรือเมื่อ Task เป็นงานชิ้นยาวชิ้นเดียวแทนที่จะเป็นงานสั้น ๆ หลายชิ้น
หัวหน้าที่ถูกกว่าไม่ใช่เหตุผลที่จะเอา Crew ไปทำงานที่ Agent ตัวเดียวทำได้ เอกสารระบุตรง ๆ ว่า: สำหรับงานชิ้นเล็กที่นิยามไว้ดีแล้ว ให้มอบหมาย Task ให้ Agent ตัวเดียวโดยตรง ใช้ Crew เมื่อหัวหน้าจำเป็นต้องตีความเป้าหมาย ให้สมาชิก Agent คนอื่นเข้ามาเกี่ยวข้อง และนำผลลัพธ์ของพวกเขากลับมารวมใน Task เดียว การแก้ไฟล์เดียวที่ส่งผ่าน Crew จะต้องจ่ายค่าการประสานงานหนึ่งรอบที่มันไม่เคยจำเป็นต้องมี ไม่ว่าจะในเรตไหน
การเปลี่ยนโมเดลของหัวหน้าก็ไม่เปลี่ยนอะไรในเรื่องความเป็นเจ้าของ Owner เป็นผู้จัดการ Crew ส่วนหัวหน้าเป็นผู้ประสานการลงมือทำ
การเขียนวิจารณญาณลงไปคือสิ่งที่ทำให้ตำแหน่งที่ถูกกว่านี้ใช้งานได้จริง:
You lead this Crew. Read the Task and the comments added since your
last turn, then pick the smallest set of members that can finish it.
Mention @backend for API and job changes, @tests for coverage,
@docs for user-facing pages.
Ask a person only when two readings of the requirement would produce
different designs. Otherwise state your assumption and proceed.
Combine member results into one summary: what changed, what you ran,
what failed, what you did not cover. Leave acceptance to a person.
มีข้อสังเกตเชิงปฏิบัติหนึ่งข้อก่อนที่คุณจะไว้ใจเทิร์นยาว ๆ ของหัวหน้า Artificial Analysis วัดได้ 102.15 วินาทีถึงโทเค็นแรกสำหรับตัวแปรการใช้เหตุผลสูงสุดของ GPT-6 Sol ซึ่งเป็นตัวเลขจากบุคคลที่สามสำหรับการตั้งค่าความพยายามสูงสุด ไม่ใช่จากผู้ให้บริการ [VERIFY] ทั้ง Crew ต้องรอเทิร์นแรกของหัวหน้า ดังนั้นหัวหน้าที่กำลังคิดอยู่กับหัวหน้าที่ค้างไปแล้วจะดูเหมือนกันจนกว่าจะมีสถานะบอกเป็นอย่างอื่น
ใบแจ้งหนี้ที่ยังไม่ขยับ
OpenAI รายงานว่านักวิจัยค่ามัธยฐานของบริษัทใช้จ่ายมากกว่า $600 ต่อวันกับ coding agent และเปอร์เซ็นไทล์ที่ 90 ใช้จ่าย $7,000 ที่เรตของ Sol ทีมที่เคยต้องจำกัดการรัน Crew ตอนนี้จ่ายไหวที่จะรันมากขึ้นหลายเท่า และทุกครั้งก็จบลงที่ผลลัพธ์ที่ต้องมีคนอ่าน
นั่นคือข้อจำกัดที่การลดราคาทำให้แย่ลงมากกว่าดีขึ้น การประสานงานที่ถูกกว่าซื้องานขนานกันมากขึ้น diff มากขึ้น และการตัดสินใจต่อสัปดาห์มากขึ้น เมื่อเทียบกับกำลังการรีวิวที่วัดกันเป็นชั่วโมงคนซึ่งไม่ได้เปลี่ยนไปเมื่อวันที่ 22 กันยายน 2026 Agents ค้นคว้า ลงมือ ทดสอบ และรายงาน People กำหนดทิศทาง มอบอำนาจ และรับผลลัพธ์ ระบบอัตโนมัติหยุดตรงจุดที่ต้องใช้วิจารณญาณของทีม
ซึ่งเป็นเหตุผลว่าทำไมเอาต์พุตของหัวหน้าจึงสำคัญกว่าเรตของมัน การรันของหัวหน้าที่จบลงเป็นข้อความให้เลื่อนอ่านย้อนหลังนั้นไร้ค่าไม่ว่าจะ $0.27 หรือ $3 การรันของหัวหน้าที่คืนแผน ผลลัพธ์ของสมาชิก การตรวจสอบ ความล้มเหลว และคำถามที่ยังค้างอยู่กลับไปใน Task เดียว คือสิ่งที่ทำให้คนรับงานได้ในไม่กี่นาทีแทนที่จะต้องนั่งประกอบมันขึ้นมาใหม่ รักษาบริบท ความคืบหน้า อุปสรรค ผลลัพธ์ และการรีวิวโดยคนให้มองเห็นได้ตั้งแต่คำขอจนถึงการปล่อยงาน แล้วตำแหน่งที่ถูกกว่านี้จะกลายเป็นกำลังผลิตแทนที่จะเป็นงานค้าง
สิ่งที่ควรเปลี่ยนในสัปดาห์นี้
- เลือก Crew หนึ่งตัวที่มีหัวหน้าแพง ๆ แล้วชี้ Runtime ของมันไปที่
gpt-6-solบน Computer เครื่องนั้น - ย้ายวิจารณญาณที่คุณเคยจ่ายให้หัวหน้าคิดสด ๆ ไปไว้ในคำสั่งของ Crew เป็นลายลักษณ์อักษร
- รัน Sprint หนึ่งรอบ แล้วเทียบตัวเลขสองตัวกับรอบก่อนหน้า: Task ที่เสร็จ และ Task ที่ถูกส่งกลับหลังรีวิว ถ้าตัวเลขส่งกลับเพิ่มขึ้น แสดงว่าตำแหน่งเดิมทำหน้าที่มากกว่าที่คุณคิด
ถ้าคุณรัน agent หลายตัวอยู่แล้ว Sharkly มอบที่เดียวให้คุณจัดการงานและผลลัพธ์ของพวกมัน


