
คุณกำลังพยายามตัดสินใจว่าจะไว้ใจ coding agent ตัวไหนให้ทำงานจริง: Claude Code, Codex, Gemini CLI, OpenCode หรือใช้สองตัวพร้อมกัน คุณจึงไปอ่านคะแนน benchmark ตัวหนึ่งแก้โจทย์ชุดสาธารณะได้ 68% อีกตัว 71% แล้วคุณก็ต้องเลือกจากตัวเลขนั้น แต่พอ agent เข้ามาใน repository ของคุณจริง ๆ กลับติดอยู่ที่ขั้นตอน build ที่ไม่มีชุดข้อมูลสาธารณะใดเคยเห็นมาก่อน
Benchmark วัดปัญหาชุดหนึ่งที่ตายตัวและใช้ร่วมกัน ส่วน codebase ของคุณคือชุดปัญหาส่วนตัว: ธรรมเนียมการเขียนโค้ดของคุณ โครงสร้าง monorepo ของคุณ เทสต์ที่ล้มบ้างไม่ล้มบ้างซึ่งทุกคนมองข้าม สคริปต์ deploy ที่มีคนเดียวที่เข้าใจ คะแนนที่ตัดสินสัปดาห์ของคุณคือคะแนนที่คุณสร้างขึ้นบนโค้ดนั้น ไม่ใช่คะแนนที่ห้องแล็บประกาศออกมา คู่มือนี้จะพาคุณไปรู้จักวิธีการเปรียบเทียบ coding agent บนซอฟต์แวร์ที่คุณส่งมอบจริง และวิธีรันการเปรียบเทียบนั้นโดยไม่ต้องเปิดห้าเทอร์มินัลเพื่อแยก agent ออกจากกัน
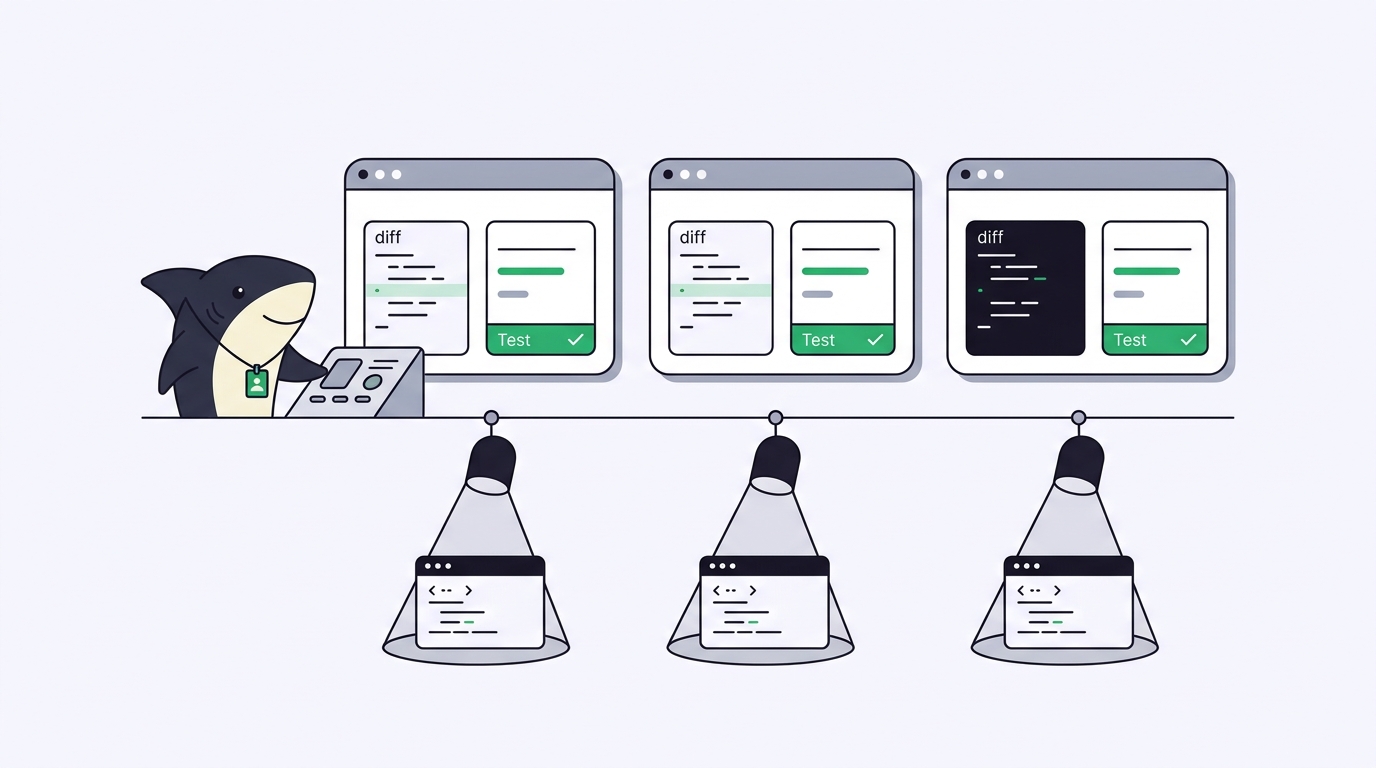
Sharkly คือที่ที่วิธีการนี้ลงตัว Sharkly เป็นแพลตฟอร์มสั่งการและจัดการ Agent แบบครบวงจร: คุณเชื่อมต่อ Computer ของตัวเอง มอบหมาย Task เดียวกันให้ Agent ต่าง ๆ และทุกครั้งที่รันจะคืนค่า diff, ผลลัพธ์เทสต์ และรีวิวกลับมาที่จุดเดียว นั่นคือสิ่งที่ทำให้การเปรียบเทียบอย่างเป็นธรรมเป็นไปได้ ตัวแปรที่คุณต้องการวัดคือ agent ไม่ใช่การ juggle เทอร์มินัลที่คุณต้องทำเพื่อไม่ให้สามรันรบกวนกัน
คะแนน benchmark วัดชุดข้อมูล ไม่ได้วัด repository ของคุณ
coding-agent benchmark คือชุดทดสอบสาธารณะที่ตายตัวและให้คะแนนเหมือนกันทุกคน นั่นแหละคือสิ่งที่ทำให้มันมีประโยชน์สำหรับห้องแล็บที่สร้างโมเดล และก็คือสิ่งที่ทำให้มันเป็นตัวพยากรณ์ที่อ่อนสำหรับคุณ
benchmark สาธารณะอย่าง SWE-bench ดึงโจทย์มาจากโปรเจกต์โอเพนซอร์สที่รู้จักกันดี พร้อม harness ที่ปรับแต่งไว้และการตรวจรับที่คัดสรรแล้ว ไม่มีข้อใดเลยที่อธิบายวันอังคารของคุณได้ สิ่งที่ตัดสินว่า agent จะทำงานบนโค้ดของคุณได้ดีแค่ไหนคือสิ่งที่ชุดข้อมูลสาธารณะไม่มีทางมี: ไลบรารีภายในที่โมเดลไม่เคยอ่าน, lint config ของคุณ, ไฟล์ context 400 บรรทัดที่อธิบายว่าบริการนี้บูตจริง ๆ อย่างไร, โมดูลหนึ่งที่ไม่มีเทสต์เลย
คะแนน benchmark สูงไม่ได้พยากรณ์ว่า agent จะทำงานอย่างไรใน repository ของคุณ มันพยากรณ์ว่า agent จะทำงานอย่างไรใน repository ของคนอื่น มอง leaderboard เป็นตัวกรองคร่าว ๆ ว่า agent ตัวไหนน่าลอง แล้วไปทำการทดสอบที่สำคัญจริง ๆ ถ้าคุณยังเลือกอยู่ว่าจะให้ agent แต่ละตัวใช้โมเดลไหน การจับคู่โมเดลกับบทบาทของ agent เป็นคำถามเริ่มต้นที่ดีกว่าคะแนนดิบ
เลือกงานจริงหนึ่งงาน ไม่ใช่ prompt เล่น ๆ
เริ่มจากการเปรียบเทียบที่เล็กที่สุดและมีประโยชน์ อย่า benchmark agent ด้วยโจทย์ "สร้างแอป todo" ให้เลือก requirement จริงหนึ่งอย่างจาก backlog ของคุณ: บั๊กที่จำกัดขอบเขต, ฟีเจอร์เล็ก ๆ บนโมดูลเดียว, migration ที่คุณจะทำอยู่แล้ว อะไรก็ได้ที่มี acceptance test ให้รันได้และมี diff ให้อ่านในไม่กี่นาที
จากนั้นให้ input ที่เหมือนกันทุกประการกับทุก agent: คำอธิบายงานเดียวกัน, starting commit เดียวกัน, acceptance criteria เดียวกัน เขียนออกมาแบบที่ tracker ของคุณจะเขียน งานอย่าง SH-312: แก้ปัญหา timezone drift ใน invoice export ถ้า agent ตัวหนึ่งได้ prompt ที่ละเอียดกว่าอีกตัว คุณกำลังวัด prompt ของคุณ ไม่ใช่ agent
ใช้ bug fix เมื่อคุณอยากเห็นว่า agent อ่านโค้ดที่มีอยู่แล้วอย่างไรและอยู่ภายในกรอบหรือไม่ ใช้ฟีเจอร์เล็ก ๆ เมื่อคุณอยากเห็นว่ามันจัดโครงสร้างโค้ดใหม่อย่างไรและเขียนเทสต์เองหรือเปล่า รันทั้งสองแบบเรื่อย ๆ เพราะงานเดียวก็บอกได้แค่เรื่องงานเดียวนั้น
เปรียบเทียบทุก agent ตอนที่ดีที่สุด ไม่ใช่ตอนที่แย่ที่สุด
agent แต่ละตัวมี setup ที่มันทำงานได้แข็งที่สุด: โมเดลที่ใช่ ไฟล์ context ที่ใช่ สิทธิ์ที่มันต้องการจริง ๆ ให้ CLAUDE.md แก่ Claude Code ให้ config แก่ Codex ให้แต่ละ Runtime สภาพแวดล้อมที่เอกสารของมันแนะนำ การเปรียบเทียบ agent ที่ตั้งค่าดีกับ agent เปล่า ๆ ไม่ได้บอกอะไรนอกจากว่าคุณขยันตั้งค่าตัวไหน
การรันพวกมันตอนที่ดีที่สุด เทียบกันแบบ side by side คือจุดที่วิธีใช้เทอร์มินัลพังทลาย บน Sharkly คุณมอบหมาย Task เดียวกันให้แต่ละ Agent และแต่ละ Agent รันบน Computer ที่เชื่อมต่อไว้ใน worktree ที่แยกออกจากกัน สาม agent ที่แก้ repository เดียวกันจะไม่แตะไฟล์ของกันและกัน คุณจะได้สามความพยายามที่สะอาดต่อปัญหาเดียวกัน แทนที่จะเป็น working tree ที่ใช้ร่วมกันและ merge ที่คุณต้องแกะด้วยมือ ถ้าคุณเคยทำแบบนี้ด้วยตัวเองมาก่อน การรัน agent หลายตัวพร้อมกัน คือส่วนที่ Sharkly ถูกสร้างมาช่วยให้คุณไม่ต้องแบก
ถ้าคุณใช้ agent ตัวเดียวและอยู่แต่ในเทอร์มินัล Claude Code session เดียวที่ตั้งค่าดี ๆ ใน worktree ก็เพียงพอ และคุณอาจไม่จำเป็นต้องใช้สิ่งนี้เลย สมการจะเปลี่ยนทันทีที่คุณเปรียบเทียบ agent สองตัวขึ้นไป ข้ามงานมากกว่าหนึ่งงาน และต้องการผลลัพธ์ในรูปแบบที่อ่านเทียบกันได้จริง
ห้าเกณฑ์ที่ชี้ขาดในงานจริง
benchmark ให้คะแนนแค่ตัวเลขเดียว: งานผ่านหรือไม่ แต่งานจริงตัดสินด้วยห้าสิ่งที่ตัวเลขนั้นมองข้ามไป
| เกณฑ์ | คำถามที่มันตอบ |
|---|---|
| การรันแบบขนาน | ฉันรัน agent หลายตัวบนงานเดียวกันพร้อมกัน แยกออกจากกัน โดยไม่ชนกันได้ไหม? |
| การมองเห็นของทีม | คนอื่นนอกจากฉันเห็นได้ไหมว่า agent แต่ละตัวทำอะไรและทำไม? |
| ขั้นตอนรีวิว | ฉันอ่าน diff, เทสต์ และข้อจำกัดที่รู้แล้ว แล้วตัดสินรับหรือปฏิเสธได้เร็วแค่ไหน? |
| รันบนเครื่องตัวเอง | agent รันบน Computer ของฉัน เทียบกับสภาพแวดล้อมจริงและ secrets จริงของฉันไหม? |
| การเชื่อมต่อ | ผลลัพธ์ไปถึง tracker, repo และเครื่องมือรีวิวที่เราใช้อยู่แล้วไหม? |
สี่ข้อแรกคือจุดที่ agent ส่วนใหญ่ดูเหมือนกันใน benchmark แต่กลับทำงานไม่เหมือนกันเลยบนโค้ดของคุณ การรันบนเครื่องตัวเองเป็นสิ่งที่มองไม่เห็นในเทสต์สาธารณะโดยเฉพาะ: agent ที่รันกับ toolchain จริงของคุณ ฐานข้อมูลในเครื่องของคุณ CI hook จริงของคุณ กำลังถูกทดสอบบนสิ่งที่คุณส่งมอบ ไม่ใช่ sandbox ที่คล้าย ๆ กัน
Agent ค้นคว้า ลงมือ ทำการทดสอบ และรายงาน ส่วนคุณกำหนดทิศทาง มอบอำนาจ และรับผลลัพธ์ การเปรียบเทียบจะซื่อสัตย์ได้ก็ต่อเมื่อคุณเห็นทุกส่วนของกระบวนการนั้น สำหรับทุก agent โดยไม่ต้องประกอบขึ้นใหม่จาก scrollback
ให้คะแนนสิ่งที่ส่งกลับมา ไม่ใช่สิ่งที่ agent อ้าง
agent ที่พิมพ์คำว่า "เสร็จแล้ว" ไม่เหมือนกับการเปลี่ยนแปลงที่ผ่านเทสต์ ให้คะแนนแต่ละรันจากสิ่งที่ส่งกลับมา ไม่ใช่จากสิ่งที่มันอ้าง สำหรับทุกครั้งที่ลอง หลักฐานที่มีประโยชน์คือรายการสั้น ๆ เดียวกัน: diff, ผลลัพธ์ typecheck และเทสต์, สรุปการเปลี่ยนแปลง และข้อจำกัดที่ agent ยอมรับ Sharkly ทำให้ context, ความคืบหน้า, อุปสรรค, ผลลัพธ์ และการรีวิวโดยมนุษย์มองเห็นได้ตั้งแต่ request จนถึง release การเปรียบเทียบจึงอ่านออกมาเหมือนตารางผลลัพธ์ แทนที่จะเป็นห้าเทอร์มินัลที่คุณต้องคอยจำ
นี่ก็เป็นจุดที่คอขวดจริงโผล่ขึ้นมา agent สองตัวอาจ "ทำงานเสร็จ" ในยี่สิบนาทีเหมือนกัน และยังทำให้คุณเสียเวลารีวิวตัวละชั่วโมงได้ การรีวิวมักเป็นข้อจำกัดที่แท้จริงของปริมาณงานขนานที่ทีมรับได้ และมันควรมีน้ำหนักมากในการเลือกว่า agent ตัวไหนจะเลือก น้ำหนักที่ให้ขึ้นอยู่กับว่าใครเป็นคนเลือก:
| เลือกให้ | ให้ความสำคัญสูงสุดกับ |
|---|---|
| นักพัฒนาคนเดียว | ขั้นตอนรีวิวและการรันบนเครื่องตัวเอง เพราะคุณเป็นคนรีวิวคนเดียว |
| ทีมเล็ก | การรันแบบขนานและการมองเห็นของทีม เพราะหลายคนต้องเห็นรันเดียวกัน |
| ทีมแพลตฟอร์ม | การเชื่อมต่อและการมองเห็น เพราะ workflow ต้องอยู่รอดผ่าน agent ตัวที่ดีที่สุดตัวต่อไป |
แถวสุดท้ายนั่นแหละคือเหตุผลของการเปรียบเทียบทั้งหมด agent ที่ดีที่สุดวันนี้อาจไม่ใช่ agent ที่ดีที่สุดในไตรมาสหน้า และการสร้าง workflow ใหม่ทุกครั้งที่ leader เปลี่ยนก็เป็นภาษีของมันเอง Sharkly ไม่ใช่ coding agent และไม่ใช่ benchmark harness แต่มันคือ layer ที่ให้คุณทดสอบ agent กับโค้ดของตัวเองต่อไปได้โดยไม่ต้องสร้างกระบวนการใหม่รอบ ๆ agent ทุกครั้ง
ถ้าคุณอยากใช้ coding agent หลายตัวต่อไปแทนที่จะผูกตัวเองกับ ecosystem เดียว นั่นคือปัญหาที่ Sharkly ถูกออกแบบมาเพื่อแก้ ดาวน์โหลด Sharkly เชื่อมต่อ Computer หนึ่งเครื่อง แล้วมอบหมายงานจริงเดียวกันให้ agent สองตัว การเปรียบเทียบที่คุณได้กลับมาจะเกี่ยวกับ codebase ของคุณ ซึ่งเป็นสิ่งเดียวที่พยากรณ์สัปดาห์ของคุณได้


