
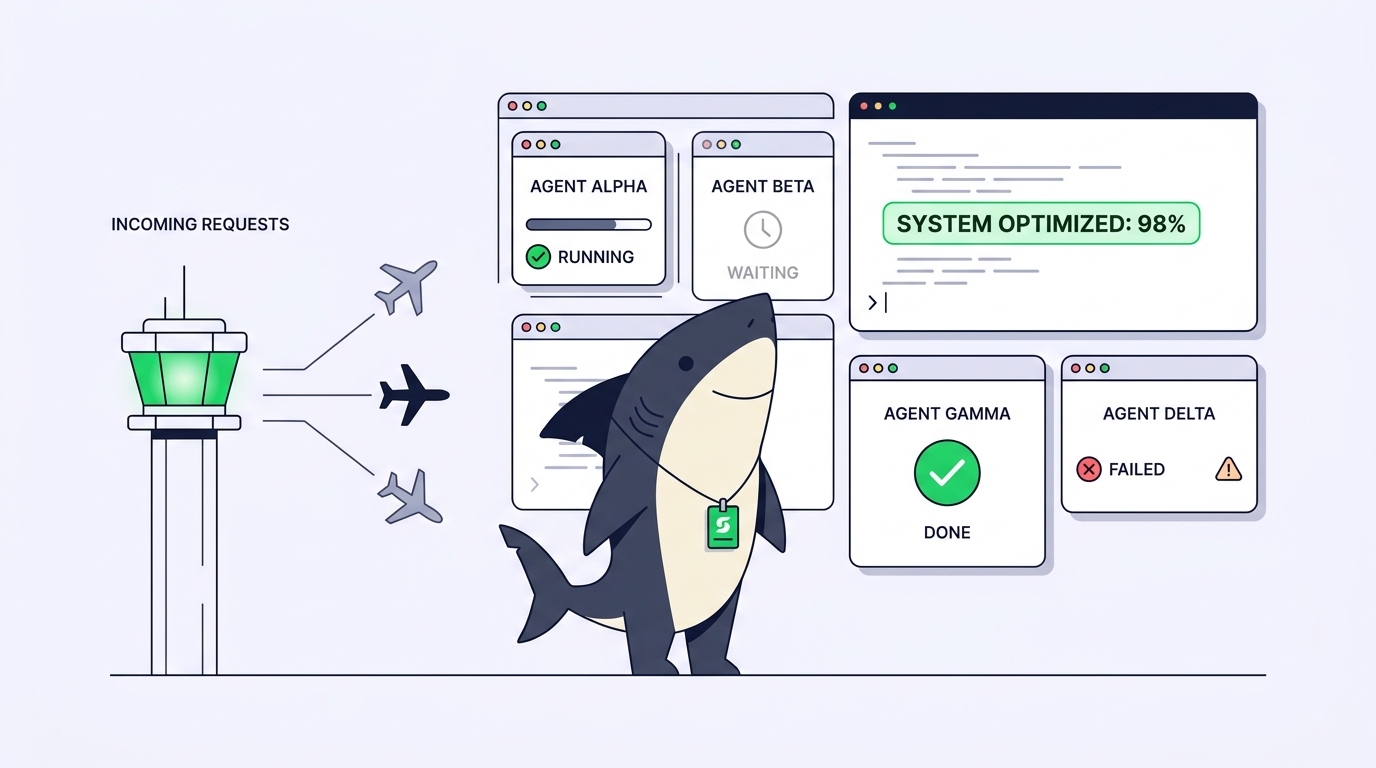
เมื่อเช้านี้คุณเริ่มรัน coding agent ไปสามตัว ตัวหนึ่งกำลัง refactor โมดูลระบบล็อกอิน (auth module) อีกตัวกำลังเขียน test ส่วนอีกตัวกำลังไล่แก้ปัญหา flaky CI job ผ่านไปหนึ่งชั่วโมง คุณเปิดเทอร์มินัลค้างไว้ถึงห้าหน้าต่าง tmux pane แยกออกมาอีกสองหน้าต่าง พร้อมความรู้สึกค้างคาใจลึก ๆ ว่าต้องมีอย่างน้อยตัวหนึ่งที่หยุดทำงานไปนานแล้ว และนั่งเฉย ๆ อยู่ตอนที่คุณไม่ได้ดู คุณได้แต่สลับหน้าจอ (alt-tab) ไถอ่านล็อก แล้วก็เดาเอา
การที่ต้องคอยเดานี่แหละคือต้นทุนที่แท้จริงของการรัน agent แบบขนานกัน การสั่งเปิด coding agent หลาย ๆ ตัวพร้อมกันในตอนนี้นั้นเป็นเรื่องง่าย แต่การจะรู้ว่าตัวไหนต้องการคุณ ตัวไหนติดปัญหา และตัวไหนทำงานเสร็จไปเงียบ ๆ ต่างหากที่กลืนเวลาช่วงบ่ายของคุณไปจนหมด การมอนิเตอร์ coding agent ที่รันพร้อมกันนั้น หมายถึงการตอบคำถามแบบเรียลไทม์ 4 ข้อนี้ให้ได้โดยไม่ต้องคอยเปิดถึงห้าหน้าต่าง ได้แก่ แต่ละตัวกำลังทำอะไรอยู่, คืบหน้าไปถึงไหนแล้ว, มีอะไรติดขัดอยู่หรือไม่, และมีผลลัพธ์อะไรที่ส่งกลับมาให้รีวิวบ้าง
คู่มือนี้จะพาคุณไปดูวิธีตั้งค่าการมอนิเตอร์แบบทำเอง (DIY) ก่อน พร้อมชี้ให้เห็นจุดบกพร่อง (failure mode) ในแต่ละขั้นตอน จากนั้นจะแสดงให้เห็นว่าเมื่อใดที่วิธีนี้เริ่มรองรับไม่ไหว และเลเยอร์จัดการงานส่วนกลาง (shared task layer) จะเข้ามาช่วยเติมเต็มอะไรได้บ้าง เลเยอร์ส่วนกลางดังกล่าวก็คือ Sharkly ซึ่งจะเข้ามาเปลี่ยน coding agent ที่คุณมีอยู่แล้วให้กลายเป็นทีมเวิร์ก โดยรวมความคืบหน้า ปัญหาที่ติดขัด และผลลัพธ์ของ agent ทุกตัวมาไว้ในที่เดียวให้เห็นชัดเจน แทนที่จะกระจัดกระจายอยู่ตามเทอร์มินัลต่าง ๆ จริงอยู่ที่คุณสามารถสร้างระบบมอนิเตอร์ส่วนใหญ่ขึ้นมาเองได้ แต่จุดประสงค์ของการเปรียบเทียบทั้งสองวิธีนี้คือ เพื่อให้รู้ว่าเมื่อถึงจุดไหน การสร้างระบบขึ้นมาเองจะเริ่มกินแรงและเสียเวลามากกว่าความคุ้มค่าที่ได้กลับมา
4 สัญญาณสำคัญที่คุณควรจับตามอง
การมอนิเตอร์ไม่ใช่เรื่องที่มีแค่แง่มุมเดียว เวลาคนบอกว่า agent กำลังรันอยู่ “ดูปกติดี” มักจะหมายถึงหนึ่งใน 4 สัญญาณที่แยกจากกัน ซึ่งแต่ละสัญญาณก็มีรูปแบบการล้มเหลวที่ต่างกันออกไป
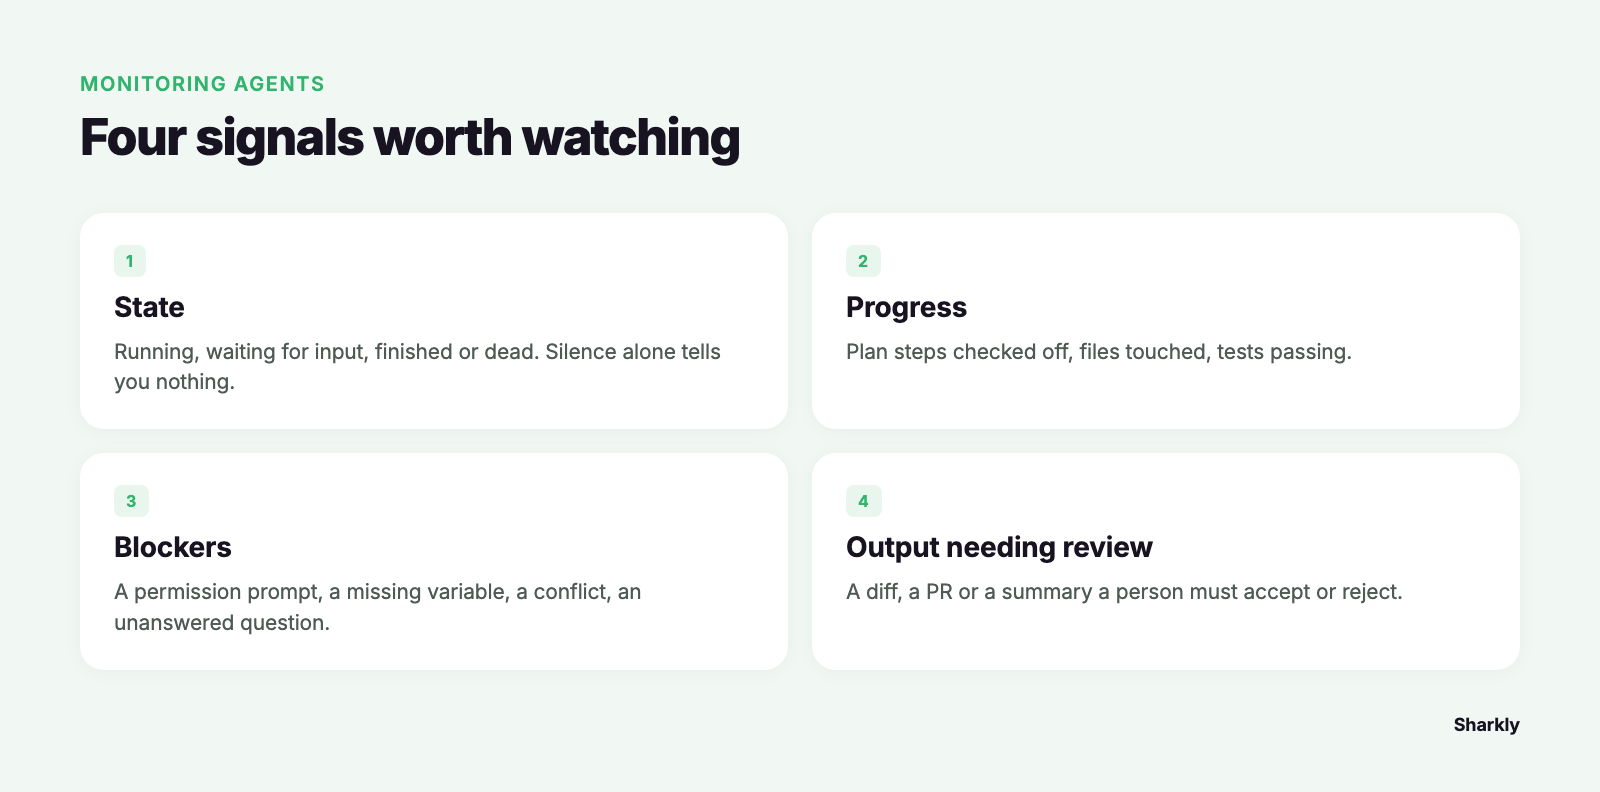
- สถานะ (State): โพรเซสกำลังทำงาน, รอรับอินพุต, ทำงานเสร็จแล้ว หรือตายไปแล้ว? agent ที่ทำงานเสร็จแล้วกับ agent ที่ค้างอยู่ต่างก็ไม่แสดงผลลัพธ์ใหม่ใด ๆ ออกมาทั้งคู่ ดังนั้นความเงียบจึงไม่สามารถบอกอะไรคุณได้เลยในตัวมันเอง
- ความคืบหน้า (Progress): งานเสร็จไปแค่ไหนแล้ว? ขั้นตอนในแผนที่ถูกติ๊กถูก, ไฟล์ที่ถูกแก้ไข, test ที่ผ่าน ความคืบหน้าคือสิ่งที่จะบอกคุณว่า agent ที่กำลังรันอยู่นั้นกำลังเดินหน้าไปจริง ๆ ไม่ใช่แค่วนลูป
- ตัวบล็อก (Blockers): agent กำลังรออะไรอยู่? ข้อความขอสิทธิ์ (permission prompt), environment variable ที่หายไป, merge conflict หรือคำถามที่มันถามทิ้งไว้แล้วยังไม่มีใครตอบ
- ผลลัพธ์ที่รอการรีวิว (Output needing review): agent สร้างอะไรออกมาบ้างที่มนุษย์ต้องตรวจรับหรือปฏิเสธ? ไม่ว่าจะเป็น diff, PR หรือสรุปรายการเปลี่ยนแปลง
หากดูแค่สถานะ คุณจะมองไม่เห็น agent ที่ยังรันอยู่แต่ติดอยู่ใน retry loop หากดูแค่ความคืบหน้า คุณจะมองไม่เห็นตัวที่ทำงานเสร็จไปตั้งแต่ยี่สิบนาทีที่แล้ว ระบบมอนิเตอร์ที่ดีจึงต้องแสดงทั้ง 4 สัญญาณนี้ของ agent ทุกตัวให้เห็นได้ในพริบตาเดียว
ขั้นตอนที่ 1: มอนิเตอร์แบบ DIY และช่องโหว่ของแต่ละขั้นตอน
การเซ็ตอัปแบบทำเองจะใช้เครื่องมือที่คุณมีอยู่แล้ว นี่คือข้อเท็จจริงตามตรง พร้อมช่องโหว่ที่แต่ละขั้นตอนทิ้งเอาไว้
ดูว่ามีอะไรกำลังรันอยู่บ้าง: หาก agent แต่ละตัวรันอยู่ใน git worktree ของตัวเอง ให้เรียกดูรายการ worktree และ branch ของแต่ละตัว:
git worktree list
tmux ls   # if each agent runs in a tmux session
จุดบกพร่อง (Failure mode): วิธีนี้บอกได้เพียงว่ามี session อยู่จริง แต่ไม่สามารถบอกได้ว่า agent ที่อยู่ข้างในกำลังทำงานหรือกำลังรออะไรอยู่ tmux pane ที่ติดอยู่ตรง prompt ถามว่า Continue? (y/n) จะดูเหมือนกับ pane ที่กำลังทำงานอยู่ตรงกลางคันทุกประการ คุณจะรู้ได้ก็ต่อเมื่อสั่ง attach เข้าไปดูเท่านั้น
ติดตามความคืบหน้า: ใช้คำสั่ง tail เพื่อดูผลลัพธ์ของแต่ละ agent และคอย poll ดูการเปลี่ยนแปลงใน worktree:
tail -f /path/to/agent-1.log
watch -n 5 'git -C ../wt-auth status --short'
จุดบกพร่อง (Failure mode): ภาระการดูจะเพิ่มขึ้นเป็นเส้นตรงตามจำนวน agent การอ่านล็อก 3 ตัวพร้อมกันยังพอไหว แต่การอ่าน tail ของล็อก 6 ตัวที่สลับกันขึ้นมานั้นเป็นไปไม่ได้เลย และลูปคำสั่ง watch ก็บอกได้แค่ว่าไฟล์มีการขยับเขยื้อน (file churn) แต่ไม่ได้บอกความหมาย คุณอาจเห็นไฟล์กำลังถูกแก้ไข โดยที่ไม่รู้เลยว่าสิ่งที่แก้นั้นถูกต้องหรือไม่ หรือ agent กำลังทำงานซ้ำซากอยู่ที่เดิมหรือเปล่า
ดักจับตอนทำงานเสร็จ: ครอบคำสั่งของแต่ละ agent ไว้ เพื่อให้ส่งการแจ้งเตือนมาหาคุณเมื่อโพรเซสทำงานจบ:
your-agent-command "$TASK"; \
  curl -s -X POST "$WEBHOOK_URL" -d "agent-1 exited $?"
จุดบกพร่อง (Failure mode): exit code 0 หมายถึงโพรเซสสิ้นสุดการทำงานลงเท่านั้น ไม่ได้แปลว่างานออกมาดี หรือทำเสร็จเรียบร้อยแล้วจริง ๆ agent จำนวนมากจบการทำงานได้อย่างราบรื่นหลังจากทิ้งคำถามไว้ที่คุณไม่เคยเห็น การแจ้งเตือนว่า "เสร็จแล้ว" จะทำให้คุณเผลอไปเชื่อสัญญาณที่ไม่ได้แปลว่างานเสร็จจริง ๆ
ตรวจจับข้อขัดแย้ง: เมื่อ agent หลายตัวใช้ repository เดียวกันร่วมกัน เวิร์กทรีจะช่วยแยก working directory ของแต่ละตัวออกจากกันก็จริง แต่ถ้า agent สองตัวแก้ไขไฟล์เดียวกันในสอง branch โค้ดก็ยังคงชนกันตอน merge อยู่ดี
git worktree list --porcelain | grep branch
จุดบกพร่อง (Failure mode): คุณจะรู้ว่ามีการแก้ไขไฟล์ทับซ้อนกันก็ต่อเมื่อพยายามจะ merge ซึ่งเป็นช่วงเวลาที่การแก้ไขปัญหามีต้นทุนสูงที่สุด
วิธีทั้งหมดที่ว่ามานี้ไม่มีอะไรผิด สำหรับ agent สองหรือสามตัวที่ทำงานคนละอย่างกัน การใช้ tmux pane สักสองสามหน้าต่างกับลูปคำสั่ง watch ก็ถือเป็นระบบมอนิเตอร์ที่สมเหตุสมผลแล้ว และคุณไม่จำเป็นต้องหาอะไรที่ซับซ้อนกว่านั้นมาใช้เลย ควรรักษาความซับซ้อนให้เหลือน้อยที่สุดไว้ก่อน จนกว่าคุณจะเริ่มรู้สึกว่ามันติดขัด
จุดที่ระบบมอนิเตอร์แบบ DIY เริ่มเอาไม่อยู่
กำแพงอุปสรรคจะเริ่มปรากฏเมื่อคุณรัน agent มากพอจนหน้าจอเดียวไม่สามารถแสดงผลได้ครบทั้งหมด และมีปัญหา 3 ประการที่ทวีความรุนแรงขึ้นร่วมกัน:
การ poll บอกได้แค่สถานะ แต่บอกสาเหตุไม่ได้: คำสั่ง git status และการ tail ล็อกบอกได้แค่ว่ามีอะไรเปลี่ยนแปลงหรือผลลัพธ์หยุดนิ่งไปแล้ว แต่ไม่สามารถบอกได้ว่า agent กำลังติด prompt, ขาด dependency หรือว่าทำงานเสร็จแล้วกันแน่ สุดท้ายคุณก็ต้องคอย attach เข้าไปดูทีละ session เพื่อหาสาเหตุ ซึ่งกลายเป็นการวนกลับมาสลับหน้าต่างเทอร์มินัลไปมา ทั้งที่จริง ๆ แล้วการรันแบบขนานควรจะช่วยตัดปัญหานี้ออกไป
ไม่มีสถานะส่วนกลางที่ใช้ร่วมกัน: การมอนิเตอร์ของคุณผูกติดอยู่กับแล็ปท็อป ใน tmux server หรือใน shell history ของคุณเอง เพื่อนร่วมทีมไม่สามารถมองเห็นได้ว่า agent ตัวไหนกำลังรับผิดชอบงานอะไรอยู่ และตัวคุณเองก็มองไม่เห็นเช่นกันเมื่อพับหน้าจอแล็ปท็อป ยิ่งเมื่อ agent ทำงาน บนเครื่องเซิร์ฟเวอร์ระยะไกล (remote machine) วิธีการ tail ล็อกในเครื่องก็จะใช้การไม่ได้โดยสิ้นเชิง
การรีวิวกลายเป็นคอขวด: นี่คือสิ่งที่คนมักประเมินต่ำไป การรัน agent หลายตัวพร้อมกันแทบไม่มีประโยชน์อะไรเลย หากการตรวจรีวิวผลงานยังต้องกลับมาต่อคิวทำทีละงานเหมือนเดิม diff ของ 5 งานที่เสร็จแล้วแต่ไม่มีพื้นที่ส่วนกลางให้ติดตามว่า “รีวิวแล้ว / ขอให้แก้ไข / merge แล้ว” จะกลายเป็น 5 แท็บบนเบราว์เซอร์กับสิ่งที่คุณต้องคอยจำเอาเองในหัว agent ทำงานเร็วขึ้น แต่มนุษย์กลับทำงานช้าลง
เมื่อถึงจุดนั้น สิ่งที่คุณขาดไม่ใช่หน้าต่างเทอร์มินัลที่เพิ่มขึ้น แต่เป็นบันทึกข้อมูลส่วนกลางที่แชร์ร่วมกันได้
สิ่งที่บอร์ดงานเข้ามาช่วยเสริม: รวมผลลัพธ์ไว้ในที่เดียว
การมีเลเยอร์จัดการงานจะเปลี่ยนหน่วยของการมอนิเตอร์จาก “โพรเซสใน pane หนึ่ง” ไปเป็น “Task ที่มีสถานะชัดเจน” นี่คือการเปลี่ยนแปลงหลักที่ Sharkly สร้างขึ้นมาตอบโจทย์ และสอดรับกับสัญญาณทั้ง 4 สัญญาณโดยตรง
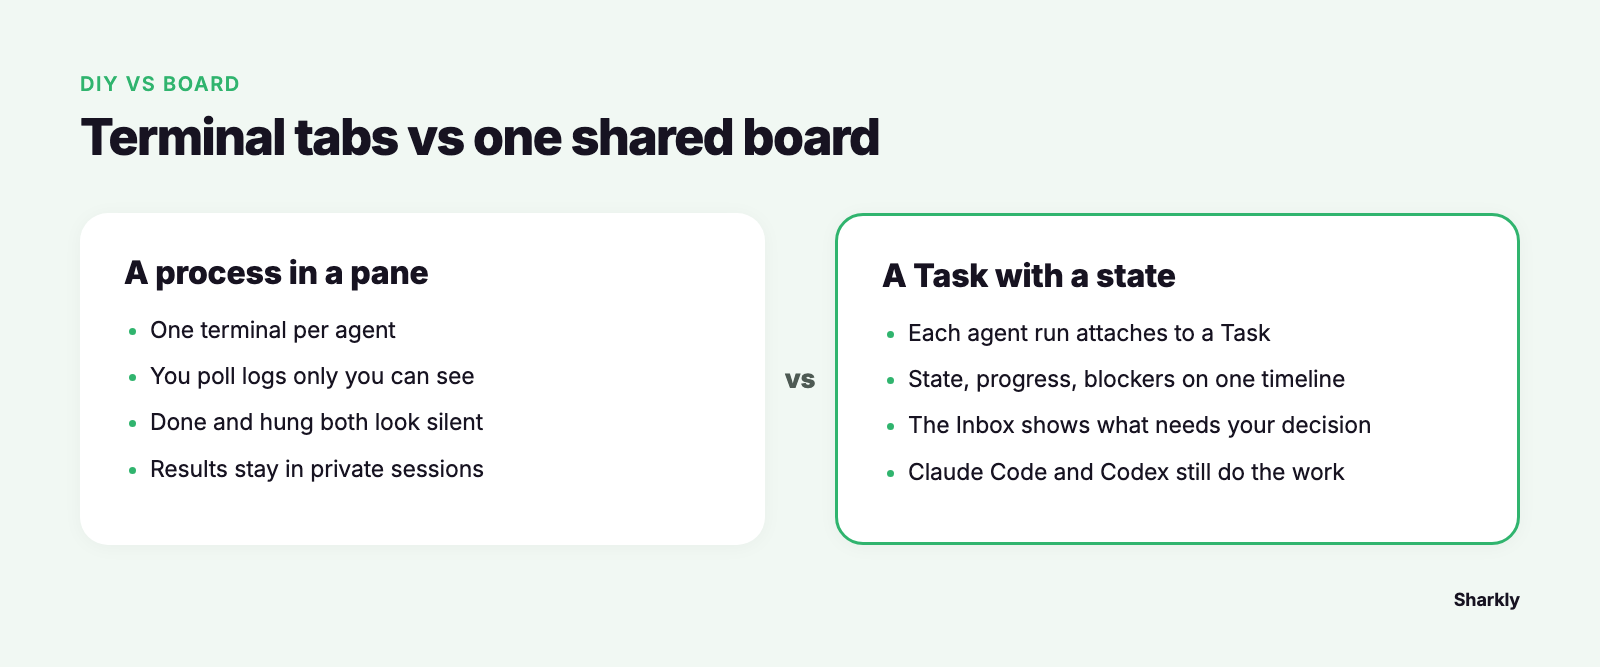
การรัน agent แต่ละครั้งจะเชื่อมโยงเข้ากับ Task หนึ่ง ๆ ทั้งสถานะ, ความคืบหน้า, ปัญหาที่ติดขัด และผลลัพธ์ จะถูกส่งกลับมารวมกันบนไทม์ไลน์ของ Task นั้น แทนที่จะฝังอยู่ในล็อกที่เห็นได้แค่คุณคนเดียว แทนที่จะต้องคอยสั่ง poll คุณแค่ดูที่บอร์ด: Task ไหนกำลังดำเนินอยู่, Task ไหนติดปัญหา, Task ไหนเสร็จแล้วและกำลังรอคุณอยู่ กล่อง Inbox ของ Sharkly จะเป็นจุดรวมของงานที่ต้องการมนุษย์เข้ามาดู คำถามจึงเปลี่ยนจาก “มีอะไรเสร็จบ้างหรือยัง?” มาเป็น “นี่คืองานที่ต้องรอการตัดสินใจจากเรา” agent มีหน้าที่ค้นคว้าข้อมูล, ลงมือทำ, ทดสอบ และรายงานผล ส่วนมนุษย์มีหน้าที่กำหนดทิศทาง, อนุมัติสิทธิ์ และตรวจรับผลงาน ระบบอัตโนมัติจะหยุดลงเมื่อถึงจุดที่ต้องใช้การตัดสินใจของมนุษย์
ขอบเขตตรงนี้เป็นเรื่องสำคัญ เพราะเข้าใจผิดกันได้ง่าย: Sharkly ไม่ได้เป็นตัวรัน agent หรือเป็นคนเขียนโค้ดเอง ตัวรันไทม์ที่คุณใช้อยู่แล้วอย่าง Claude Code, Codex หรือตัวอื่น ๆ ยังคงทำหน้าที่ประมวลผลโค้ดเช่นเดิม แต่ Sharkly จะเข้ามาเติมเต็มเลเยอร์ของงานส่วนกลาง (shared task), คอมพิวเตอร์, บริบท (context) และการรีวิวครอบไว้รอบตัวรันไทม์เหล่านั้น เพื่อให้ความคืบหน้าของงานและ diff ถูกส่งมายังที่ที่ทุกคนในทีมมองเห็นได้ตั้งแต่เริ่มสั่งงานไปจนถึงขั้นตอน release นอกจากนี้ยังช่วยแยกการรันแต่ละครั้งให้อยู่ใน worktree ที่แยกจากกันโดยอิสระ ทำให้ปัญหาการแก้ไขไฟล์ชนกันที่คุณมักจะเจอตอน merge ถูกจำกัดและควบคุมไว้ในระดับของแต่ละ Task
หลักเกณฑ์ในการตัดสินใจแบบตรงไปตรงมา: หากคุณรัน agent แค่หนึ่งหรือสองตัวกับงานที่ไม่เกี่ยวข้องกัน และไม่เคยต้องส่งต่องานให้ใคร การมอนิเตอร์แบบ DIY ก็เพียงพอแล้ว และการใช้ Sharkly จะกลายเป็นภาระส่วนเกิน แต่สมการจะเปลี่ยนไปทันทีเมื่อจำนวน agent มีมากกว่าหน้าจอที่คุณมี เมื่อมีงานที่ต้องรันบนเครื่องที่คุณไม่ได้นั่งอยู่หน้าจอ หรือเมื่อมีคนอื่นจำเป็นต้องดูบอร์ดเดียวกับคุณ หากคุณต้องการใช้งาน coding agent หลากหลายตัวต่อไปโดยไม่ต้องผูกมัดตัวเองไว้กับอีโคซิสเต็มใดเพียงระบบเดียว มุมมองส่วนกลางนี้แหละคือโจทย์ที่ Sharkly ถูกออกแบบมาเพื่อแก้ไข สำหรับภาพรวมว่าควรมีอะไรอยู่บนบอร์ดบ้าง สามารถดูเพิ่มเติมได้ที่ แดชบอร์ดของ AI coding agent ควรแสดงผลอะไรบ้างกันแน่
เช็กลิสต์การมอนิเตอร์ที่คุณนำไปใช้ได้ทันทีวันนี้
ไม่ว่าคุณจะยังใช้ระบบที่สร้างขึ้นมาเอง หรือเปลี่ยนไปใช้เลเยอร์ส่วนกลาง ระบบมอนิเตอร์สำหรับ agent ที่รันพร้อมกันควรจะตอบคำถามเหล่านี้ได้โดยที่คุณไม่ต้อง attach เข้าไปดูใน session เลยแม้แต่ครั้งเดียว:
- agent ทุกตัวต้องผูกกับชื่องานที่ชัดเจน: ไม่ใช่ชื่อนิรนามอย่าง “agent-3” คุณต้องบอกได้ทันทีว่าแต่ละตัวกำลังทำอะไรอยู่
- มองเห็นสถานะได้ในพริบตาเดียว: กำลังรัน, รอรับอินพุต, เสร็จแล้ว หรือล้มเหลว ต้องแยกแยะได้ชัดเจน ไม่ใช่ต้องมานั่งเดาจากความเงียบ
- agent ที่ติดปัญหาต้องยกมือบอก: หากมี prompt รอคำตอบ
y/n, ขาด secret หรือมีคำถามที่ยังไม่ได้ตอบ ต้องแสดงขึ้นมาให้คุณเห็นทันที แทนที่จะหยุดค้างไปเงียบ ๆ - คำว่า "เสร็จ" ต้องพร้อมให้รีวิวได้ ไม่ใช่แค่โพรเซสหยุดทำงาน: การรันที่เสร็จสิ้นต้องชี้ไปยัง diff หรือ PR ได้ ไม่ใช่บอกแค่ exit code
- การรีวิวต้องมีสถานะเป็นของตัวเอง: มีการติดตามสถานะว่า รีวิวแล้ว, ขอให้แก้ไข และ merge แล้ว เพื่อไม่ให้งานที่ทำมาแบบขนานต้องวนกลับไปคอยต่อคิวตรวจทีละงาน
- ดูข้อมูลต่อได้แม้พับหน้าจอแล็ปท็อป และแชร์ให้คนอื่นดูได้: ข้อมูลสถานะต้องเก็บไว้ในที่อื่นที่ไม่ใช่แค่ shell history ของคุณ
- งานใน repo เดียวกันต้องแยกออกจากกัน: agent แต่ละตัวต้องมี worktree ของตัวเอง และปัญหาไฟล์ทับซ้อนต้องตรวจพบก่อนการ merge ไม่ใช่ระหว่าง merge
ลองตรวจสอบเช็กลิสต์ด้านบนเทียบกับการเซ็ตอัปปัจจุบันของคุณดู ข้อไหนที่คุณยังติ๊กถูกไม่ได้ในวันนี้ จะเป็นข้อที่ทำให้คุณต้องเสียเวลาทั้งช่วงบ่ายในวันหน้า หากคุณกำลังรัน agent หลายตัวอยู่แล้ว Sharkly จะช่วยให้คุณมีพื้นที่ส่วนกลางเพียงที่เดียวในการจัดการงานและผลลัพธ์ทั้งหมด นอกจากนี้คุณยังสามารถ รัน coding agent ที่มีอยู่แล้วผ่าน Sharkly โดยยังคงใช้รันไทม์เดิมที่คุณคุ้นเคยได้ทันที


