
สรุปสั้น ๆ (TL;DR): หากต้องการรัน AI coding agent พร้อมกัน 10 ตัว ให้เลิกมอง agent แต่ละตัวเป็นหน้าต่างเทอร์มินัลที่คุณต้องคอยเฝ้า แต่ให้เปลี่ยนงานแต่ละชิ้นเป็น Task แยกกัน มอบหมายให้แต่ละ Task มีรอบการทำงานของ agent ใน worktree ที่แยกเป็นอิสระบน Computer ที่เชื่อมต่อไว้ จัดการการติดตามงานผ่านคอมเมนต์ใน Task และปล่อยให้เงื่อนไขกระตุ้น (event triggers) คอยเริ่มงานที่ต้องทำซ้ำ สิ่งที่คุณต้องตรวจทานคือผลลัพธ์ ไม่ใช่การนั่งเฝ้าเซสชัน
คุณสามารถรัน AI coding agent พร้อมกัน 10 ตัวได้โดยไม่ต้องเปิดหน้าต่างเทอร์มินัลทิ้งไว้ถึง 10 แท็บ และขีดจำกัดแรกที่คุณจะพบไม่ใช่ตัวโมเดล ในบทความ “Exploring Super-agent Design” ทีม DeepSeek Harness ได้อธิบายไว้อย่างชัดเจนว่า โดยทั่วไปคนเราสามารถติดตามเซสชันที่กำลังทำงานอยู่ได้เพียง 3 ถึง 5 เซสชันพร้อมกันเท่านั้น หากเกินกว่านั้น ตัวคุณเองนั่นแหละที่จะกลายเป็นคอขวด (bottleneck)
คำตอบของพวกเขาคือ "super-agent" ซึ่งเป็นตัวประสานงาน (coordinator) กลางเพียงหนึ่งเดียวที่คอยสื่อสารกับมนุษย์และกระจายงานไปยัง worker ที่แยกการทำงานจากกันเป็นจำนวนมาก บทความดังกล่าวกล่าวถึงสถาปัตยกรรมเชิงแนวคิด ไม่ใช่ผลิตภัณฑ์ที่เปิดตัวให้ใช้งานแล้ว คู่มือนี้จึงนำเสนอเวอร์ชันที่เข้าใจง่ายและปรับใช้ได้จริง ซึ่งทีมของคุณสามารถรันได้ทันทีบนบอร์ด Sharkly โดยใช้การตั้งค่า Claude Code หรือ Codex ที่คุณมีอยู่แล้ว
ความแตกต่างอย่างหนึ่งที่ต้องบอกตรง ๆ คือ coordinator ของ DeepSeek จะเป็น LLM ที่ตัดสินใจเองว่าใครควรทำอะไร แต่ในรูปแบบบอร์ด มนุษย์จะเป็นผู้ตัดสินใจเรื่องดังกล่าว และทุกการตัดสินใจจะมีการบันทึกประวัติไว้อย่างชัดเจน
ทำไมการเปิดเทอร์มินัล 10 หน้าต่างถึงไปไม่รอด
หากทำด้วยตนเอง การจัดการ 2 หรือ 3 agent ยังพอไปได้ แต่เมื่อเพิ่มเป็น 10 ตัว คุณจะต้องเจอกับ 4 ปัญหานี้พร้อมกันทันที
- คุณกลายเป็นเราเตอร์เสียเอง ทุกพรอมต์ ทุกคำสั่ง “continue” และทุกการติดตามงานต้องวิ่งผ่านคุณทั้งหมด
- บริบท (Context) ปะปนกันมั่วไปหมด การแก้ไขที่ควรจะอยู่ใน branch ของ auth กลับไปโผล่ในเซสชันของระบบ billing หรือ agent 2 ตัวเข้าไปแก้ไข checkout เดียวกันจนเขียนทับงานกันเอง
- แล็ปท็อปของคุณกลายเป็นเซิร์ฟเวอร์ พอพับฝาเครื่องลง ทุกเซสชันก็หยุดทำงาน ทั้งที่งานที่ต้องรันยาวนานต้องการโฮสต์ที่พร้อมทำงานตลอดเวลา
- ไม่มีอะไรถูกบันทึกไว้เลย เมื่องานเกิดข้อผิดพลาด ประวัติการทำงานก็หลงเหลืออยู่แค่ใน scrollback buffer ของเทอร์มินัลที่คุณเพิ่งปิดไป
เราได้พูดถึงต้นทุนแฝงเหล่านี้ไว้แล้วในบทความ Too Many Terminals ทางออกของเรื่องนี้คือ ย้ายภาระการประสานงานออกจากสมองของคุณ ไปไว้ในระบบที่สามารถบันทึกและจัดการสถานะ (state) ได้
การปรับแนวคิด Super-agent ของ DeepSeek มาใช้บนบอร์ด
องค์ประกอบแต่ละส่วนในการออกแบบของ DeepSeek มีสิ่งที่เทียบเคียงกันได้อย่างตรงไปตรงมาบนกระดานงาน (Task board)
| ส่วนประกอบของ DeepSeek | หน้าที่ในบทความ | การทำงานบนบอร์ด Sharkly |
|---|---|---|
| Router | เซสชันเดียวที่ทำงานต่อเนื่อง คอยคุยกับมนุษย์ กระจายงาน ไม่ลงมือ execute เอง ใช้โมเดลที่เบากว่าได้ | ตัวบอร์ดร่วมกับบุคคลที่ทำหน้าที่มอบหมาย Task |
| Workers | เซสชันแยกต่างหาก 1 เซสชันต่อ 1 งาน ใช้โมเดลที่มีความสามารถสูงสุด และไม่คุยกับมนุษย์โดยตรง | การรัน 1 agent ต่อ 1 Task ภายใน worktree แยกเฉพาะของตัวเอง |
| Threads | การติดตามงานใน PR เดียวกันหรือหัวข้อแชตเดิมจะส่งตรงไปยัง Worker ที่ติดตามเรื่องนั้นไว้ | คอมเมนต์ใน Task จะปลุก agent ที่ได้รับมอบหมายให้กลับมาทำงานต่อ |
| Triggers | คัดกรองอีเวนต์ด้วยโค้ดก่อน (allowlists) แล้วจึงคัดกรองด้วยโมเดล (ใช้นโยบายในรูปแบบพรอมต์) | ระบบ Automation ตามสถานะ, วลีในคอมเมนต์, webhook หรือตามกำหนดเวลา |
| BYOM (bring your own hardware) | ลูปของ agent อยู่บนคลาวด์ สภาพแวดล้อมการทำงานอยู่บนฮาร์ดแวร์ของคุณเองผ่าน daemon ขนาดเบา | เครื่อง Computer ที่เชื่อมต่อผ่าน Sharkly Desktop หรือ Sharkly CLI |
| Watchdog | เซสชันภายนอกที่คอยตรวจจับ Worker ที่ติดลูปหรือทำงานออกนอกลู่นอกทาง | การตรวจสอบตามรอบเวลา (scheduled check) ควบคู่กับประวัติการรันและขั้นตอนการตรวจทานโดยมนุษย์ |
การคัดกรองทริกเกอร์แบบสองขั้น (two-stage filter) เป็นสิ่งที่คุณควรนำมาปรับใช้อย่างยิ่ง กล่าวคือ โค้ดจะคัดกรองสิ่งที่ไม่ตรงเงื่อนไขทิ้งไปก่อนเท่าที่จะทำได้ (เช่น repo ผิด, สถานะไม่ถูกต้อง) จากนั้นโมเดลจึงค่อยเข้ามาอ่านอีเวนต์นั้น ในการทำงานบนบอร์ด ตัวทริกเกอร์จะทำหน้าที่เป็นตัวกรองด้วยโค้ด ส่วนคำสั่งใน Automation ก็คือพรอมต์เชิงนโยบาย (policy prompt)
วิธีรัน AI coding agent 10 ตัวบนบอร์ด Sharkly
คุณไม่จำเป็นต้องเริ่มต้นที่สิบตัว ให้เริ่มจากสามตัวเพื่อพิสูจน์ลูปการทำงานก่อน แล้วค่อยขยายจำนวนขึ้นเรื่อย ๆ
ขั้นตอนที่ 1: เชื่อมต่อ Computer และตั้งค่า Concurrency ไว้ต่ำ ๆ ก่อน
Computer คือโฮสต์ที่ทำหน้าที่รัน agent ของคุณ หากใช้งานบนแล็ปท็อป ให้ติดตั้ง Sharkly Desktop หากอยู่บนโฮสต์ระยะไกลหรือเครื่อง Linux ให้ใช้ Sharkly CLI ร่วมกับ local service:
# On the remote host, with an install token from the Computers page
sharkly computer register --install-token <install-token>
sharkly daemon status
ตัว local service จะตรวจหาเครื่องมือที่ติดตั้งไว้ เช่น Claude Code และ Codex แล้วรายงานแต่ละเครื่องมือในฐานะ Runtime
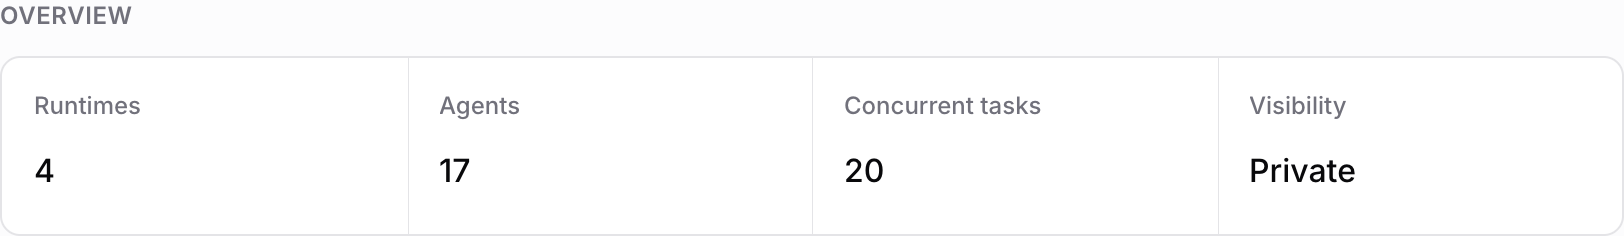
Computer แต่ละเครื่องจะมีขีดจำกัดจำนวนงานที่ทำงานพร้อมกันได้ (concurrent-task limit) โดยตามข้อมูลใน เอกสารประกอบของ Computers การรันในโหมดโฟลเดอร์ชั่วคราว (temporary directory) จะถูกตั้งค่าเริ่มต้นไว้ที่ 50% ของขีดจำกัดนั้น และงานส่วนเกินจะถูกจัดเข้าคิวเมื่องานเต็มความจุ ขอแนะนำให้เริ่มต้นน้อยกว่าที่คุณคิดไว้ การรันพร้อมกัน 3 งานบน Computer เครื่องเดียวนับเป็นการทดสอบเริ่มต้นที่เหมาะสม
ควรใช้โหมด temporary-directory สำหรับงานเขียนโค้ด เพราะการรันแต่ละครั้งจะได้ไดเรกทอรีของตัวเอง และการรันใน repository ก็จะได้ git worktree ใหม่เสมอ ทำให้ agent สองตัวไม่มีทางเขียนทับ checkout เดียวกัน หากคุณยังไม่คุ้นเคยกับ worktree ขอแนะนำให้อ่าน วิธีใช้งาน git worktree ร่วมกับ AI coding agent ก่อน
ขั้นตอนที่ 2: สร้าง Agent สองหรือสามตัวโดยแบ่งหน้าที่ให้ชัดเจน
การมี 10 agent ไม่ได้แปลว่าต้องมี 10 บุคลิก แต่หมายถึงการกำหนดบทบาทเพียงไม่กี่บทบาท โดยแต่ละบทบาทจะคอยรันหลาย ๆ Task
- Builder: ทำหน้าที่เขียนโค้ดส่วนที่เปลี่ยนแปลง ให้เลือกใช้โมเดลที่มีความสามารถสูงสุดของคุณ เช่นเดียวกับที่ DeepSeek ใช้กับ Worker
- Reviewer: ทำหน้าที่อ่าน diff และเกณฑ์การยอมรับงาน (acceptance check) ของ Task นั้น ๆ แล้วเขียนคอมเมนต์
- Fixer: รับหน้าที่จัดการกับแบบทดสอบที่ไม่ผ่านและแก้ไขตามคอมเมนต์จากการรีวิว
Agent, Crew และ Computer จะไม่นับรวมในโควตาผู้ใช้งาน (seats) ดังนั้นการเพิ่มบทบาทใหม่จึงไม่มีค่าใช้จ่ายด้าน seat เพิ่มเติม
ขั้นตอนที่ 3: เขียน Task ที่สามารถทำงานจบได้ในตัวเอง
การตั้งค่าการทำงานแบบคู่ขนานส่วนใหญ่ล้มเหลวที่จุดนี้ เพราะ Task ที่ต้องพึ่งพาโค้ดของอีก Task ที่ยังไม่ถูก merge มักจะเกิดการหยุดชะงักหรือไม่ก็เกิดข้อขัดแย้ง (conflict) ขึ้น
เขียนแต่ละ Task ให้ประกอบด้วย 3 สิ่ง ได้แก่ ผลลัพธ์ที่ต้องการหนึ่งอย่าง, ไฟล์หรือโมดูลที่ Task นั้นรับผิดชอบ และการตรวจสอบที่ใครก็รันได้ ตัวอย่างเช่น “เพิ่ม rate limiting ให้กับ /api/upload; รันคำสั่ง npm test -- upload แล้วต้องผ่าน” แบบนี้ใช้ได้ แต่คำว่า “ปรับปรุง API” แบบนี้ใช้ไม่ได้
หากมี 2 Task ที่จำเป็นต้องแก้ไขไฟล์เดียวกัน ให้รันงานเหล่านั้นตามลำดับทีละงาน
ขั้นตอนที่ 4: มอบหมายงาน แล้วติดตามงานต่อภายใน Task เท่านั้น
มอบหมายแต่ละ Task ให้กับ agent โดย Task ที่อยู่นอก Backlog สามารถเริ่มรันได้ทันที ส่วน Task ใน Backlog จะรอจนกว่าจะถูกย้ายไปยังสถานะที่พร้อมทำงาน
การติดตามงานต่อให้ทำผ่านคอมเมนต์ของ Task เสมอ และอย่าแยกไปคุยในแชตส่วนตัว คอมเมนต์จากสมาชิกในทีมบน Task ที่มอบหมายให้ agent ไว้นั้นสามารถจัดคิวการรันเพื่อติดตามงานต่อได้ โดย Sharkly จะรวมคอมเมนต์ที่ส่งติด ๆ กันเข้าด้วยกัน เพื่อป้องกันไม่ให้เกิดการรันซ้ำซ้อนที่ค้างอยู่ในคิว ซึ่งตรงกับแนวคิดเรื่อง Thread ของ DeepSeek ที่ให้บทสนทนาผูกติดอยู่กับเนื้องานเสมอ
การใช้วลีที่กำหนดไว้ล่วงหน้า เช่น /revise ตามด้วยรายละเอียดที่ต้องการให้แก้ จะช่วยให้สังเกตการติดตามงานได้ง่ายขึ้น
ขั้นตอนที่ 5: เปลี่ยนอีเวนต์ที่เกิดซ้ำให้เป็น Automation
Automation คือการจับคู่ชุดคำสั่งเข้ากับ agent หรือ Crew ร่วมกับทริกเกอร์อย่างน้อยหนึ่งตัวขึ้นไป โดยตาม เอกสารประกอบของ Automations มีทริกเกอร์ให้เลือกใช้ 4 รูปแบบ นอกเหนือจากการกดสั่ง Run now ด้วยตนเอง:
- Schedule: กำหนดเวลาด้วย cron expression แบบ 5 ช่อง พร้อมระบุเขตเวลา
- Task status: ทำงานเมื่อ Task ถูกเปลี่ยนไปยังสถานะที่เลือกไว้
- Comment phrase: ทำงานเมื่อคอมเมนต์มีวลีที่ระบุ โดยไม่สนใจตัวพิมพ์เล็ก-พิมพ์ใหญ่ (case-insensitive)
- Webhook: URL ลับที่รองรับคำขอแบบ POST พร้อมตัวเลือกการลงนามคำขอ (request signing)
ข้อควรระวังหนึ่งจากเอกสารคือ ปัจจุบันการจับคู่สถานะและคอมเมนต์มีผลครอบคลุมทั้งองค์กร ไม่ได้จำกัดอยู่เฉพาะใน Space ใด Space หนึ่ง ดังนั้นควรเขียนคำสั่งให้ agent ตรวจสอบ Task ที่เป็นตัวทริกเกอร์ก่อนเสมอ (เช่น คำนำหน้าชื่อ Task หรือ Space ที่สังกัด) และให้หยุดทำงานทันทีหากไม่ตรงเงื่อนไข นี่คือการคัดกรองขั้นที่สองตามแบบ DeepSeek ซึ่งเขียนขึ้นในรูปแบบของพรอมต์
ขั้นตอนที่ 6: เพิ่ม Watchdog และจุดตรวจทานโดยมนุษย์
DeepSeek ใช้ Watchdog แยกอีกส่วนเพื่อคอยตรวจจับ Worker ที่ทำงานวนลูปหรือเริ่มหลงประเด็น คุณสามารถจำลองกลไกนี้ได้โดยตั้งค่า Automation ตามกำหนดเวลาให้คอยแจ้งเตือนการรันที่ใช้เวลานานผิดปกติ โดยอิงจากสถานะการรันที่ Sharkly บันทึกไว้ ได้แก่ queued, running, completed, failed และ canceled
จากนั้นให้มนุษย์เป็นผู้ตรวจทานในขั้นตอนสุดท้าย โดยกำหนดสถานะ review ให้มนุษย์เข้ามาอนุมัติ diff ก่อนที่จะ merge ความสามารถในการรีวิวของคนนี่เองที่จะเป็นเพดานขีดจำกัดที่แท้จริงของคุณ ดังนั้นควรอ่านบทความ Human Review Is the Bottleneck ก่อนที่จะขยายจำนวนเกิน 5 ตัว และสำหรับสิ่งที่ควรเฝ้าระวังในขณะที่รันงานอยู่ สามารถอ่านเพิ่มเติมได้ที่ วิธีมอนิเตอร์ coding agent ที่ทำงานพร้อมกันหลายตัว
ต้นทุนในการรัน 10 ตัวอยู่ที่เท่าไร
ค่าใช้จ่ายจะแบ่งออกเป็น 2 ส่วนแยกกัน ได้แก่ โทเค็นของโมเดล และเลเยอร์สำหรับการประสานงาน
โทเค็น: Sharkly ไม่ได้ขายโทเค็น การรันงานจะคิดค่าบริการผ่านแพ็กเกจ Claude Code, Codex หรือแพ็กเกจ API ที่คุณเชื่อมต่อไว้กับ Runtime โดยเราได้อธิบายเหตุผลไว้ในบทความ Why an Agent Platform Should Not Sell You Tokens
การทำงานแบบคู่ขนานต้องใช้โทเค็นมากขึ้น: การทดสอบของ DeepSeek เองมีประโยชน์มากในจุดนี้ พวกเขาได้ทดสอบด้วยข้อความราว 300 ข้อความพร้อมคำของานประมาณ 20 รายการ ในสถานการณ์จำลองการเขียนโค้ด โดยรันแบบละ 5 รอบ และระบุว่าผลลัพธ์ดังกล่าวใช้เป็นแนวทางชี้วัดได้
| รูปแบบการตั้งค่า (ตัวเลขจาก DeepSeek) | เวลาต่อ Task (p50) | เวลาต่อ Task (p95) | โทเค็น Cache-read ต่อการรัน |
|---|---|---|---|
| Super-agent | 12.4 นาที | 15.7 นาที | 23.2M |
| เซสชันเดี่ยว + subagents, พรอมต์แบบกลาง ๆ (neutral prompt) | 20.4 นาที | 29.5 นาที | 6.1M |
| เซสชันเดี่ยว + subagents, พรอมต์เน้นกระจายงาน (delegation-first prompt) | 13.8 นาที | 29.0 นาที | 10.8M |
เซสชันที่ใช้พรอมต์แบบกลาง ๆ ไม่เคยกระจายงานเลยแม้แต่ครั้งเดียวจากการรัน 5 รอบ สิ่งที่ต้องแลกมาคือ: การใช้โทเค็นมากขึ้นเพื่อแลกกับระยะเวลาการทำงานที่สั้นลงและสม่ำเสมอขึ้น ทั้งนี้ เราไม่ได้ทำการทดสอบเหล่านี้ซ้ำด้วยตัวเอง
แพลตฟอร์ม: ณ วันที่ 4 พฤศจิกายน 2026 ข้อมูลบนหน้า ราคาของ Sharkly ระบุว่าผลิตภัณฑ์เปิดให้ใช้งานฟรีสำหรับองค์กรที่มีสมาชิกไม่เกิน 5 คน ส่วนแพ็กเกจ Team อยู่ที่ 7 ดอลลาร์ต่อคน ชำระเป็นรายปี โดย seat จะนับเฉพาะจำนวนคนเท่านั้น
รูปแบบนี้เหมาะกับงานประเภทใด
- การเคลียร์ Backlog (Backlog burn-down): ปัญหาเล็ก ๆ 20 รายการที่ไม่ขึ้นต่อกัน แยกเป็นรายการละหนึ่ง Task โดยใช้ builder ร่วมกับ reviewer
- การแก้ไข Test หลังการอัปเกรด: แยกหนึ่ง Task ต่อหนึ่งแพ็กเกจที่มีปัญหา โดยแต่ละงานรันใน worktree ของตัวเอง
- การอัปเดตเอกสารและโค้ดไปพร้อมกัน: ทริกเกอร์สถานะจะสั่งให้ agent ดูแลเอกสารเริ่มทำงานทันทีที่ Task พัฒนาฟีเจอร์ถูกย้ายไปยังสถานะ review
- คิวงานข้ามคืน: ปล่อยให้ Task รันบน Computer ระยะไกลที่ทำงานตลอดเวลา แล้วคุณค่อยมาตรวจทานผลลัพธ์ในตอนเช้า
หากคุณต้องการเปรียบเทียบว่าควรรัน agent ที่ใดมากกว่ากัน บทความ Codex Cloud vs your own Computers มีรายละเอียดครอบคลุมตัวเลือกดังกล่าวไว้แล้ว
เริ่มต้นด้วยสามตัว
การรัน 10 agent แบบคู่ขนานคือผลลัพธ์ปลายทาง ไม่ใช่จุดเริ่มต้น ให้เริ่มจากการเชื่อมต่อ Computer หนึ่งเครื่อง สร้าง builder และ reviewer ขึ้นมา เขียน Task สามรายการที่มีผลลัพธ์ชัดเจนและตรวจสอบได้ แล้วจึงมอบหมายงาน เฝ้าดูวงจรการทำงานครบหนึ่งลูป: รันงาน, คอมเมนต์, ติดตามงาน และรีวิว เมื่อลูปดังกล่าวทำงานได้อย่างราบรื่นและคาดเดาได้แล้ว จึงค่อยเพิ่ม concurrency ขึ้นทีละสอง และเพิ่ม Automation อีกหนึ่งตัว
คำถามที่พบบ่อย (FAQ)
คนหนึ่งคนสามารถจัดการ AI coding agent ได้กี่ตัว?
ทีม DeepSeek ประเมินไว้ที่ 3 ถึง 5 เซสชันที่ทำงานอยู่ หากคุณต้องคอยติดตามดูแต่ละเซสชันด้วยตัวเอง แต่คุณจะสามารถรันได้มากกว่านั้นอย่างมากเมื่อแปลงงานให้อยู่ในรูปของ Task ที่ระบุผลลัพธ์ไว้อย่างชัดเจน เพราะสิ่งที่คุณต้องทำมีเพียงแค่ตรวจทานผลลัพธ์ แทนที่จะต้องคอยเฝ้าหน้าจอทุกเซสชัน
สามารถรัน Claude Code agent หลายตัวบน repository เดียวกันได้หรือไม่?
ได้ หากการรันแต่ละครั้งทำงานในไดเรกทอรีของตัวเอง โดยโหมด temporary-directory จะมอบไดเรกทอรีที่แยกเป็นอิสระให้กับแต่ละ Task และการรันใน repository ก็สามารถใช้ git worktree ใหม่ได้ ทำให้ agent ที่ทำงานพร้อมกันไม่เขียนทับการเปลี่ยนแปลงของกันและกัน
จะเกิดอะไรขึ้นหากมอบหมาย Task มากกว่าจำนวนที่ Computer สามารถรันได้?
Task ส่วนเกินจะถูกจัดเข้าคิวรอ เนื่องจาก Computer แต่ละเครื่องมีขีดจำกัดงานที่ทำงานพร้อมกันได้ (concurrent-task limit) และงานจะเริ่มรันเมื่อมีทรัพยากรว่างลง นอกจากนี้ งานที่อยู่ในคิวจะรอต่อไปหาก Computer ออฟไลน์อยู่หรือ Runtime ยังไม่พร้อมใช้งาน
จำเป็นต้องมีคลาวด์เซิร์ฟเวอร์เพื่อรัน agent แบบคู่ขนานหรือไม่?
ไม่จำเป็น แล็ปท็อปทั่วไปก็สามารถทำหน้าที่เป็น Computer ได้ผ่าน Sharkly Desktop แต่สำหรับการรันงานที่ยาวนานหรืองานข้ามคืน การใช้โฮสต์ระยะไกลหรือเครื่อง Linux ที่เชื่อมต่อด้วย Sharkly CLI จะช่วยให้งานรันต่อเนื่องได้แม้ในเวลาที่แล็ปท็อปของคุณพักเครื่อง (sleep)
การใช้บอร์ดเหมือนกับ Super-agent ของ DeepSeek หรือไม่?
ไม่เหมือนกันเสียทีเดียว Router ของ DeepSeek คือ LLM ที่ทำหน้าที่กระจายงานโดยอัตโนมัติด้วยตัวเอง แต่บนบอร์ด มนุษย์จะเป็นผู้มอบหมาย Task และให้ Automation คอยจัดการกับอีเวนต์ที่เกิดขึ้นซ้ำ ๆ


