
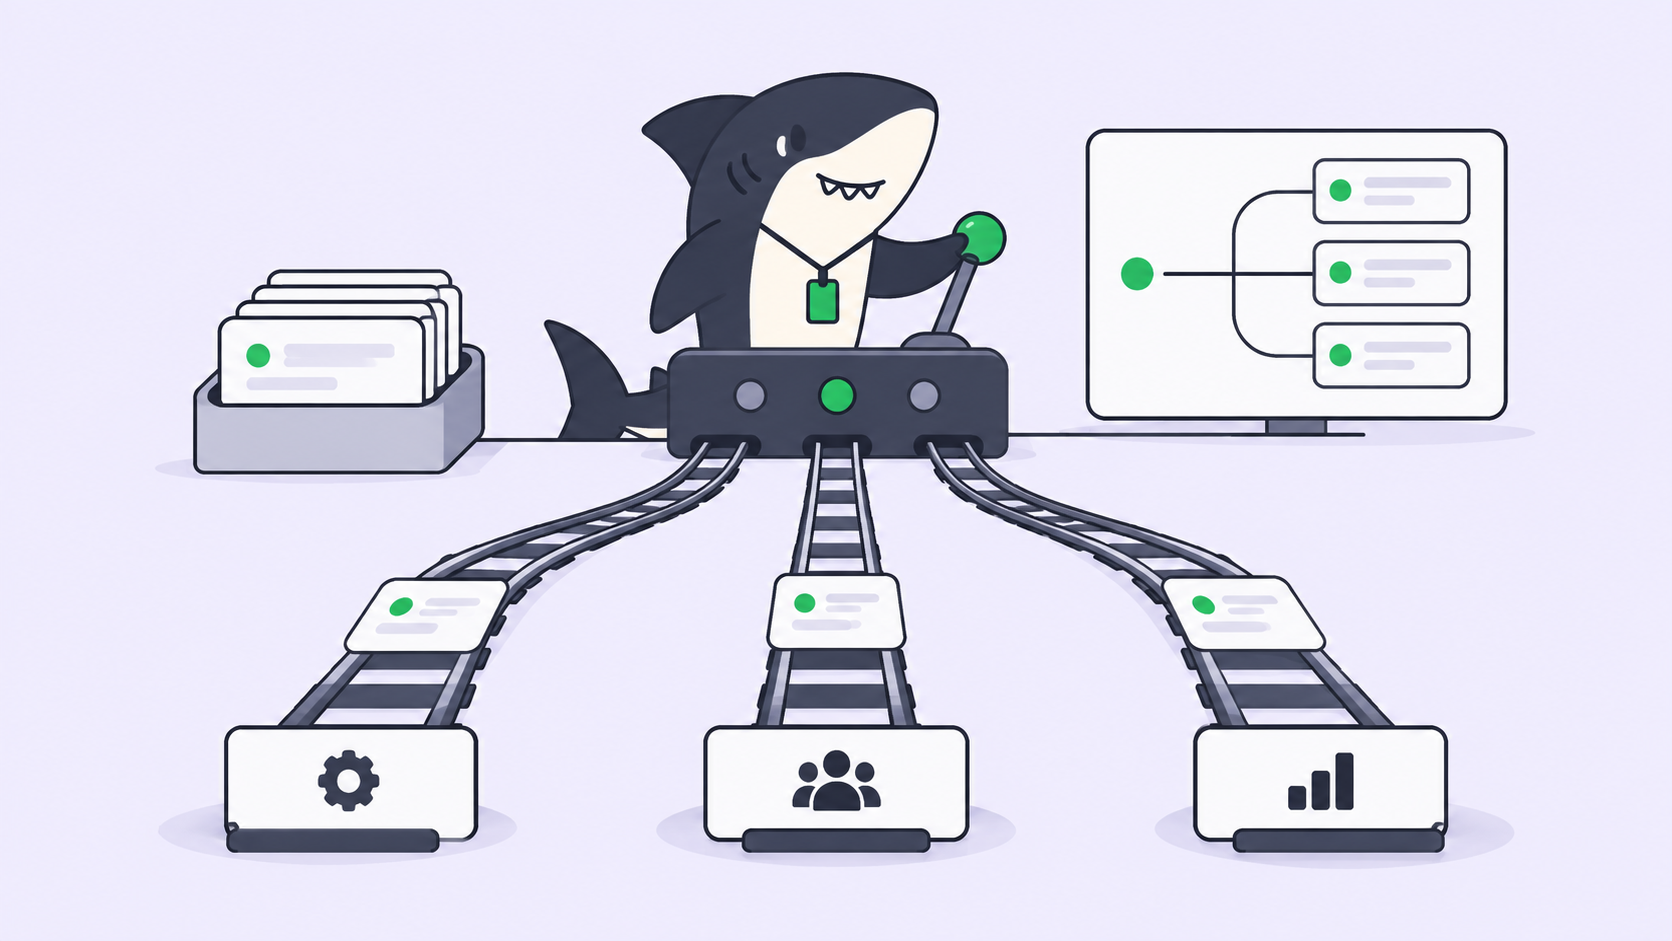
ทีมของคุณจัดสรรงานระหว่างโมเดลอยู่แล้ว ก็แค่ทำกันในหัว วิศวกรคนหนึ่งรันทุกอย่างบน tier ราคาแพงเพราะมันล้มเหลวน้อยกว่า อีกคนเปลี่ยนไปใช้ตัวถูกเมื่อเดือนที่แล้วโดยไม่บอกใคร ส่วนคนที่สามยังใช้ค่าเริ่มต้นที่เครื่องมือตั้งไว้ตอนติดตั้ง วิธีนี้พออยู่รอดได้ตราบใดที่มีคนเดียวรัน agent ตัวเดียว แต่จะพังทันทีที่ Agent ห้าตัวทำงานพร้อมกัน แล้วไม่มีใครบอกได้ว่าตัวไหนกำลังใช้จ่ายมากเกินความจำเป็นถึงสี่สิบเท่าไปกับงานเขียน docstring หรือตัวไหนกำลังล้มเหลวเงียบ ๆ กับงานที่มันไม่แข็งแรงพอจะรับไว้ตั้งแต่แรก
เมื่อวันที่ 2026-09-22 ช่องว่างระหว่าง tier ต่าง ๆ กว้างพอจนมีนัยสำคัญ Anthropic เปิดตัว Claude Opus 5.5 ส่วน OpenAI เปิดตัว GPT-6 Sol และ GPT-6 Luna ช่องว่างระหว่างตัวถูกที่สุดกับตัวแพงที่สุดในสามตัวนี้ต่างกันถึงสี่สิบเท่าในแง่ input token และทุกตัวก็ดีพอจะมอบ Task จริงให้ได้
กฎการจัดเส้นทางคือข้อกำหนดที่เขียนไว้ ไม่ใช่ความชอบส่วนตัว
กฎการจัดเส้นทางคือข้อกำหนดที่เขียนไว้ชัดเจนว่า Task ประเภทใดรันบน Runtime ตัวไหน โดยผูกไว้กับ Agent ที่ลงมือทำงาน ไม่ใช่ผูกกับคนที่บังเอิญเป็นคนเริ่มรัน
นั่นคือแนวคิดทั้งหมด และครึ่งที่สำคัญคือคำว่า "เขียนไว้" ความชอบส่วนตัวอยู่ใน terminal ของคนใดคนหนึ่ง และหมดอายุเมื่อคนนั้นลาพักร้อน ส่วนกฎอยู่ข้าง ๆ Agent ดังนั้น Assignee ที่มารับ Task ต่อก็ได้กฎนี้ไปด้วย ผู้รีวิวเห็นได้ว่า tier ไหนสร้าง diff ที่กำลังอ่านอยู่ และการเปลี่ยนใจในไตรมาสหน้าก็แก้ไขแค่ครั้งเดียว ไม่ต้องคุยกันหกครั้ง
กฎการจัดเส้นทางไม่ใช่การจัดอันดับโมเดล ไม่ได้ประกาศหาผู้ชนะ และไม่จำเป็นต้องมีด้วยซ้ำ มันแค่บอกว่างานแต่ละประเภทไปที่ไหนโดยค่าเริ่มต้น และเกิดอะไรขึ้นเมื่อค่าเริ่มต้นนั้นกลายเป็นผิด
สาม tier นี้มีค่าใช้จ่ายเท่าไร
| Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|
| API id | claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| Input / output ต่อ 1M | $4 / $20 | $2 / $10 | $0.10 / $0.50 |
| Cached input | อ่าน $0.20, เขียน $5 | อ่านถูกลง 90% | อ่านถูกลง 90% |
| Context | 1M | 872k | 1M |
เพื่อเป็นข้อมูลอ้างอิง: Claude Opus 5 อยู่ที่ $5 / $25 และ GPT-6 Astra อยู่ที่ $10 / $50 OpenAI อธิบายว่า Sol และ Luna ถูกกว่าราคา GPT-5.6 แบบ promotional อยู่ 50% คำว่า promotional เป็นคำของ OpenAI เอง และมันเปลี่ยนความหมาย เพราะฐานของการเปรียบเทียบในพาดหัวนั้นคือราคาที่ลดแล้ว ไม่ใช่ราคาปกติ OpenAI ยังบอกว่า Astra "continues to be our best model across the board" ซึ่งเตือนให้เราจำไว้ว่า Sol เป็น tier ที่คุ้มค่าในตระกูลของตัวเอง ไม่ใช่เรือธง
เช็กเชิงปฏิบัติหนึ่งอย่างก่อนจะเขียน tier ลงในกฎ: OpenAI ระบุว่า Sol และ Luna อยู่ใน ChatGPT Work และใน Codex สำหรับแพ็กเกจ Plus, Pro, Business, Enterprise และ Edu โดย Free และ Go ได้ Luna ในแอปเดสก์ท็อป และบอกว่าทั้งสองตัวยังไม่อยู่ใน Chat ความพร้อมใช้งานมีผลต่อกฎการจัดเส้นทางพอ ๆ กับราคา เพราะ tier ที่ Crew ของคุณครึ่งหนึ่งเข้าไม่ถึงก็ไม่นับเป็น tier
จัดเส้นทางด้วยต้นทุนต่องานที่เสร็จ ไม่ใช่อัตราค่า token
ราคา token เป็นเพียงตัวแทนของตัวเลขที่คุณจ่ายจริง โมเดลที่ราคาหนึ่งในห้าแต่ต้องลองสี่ครั้งและมีคนเข้าไปช่วย ไม่ได้ถูกกว่า OpenAI เผยแพร่ต้นทุนต่องานควบคู่กับคะแนนในการเปิดตัวครั้งนี้ ซึ่งตรงไปตรงมาอย่างผิดปกติ และเป็นหลักฐานรูปแบบที่เหมาะจะใช้ตัดสินใจเรื่องการจัดเส้นทาง
| Benchmark ตามที่ OpenAI เผยแพร่ | ผลลัพธ์ | ต้นทุนต่องาน (เทียบสัมพัทธ์) |
|---|---|---|
| AutomationBench 1.0.6, Sol ที่ระดับ extra-high | 33.2% | $0.27 ต่อ task |
| AutomationBench 1.0.6, GPT-6 Astra ที่ระดับ low | 30.3% | 3.9 เท่าของ Sol |
| AutomationBench 1.0.6, Claude Opus 5 ที่ระดับ max | 26.9% | 11.1 เท่าของ Sol |
| AutomationBench 1.0.6, Fable 5.1 ที่มี Opus 5 เป็น fallback ที่ระดับ max | 31.4% | มากกว่า 8.9 เท่าของ Sol |
| Agents’ Last Exam V1, Sol ที่ระดับ max | 56.4% สูงกว่าคะแนนดีที่สุดของ Opus 5 | ต่ำกว่า Opus 5 อยู่ 60% |
| OSWorld 2.0 แบบ offline, Sol ที่ระดับ extra-high | 60.5% เทียบกับ Opus 5 ที่ระดับ medium ซึ่งได้ 60.3% | ถูกกว่าราว 80% |
| DeepSWE 1.1, Luna ที่ระดับ max | 66.6% | ถูกกว่า Opus 5 อยู่ 93% |
| DeepSWE 1.1, Sol ที่ระดับ max | 68.8% ห่างจาก Fable 5 ที่ระดับ extra-high แค่ 1.1pp | ถูกกว่าราว 80% |
ตารางนี้เป็นจริงสองอย่างพร้อมกัน ช่องว่างนั้นกว้าง และมันวัดเทียบกับ Claude Opus 5 ไม่ใช่ Opus 5.5 ซึ่งยังไม่มีอยู่ตอนที่โพสต์ของ OpenAI เขียนขึ้น และเพิ่งเปิดตัวในอีกไม่กี่ชั่วโมงต่อมา โดย Anthropic เองบอกว่ามีต้นทุนการรันต่ำกว่า Opus 5 อยู่ 40% ยังไม่มีใครรันการเปรียบเทียบซ้ำ ให้ถือว่าแถวต่าง ๆ เป็นตัวเลขที่เผยแพร่ล่าสุด และอันดับที่มันสื่อเป็นเพียงสมมติฐานให้ทดสอบบน repository ของคุณเอง
สิ่งที่ยังใช้ได้แม้มีข้อแม้นั้นคือรูปร่างของมัน และรูปร่างนี่แหละที่กฎการจัดเส้นทางต้องการ tier ราคาถูกยืนได้ด้วยตัวเองกับงานที่ขอบเขตชัดและทำซ้ำได้ ในต้นทุนเพียงเสี้ยวเดียว ส่วนคำกล่าวอ้างของ Anthropic เองสำหรับ Opus 5.5 ไม่ได้พูดถึงราคาต่องานเลย: ต้นทุนการรันต่ำกว่า Opus 5 อยู่ 40% เอาต์พุตเร็วกว่าราว 30% เอาต์พุตสูงสุด 128k และทำงานต่อเนื่องได้ 18 ชั่วโมงขึ้นไป คำอธิบายเหล่านี้บ่งบอกถึงโมเดลที่คุณใช้กับงานยาว ๆ ที่น่าเบื่อ ไม่ใช่โมเดลที่คุณใช้กับงานเล็ก ๆ ร้อยงาน
กฎฉบับเขียนออกมาแล้ว
นี่คือชิ้นงานจริง มันจงใจให้ดูน่าเบื่อ และควรอยู่ที่ที่ทีมอ่านเห็น ไม่ใช่ในไฟล์ config ส่วนตัวบนแล็ปท็อปเครื่องเดียว
ROUTING RULE  (owner: platform, review: end of Sprint)

Tier 1  Runtime: Codex on gpt-6-luna
  Triage, labelling, changelog and release notes, first-pass review
  comments, test scaffolding, dependency bumps, doc edits.
  Rule of thumb: if a wrong answer costs a reviewer one minute, route here.

Tier 2  Runtime: Codex on gpt-6-sol           <- default
  Bounded feature work, bug fixes with a reproduction, refactors inside
  one module, anything repeated many times a day and cheap to retry.

Tier 3  Runtime: Claude Code on claude-opus-5-5
  Migrations, cross-cutting refactors, work that must hold context for
  hours, anything where stopping halfway costs more than the tokens.

ESCALATION
  A Tier 1 or Tier 2 Task that fails twice returns to the Task with its
  log and does NOT silently re-run on Tier 3. A person moves it.

EXCEPTIONS
  Named on the Task, with a reason, by the Assignee. Not in a DM.
สามบรรทัดนี้ทำงานหนักจริง tier ค่าเริ่มต้นถูกระบุชื่อไว้ งานที่ไม่มีใครคิดถึงจึงตกไปอยู่ที่ที่สมเหตุสมผล การ escalate ชัดเจน ความล้มเหลวจากตัวถูกจึงไม่ไหลบ่าไปกลายเป็นความล้มเหลวราคาแพงโดยไม่มีใครรู้ และข้อยกเว้นถูกบันทึกไว้บน Task ซึ่งเป็นความต่างระหว่างกฎกับข้อเสนอแนะ
การ escalate คือครึ่งที่ทีมมักข้ามไป
การประหยัดในตารางข้างบนเป็นของจริงต่อการลองหนึ่งครั้ง แต่มันจะหายไปถ้าการลองแบบถูก ๆ กลายเป็นเรื่องปกติที่จะต้อง retry แพง ๆ บวกกับคนเข้าไปช่วย เพราะคุณต้องจ่ายทั้งสองรอบบวกกับการรบกวน นี่คือจุดล้มเหลวของ fallback chain แบบอัตโนมัติ: มันซ่อนต้นทุนของ tier ถูกไว้ในบิลของ tier แพง และไม่มีใครเห็นอัตราแลกเปลี่ยน
ดังนั้นทำให้การ escalate เป็นแบบคนตัดสินและมองเห็นได้ การรันที่ล้มเหลวจะกลับไปที่ Task พร้อม log, diff ที่ทำได้ถึงตอนนั้น และคำถามที่มันติดอยู่ คนเป็นคนตัดสินใจว่าจะจัดเส้นทางขึ้น tier ที่สูงกว่า แยกงานออก หรืออธิบายให้ชัดขึ้น Agent ค้นคว้า ลงมือ ทดสอบ และรายงาน คนกำหนดทิศทาง มอบอำนาจ และรับผลลัพธ์ ถ้าเส้นทางการ escalate ของคุณคือ retry loop แปลว่าคุณ automate ไปแล้วในสิ่งที่ต้องการคนตัดสินใจจริง ๆ
อีกเรื่องที่ควรจับตาก่อนจะจัดงานที่อ่อนไหวต่อ latency ลงไปที่ tier ต่ำ Artificial Analysis ซึ่งเป็นบุคคลที่สาม ไม่ใช่ผู้ขายรายใด วัด reasoning variant ระดับ "max" ได้ 115.2 output token ต่อวินาทีสำหรับ Sol โดยใช้เวลา 102.15 วินาทีถึง token แรก และ 153.9 token ต่อวินาทีสำหรับ Luna ที่ 124.23 วินาที ยืนยันตัวเลขเหล่านี้กับรายการปัจจุบันก่อนนำไปใช้ [VERIFY] รูปร่างนี่แหละคือประเด็น: ที่ reasoning effort สูงสุด โมเดลถูกไม่ใช่โมเดลที่เริ่มต้นเร็ว และ Agent ที่กำลังคิดเป็นร้อยวินาทีก็ดูเหมือน Agent ที่ค้างไปแล้วทุกประการ ไม่ว่าคุณจะจัดเส้นทางไป tier ไหน วิธีที่ Runtime ส่งสัญญาณความคืบหน้าและความล้มเหลว เป็นตัวตัดสินว่ามีใครสังเกตเห็นความต่างหรือไม่
เมื่อไรที่ไม่ควรเขียนกฎการจัดเส้นทาง
ถ้าคุณรัน agent ตัวเดียวบน repository เดียว ไม่ต้องทำอะไรพวกนี้เลย เลือก tier ที่เหมาะกับงานของคุณแล้วไปต่อ การจัดเส้นทางมีต้นทุนคือเอกสารที่ต้องดูแลและการต้องเถียงกัน และมันคืนทุนก็ต่อเมื่อมี Agent หลายตัวรันพร้อมกัน และต้นทุนหรือรูปแบบความล้มเหลวของแต่ละตัวต่างกัน
เกณฑ์คร่าว ๆ คือแบบนี้: เขียนกฎเมื่อมีคนสองคนขึ้นไปที่เริ่มการรันได้ หรือเมื่อมีงบก้อนเดียวคุม Agent ที่ทำงานพร้อมกันหลายตัว ต่ำกว่านั้นกฎก็เป็นภาระเกินจำเป็น สูงกว่านั้นการไม่มีกฎคือเหตุผลที่ไม่มีใครอธิบายบิลเดือนที่แล้วได้
ตัวเลขที่ไม่ขยับ
ต้นทุนต่องานที่เสร็จลดลงอย่างหนักทั้งสองฝั่งของการเปิดตัวครั้งนี้ เพื่อให้เห็นขนาด OpenAI รายงานว่านักวิจัยค่ามัธยฐานใช้จ่ายมากกว่า $600 ต่อวันกับ coding agent โดยเปอร์เซ็นไทล์ที่ 90 อยู่ที่ $7,000 ทีมที่อยู่ต่ำกว่าเส้นนั้นเพิ่งได้งาน agent ที่เสร็จแล้วมากกว่าหลายเท่าในงบเท่าเดิม ซึ่งคุ้มที่จะติดตามต่อ Runtime ไม่ใช่ต่อใบแจ้งหนี้
แต่พวกเขาไม่ได้ชั่วโมงรีวิวเพิ่มขึ้นแม้แต่ชั่วโมงเดียว การจัดเส้นทางเป็นคันโยกด้านต้นทุนและด้านความน่าเชื่อถือ ไม่ใช่คันโยกด้านปริมาณงาน เพราะคิวงานที่รอคนมารับยังเท่าเดิม สิ่งที่การจัดเส้นทางทำได้คือทำให้คิวนั้นอ่านออก: diff นี้ tier ไหนสร้าง ต้นทุนเท่าไร ลองไปกี่ครั้ง และ Task ที่ล้มเหลวสองครั้งตอนนี้อยู่ใน Inbox ของใครสักคนหรือไม่มีอยู่ที่ไหนเลย ถ้าคุณเก็บ goal, การรัน, ต้นทุน, อุปสรรค และการรีวิวไว้บน Task ตั้งแต่คำขอจนถึงปล่อยของ กฎการจัดเส้นทางก็จะกลายเป็นตั้งค่าที่ทีมช่วยกันแก้ไข ไม่ใช่นิสัยที่คนหกคนเก็บไว้คนเดียว
Sharkly ไม่ได้รันโมเดลและไม่ได้เลือกโมเดลให้คุณ มันคือชั้นของ Task, Computer, context และการรีวิวที่ใช้ร่วมกัน ล้อมรอบเครื่องมือที่รันโมเดลจริง ซึ่งเป็นที่ที่กฎการจัดเส้นทางต้องอยู่ ถ้ามันจะอยู่ยืนยาวกว่าคนที่เขียนมัน ถ้าคุณรัน coding agent หลายตัวอยู่แล้ว โมเดลไหนได้งานไหน และagent ตัวไหนได้งานนั้น คือการตัดสินใจเดียวกันที่มองจากสองด้าน เชื่อมต่อ Computer หนึ่งตัว สร้าง Agent หนึ่งตัวต่อ tier แล้วมอบงานน่าเบื่อ ๆ ให้ตัวถูกสักอย่าง


