
สรุปสั้น ๆ (TL;DR): ทีม AI Agent ของ OpenAI ได้เปลี่ยนเป้าหมายการตรวจสอบ 5,034 จุดใน Linux kernel ให้กลายเป็น exploit ยกระดับสิทธิ์ระดับเครื่อง (Local Privilege Escalation - LPE) ที่ไม่ซ้ำกันถึง 948 รายการ โดยใช้เครดิต API ไปราว 1.2 ล้านดอลลาร์สหรัฐ จากนั้นนักวิจัยที่เป็นมนุษย์จึงเข้ามาตรวจสอบผลลัพธ์ คุณสามารถนำโมเดลการทำงานรูปแบบนี้ไปปรับใช้กับโค้ดของทีมคุณเองได้ โดยให้ Agent ทำหน้าที่สอดแนมส่วนที่เข้าถึงได้ วิเคราะห์ความเสี่ยง พิสูจน์ช่องโหว่แต่ละจุดในสภาพแวดล้อมแยกเดี่ยว และร่างโค้ดแก้ไข จากนั้นให้นักพัฒนาที่เป็นมนุษย์เป็นผู้อนุมัติขั้นสุดท้าย
เมื่อวันที่ 4 พฤศจิกายน 2026 OpenAI ได้เผยแพร่บทความ “A thousand fewer paths to root” ซึ่งพาดหัวหลักคือการค้นพบ 948 ช่องโหว่บน Linux แต่บทเรียนสำคัญสำหรับทีมพัฒนาซอฟต์แวร์ที่ซ่อนอยู่เบื้องหลังคือ ผลลัพธ์นี้เกิดจากการทำงานร่วมกันของ Agent เฉพาะทางที่แบ่งการทำงานเป็นขั้นตอน โดยแต่ละขั้นจะส่งต่อหลักฐานไปยังขั้นถัดไป และมีมนุษย์คอยตรวจสอบในขั้นตอนสุดท้าย
แนวคิดการออกแบบนี้ไม่ได้จำกัดอยู่แค่ความเชี่ยวชาญระดับเคอร์เนลเท่านั้น คุณจึงสามารถนำโครงสร้างแบบเดียวกันนี้ไปประยุกต์ใช้กับเซอร์วิสของคุณเองได้ ความเร่งด่วนนี้เป็นเรื่องจริง เพราะ OpenAI ระบุว่าไปป์ไลน์นี้ “ทำกำไรสุทธิได้จริง” เมื่อเทียบกับเงินรางวัล Bug Bounty สาธารณะ ฝ่ายผู้โจมตีเองก็คำนวณความคุ้มค่าแบบนี้ได้เช่นกัน ดังนั้นจึงควรเริ่มลงมือตั้งแต่วันนี้
สิ่งที่ทีม AI Agent ของ OpenAI ค้นพบ
OpenAI ได้รันไปป์ไลน์นี้ในช่วงกลางเดือนตุลาคม 2026 กับ Linux kernel เวอร์ชันล่าสุด โดยใช้โมเดลด้านไซเบอร์รุ่นใหม่ที่กำลังจะเปิดตัว เป้าหมายที่ใช้ทดสอบคือ VM แบบแยกเดี่ยวที่รันระบบปฏิบัติการเดสก์ท็อปมาตรฐานพร้อมเปิดระบบป้องกันไว้ครบถ้วน
| ขั้นตอน | ผลลัพธ์ | ค่าใช้จ่าย API |
|---|---|---|
| สอดแนม (Scout) | เป้าหมายการตรวจสอบ 5,034 รายการ, โค้ดราว 2.8 ล้านบรรทัด, คิดเป็นประมาณ 7% ของเคอร์เนล | $3,426 |
| วิเคราะห์ (Analyze) | ข้อค้นพบที่เข้าข่าย 2,308 รายการ | $316,549 |
| ยืนยันผล (Validate) | ทำซ้ำสำเร็จ 1,724 รายการ (ราว 74.7%) | $73,330 |
| ประเมินโอกาสการโจมตี (Assess exploitability) | 948 exploit ยกระดับสิทธิ์ (LPE) ที่ไม่ซ้ำกัน, 291 PoC ช่องโหว่ข้อมูลรั่วไหล | $820,123 |
| รวมทั้งสิ้น | $1,213,430 |
ตัวเลขเหล่านี้เป็นสเกลระดับเคอร์เนลของ OpenAI ไม่ใช่ตัวเลขประเมินสำหรับคลังโค้ดของคุณ ทาง OpenAI กล่าวว่าค่าใช้จ่ายนี้นับเป็น “เพดานสูงสุด (Upper Bound)” เสียมากกว่า เพราะการทดสอบนี้มุ่งวัดขีดความสามารถ ไม่ได้เน้นเรื่องความคุ้มค่าหรือประสิทธิภาพ
มีข้อจำกัด 3 ประการที่ควรตระหนักไว้:
- ช่องโหว่เหล่านี้เป็นช่องโหว่ยกระดับสิทธิ์ระดับเครื่อง (LPE): ผู้โจมตีจำเป็นต้องเข้าถึงเครื่องในเบื้องต้นให้ได้ก่อน ช่องโหว่เหล่านี้จึงไม่ใช่ช่องโหว่สำหรับการโจมตีระยะไกล (Remote Exploit) ในตัวเอง
- หลายรายการยังไม่ได้รับการแก้ไข: เมื่อสิ้นสุดการสแกนและวิเคราะห์นาน 10 วัน มีช่องโหว่ LPE เพียง 61 รายการที่ได้รับการแพตช์ในโครงการต้นน้ำ (Upstream), 43 รายการมีแพตช์ใน Staging และ 299 รายการกำลังอยู่ระหว่างการหารือในที่สาธารณะ โดย OpenAI ได้ส่งรายงานและแพตช์สำหรับช่องโหว่ระดับวิกฤตไปแล้วหลายร้อยรายการ และกำลังทยอยส่งส่วนที่เหลือร่วมกับพาร์ทเนอร์ในโครงการ Patch the Planet
- บทความของ OpenAI ไม่ได้ระบุว่ามีการนำช่องโหว่เหล่านี้ไปใช้โจมตีจริงในโลกภายนอก (In the wild)
ถึงกระนั้น คำแนะนำของ OpenAI ก็ยังคงตรงไปตรงมา โดยระบุว่าบนระบบปฏิบัติการที่ไม่ได้อัปเดตแพตช์ล่าสุด บัญชีผู้ใช้ที่ได้รับสิทธิ์ระดับต่ำ “ควรถูกมองว่ามีค่าเทียบเท่ากับการเข้าถึงสิทธิ์ระดับ root สำหรับผู้คุกคามที่มีทรัพยากรพร้อม” ดังนั้นจึงควรอัปเดตแพตช์อยู่เสมอ และจำกัดรัศมีความเสียหาย (Blast Radius) ด้วยระบบแยกสภาพแวดล้อม เช่น Firecracker และ gVisor
5 ขั้นตอนของเวิร์กโฟลว์ความปลอดภัยด้วย AI Agent
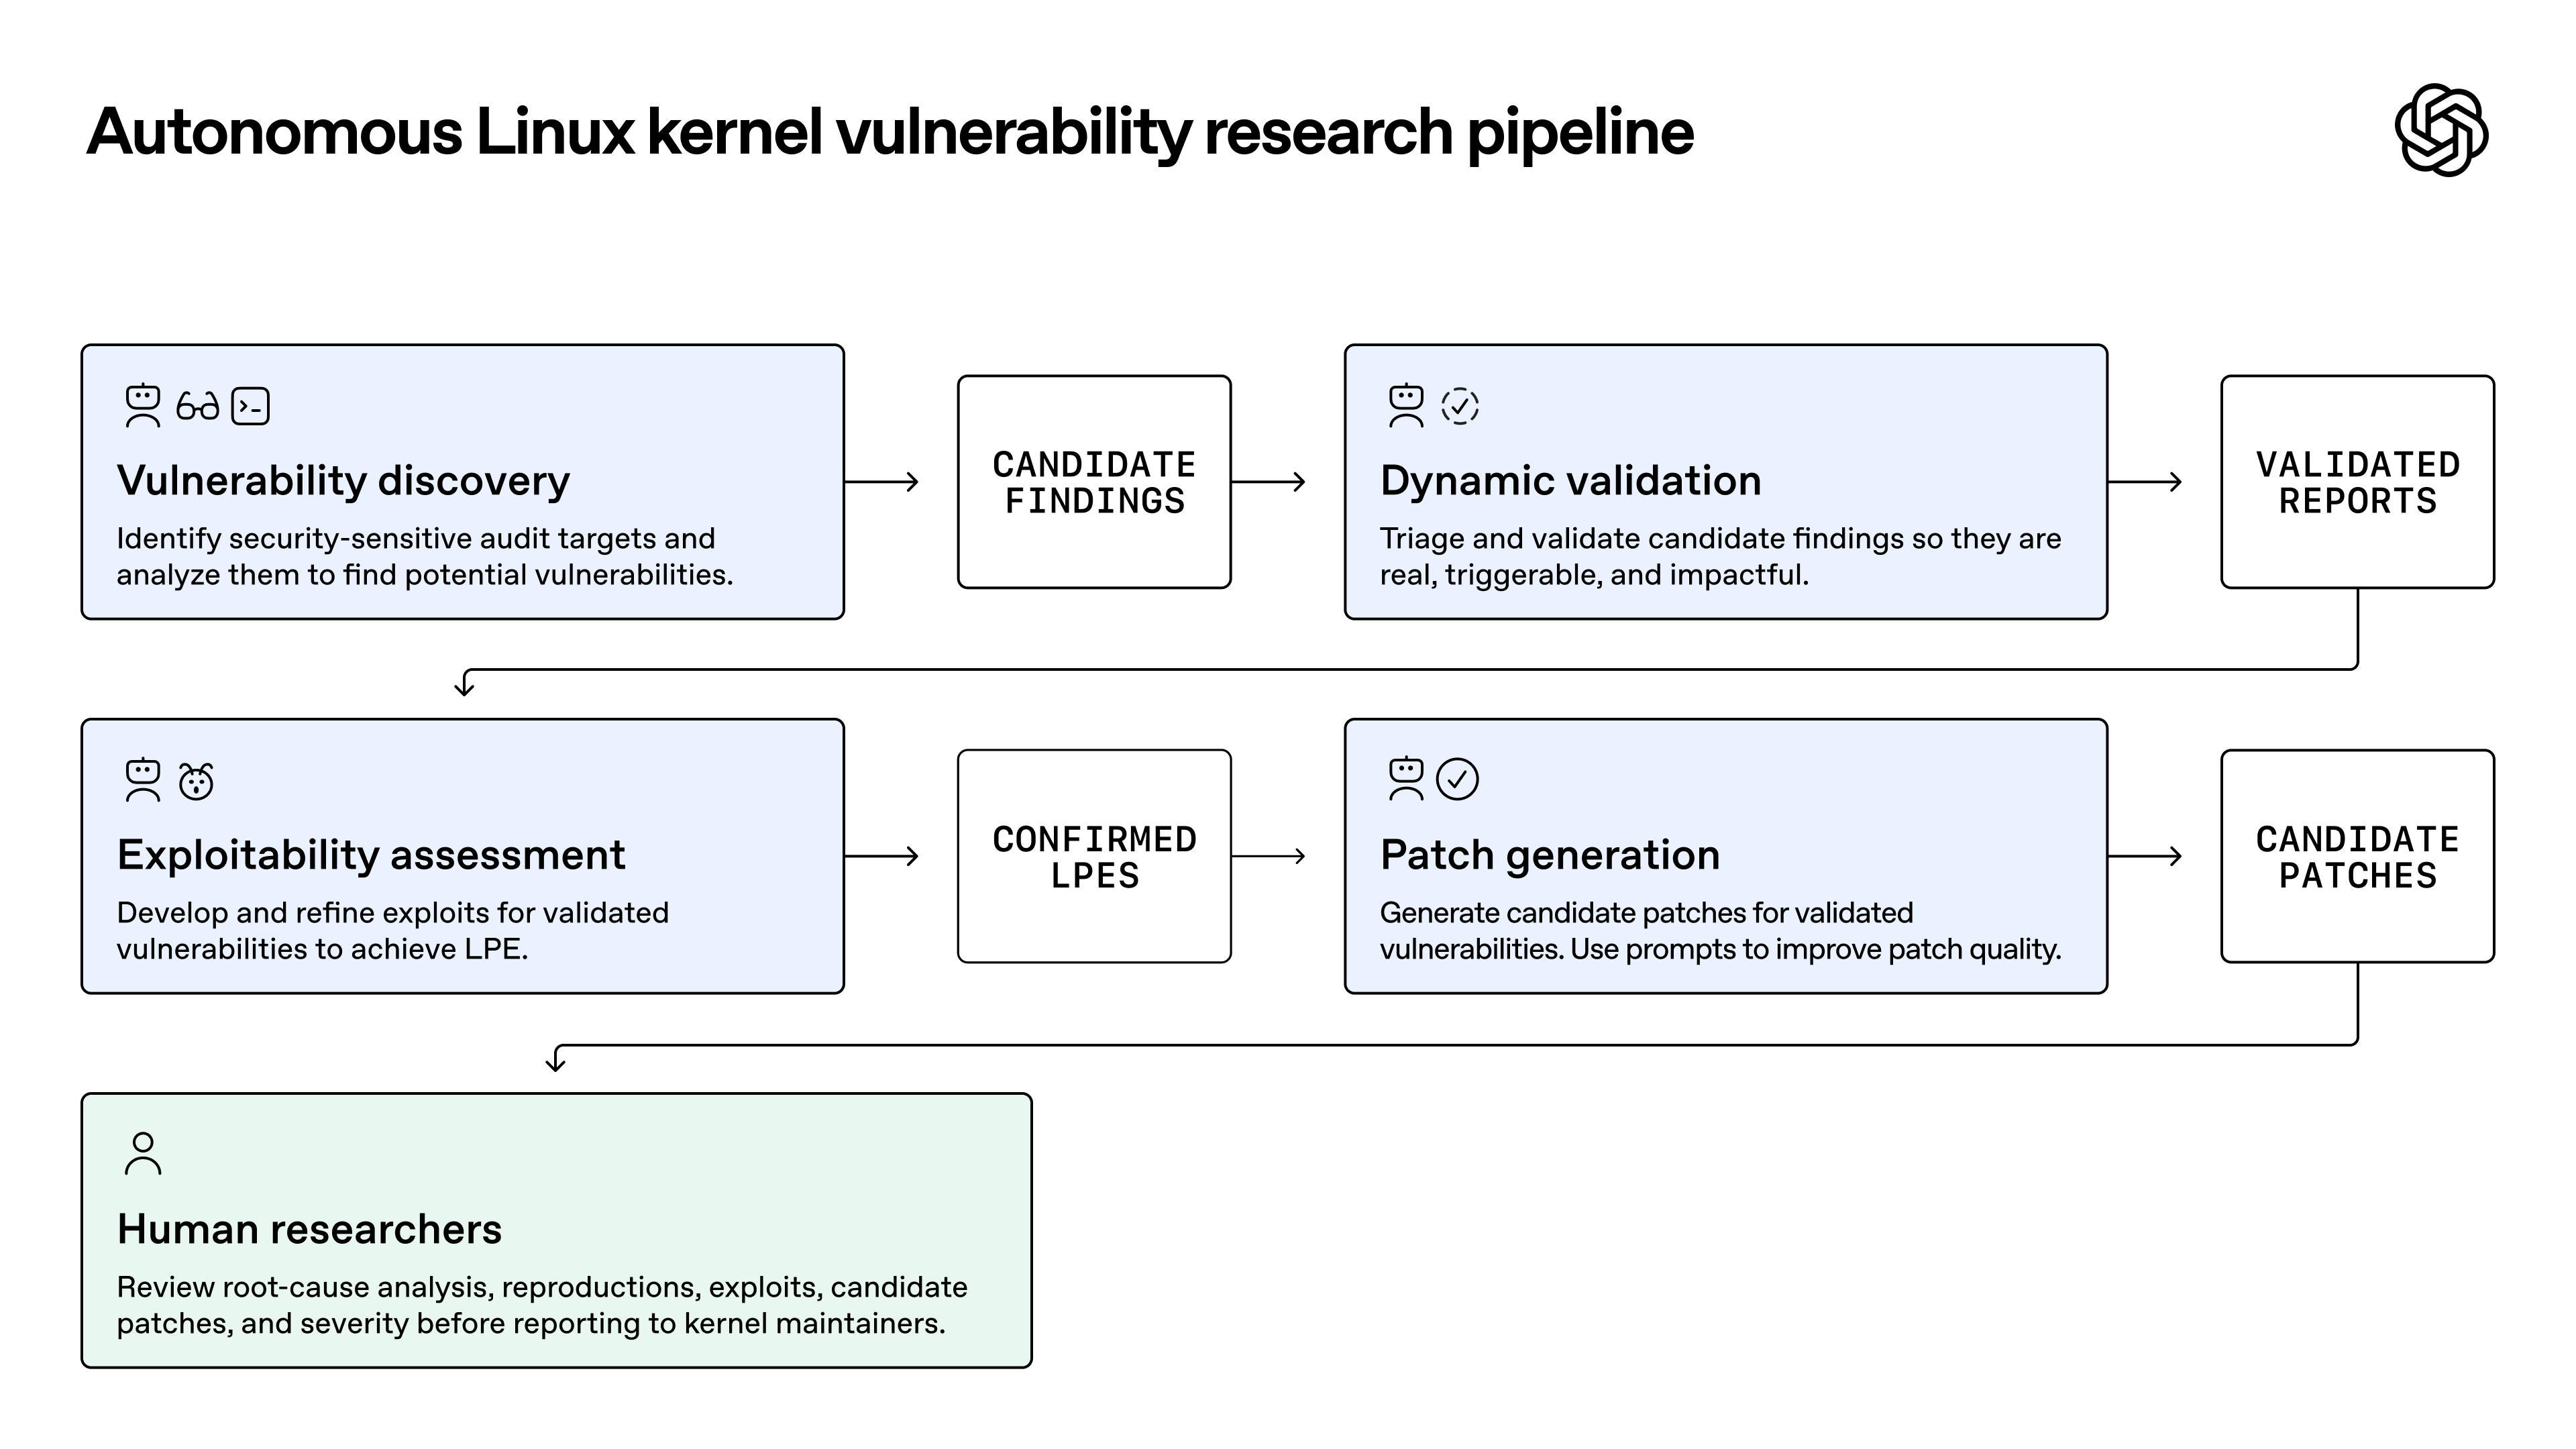
เวิร์กโฟลว์ความปลอดภัยด้วย AI Agent จะแบ่งการตรวจสอบออกเป็นขั้นตอน โดยแต่ละขั้นจะคัดกรองงานให้แคบลงและสร้างหลักฐานส่งต่อไปยังขั้นถัดไป ในเวอร์ชันของ OpenAI มีทั้งหมด 5 ขั้นตอน ได้แก่:
- การค้นหา (Discovery): Scout Agent จะคัดเลือกเป้าหมายที่จะตรวจสอบจากความสามารถในการเข้าถึงและความเกี่ยวข้องด้านความปลอดภัย จากนั้น Analyst Agent จะอ่านโค้ดของแต่ละเป้าหมาย สร้างแบบจำลองภัยคุกคาม (Threat Model) และรายงานข้อค้นพบที่เข้าข่าย
- การยืนยันผลเชิงรุก (Dynamic validation): Triage Agent จะเขียนโค้ด Proof of Concept (PoC) และรันใน VM แบบแยกเดี่ยวด้วย KASAN ซึ่งเป็นเครื่องตรวจจับข้อผิดพลาดของหน่วยความจำในเคอร์เนล โดยจะปรับปรุงโค้ดทดสอบไปเรื่อย ๆ จนกว่าจะทำซ้ำบั๊กได้สำเร็จหรือหมดหนทาง
- การประเมินโอกาสการโจมตี (Exploitability assessment): Screening Agent จะคัดกรองข้อค้นพบที่ไม่มีความเป็นไปได้ในทางปฏิบัติออกไป จากนั้น ExploitDev Agent จะทดสอบส่วนที่เหลือ
- การสร้างแพตช์แก้ไข (Patch generation): Agent จะร่างแพตช์สำหรับบั๊กแต่ละจุดที่ยืนยันแล้ว โดยยึดตามแบบแผนการเขียนโค้ดของจุดนั้น ๆ พร้อมทั้งตรวจสอบหาบั๊กลักษณะเดียวกันในส่วนอื่น (Variants)
- การตรวจสอบโดยมนุษย์ (Human review): นักวิจัยด้านความปลอดภัยจะตรวจสอบทั้ง Exploit, แพตช์แก้ไข และระดับความรุนแรง ก่อนที่จะส่งต่อไปยังผู้ดูแลระบบ (Maintainers)
การส่งต่องานในแต่ละขั้นจะยึดหลักฐานเป็นหลัก ไม่ใช่ความคิดเห็น ดังนั้นมนุษย์ที่อยู่ปลายทางจึงตัดสินใจบนพื้นฐานของข้อเท็จจริง
วิธีนำแต่ละขั้นตอนไปปรับใช้กับคลังโค้ดของคุณ
ควรใช้เวิร์กโฟลว์นี้กับโค้ดที่คุณเป็นเจ้าของหรือได้รับอนุญาตให้ทดสอบเท่านั้น สำหรับคลังโค้ดของคุณ ให้ตัดขั้นตอนการสร้าง Exploit ออกไปได้เลย เพราะเพียงแค่การเขียนชุดทดสอบที่ล้มเหลว (Failing Test) ก็เพียงพอที่จะพิสูจน์ข้อบกพร่องได้แล้ว โดยไม่จำเป็นต้องสร้างเครื่องมือโจมตีขึ้นมา
| ขั้นตอนของ OpenAI | เวอร์ชันของคุณ | ผลลัพธ์ |
|---|---|---|
| Scout | ลิสต์จุดเริ่มต้นที่ผู้ใช้ทั่วไปหรือผู้ใช้สิทธิ์ต่ำเข้าถึงได้ เช่น routes, webhooks, ระบบอัปโหลด, parsers, queue consumers | รายการที่ต้องตรวจสอบ (Audit list) |
| Analyst | หนึ่งเป้าหมายต่อการรันหนึ่งครั้ง: อ่านโค้ด, เขียนโมเดลภัยคุกคามแบบสั้น, รายงานข้อบกพร่องที่น่าสงสัย | ข้อค้นพบที่เข้าข่าย (Candidate findings) |
| Validate | เขียนชุดทดสอบที่ล้มเหลวแบบเรียบง่ายที่สุดในสภาพแวดล้อมที่ทิ้งได้ทันที (Disposable environment) | ชุดทดสอบพร้อมบันทึกการทำงาน (Log) |
| Assess | ประเมินผลกระทบตามขอบเขตความน่าเชื่อถือ (Trust Boundary) ที่ถูกก้าวข้าม | ระดับความรุนแรงพร้อมเหตุผลประกอบ |
| Patch | ร่างโค้ดแก้ไขเป็น Pull Request พร้อมแนบชุดทดสอบไปด้วย | Pull Request |
| Human | ตรวจสอบ จากนั้นกด Merge หรือ Reject | โค้ดแก้ไขที่ถูกผสาน (Merged) หรือการปิดเคสข้อค้นพบ |
การกำหนดขอบเขตงานให้ชัดเจนช่วยประหยัดค่าใช้จ่ายได้มหาศาล ขั้นตอนสอดแนม (Scout) ของ OpenAI ใช้เงินไปเพียง $3,426 แต่สามารถจำกัดการตรวจสอบเหลือเพียงราว 7% ของเคอร์เนล แนะนำให้เริ่มต้นจากเซอร์วิสเดียวและสำรวจเฉพาะจุดเริ่มต้นสาธารณะของมัน งานสำหรับข้อค้นพบหนึ่งรายการสามารถเขียนให้กระชับได้ดังนี้:
Title: Validate finding: path traversal in /api/exports/download

Scope: this repository only. Disposable test environment only.
No production credentials, no external network targets.

Goal: write a minimal failing test that proves or disproves the finding.
Evidence: test file, command output, code path from entry point to flaw.
Give up: stop after two approaches with no new evidence. Report what you tried.
Do not: fix the bug here, build an attack payload, or merge anything.
ตรวจสอบเส้นทาง ไม่ใช่ดูแค่ผลลัพธ์
ในการทดสอบช่วงแรก ขั้นตอนการสร้าง Exploit ของ OpenAI รายงานผลสำเร็จ 200 รายการ แต่เมื่อมนุษย์เข้าไปตรวจสอบกลับพบว่ามี 20 รายการที่ได้สิทธิ์ root ผ่านช่องโหว่ 0-day อื่นที่ไม่ใช่จุดที่ได้รับมอบหมาย ไปป์ไลน์ตัดสินความสำเร็จจากผลลัพธ์สุดท้าย ซึ่งผลลัพธ์นั้นถูกต้องแต่มาจากสาเหตุที่ผิด
OpenAI จึงรัดกุมข้อกำหนดของงานให้เข้มงวดยิ่งขึ้น และเพิ่มการตรวจสอบแยกต่างหากเพื่อยืนยันว่า Exploit แต่ละตัวใช้ช่องโหว่ตามที่ได้รับมอบหมายจริง บทเรียนสำคัญคือ: จงตรวจสอบเส้นทางที่นำไปสู่ผลลัพธ์ควบคู่ไปกับตัวผลลัพธ์เสมอ
ในฝั่งของทีมคุณเองก็อาจเจอกรณีคล้ายกัน เช่น Agent บอกว่าชุดทดสอบพิสูจน์ช่องโหว่ด้านการยืนยันตัวตนได้แล้ว แต่แท้จริงแล้วชุดทดสอบกลับพังเพราะขาด fixture วิธีแก้คือให้เพิ่ม Check Agent ที่ไม่ได้เป็นคนเขียนชุดทดสอบขึ้นมาอีกตัว แล้วตั้งคำถามเดียวว่า: ความล้มเหลวนี้เกิดจากเส้นทางของโค้ดที่รายงานไว้จริงหรือไม่?
ตรวจสอบตั้งแต่เนิ่น ๆ เพราะ False Positive ก็มีค่าใช้จ่ายเท่ากัน
OpenAI พบว่าต้นทุนในการพยายามตรวจสอบผลที่ถูกต้อง (True Positive) กับผลลวง (False Positive) นั้นแทบไม่ต่างกันเลย ดังนั้นทุกข้อค้นพบที่ไม่ถูกต้องแต่หลุดเข้ามาถึงขั้นตรวจสอบ ก็จะผลาญค่าใช้จ่ายในการรันไปแบบเต็ม ๆ
จงคัดกรองก่อนที่จะลงมือพิสูจน์ OpenAI จะเลือกตรวจสอบเฉพาะข้อค้นพบที่ผู้ใช้สิทธิ์ต่ำเข้าถึงได้ ไม่ต้องใช้ความสามารถพิเศษ และสามารถสร้างหลักฐานที่วัดผลได้จริง สำหรับโค้ดของคุณ ให้สร้างเกณฑ์คัดกรองในลักษณะเดียวกัน เช่น “ต้องเข้าถึงได้โดยไม่ต้องมีสิทธิ์ผู้ดูแลระบบ (Admin)” ข้อค้นพบใดที่ไม่ผ่านเกณฑ์เหล่านี้ก็จะถูกปิดเคสไปพร้อมระบุเหตุผล
จากนั้นให้ตรวจสอบข้อค้นพบซ้ำกับโค้ดเวอร์ชันล่าสุดก่อนรายงานเสมอตามที่ OpenAI แนะนำ เพื่อหลีกเลี่ยงการรายงานซ้ำซ้อนหรือรายงานในส่วนที่โค้ดล้าสมัยไปแล้ว
ตั้งเงื่อนไขยอมแพ้ (Give-up Rule) ไว้ล่วงหน้าก่อนเริ่มรัน
การพยายามที่ล้มเหลวคือส่วนที่สิ้นเปลืองงบประมาณมากที่สุด สำหรับกลุ่มเป้าหมาย LPE นั้น การทดสอบที่ล้มเหลว 69 ครั้งมีค่าใช้จ่ายเฉลี่ยสูงถึง $3,922 ต่อครั้ง ในขณะที่การทดสอบที่สำเร็จ 1,169 ครั้งมีค่าเฉลี่ยเพียง $360 ต่อครั้ง เมื่อคำนวณดูแล้ว นั่นหมายถึงการทดสอบเพียงราว 6% ของทั้งหมด กลับกินงบประมาณไปถึงประมาณ 39% จากงบรวม $691,000 ที่ใช้ไปในขั้นตอนนี้
ทางออกที่ OpenAI แนะนำคือการกำหนดเงื่อนไขการยอมแพ้ (Give-up Condition) เช่น ให้หยุดทำงานหากผ่านไปหนึ่งชั่วโมงแล้วไม่มีความคืบหน้า ให้เขียนกฎข้อนี้ลงในคำสั่งของงาน และควบคุมด้วยการจำกัดเวลาสูงสุด (Hard Limit) ของการรันไว้ควบคู่กัน
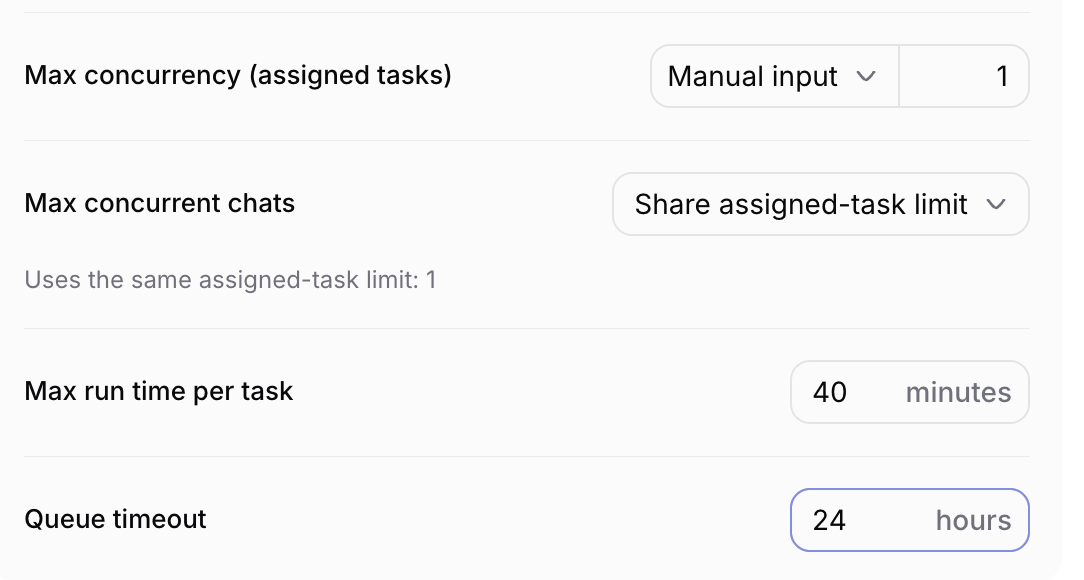
ใน Sharkly การตั้งค่าระยะเวลาหมดเวลาต่อหนึ่งงานจะอยู่ใน Run settings ของ Agent ซึ่งเป็นการกำหนดเพดานเวลา ไม่ใช่ตัวตรวจจับความคืบหน้า ดังนั้นจึงควรระบุกฎ “หากไม่มีหลักฐานใหม่ให้หยุด” ไว้ในคำสั่งการทำงานเสมอ
ลดความซับซ้อนของระบบประสานงานลงเมื่อโมเดลเก่งขึ้น
OpenAI เคยสร้างเลเยอร์เทคนิคการโจมตีไว้ถึง 103 รูปแบบสำหรับ GPT-5.5 Cyber ซึ่งช่วยเพิ่มอัตราความสำเร็จจาก 76.2% เป็น 88.9% แต่เมื่อนำเลเยอร์เดียวกันนี้ไปใช้กับ GPT-5.6 Cyber กลับเพิ่มประสิทธิภาพได้เพียง 1.5% เท่านั้น OpenAI จึงตัดสินใจถอดเลเยอร์นี้ออก
จงทดสอบโครงสร้างเสริม (Scaffolding) ของคุณใหม่ทุกครั้งที่มีการเปลี่ยนโมเดล และควรสแกนซ้ำด้วยเช่นกัน เพราะการรันในเดือนตุลาคมพบช่องโหว่ LPE ใหม่มากกว่าการรันในเดือนกรกฎาคมด้วย GPT-5.6 Sol ถึงกว่า 5 เท่า ทั้งที่เป็นโค้ดชุดเดียวกันที่ได้รับการเพิ่มความปลอดภัย (Hardening) มาอีกถึง 3 เดือน
ให้มนุษย์ตรวจสอบก่อนปล่อยขึ้นระบบเสมอ
Agent จะทำหน้าที่ร่างโค้ดแก้ไขในรูปแบบ Pull Request แต่มนุษย์จะเป็นคนกด Merge ทาง OpenAI พบว่าแพตช์ที่สร้างในรอบแรกอาจมีขนาดใหญ่เกินความจำเป็น มองข้ามรูปแบบช่องโหว่ที่คล้ายกัน หรือไม่ตรงตามแบบแผนของโค้ดเดิม และการให้ตรวจทานหลายรอบจะช่วยปรับปรุงคุณภาพของแพตช์ให้ดียิ่งขึ้น
นอกจากนี้ยังแนะนำให้ใช้โมเดลมาทำ Adversarial Review (ตรวจสอบแบบเจาะหาจุดบกพร่อง) กับทั้งแพตช์ที่เขียนโดยมนุษย์และ AI ดังนั้นคุณจึงควรให้ Agent ลองพยายามบายพาสโค้ดแก้ไขนั้นดู แล้วค่อยให้คนเป็นผู้ตัดสินใจขั้นสุดท้าย หากกระบวนการตรวจสอบโค้ดกลายเป็นคอขวดของทีมอยู่แล้ว ลองอ่าน วิธีออกแบบการตรวจสอบโค้ดสำหรับ Agent ที่ทำงานแบบคู่ขนาน ก่อนที่คุณจะเพิ่มปริมาณ Pull Request เข้ามาใหม่
วิธีนำเวิร์กโฟลว์นี้ไปรันเป็น Task ใน Sharkly
Task คือหน่วยการทำงานหลักใน Sharkly นี่คือแนวทางหนึ่งในการสร้างเวิร์กโฟลว์นี้:
- สร้าง Task Type: Task Type จะมีเวิร์กโฟลว์สถานะตามลำดับเป็นของตนเอง ตัวอย่างเช่น ประเภท “Security finding” อาจมีลำดับสถานะเป็น Candidate, Reproduced, Patch drafted, In review, Closed
- สร้าง Crew: Crew คือกลุ่มของผู้ใช้และ Agent ที่นำมาใช้ซ้ำได้ โดยมีการประสานงานผ่านลีดเดอร์ Agent ตัวเดียว ให้เพิ่ม Agent ฝั่ง Scout, Analyst, Check และ Patch เข้ามา โดยลีดเดอร์จะเริ่มทำงานก่อนแล้วค่อย Mention มอบหมายงานเฉพาะทางให้สมาชิกแต่ละตัว
- แยกสภาพแวดล้อมการรัน: ใช้ ไดเรกทอรีชั่วคราว เพื่อให้แต่ละ Task มี Worktree เป็นของตัวเอง และอ่าน คู่มือการใช้ Worktree แบบแยกเดี่ยว หากคุณต้องการรันงานพร้อมกันจำนวนมาก รวมถึงปิดการแชร์ไดเรกทอรีของ Crew ในจุดที่ Check Agent ต้องการความเป็นอิสระ
- ตั้งค่าส่งต่องานอัตโนมัติ: ใช้ Automation ที่มีตัวกระตุ้นจากสถานะของ Task เพื่อเริ่มการทำงานของ Patch Agent เมื่อ Task เปลี่ยนสถานะเป็น Reproduced การรันเหล่านี้ทำงานแบบอัตโนมัติและไม่สามารถถามคำถามได้ อีกทั้งการตรวจจับสถานะจะมีผลทั่วทั้งองค์กร ดังนั้นควรกำหนดให้คำสั่งมีการตรวจสอบ Task ต้นทางที่กระตุ้นให้แน่ชัด
- เชื่อมโยง Pull Request: เมื่อใช้ GitHub Integration การใส่ Task ID ในชื่อบรันช์, หัวข้อ หรือคำอธิบาย จะเชื่อมโยงเข้ากับ Pull Request ให้โดยอัตโนมัติ ทั้งนี้การ Merge จะไม่เปลี่ยนสถานะของ Task ดังนั้นผู้ตรวจสอบจึงต้องเป็นผู้ปิด Task ด้วยตนเอง
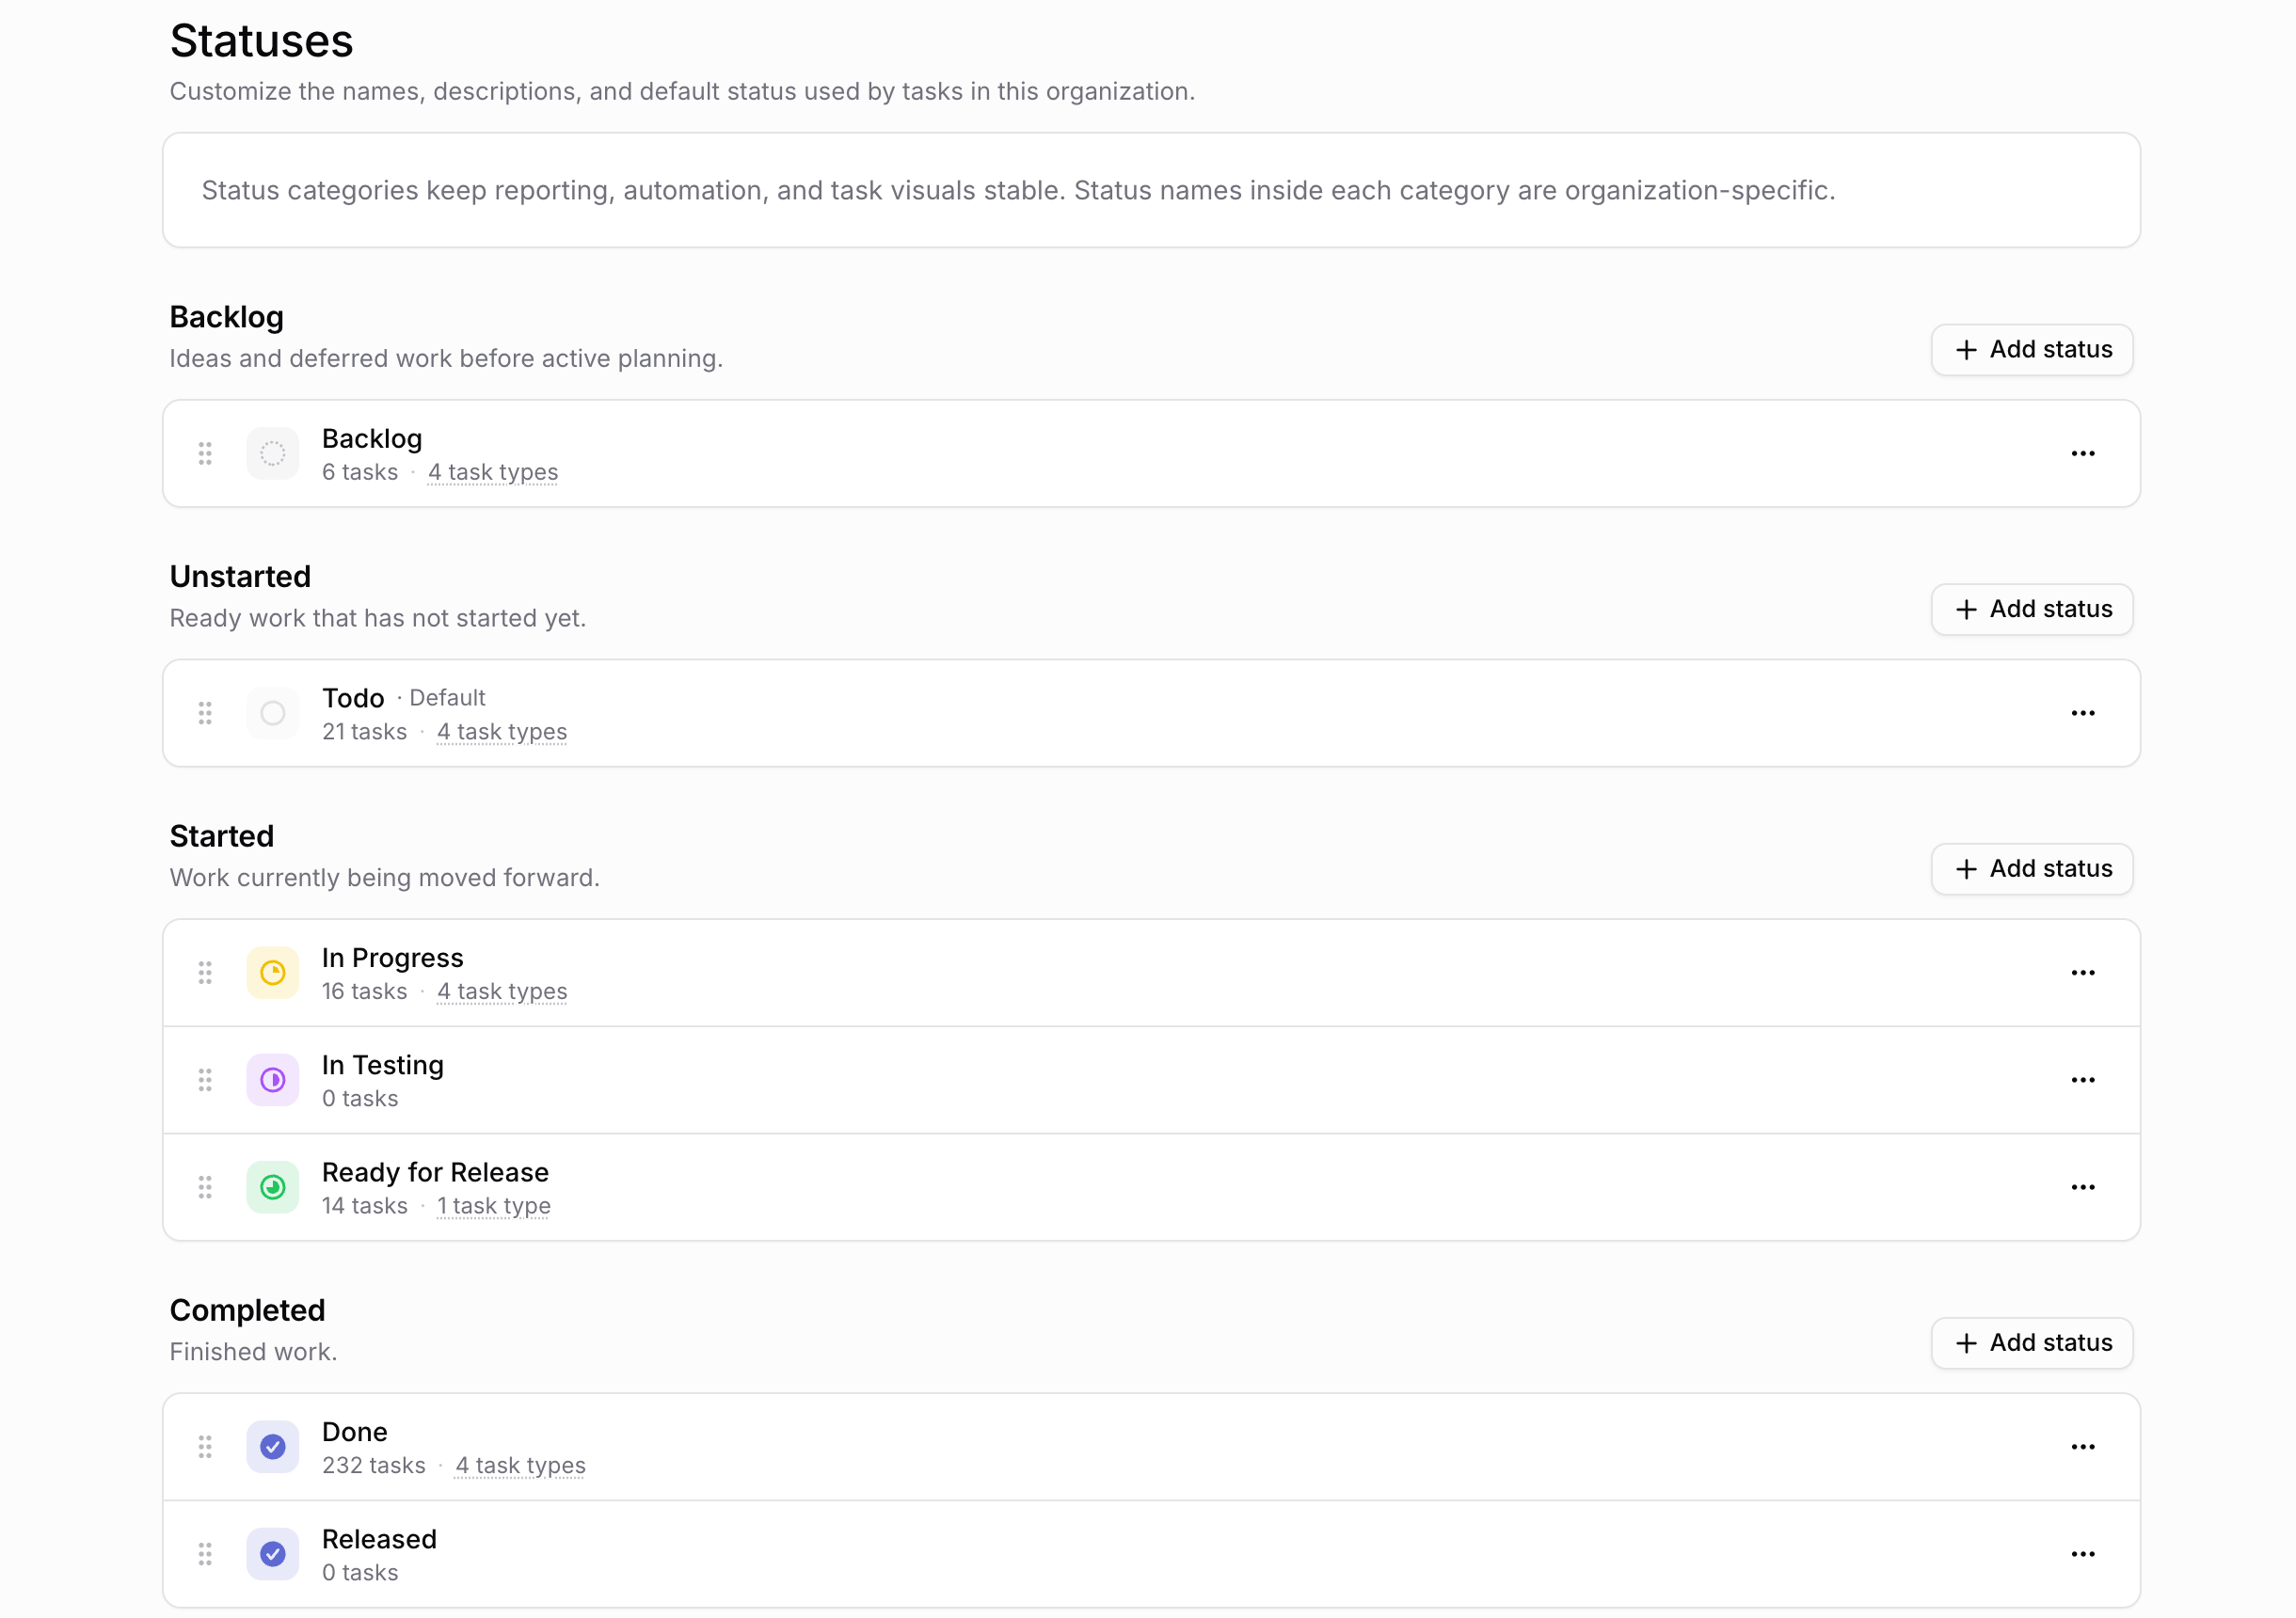
สถานะต่าง ๆ จะถูกแชร์ใช้งานทั่วทั้งองค์กร ดังนั้นจึงควรสร้างสถานะใหม่สำหรับเวิร์กโฟลว์นี้แทนที่จะเปลี่ยนชื่อสถานะเดิมที่มีอยู่
มีขอบเขตความปลอดภัยจุดหนึ่งที่ต้องระวัง: Worktree ช่วยป้องกันไม่ให้ Task ทำงานทับซ้อนกัน แต่ไม่ได้เป็น Sandbox ด้านความปลอดภัย ควรทำการทดสอบทำซ้ำในคอนเทนเนอร์หรือ VM แบบใช้แล้วทิ้งที่ไม่มีข้อมูลความลับระดับโปรดักชัน และให้สิทธิ์เข้าถึง Git แก่ Agent เท่าที่จำเป็นจริง ๆ เท่านั้น
Sharkly ทำหน้าที่เป็นศูนย์กลางประสานงานนี้ ส่วนเครื่องมืออย่าง Claude Code, Codex หรือเครื่องมืออื่น ๆ ที่คล้ายกันจะทำหน้าที่ลงมือปฏิบัติการจริง โดยการเรียกใช้โมเดลจะหักค่าใช้จ่ายผ่าน Subscription หรือ API Key ที่คุณตั้งค่าไว้ในเครื่องมือเหล่านั้น หากต้องการขยายสเกลการทำงาน สามารถดูเพิ่มเติมได้ที่ วิธีรัน AI Coding Agent พร้อมกัน 10 ตัว
สำหรับคลังโค้ดขนาดเล็ก คุณสามารถมอบหมาย Agent หนึ่งตัวต่อหนึ่ง Task ได้โดยไม่ต้องสร้าง Crew แต่ให้ใช้ Crew เมื่อลีดเดอร์จำเป็นต้องจัดลำดับการทำงานของบทบาทต่าง ๆ และรวบรวมผลลัพธ์กลับเข้ามาไว้ใน Task เดียวกัน
บทสรุป
ผลลัพธ์ของ OpenAI คือพิมพ์เขียวชั้นดีสำหรับทีมของคุณ: จำกัดขอบเขตให้แคบ, กำหนดให้ต้องมีหลักฐานในทุกขั้นตอนการส่งต่องาน, ตรวจสอบเส้นทางความถูกต้อง, ตัดจบการรันที่ไร้ทิศทางตั้งแต่เนิ่น ๆ และให้มนุษย์เป็นผู้กดปุ่ม Merge เสมอ
เริ่มต้นได้เลยในสัปดาห์นี้ เลือกเซอร์วิสที่คุณดูแลมาหนึ่งตัว ลิสต์จุดเริ่มต้นสาธารณะทั้งหมด และเปิด Task ตรวจสอบหนึ่งงานต่อหนึ่งข้อบกพร่องที่น่าสงสัย คู่มือ Sharkly’s quickstart จะช่วยให้คุณเริ่มต้นรัน Agent ตัวแรกบนเครื่องที่เชื่อมต่อไว้ และดูที่ sharkly.ai เพื่อดูว่าระบบจัดการ Task และการตรวจสอบจะช่วยเสริมการทำงานของ Agent ได้อย่างไร
คำถามที่พบบ่อย (FAQ)
Agent ของ OpenAI ได้โจมตีระบบ Linux ที่ใช้งานจริงหรือไม่?
ไม่ใช่เลย การทดสอบ Exploit ทำขึ้นใน VM แบบแยกเดี่ยวภายในสภาพแวดล้อมการวิจัยที่มีการควบคุมอย่างรัดกุม และนักวิจัยที่เป็นมนุษย์ได้ตรวจสอบผลลัพธ์ทั้งหมดก่อนที่จะรายงานไปยังภายนอก
ช่องโหว่ Linux ทั้ง 948 รายการได้รับการแก้ไขหมดแล้วหรือยัง?
ยังไม่หมด หลายรายการยังอยู่ในระหว่างการรายงานและพัฒนาแพตช์แก้ไข โดยเมื่อสิ้นสุดการสแกน 10 วัน มีช่องโหว่ 61 รายการที่ได้รับการแพตช์ในต้นน้ำ และ 43 รายการมีแพตช์ใน Staging
Exploit เหล่านี้สามารถโจมตีเซิร์ฟเวอร์จากระยะไกลได้หรือไม่?
ไม่สามารถทำได้โดยลำพัง เนื่องจากช่องโหว่เหล่านี้เป็นช่องโหว่ยกระดับสิทธิ์ระดับเครื่อง (LPE) ผู้โจมตีจึงต้องเจาะเข้าถึงเครื่องในเบื้องต้นให้ได้ก่อน ดังนั้นควรอัปเดตระบบให้เป็นปัจจุบันอยู่เสมอ และแยกสภาพแวดล้อมการทำงานของเวิร์กโหลดที่ไม่น่าไว้วางใจ
เวิร์กโฟลว์นี้จะมีค่าใช้จ่ายเท่าไรกับคลังโค้ดของฉัน?
ตัวเลขค่าใช้จ่ายของ OpenAI ไม่สามารถนำมาเปรียบเทียบกันได้โดยตรง เนื่องจากเป็นการรันกับโค้ดระดับเคอร์เนล แนะนำให้เริ่มต้นจากเซอร์วิสเดียวก่อน กำหนดขีดจำกัดการรัน และวัดค่าใช้จ่ายต่อข้อค้นพบที่ตรวจสอบแล้วหนึ่งรายการ
จำเป็นต้องใช้โมเดล Cyber ของ OpenAI หรือไม่?
ในปัจจุบันคุณยังไม่สามารถใช้งานได้ เนื่องจาก OpenAI ระบุว่าเป็นโมเดลที่กำลังจะเปิดตัวในอนาคต แต่ขั้นตอนต่าง ๆ ในเวิร์กโฟลว์นี้ไม่ได้ขึ้นอยู่กับโมเดลใดโมเดลหนึ่งโดยเฉพาะ ดังนั้นคุณจึงสามารถทดสอบด้วย Coding Agent ที่ทีมของคุณใช้งานอยู่แล้ว และตัดสินคุณภาพของผลลัพธ์จากหลักฐานที่ได้รับ


