
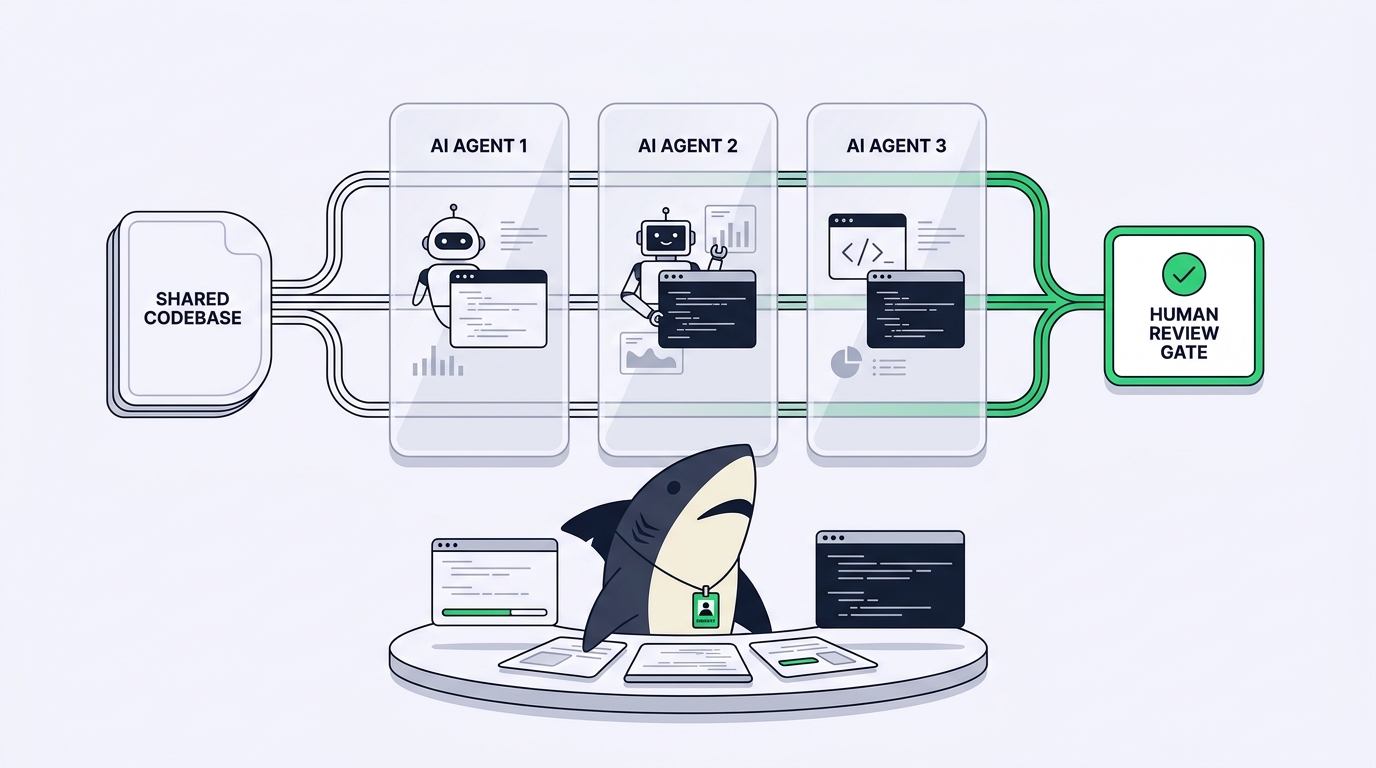
ลองรัน coding agent สองตัวใน checkout เดียวกันดูสิ รับรองว่าไม่ถึงชั่วโมงก็เจอปัญหานี้แน่ ๆ agent ตัวหนึ่งสลับ branch ในขณะที่อีกตัวกำลังแก้ไฟล์อยู่ครึ่ง ๆ กลาง ๆ การเปลี่ยนแปลงที่ stage ไว้ก็หายไปรวมกับ commit ที่มันไม่ได้เป็นส่วนหนึ่ง เทสต์ผ่านทั้งที่รันกับไฟล์ที่ agent อีกตัวเขียนทับไปครึ่งหนึ่ง ทั้งหมดนี้ไม่ใช่ความผิดของโมเดลเลย git working tree คือ shared mutable state และเมื่อมีสองโปรเซสมาปรับแก้ state ที่แชร์กันโดยไม่ประสานงานกัน สุดท้ายมันก็ต้องพัง
วิธีแก้มาตรฐานเป็นที่รู้กันดีอยู่แล้ว คือให้ working tree ของตัวเองแก่ agent แต่ละตัว Git worktree ทำให้ repository เดียวรองรับไดเรกทอรีที่เช็คเอาท์ไว้หลายตัวพร้อมกันได้ ดังนั้น branch ที่ทำงานขนานกันจะไม่แตะไฟล์เดียวกันบนดิสก์เลย หลายทีมเขียนสคริปต์ทำเองด้วยมือ ส่วนคู่มือการใช้ git worktree กับ AI coding agentของเราก็อธิบายการตั้งค่าแบบ DIY ไว้ครบถ้วนแล้ว
โพสต์นี้จะพูดถึงอีกเส้นทางหนึ่ง นั่นคือเกิดอะไรขึ้นเมื่อการแยกสภาพแวดล้อม การเตรียมไดเรกทอรี การจำกัด concurrency และการ cleanup ถูกจัดการโดยแพลตฟอร์มแทนที่จะเป็นสคริปต์ shell ของคุณ
TL;DR
Sharkly รัน AI agent แบบขนานได้โดยไม่เกิด merge conflict เพราะให้ทุก run ของ Task มีไดเรกทอรีแยกของตัวเองบน Computer ที่เชื่อมต่ออยู่ local service บน Computer นั้นจะรับ run ที่เข้าคิว เตรียมไดเรกทอรีของ task (สำหรับงานที่ผูกกับ repository จะเป็น git worktree แยกต่างหากต่อ run) เริ่ม Runtime ที่เลือกไว้ แล้วสตรีมความคืบหน้า เหตุการณ์ trace และผลลัพธ์กลับไปยัง Task ข้อจำกัด concurrency ทั้งที่ Agent และ Computer เป็นตัวกำหนดเพดานว่ามี run ทำงานพร้อมกันได้กี่ตัว และไม่มีอะไร merge เองโดยอัตโนมัติ เพราะผลลัพธ์จะกลับไปที่ Task ซึ่งมีคนรีวิวการเปลี่ยนแปลงและตัดสินใจขั้นตอน merge และ release เอง Agent ไม่เคยใช้ working tree ร่วมกัน ดังนั้น Task ที่ทำงานขนานกันจึงเขียนทับการเปลี่ยนแปลงของกันและกันไม่ได้
failure mode ที่ Sharkly ถูกสร้างขึ้นมาเพื่อป้องกัน
การอธิบายให้ชัดว่าเกิดอะไรขึ้นเมื่อ agent ใช้ checkout ร่วมกันนั้นมีประโยชน์ เพราะอาการแต่ละอย่างสอดคล้องกับส่วนหนึ่งของวิธีแก้
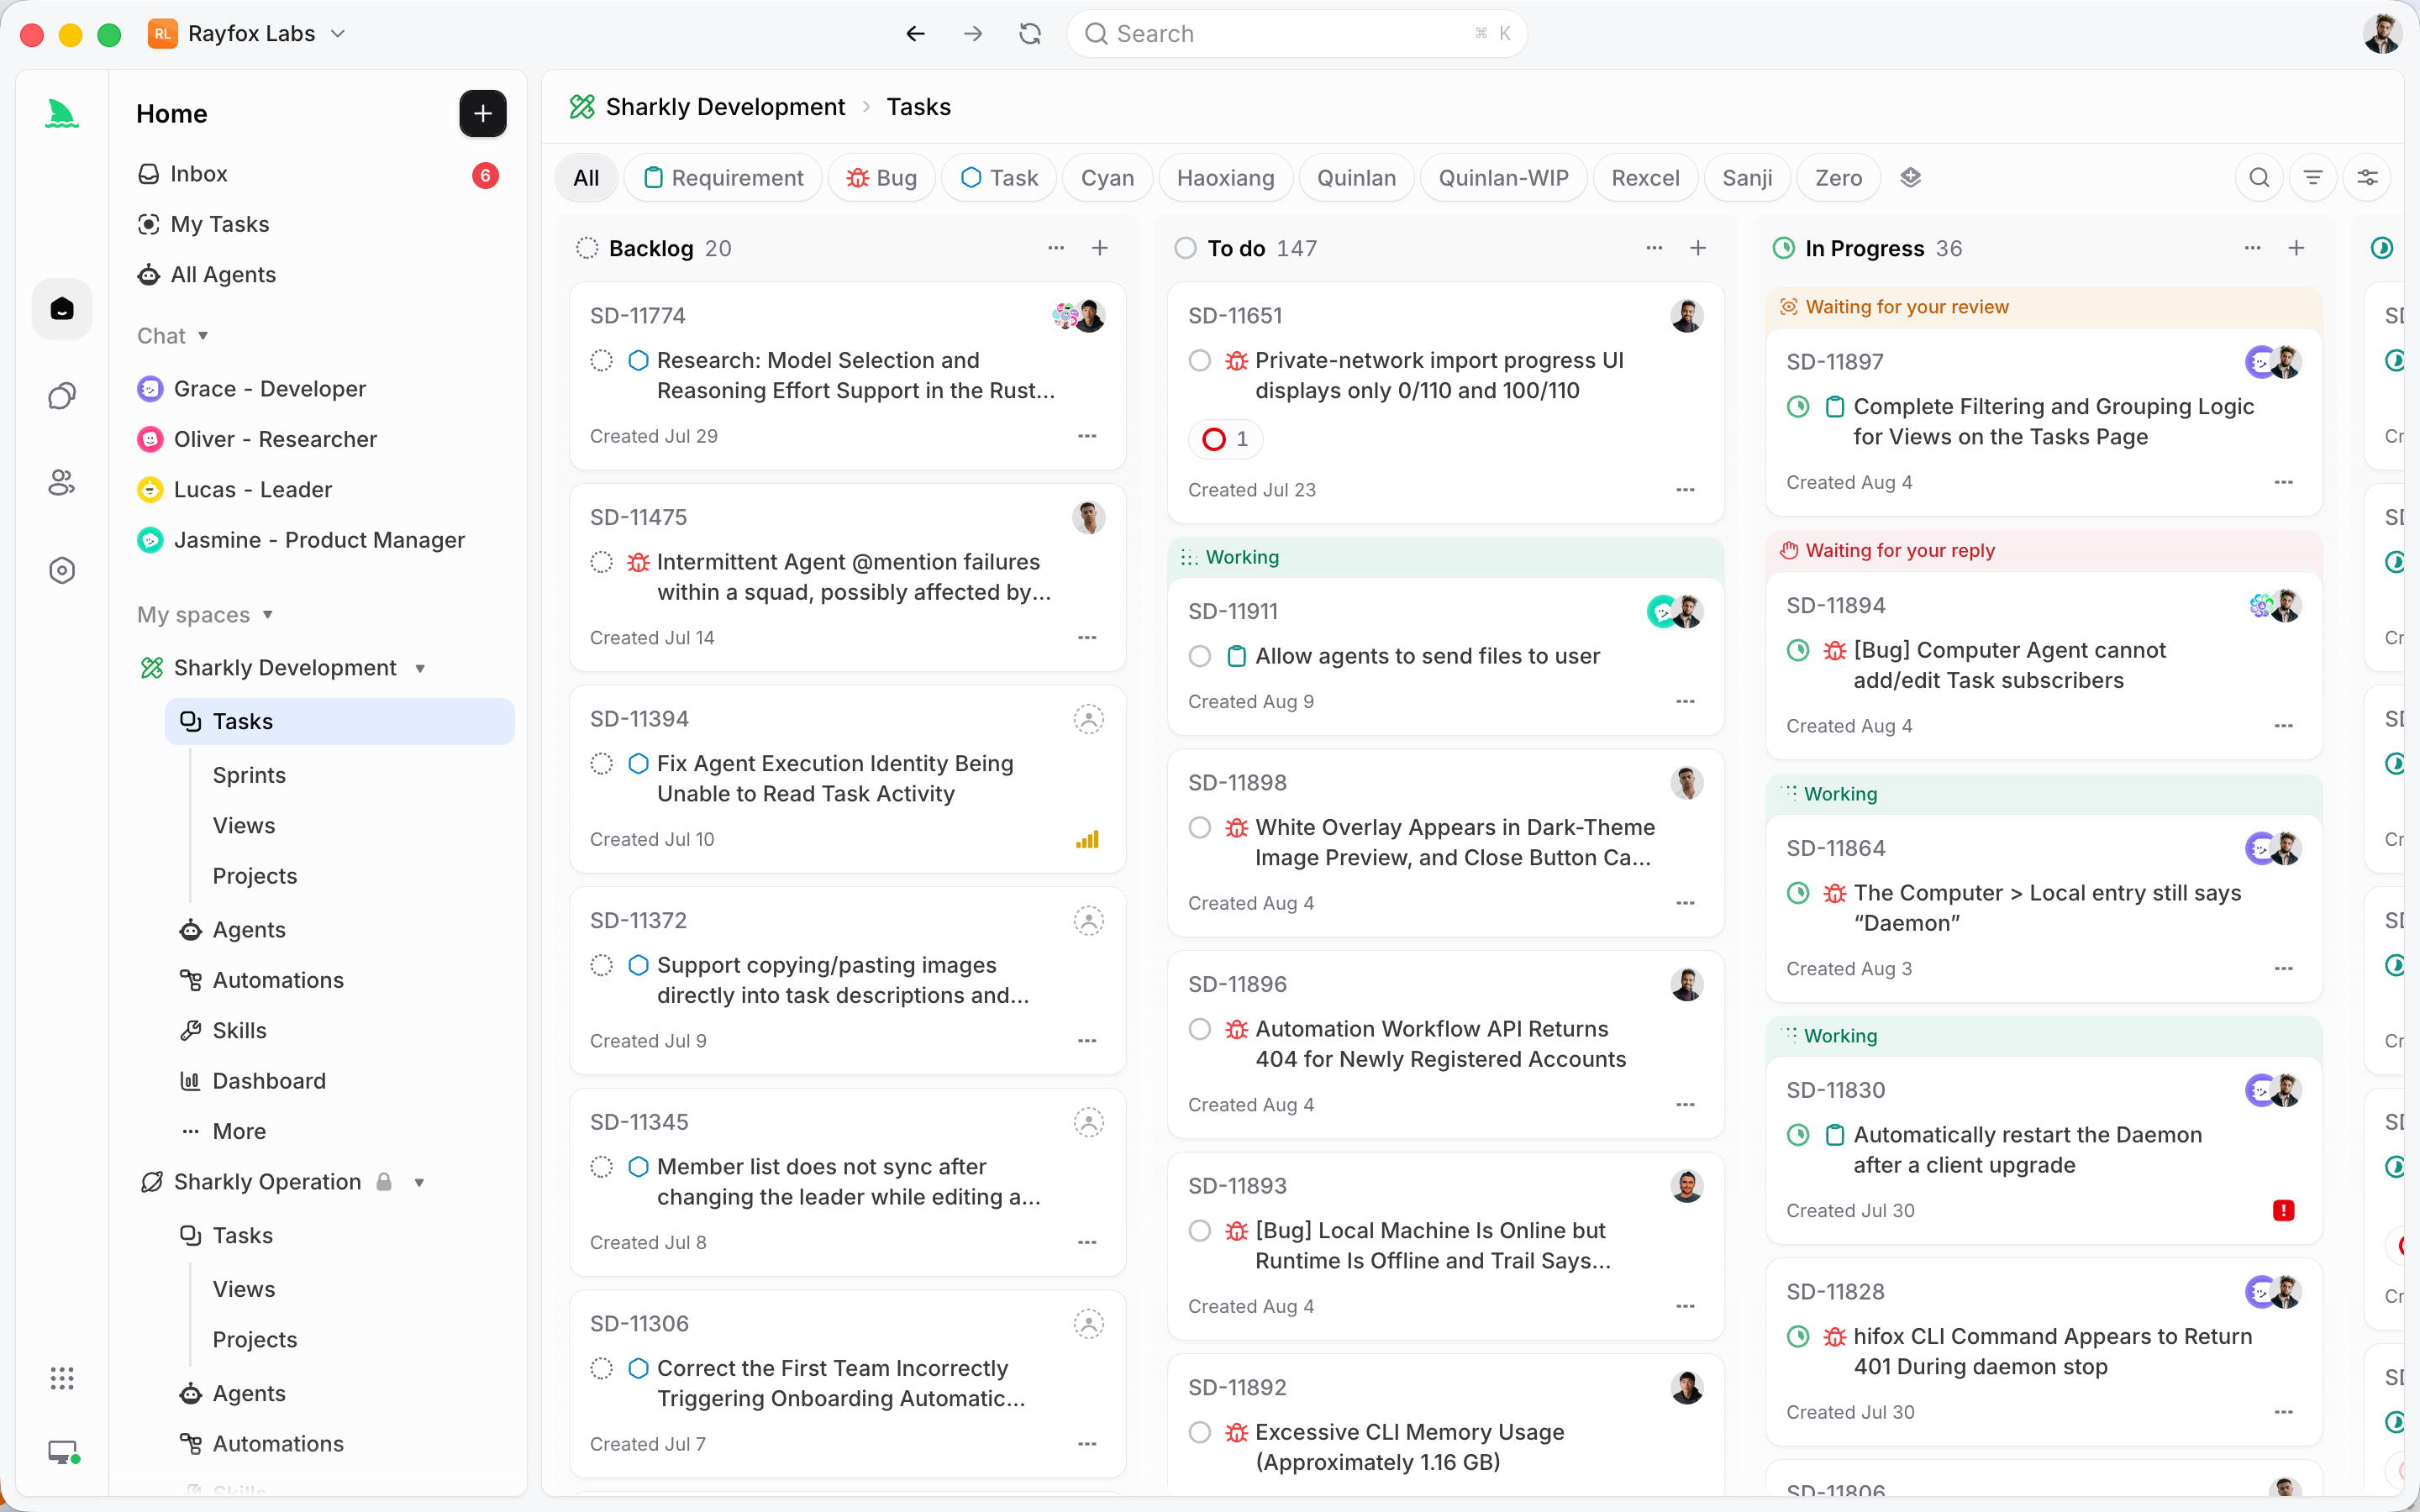
สถานะของ branch เป็นแบบ global ต่อ working tree หนึ่งตัว ดังนั้นเมื่อ agent A เช็คเอาท์ branch ของตัวเอง ไฟล์ของ agent B ก็เปลี่ยนไปทั้งที่มันกำลังทำงานอยู่ ส่วน index ก็เป็น global เช่นกัน git add และ git commit จึงสลับปนงานจากต่าง task เข้าด้วยกัน state ที่ยังไม่ถูก track ก็ชนกันด้วย เพราะผลลัพธ์จากการ build และการติดตั้ง dependency ของ run หนึ่งไปปนเปื้อนผลเทสต์ของอีก run และหนี้จากการ cleanup ก็พอกพูนขึ้นเรื่อย ๆ เพราะสำเนา repository แบบเฉพาะกิจทุกอันที่ทำขึ้นเพื่อหลบสามปัญหาข้างต้นจะนอนอยู่บนดิสก์จนกว่าจะมีคนนึกออกว่ามันมีอยู่
ไดเรกทอรีที่แชร์กันเพียงอันเดียวรัน agent ได้อย่างปลอดภัยทีละตัวเท่านั้น ถ้าคุณกำลังบริหารเรื่องนี้ด้วย tmux pane และวินัยของตัวเอง โพสต์ของเราเรื่องการรัน Claude Code agent หลายตัวพร้อมกันอธิบายไว้ว่าทำไมเพดานนั้นมาถึงเร็วขนาดนั้น
สถาปัตยกรรมการทำงาน: Agent, Computer, Runtime, Task
Sharkly ไม่ได้มาแทน Claude Code, Codex หรือเครื่องมือสำหรับ execute อื่น ๆ แต่เข้ามาเพิ่มชั้นของ task ที่ใช้ร่วมกัน, Computer, context, การควบคุม และการรีวิว ครอบเครื่องมือที่ทีมคุณใช้อยู่แล้ว ตำแหน่งในฐานะชั้นเชื่อมต่อนี้เองที่กำหนดว่าการทำงานแบบขนานจะเป็นอย่างไร เพราะหน้าที่ของ Sharkly คือประสานงาน run ต่าง ๆ ไม่ใช่เขียนโค้ด
มีสี่บทบาทที่แบ่งงานกัน โดยแต่ละบทบาทมีหน้าที่เดียวชัดเจน
- Agent กำหนดว่างานควรถูกจัดการอย่างไร ทั้งคำสั่ง (instructions), Skills, repository และการตั้งค่าการ run ต่าง ๆ Agent ไม่ใช่โฮสต์ที่ใช้ execute งาน
- Computer ให้โฮสต์และทรัพยากรภายในเครื่อง ไม่ว่าจะเป็นเครื่องโลคอล เซิร์ฟเวอร์ระยะไกล คอนเทนเนอร์ หรือคลาวด์โฮสต์ที่รองรับ โพสต์คู่กันเรื่องComputers ใน Sharklyอธิบายวิธีเชื่อมต่อไว้แล้ว
- Runtime ทำหน้าที่รันเซสชันของ agent จริง ๆ เป็นเครื่องมือที่ติดตั้งอยู่บน Computer นั้น เช่น Claude Code, Codex หรือ Gemini CLI
- Task ยังคงเป็นบันทึกที่ทีมใช้ร่วมกัน ทั้งเป้าหมาย สถานะ การสนทนา execution trace และผลลัพธ์
ตัวที่เชื่อมทั้งหมดเข้าด้วยกันคือ local service ขนาดเล็กบน Computer มันลงทะเบียน Computer ตรวจหา Runtime ที่ติดตั้งไว้ รับ run ที่อยู่ในคิว เตรียมไดเรกทอรีของ task ให้แต่ละ run เริ่ม Runtime แล้วส่งผลลัพธ์กลับมา มันเป็นฝ่ายเริ่มการเชื่อมต่อไปยังเซิร์ฟเวอร์ ดังนั้นการตั้งค่าทั่วไปจึงไม่ต้องเปิดพอร์ต inbound เลย
การแยกหน้าที่แบบนี้เองที่ทำให้การทำงานแบบขนานจัดการได้ เพราะ working directory ถูกเตรียมต่อ run โดย local service ไม่ได้ถูกเลือกโดย Agent สอง Agent ที่ได้รับมอบหมายสอง Task จึงชี้ไปที่ repository เดียวกันบน Computer เครื่องเดียวกันได้โดยไม่เห็นไฟล์ของกันและกันเลย สำหรับวิธีตั้งค่า Agent ดูได้ที่Agents ใน Sharkly
เกิดอะไรขึ้นเมื่อ run เริ่มทำงาน
เมื่อคุณมอบหมาย Task ให้ Agent และย้ายมันออกจาก Backlog Sharkly จะตรวจสอบความพร้อมในการ execute จัดคิว run ที่เข้าเงื่อนไข แล้วส่งต่อไปยัง Computer ที่เลือกไว้ จากจุดนั้น local service จะเข้ามารับช่วงต่อ ก่อนที่ Runtime จะเริ่มทำงาน มันอาจต้องรอช่อง concurrency ว่าง เตรียมไดเรกทอรีชั่วคราวแบบแยกส่วน หรือรอไดเรกทอรี specified ที่ว่างอยู่ ดึง repository ที่ตั้งค่าไว้ คัดเลือกเฉพาะ environment variable ที่อนุญาตให้ใช้ และประกอบคำสั่งเรียก Runtime
จากนั้น Runtime จึงจะเริ่มทำงาน run จะเคลื่อนผ่านสถานะที่ชัดเจน ได้แก่ Queued, Dispatched, Waiting for local directory, Running และสุดท้าย Completed, Failed หรือ Canceled สถานะเหล่านี้จะปรากฏใน execution log ของ Task ดังนั้นคำถามที่ว่า “ทำไมยังไม่มีอะไรเกิดขึ้น” จึงมีคำตอบที่ตรวจสอบได้แทนที่จะต้องเดา เอา run ที่ค้างอยู่ใน Queued เพราะ concurrency เต็ม ไปเทียบกับ run ที่ค้างอยู่ใน Waiting for local directory จะเห็นว่าต่างกัน และความต่างนั้นบอกคุณว่าต้องหมุนปุ่มไหน
สังเกตว่าอะไรที่ไม่มีอยู่ นั่นคือไม่มีจุดใดเลยที่ Agent ตัดสินใจว่าจะรันที่ไหน Agent นำคำสั่งมา ส่วนโครงสร้างพื้นฐานนำการแยกส่วนมาให้
worktree แยกส่วน: โหมด Temporary ทำงานอย่างไร
Agent รองรับโหมด working directory สองแบบ และโหมดที่สร้างมาสำหรับงานขนานคือโหมด Temporary แต่ละ Task จะได้ไดเรกทอรีแยกของตัวเอง และสำหรับงานที่ผูกกับ repository นั้น local service สามารถเตรียม git worktree แยกต่างหากให้แต่ละ run จากข้อมูล repository ที่ cache ไว้
ประโยคเดียวนี้แบกเรื่องราวการป้องกัน conflict ไว้ทั้งหมด worktree ให้ไดเรกทอรีที่เช็คเอาท์ไว้และสถานะ branch ของตัวเองแก่แต่ละ run พร้อมกับใช้ repository object ชุดเดียวกันร่วมกัน failure mode ทั้งสี่ข้อข้างต้นจึงหายไปโดยธรรมชาติ ไม่มี branch pointer ร่วมกัน ไม่มี index ร่วมกัน ไม่มี build artifact ร่วมกัน และเป็นไดเรกทอรีที่แพลตฟอร์มเก็บกวาดทีหลังได้ เนื่องจาก worktree มาจากข้อมูลที่ cache ไว้ ไม่ใช่การ clone ใหม่หมด ต้นทุนตอนเริ่มงานจึงอยู่ในระดับที่สมเหตุสมผล แม้ว่า run อาจยังต้องใช้การเชื่อมต่อเครือข่ายเพื่อรีเฟรช repository ก็ตาม
เอกสารระบุตรง ๆ ว่าควรใช้เมื่อไหร่ แนะนำให้ใช้โหมด Temporary สำหรับการแก้โค้ดแบบขนาน และสำหรับทุกสถานการณ์ที่หลาย Task อาจแก้ไข codebase เดียวกันพร้อมกัน
มีข้อจำกัดหนึ่งที่ควรพูดให้ชัด การแยกส่วนป้องกันการชนกันของ working tree ไม่ใช่ semantic conflict ถ้าสอง Task เขียนฟังก์ชันเดียวกันใหม่ทั้งคู่ ทั้งสอง run จะเสร็จเรียบร้อยใน worktree ของตัวเอง และยังต้องมีคนมาประสานความทับซ้อนตอนรีวิวอยู่ดี วิธีแก้คือกำหนดขอบเขต Task ไม่ให้พุ่งเป้าไปที่โค้ดเดียวกันในบ่ายเดียวกัน ซึ่งเป็นการตัดสินใจเรื่องการวางแผน ไม่ใช่เรื่องโครงสร้างพื้นฐาน
เมื่อการแยกส่วนเป็นทางเลือกที่ผิด: โหมด Specified
โหมดที่สองมีอยู่เพราะการสร้างไดเรกทอรีใหม่ทุก run ไม่ได้ฟรี ในโหมด Specified นั้น Agent จะรันภายในไดเรกทอรีโลคอลแบบ absolute เพียงหนึ่งไดเรกทอรีที่ตั้งค่าไว้จาก pool ของมัน โดยใช้ repository, dependency และ cache ที่มีอยู่แล้วซ้ำ โหมดนี้ใช้ได้เฉพาะบน Computer ที่เป็นเครื่องโลคอลเท่านั้น
การแลกเปลี่ยนนี้มีผลลัพธ์ที่เลี่ยงไม่ได้ ไดเรกทอรี specified ให้บริการได้ครั้งละหนึ่ง run และเมื่อไดเรกทอรีที่ตั้งค่าไว้ทุกอันไม่ว่าง run ถัดไปก็ต้องรอ Agent ที่ต้องรันหลาย Task พร้อมกันในโหมด Specified จึงต้องมีหลายไดเรกทอรีใน pool
| โหมด Temporary | โหมด Specified | |
|---|---|---|
| ไดเรกทอรีต่อ run | ไดเรกทอรีแยกใหม่, worktree สำหรับงานที่ผูกกับ repository | ไดเรกทอรี absolute ที่ตั้งค่าไว้หนึ่งอันจาก pool |
| ความปลอดภัยในการทำงานขนาน | run ต่าง ๆ แตะไฟล์ของกันไม่ได้ | หนึ่งไดเรกทอรีให้บริการได้ครั้งละหนึ่ง run |
| ต้นทุนตอนเริ่ม | เตรียมไดเรกทอรีใหม่ทุก run จากข้อมูล repository ที่ cache ไว้ | ใช้โค้ด dependency และ cache ที่มีอยู่แล้วซ้ำ |
| เหมาะที่สุดสำหรับ | การแก้โค้ดแบบขนาน งานที่ผูกกับ repository ส่วนใหญ่ | repo ขนาดใหญ่มาก, local state ที่มีต้นทุนสูง, เครื่องมือที่ผูกกับไดเรกทอรีใดไดเรกทอรีหนึ่ง |
| ความพร้อมใช้งาน | Computer ที่เชื่อมต่อได้ทุกเครื่อง | เฉพาะ Computer ที่เป็นเครื่องโลคอล |
การแยกส่วนได้ความปลอดภัยมาแลกกับงานเตรียมการ ส่วนการใช้ซ้ำได้ความเร็วมาแลกกับการต้องรันทีละ run Sharkly ให้คุณเลือกอย่างชัดเจนเป็นราย Agent ซึ่งดีกว่าไปรู้ตัวทีหลังว่ามีการแลกเปลี่ยนนี้อยู่ตอน working tree พังไปแล้ว
ข้อจำกัด concurrency: ขนานได้ แต่มีขอบเขต
การทำงานขนานแบบไร้ขอบเขตก็เป็น failure mode ในตัวเอง ทุก run ที่ทำงานพร้อมกันกิน CPU, หน่วยความจำ, ดิสก์, ความจุของ model provider และแบนด์วิดท์ของ repository ทั้งหมด agent แปดตัวที่แย่งทรัพยากรกันบนแล็ปท็อปเครื่องเดียวให้ผลลัพธ์แย่กว่า agent สามตัวที่รันสบาย ๆ เสียอีก
Sharkly จำกัด concurrency ไว้สองระดับ Computer มีข้อจำกัด task concurrency ในฐานะโฮสต์ และ Agent แต่ละตัวมีจำนวน Task สูงสุดที่รันพร้อมกันได้ พร้อมกับ timeout ต่อ Task ค่าเริ่มต้นค่อนไปทางระมัดระวัง ในโหมด Temporary Agent จะได้ 50 เปอร์เซ็นต์ของขีดจำกัดของ Computer ส่วนในโหมด Specified จะเท่ากับจำนวนไดเรกทอรีที่ตั้งค่าไว้ ถ้าตั้งให้สูงกว่าจำนวนไดเรกทอรี ตัวผลิตภัณฑ์จะเตือนว่าการเขียนอาจชนกันข้าม task คำเตือนนั้นคือแก่นของโพสต์นี้ที่ถูกย่อลงมาไว้ในกล่องโต้ตอบเดียว
คำแนะนำในเอกสารเรื่องการเพิ่มขีดจำกัดเป็นแบบสุขุมรอบคอบ นั่นคือเพิ่ม concurrency เฉพาะหลังจากที่ Computer และ Runtime ปัจจุบันรับภาระงานที่มีอยู่ได้อย่างเสถียรแล้วเท่านั้น
การสตรีมความคืบหน้าและการรีวิวก่อน merge
การแยกส่วนจะกลายเป็นข้อเสียทันทีถ้ามันหมายถึงการมองไม่เห็นด้วย Agent ห้าตัวในห้าไดเรกทอรีที่ซ่อนอยู่คือวิธีที่งานหายเข้าไปใน terminal ส่วนตัวพอดี ดังนั้นทุกอย่างที่ run ผลิตออกมาจึงไหลกลับไปยังบันทึกที่ใช้ร่วมกัน
ในขณะที่ run กำลังทำงาน Task จะแสดงสถานะการ execute ของมัน Activity เก็บความคิดเห็นและการเปลี่ยนแปลงของ task ไว้ในไทม์ไลน์ ส่วน execution log บันทึกว่า run เริ่มและจบเมื่อไหร่ การเรียกใช้เครื่องมือและเหตุการณ์ของ Runtime แหล่งที่มาของ trigger และรายละเอียดของความล้มเหลวถ้ามี ส่วนรายงานของ Agent จะถูกบันทึกไว้เป็นความคิดเห็นที่เชื่อมกับ execution trace ของมัน context, ความคืบหน้า, อุปสรรคที่ติดขัด และผลลัพธ์ ยังมองเห็นได้ตั้งแต่ตอนร้องขอจนถึงตอน release แม้ว่าการแก้ไฟล์จะเกิดขึ้นในไดเรกทอรีที่ไม่มีมนุษย์คนไหนเปิดดูเลยก็ตาม
จากนั้นก็มาถึงด่านสุดท้าย ไม่มีอะไรในระบบนี้ merge ด้วยตัวเอง Agent ค้นคว้า ลงมือทำ ทดสอบ และรายงาน ส่วนคนเป็นผู้กำหนดทิศทาง ให้อำนาจ และยอมรับผลลัพธ์ เมื่อ run เสร็จ Agent สามารถปล่อยให้ Task รอการรีวิวจากมนุษย์ได้ ซึ่งจะไปปรากฏใน Inbox ของผู้ที่รับผิดชอบ worktree ที่แยกส่วนทำให้การทำงานขนานปลอดภัย ส่วนด่านรีวิวทำให้มันน่าเชื่อถือ
มีอีกชิ้นหนึ่งที่ปิดวงจรให้ครบ นั่นคือการ cleanup การรัน agent ทิ้ง working directory และ artifact ไว้บน Computer และระบบ cleanup ที่ตั้งค่าได้จะเก็บคืน run ที่เสร็จแล้วหลังจากพ้นช่วงเวลาที่กำหนด โดยมีเกณฑ์พื้นที่ว่างขั้นต่ำเป็นตัวกันสำรอง ส่วนงานที่กำลังรันหรืออยู่ในคิว, run ที่ถูก pin ไว้ และ run ที่ล้มเหลวซึ่งยังต้องสอบสวน จะไม่ถูกแตะต้องเลย นี่คือภาระที่การตั้งแบบ DIY มักลืมกันจนดิสก์เต็ม
Sharkly ทำอะไรให้อัตโนมัติ เมื่อเทียบกับการตั้งแบบ DIY
ถ้าคุณเคยอ่านคู่มือ worktree แบบ DIYของเรา การเทียบกันจะตรงไปตรงมา คำสั่ง git worktree add ที่คุณเขียนสคริปต์รันต่อ agent กลายเป็น local service ที่เตรียมไดเรกทอรีแยกต่อ run การตัดสินใจว่า “agent เท่าไหร่ถึงจะมากเกินไป” กลายเป็นข้อจำกัด concurrency ที่ชัดเจนพร้อมคำเตือนเมื่อการตั้งค่าไม่ปลอดภัย คำสั่ง git worktree prune ที่คุณลืมรัน กลายเป็น cleanup ตามระยะเวลาที่กำหนด และส่วนที่ไม่มีสคริปต์ไหนให้คุณได้ นั่นคือบันทึกที่ใช้ร่วมกันว่า run ไหนทำอะไรและมีคนยอมรับมันหรือไม่ ซึ่งก็คือตัว Task นั่นเอง
หลักการตัดสินใจแบบตรงไปตรงมาก็ใช้ที่นี่เช่นกัน นักพัฒนาคนเดียวที่รัน agent สองตัวบนเครื่องเดียวอาจยังไม่จำเป็นต้องใช้แพลตฟอร์ม สคริปต์ worktree บวกวินัยก็พาไปได้ไกลพอสมควร หันมาใช้ Sharkly เมื่อการประสานงานมีต้นทุนสูงกว่าการพิมพ์งานเสียเอง เช่นมีหลายคนคอยมอบหมายงาน มีหลาย Computer มี run ที่ต้องจัดคิวและต้องรีวิว ไม่ว่าทางไหน คุณก็ยังใช้ Runtime ที่มีอยู่แล้วต่อไป การใช้งานโมเดลยังคงดำเนินผ่าน subscription หรือ API key ที่ตั้งค่าไว้ในเครื่องมือเหล่านั้น
การเริ่มต้นถูกออกแบบให้เล็กโดยตั้งใจ เชื่อมต่อ Computer หนึ่งเครื่อง สร้าง Agent หนึ่งตัวในโหมด Temporary แล้วมอบหมาย Task ที่มีความเสี่ยงต่ำให้หนึ่งงาน คู่มือเริ่มต้นใช้งานพาคุณทำลูปแรกจนครบในประมาณสิบนาที เอกสาร Sharkly docs อธิบายแต่ละแนวคิดอย่างละเอียด และSharkly คืออะไรจะเติมภาพแพลตฟอร์มรอบ ๆ การ execute ให้ครบ
คำถามที่พบบ่อย
Sharkly ป้องกัน merge conflict ระหว่าง agent ที่ทำงานขนานกันได้อย่างไร
แต่ละ run ของ Task จะได้ไดเรกทอรีแยกของตัวเองบน Computer และ run ที่ผูกกับ repository แต่ละอันจะได้ git worktree แยกต่างหากที่ local service เตรียมไว้ให้ Agent ไม่เคยใช้ checkout, index หรือไฟล์ที่ยังไม่ถูก track ร่วมกัน ดังนั้น run ที่ทำงานพร้อมกันจึงเขียนทับงานที่กำลังทำของกันและกันไม่ได้ ส่วนความทับซ้อนที่สอง Task ตั้งใจแก้โค้ดเดียวกัน ก็ยังต้องมีคนมาประสานกันตอนรีวิวอยู่ดี
ต้องตั้งค่า git worktree เองไหมถึงจะใช้ Sharkly ได้
ไม่ต้อง ในโหมด Temporary นั้น local service จะเตรียมไดเรกทอรีของ task ให้ทุก run รวมถึง worktree สำหรับงานที่ผูกกับ repository คุณตั้งค่าโหมดบน Agent ครั้งเดียว ก็ไม่ต้องเขียนสคริปต์คำสั่ง worktree ต่อ run อีก หากอยากเข้าใจกลไกเบื้องหลัง ดูได้ที่เอกสาร git worktree
agent กี่ตัวรันพร้อมกันได้บน Computer หนึ่งเครื่อง
Computer มีข้อจำกัด task concurrency ของตัวเอง และ Agent แต่ละตัวมีจำนวนสูงสุดของ Task ที่รันพร้อมกันได้ โดยค่าเริ่มต้น Agent ในโหมด Temporary จะได้ 50 เปอร์เซ็นต์ของขีดจำกัดของ Computer ส่วนโหมด Specified จะได้หนึ่งช่องต่อไดเรกทอรีที่ตั้งค่าไว้ run ที่เกินขีดจำกัดจะรออยู่ในคิว
Sharkly merge การเปลี่ยนแปลงของ agent ให้อัตโนมัติหรือไม่
ไม่ ผลลัพธ์ หลักฐาน และ trace ของ run จะกลับไปที่ Task และมีคนรีวิวสรุปการเปลี่ยนแปลงก่อนที่อะไรจะถูกปล่อยออกไป ผู้รีวิวจะยอมรับ ขอให้แก้ไข หรือตัดสินใจขั้นตอน merge และ release เอง ระบบอัตโนมัติจะหยุดตรงจุดที่ต้องใช้ดุลยพินิจของทีม
ควรใช้โหมด Specified แทน worktree ที่แยกส่วนเมื่อไหร่
ใช้เมื่อการเตรียมไดเรกทอรีใหม่ทุก run มีต้นทุนสูงจริง ๆ เช่น repository ขนาดใหญ่มาก, state หรือ cache ที่ถูกสร้างขึ้นซึ่งมีต้นทุนสูง หรือเครื่องมือที่ผูกกับพาธโลคอลหนึ่งพาธ โดยยอมรับว่ามันให้บริการได้ครั้งละหนึ่ง run ต่อไดเรกทอรี สำหรับกรณีอื่น ๆ ทั้งหมด โหมด Temporary คือค่าเริ่มต้นที่แนะนำ


