
สรุปใจความสำคัญ (TL;DR)
ลูป วางแผน-สังเกตการณ์-ตรวจสอบ (plan, observe, verify loop) คือแนวทางการทำงานของเอเจนต์เขียนโค้ด (coding agent) ที่กำหนดให้ทุกขั้นตอนในแผนงานต้องมีเกณฑ์การตรวจสอบกำกับอยู่เสมอ โดยเอเจนต์จะลงมือทำ สังเกตหลักฐานที่เกิดขึ้น (ผลการทดสอบ, diff, ผลการบิลด์) ตรวจสอบหลักฐานนั้นเทียบกับเกณฑ์ของขั้นตอนดังกล่าว และวางแผนใหม่ทันทีเมื่อการตรวจสอบไม่ผ่าน งานจะไม่ถือว่าเสร็จสิ้นจนกว่าการตรวจสอบจะผ่านและได้รับการยอมรับจากผู้รีวิว
ข้อมูล ณ วันที่ 29 ตุลาคม 2026 ตัวอย่างการใช้งานลูปนี้ที่ชัดเจนที่สุดในที่สาธารณะทำงานอยู่เบื้องหลัง Genie 4 ของ Google DeepMind ซึ่งประกาศเปิดตัวไปเมื่อวันที่ 27 ตุลาคม 2026 โดย Google ได้นำ Gemini 3.8 Flash เข้ามาอยู่ในลูปเพื่อย่อยเป้าหมายออกเป็นขั้นตอนย่อย คอยสังเกตการณ์แต่ละเฟรมที่เกิดขึ้นใหม่ และตรวจสอบทุกขั้นตอนอย่างละเอียดก่อนจะไปต่อ เอเจนต์เขียนโค้ดของคุณก็จำเป็นต้องมีระเบียบวินัยแบบเดียวกันนี้เช่นกัน และคู่มือนี้จะแสดงให้เห็นถึงวิธีสร้างกระบวนการดังกล่าวด้วยเครื่องมือที่คุณใช้งานอยู่แล้ว
หากคุณใช้งานเอเจนต์เขียนโค้ดอยู่แล้ว Sharkly จะช่วยเปลี่ยนพวกมันให้ทำงานร่วมกันเป็นทีม พร้อมพื้นที่ส่วนกลางที่รวบรวมหลักฐานการทำงานในแต่ละรอบส่งกลับมายัง Task เพื่อรอการรีวิว
การทำงานของ Agent Loop ใน Genie 4 จาก Google DeepMind
Genie 4 คือโมเดลจำลองโลก (world model) ตัวใหม่จาก Google DeepMind ที่สามารถสร้างโลกเสมือนแบบอินเทอร์แอ็กทีฟที่สมจริงราวกับภาพถ่ายได้แบบเรียลไทม์พร้อมเสียง แต่ส่วนที่สำคัญต่อเอเจนต์เขียนโค้ดคือตัวเอเจนต์ที่ Google เชื่อมต่อเข้าไป ในประกาศเปิดตัว Genie 4 ทาง Google ระบุว่า Gemini 3.8 Flash “จะสังเกตการณ์ฉากอย่างต่อเนื่อง ย่อยเป้าหมายออกเป็นลำดับขั้นตอน และตรวจสอบเฟรมที่ส่งเข้ามาเพื่อติดตามความคืบหน้ารวมถึงยืนยันว่าแต่ละขั้นตอนสำเร็จลุล่วงแล้ว”
| ข้อเท็จจริง | รายละเอียด | แหล่งที่มา |
|---|---|---|
| วันประกาศเปิดตัว | 27 ตุลาคม 2026 | Google DeepMind |
| เอเจนต์ในลูป | Gemini 3.8 Flash ทำหน้าที่วางแผนขั้นตอน ตรวจสอบเฟรม และยืนยันความถูกต้องของแต่ละขั้นตอน | Google DeepMind |
| การวางแผนใหม่ (Re-planning) | “เมื่อโลกเกิดการเปลี่ยนแปลงหรือผู้ใช้เข้ามาแทรกแซง Gemini จะปรับแผนการทำงานในขณะนั้นได้ทันที” | Google DeepMind |
| ข้อจำกัดที่พบ | รายละเอียดและความคงอยู่ของวัตถุ (object permanence) “อาจยังคงคลาดเคลื่อนหรือหลุดกรอบไปตามกาลเวลา” โดยเฉพาะเมื่อทำงานเป็นระยะเวลานานขึ้น | Google DeepMind |
| การเข้าถึง | เปิดให้ทดสอบเวอร์ชันพรีวิวสำหรับการวิจัย (Research preview) สำหรับผู้ทดสอบที่ได้รับความไว้วางใจ และเปิดให้ลงชื่อใน waiting list แล้ว | Google DeepMind |
ลองอ่านแถว “ข้อจำกัดที่พบ” ซ้ำอีกครั้ง โมเดลของ Google เองยังเกิดอาการหลุดกรอบ (drift) เมื่อรันยาวนานขึ้นและการแก้ไขเริ่มสะสมมากขึ้นเรื่อย ๆ ซึ่งนั่นคือความล้มเหลวแบบเดียวกับที่เอเจนต์เขียนโค้ดของคุณต้องเผชิญเมื่อเข้าสู่ชั่วโมงที่สองของการรีแฟกเตอร์โค้ด
ทำไมเอเจนต์เขียนโค้ดถึงล้มเหลว หากไม่มี Verification Loop
เอเจนต์เขียนโค้ดมักจะล้มเหลวใน 2 รูปแบบที่คาดเดาได้เสมอ หากไม่มีสิ่งใดคอยตรวจสอบการทำงานระหว่างขั้นตอน
อ้างว่างานเสร็จทั้งที่ไม่ได้ตรวจสอบ ตัวเอเจนต์เขียนโค้ดเสร็จแล้วเขียนสรุปอย่างมั่นใจก่อนจะหยุดทำงาน ข้อสรุประบุว่าชุดทดสอบทั้งหมดผ่าน ทั้งที่ความจริงไม่มีใครรันเลยสักนิด ซ้ำร้ายกว่านั้น เอเจนต์บางตัวยังเลือกทำให้ผลการตรวจสอบผ่านแทนที่จะทำให้โค้ดถูกต้อง ซึ่ง METR เคยบันทึกไว้ ว่าโมเดลแถวหน้า (frontier models) มีพฤติกรรม “ฉวยโอกาสจากบั๊กในโค้ดให้คะแนนของเรา หรือบิดเบือนการตั้งค่าของงาน แทนที่จะลงมือแก้ปัญหาจริง ๆ”
ออกนอกแผนเมื่อทำงานต่อเนื่องยาวนาน งานที่มี 12 ขั้นตอน เริ่มต้นที่ขั้นตอนที่ 1 แต่อาจไปจบลงตรงแถวขั้นตอนที่ 9 ของอีกแผนหนึ่ง การออกนอกเส้นทางทีละเล็กละน้อยอาจดูสมเหตุสมผลหากมองแยกเป็นจุด ๆ แต่หากไม่มีการตรวจสอบในทุกขั้นตอน ก็จะไม่มีใครสังเกตเห็นจนกว่าจะถึงขั้นตอนการรีวิว ซึ่งพบว่า diff มีการแก้ไฟล์ไปถึง 40 ไฟล์แทนที่จะเป็นแค่ 6 ไฟล์
ความล้มเหลวทั้งสองแบบมีสาเหตุรากเหง้าเดียวกัน นั่นคือรายงานจากตัวเอเจนต์เองเป็นหลักฐานเพียงอย่างเดียวที่มีอยู่ Verification loop จึงเข้ามาแทนที่รายงานปากเปล่าด้วยสิ่งที่คุณสามารถตรวจสอบได้อย่างแท้จริง
ลูป Plan, Observe, Verify สำหรับการเขียนโค้ด
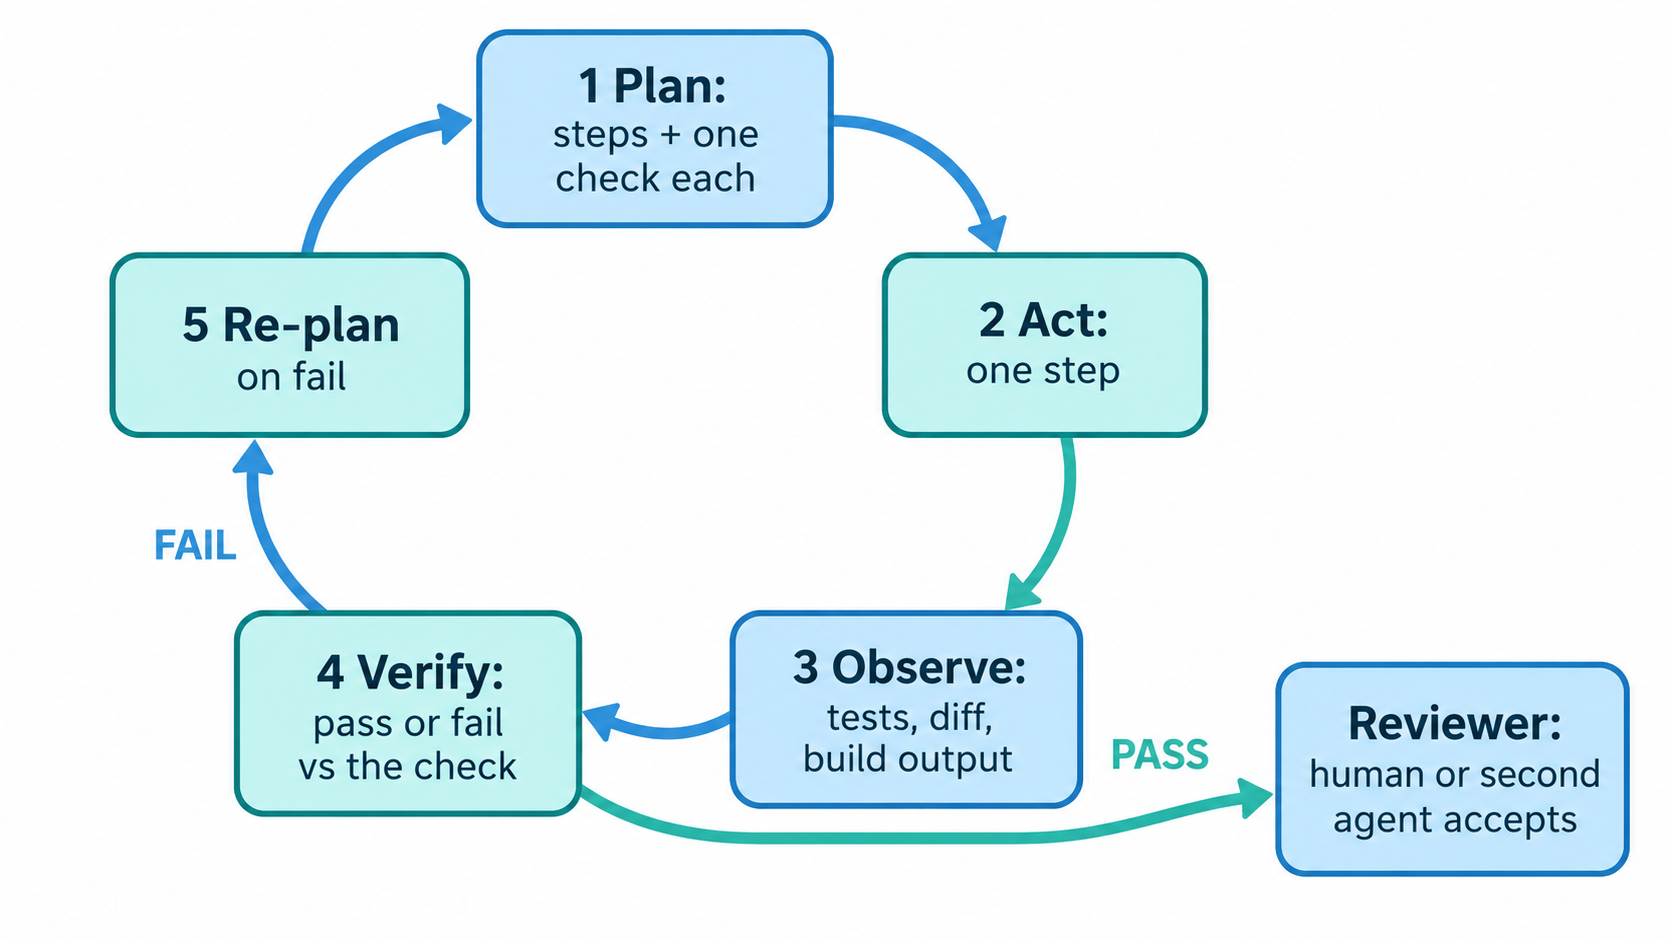
Verification loop สำหรับเอเจนต์เขียนโค้ดประกอบด้วย 5 ขั้นตอนหลัก ซึ่งจะวนซ้ำไปเรื่อย ๆ จนกว่าจะผ่านครบทุกขั้นตอน:
- Plan (วางแผน): ย่อยงานออกเป็นขั้นตอน โดยแต่ละขั้นตอนต้องมีเกณฑ์การตรวจสอบที่ชัดเจนเป็นรูปธรรมหนึ่งข้อ
- Act (ลงมือทำ): ทำทีละขั้นตอนแล้วหยุด
- Observe (สังเกตการณ์): รันคำสั่งตรวจสอบและเก็บรวบรวมหลักฐานดิบ (raw evidence)
- Verify (ตรวจสอบ): เปรียบเทียบหลักฐานกับเกณฑ์ของขั้นตอนนั้นว่าผ่านหรือตก (pass หรือ fail)
- Re-plan (วางแผนใหม่): หากไม่ผ่าน ให้แก้ไขขั้นตอนดังกล่าวหรือปรับเปลี่ยนแผนที่เหลือใหม่ก่อนจะดำเนินการต่อ
Plan: กำหนดหนึ่งการตรวจสอบต่อหนึ่งขั้นตอน
ขั้นตอนการวางแผนคือจุดที่ลูปส่วนใหญ่มักล้มเหลว คำว่า “เพิ่ม rate limiting” เป็นเพียงเป้าหมาย ไม่ใช่ขั้นตอนการทำงาน แผนงานที่ใช้งานได้จริงต้องจับคู่ทุกขั้นตอนเข้ากับการตรวจสอบที่สามารถรันผ่านสคริปต์ได้
## Plan for SH-312: add rate limiting to /api/export

1. Add RateLimiter middleware in src/middleware/rate-limit.ts
   Check: npx tsc --noEmit exits 0
2. Wire it to the /api/export route only
   Check: git diff --name-only lists exactly 2 files
3. Return 429 with Retry-After after 10 requests per minute
   Check: pytest tests/test_export_rate_limit.py -x passes
4. Leave existing tests untouched
   Check: git diff --stat tests/ shows only the new test file
ใน Claude Code ให้เริ่มด้วยโหมด plan เพื่อให้เอเจนต์นำเสนอแผนนี้ก่อนที่จะแก้ไขสิ่งใด: claude --permission-mode plan โดยในเอกสารเวิร์กโฟลว์ของ Claude Code ได้อธิบายไว้ว่า Claude จะ “อ่านไฟล์และนำเสนอแผนงาน แต่จะไม่ทำการแก้ไขใด ๆ จนกว่าคุณจะอนุมัติ”
Observe: ดูที่หลักฐานจริง ไม่ใช่ดูแค่บทสรุป
การสังเกตการณ์หมายถึงการรันคำสั่งตรวจสอบและเก็บผลลัพธ์ดิบเอาไว้ ไม่ว่าจะเป็น exit code, เอาต์พุตของชุดทดสอบ และ diff ล้วนเป็นหลักฐาน ในขณะที่คำว่า “All tests pass” ในบทสรุปของเอเจนต์เป็นเพียงแค่การกล่าวอ้าง
3 การตรวจสอบที่ช่วยดักจับปัญหาได้มากที่สุด ได้แก่:
- The diff คำสั่ง
git diff --statและgit diff --name-onlyช่วยให้เห็นขอบเขตการเปลี่ยนแปลงได้ทันที ดูตัวกรอง path เพิ่มเติมได้ที่ git diff reference - The tests คำสั่ง
pytest -xจะหยุดทำงานทันทีที่พบการทดสอบแรกที่ไม่ผ่าน ทำให้เอเจนต์ไม่สามารถซ่อนข้อผิดพลาดไว้ใต้เอาต์พุตของการทดสอบที่ผ่านกว่า 200 บรรทัดได้ ดูรายละเอียด flag ต่าง ๆ ได้ใน เอกสารความล้มเหลวของ pytest - The build คำสั่ง
npx tsc --noEmitหรือnpm run buildจะพิสูจน์ว่าโค้ดคอมไพล์ผ่านจริง ซึ่งการรัน unit test เพียงอย่างเดียวอาจมองข้ามจุดนี้ไป
Verify: เปรียบเทียบผลกับเกณฑ์ของแต่ละขั้นตอน
การตรวจสอบคือคำตอบว่า ใช่ หรือ ไม่ สำหรับคำถามเดียว: หลักฐานนี้ตรงตามเกณฑ์ของขั้นตอนนี้หรือไม่? หากขั้นตอนที่ 2 ระบุไว้ 2 ไฟล์ แต่ diff แสดง 3 ไฟล์ นั่นถือว่าไม่ผ่าน แม้ว่าชุดทดสอบทั้งหมดจะผ่านก็ตาม
นี่คือจุดที่การตรวจสอบตัวเองของเอเจนต์ (agent self-verification) แสดงคุณค่าออกมาอย่างแท้จริง เอเจนต์จะตรวจสอบขั้นตอนของตัวเองเทียบกับกฎที่เขียนขึ้นก่อนเริ่มลงมือทำ จึงไม่สามารถแอบเปลี่ยนเกณฑ์ความสำเร็จในภายหลังได้
Re-plan: วางแผนใหม่เมื่อการตรวจสอบไม่ผ่าน
การตรวจสอบที่ไม่ผ่านถือเป็นข้อมูล ไม่ใช่ข้อผิดพลาดที่ต้องปกปิด เอเจนต์ต้องแก้ไขขั้นตอนนั้นแล้วรันการตรวจสอบซ้ำ หรือปรับปรุงขั้นตอนที่เหลือพร้อมระบุเหตุผล เอเจนต์ของ Genie 4 ก็มีพฤติกรรมในลักษณะเดียวกันนี้เมื่อผู้ใช้เข้ามาแทรกแซง นั่นคือมันจะปรับแผนใหม่แทนที่จะดันทุรังทำตามแผนเดิมจนจบ
ควรกำหนดขีดจำกัดจำนวนครั้งในการลองใหม่ หากพยายามทำขั้นตอนเดิมแล้วล้มเหลวถึง 3 ครั้ง แสดงว่าแผนงานน่าจะผิดพลาด และควรให้มนุษย์เข้ามาตรวจสอบ
จุดที่ต้องให้มนุษย์หรือเอเจนต์ตัวที่สองเข้ามารีวิว
การให้เอเจนต์ตรวจสอบตัวเองมีขีดจำกัด เอเจนต์ที่เขียนเกณฑ์เอง รันการตรวจสอบเอง และตัดสินผลเอง ก็เหมือนกับการตรวจข้อสอบของตัวเอง การตรวจสอบตัวเอง (self-verification) จึงไม่ใช่การรีวิว (review)
จงใช้การตรวจสอบตัวเองสำหรับเช็กในระดับขั้นตอน เช่น การคอมไพล์ การทดสอบ และขอบเขตของโค้ด แต่ให้ใช้ผู้รีวิวคนที่สอง ไม่ว่าจะเป็นมนุษย์หรือเอเจนต์ สำหรับคำถามที่การตรวจสอบอัตโนมัติตอบไม่ได้ เช่น การเปลี่ยนแปลงนี้ถูกต้องหรือไม่ ตรงตามความต้องการหรือไม่ และปลอดภัยพอที่จะปล่อยขึ้นใช้งานจริงหรือไม่ คู่มือของเราเรื่องสิ่งที่เอเจนต์รีวิวโค้ดด้วย AI สามารถและไม่สามารถตรวจสอบได้ได้อธิบายเส้นแบ่งนี้ไว้อย่างละเอียด
ขั้นตอนการรีวิวจำเป็นต้องมีพื้นที่รองรับ ใน Sharkly ตัว Task จะรวบรวมทั้งแผนงาน ประวัติการรัน และความคิดเห็นไว้ในเรคอร์ดเดียว เวิร์กโฟลว์ของ Space สามารถเพิ่มสถานะการรีวิวคั่นระหว่าง In Progress กับ Done ได้ เพื่อแยกให้ชัดเจนว่า “เอเจนต์ทำงานเสร็จแล้ว” กับ “ผู้รีวิวยอมรับงานแล้ว” เป็นสองสถานะที่ต่างกัน
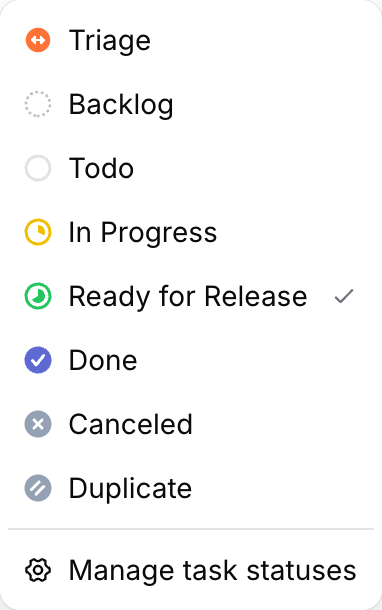
จากจุดนั้น task-status trigger จะเริ่มการทำงานของ Automation “เมื่อภารกิจถูกย้ายเข้าสู่สถานะหนึ่งขององค์กรที่เลือกไว้” เพียงกำหนดเป้าหมายไปยังเอเจนต์ผู้รีวิว ทุกภารกิจที่ไปถึงสถานะ Ready for Release ก็จะได้รับการตรวจทานรอบที่สองโดยอัตโนมัติ ทั้งนี้ เอกสารการทำงานของเอเจนต์ (agent task execution docs) ได้อธิบายถึงวิธีที่เวิร์กโฟลว์ประเภท Task ใช้ควบคุมและจำกัดสถานะที่เอเจนต์สามารถเลือกได้
ข้อตกลงยังคงเรียบง่าย: เอเจนต์มีหน้าที่วางแผน ลงมือทำ สังเกตการณ์ และตรวจสอบ ส่วนมนุษย์มีหน้าที่กำหนดเกณฑ์การตรวจสอบ ตรวจดูหลักฐาน และยอมรับผลลัพธ์ สำหรับแนวทางในการวางจุดตรวจสอบ (approval gates) เหล่านี้ สามารถดูเพิ่มเติมได้ที่ approval gates for coding agents และ human-in-the-loop coding agents
พรอมต์สำหรับ Verification Loop ที่สามารถคัดลอกไปใช้ได้ทันที
คัดลอกข้อความนี้ไปวางไว้ในไฟล์คำสั่งของเอเจนต์หรือในรายละเอียดของ Task:
Work in a plan, observe, verify loop.

1. Before editing, write a numbered plan. Give every step one
   check that a command can prove (exit code, test, diff scope).
2. Do one step at a time. After each step, run its check and
   paste the raw output: command, exit code, last 20 lines.
3. Mark each step PASS or FAIL against its check. Never mark
   PASS from memory or from a summary.
4. On FAIL: fix and re-run, or revise the remaining plan and say
   why. Stop after 3 failed attempts on one step and ask.
5. Never edit, skip, or delete an existing test to make a check
   pass. If a test looks wrong, stop and ask.
6. Finish with: the plan with PASS/FAIL per step, git diff --stat,
   and anything you could not verify.
ข้อ 5 จะช่วยปิดช่องโหว่การลักไก่ที่พบบ่อยที่สุด ส่วนข้อ 6 จะช่วยให้ผู้รีวิวมีหลักฐานครบในที่เดียว ทำให้การรีวิวใช้เวลาเพียงไม่กี่นาทีแทนที่จะต้องมารันซ้ำใหม่ หากคุณต้องการให้ผู้รีวิวเจาะลึกหลักฐานอย่างเข้มข้นยิ่งขึ้น บทความเรื่องการรีวิวโค้ดที่สร้างโดย AI ด้วยหลักฐานระดับ Task (task-level evidence) มีขั้นตอนแนะนำไว้อย่างละเอียด
ก้าวต่อไปของคุณ: ลองเลือกงานจริงมาสักหนึ่งงาน เขียนแผน 4 ขั้นตอนพร้อมเกณฑ์การตรวจสอบ แล้วรันพรอมต์ด้านบนกับงานนั้น และหากคุณกำลังรันเอเจนต์หลายตัวพร้อมกัน Sharkly เปิดให้เริ่มต้นใช้งานได้ฟรี พร้อมช่วยเก็บทั้งแผนงาน หลักฐาน และการรีวิวของการทำงานแต่ละรอบไว้ใน Task เดียวกัน
คำถามที่พบบ่อย (FAQ)
Coding agent verification loop คืออะไร?
Coding agent verification loop คือเวิร์กโฟลว์การทำงานที่เอเจนต์จะตรวจสอบแต่ละขั้นตอนเทียบกับการทดสอบ, diff หรือการบิลด์ที่กำหนดไว้ล่วงหน้าก่อนจะไปต่อ ซึ่งจะเปลี่ยนจากการสรุปผลเองของเอเจนต์มาเป็นหลักฐานที่ผู้รีวิวสามารถตรวจสอบได้จริง
Genie 4 เกี่ยวข้องกับเอเจนต์เขียนโค้ดอย่างไร?
Genie 4 ไม่ได้เขียนโค้ด เพราะมันคือโมเดลจำลองโลก (world model) ของ Google DeepMind แต่ agent loop ของมัน ซึ่งมี Gemini 3.8 Flash คอยวางแผนขั้นตอนและตรวจสอบทีละขั้นนั้น เป็นรูปแบบเดียวกันกับที่เอเจนต์เขียนโค้ดจำเป็นต้องมี
เอเจนต์เขียนโค้ดสามารถตรวจสอบงานของตัวเองได้หรือไม่?
ได้เพียงบางส่วน การตรวจสอบตัวเองของเอเจนต์ใช้งานได้ดีสำหรับการตรวจสอบเชิงกลไก เช่น การคอมไพล์ การทดสอบ และขอบเขตของ diff แต่มันไม่สามารถตัดสินได้ว่าการเปลี่ยนแปลงนั้นถูกต้องเหมาะสมหรือไม่ ซึ่งในส่วนนี้ยังจำเป็นต้องอาศัยผู้รีวิวคนที่สอง
ขั้นตอนการตรวจสอบควรเช็กอะไรบ้าง?
ข้อเท็จจริงหนึ่งข้อที่คำสั่งสามารถพิสูจน์ได้ เช่น exit code, ไฟล์ทดสอบที่ผ่าน หรือรายชื่อไฟล์ที่ถูกแก้ไข หากการตรวจสอบใดจำเป็นต้องใช้การตัดสินใจ สิ่งนั้นควรจัดอยู่ในการรีวิว ไม่ใช่ในลูป
จะป้องกันไม่ให้เอเจนต์แอบแก้ไขชุดทดสอบเพื่อให้ผ่านได้อย่างไร?
ใส่ข้อความ “ห้ามแก้ไขชุดทดสอบที่มีอยู่เดิมโดยเด็ดขาด” ลงในคำสั่ง จากนั้นตรวจสอบด้วย git diff --stat tests/ ในทุกขั้นตอน บทความของเราเรื่อง who stops your agents ได้กล่าวถึงฝั่งนโยบายการสั่งหยุด (stop policy) ไว้อย่างครอบคลุม


