
ทีมส่วนใหญ่ที่ใช้งาน coding agent หลายตัวมักตั้งเพดานการใช้จ่ายกับโมเดลเป็นรายเดือนในสักช่วงหนึ่ง โดยปกติก็หลังผ่านสัปดาห์ที่ย่ำแย่มา เลือกตัวเลขขึ้นมาสักตัว จำกัด concurrency ไว้จนกว่าใบแจ้งหนี้จะไม่เกินนั้น แล้วค่อยกลับมาทบทวนกันไตรมาสหน้า แต่วันที่ 2026-09-22 ตัวเลขนั้นก็เงียบ ๆ หยุดมีความหมายอย่างที่มันเคยเป็น
OpenAI เปิดตัว GPT-6 Sol ในราคา 2 ดอลลาร์ต่อล้าน input token และ 10 ดอลลาร์ต่อล้าน output token ใช้ API id ว่า gpt-6-sol พร้อมเผยข้อมูลที่มีประโยชน์กว่าอัตราค่าต่อ token นั่นก็คือต้นทุนต่อ task บน AutomationBench 1.0.6 นั้น Sol ที่ระดับ reasoning effort สูงพิเศษทำคะแนนได้ 33.2% ด้วยต้นทุน 0.27 ดอลลาร์ต่อ task ขณะที่ Claude Opus 5 ที่ effort สูงสุดทำได้ 26.9% แต่มีต้นทุนต่อ task สูงกว่า Sol ถึง 11.1 เท่าเมื่อรันบน harness เดียวกัน
ลองคำนวณดูว่าตอนนี้เพดานที่คุณตั้งไว้ซื้ออะไรได้บ้าง ก่อนที่คุณจะปรับมันขึ้น คำตอบสำหรับทีมส่วนใหญ่คือมันซื้อ run ที่เสร็จสมบูรณ์ได้มากกว่าที่ใครจะอ่านไหวอยู่แล้ว ซึ่งหมายความว่าเพดานนั้นไม่เคยปกป้องงบประมาณเลย มันปกป้องนักรีวิวของคุณต่างหาก โดยบังเอิญ และอีกไม่นานก็จะหมดหน้าที่นั้น
TL;DR
ต้นทุนต่อการเปลี่ยนแปลงที่ได้รับการยอมรับ (cost per accepted change) คือค่าใช้จ่ายที่ทีมของคุณจ่ายไปกับ model inference สำหรับทุก diff ที่มีคนอ่านและยอมรับจริง และมันเป็นตัวเลขต้นทุนของ agent ตัวเดียวที่เชื่อมโยงกับงานที่ส่งมอบจริงได้ ด้วยราคาที่ประกาศออกมา ปริมาณงานที่ทีมซึ่งมีนักรีวิว 4 คนสามารถรีวิวได้ทั้งเดือนคิดเป็นต้นทุน GPT-6 Sol เพียงประมาณ 136 ดอลลาร์เท่านั้น คอขวดที่แท้จริงย้ายจากใบแจ้งหนี้มาอยู่ที่ขั้นตอนการยอมรับ และไม่มีโมเดลตัวไหนที่เปิดตัวแล้วแตะต้องจุดนี้ได้ agent นั้นค้นคว้า ลงมือทำ ทดสอบ และรายงาน ส่วนคนเป็นผู้กำหนดทิศทาง ให้อำนาจ และยอมรับผลลัพธ์
ตัวเลขที่ OpenAI เปิดเผยจริง ๆ
OpenAI รายงานคะแนนควบคู่ไปกับต้นทุนต่อ task ซึ่งถือว่าซื่อสัตย์กว่าปกติ และมีประโยชน์กว่ารายการราคาเยอะ
| โมเดล ณ ระดับ effort ที่ OpenAI ใช้ | AutomationBench 1.0.6 | ต้นทุนต่อ task |
|---|---|---|
| GPT-6 Sol, สูงพิเศษ | 33.2% | $0.27 |
| GPT-6 Astra, ต่ำ | 30.3% | 3.9 เท่าของ Sol |
| Claude Opus 5, สูงสุด | 26.9% | 11.1 เท่าของ Sol |
| Fable 5.1 พร้อม Opus 5 เป็น fallback, สูงสุด | 31.4% | มากกว่า 8.9 เท่าของ Sol |
สรุปจาก OpenAI เองสำหรับแถวแรกและแถวที่สาม: Sol ที่ระดับสูงพิเศษเอาชนะ Opus 5 ที่ระดับสูงสุดได้ ด้วยต้นทุนต่อ task เพียงประมาณ 9% ของ Opus 5 รูปแบบเดียวกันนี้ปรากฏที่อื่นในโพสต์ของ OpenAI ด้วย บน Agents' Last Exam V1 นั้น Sol ที่ระดับสูงสุดทำคะแนนได้ 56.4% สูงกว่าคะแนนดีที่สุดของ Opus 5 โดยมีต้นทุนต่อ task ต่ำกว่า 60% บน DeepSWE 1.1 นั้น Sol ที่ระดับสูงสุดทำได้ 68.8% ห่างจาก Fable 5 ที่ระดับสูงพิเศษ (69.9%) เพียง 1.1 จุดเปอร์เซ็นต์ แต่ถูกกว่าต่อ task ราว 80%
มีข้อควรระวังสองข้อที่ควรมากับตัวเลขพวกนี้แต่แทบไม่ค่อยถูกพูดถึงพร้อมกัน หัวข้อข่าวของ OpenAI คือ Sol และ Luna ถูกกว่า GPT-5.6 ราคา โปรโมชัน ตัวละ 50% และคำว่า "โปรโมชัน" ก็เป็นคำของ OpenAI เอง คือการเปรียบเทียบกับราคาที่ลดแล้ว และ OpenAI ใช้ Claude Opus 5 เป็นตัวเทียบ เพราะ Claude Opus 5.5 เปิดตัวหลังจากนั้นไม่กี่ชั่วโมงในราคา 4 และ 20 ดอลลาร์ต่อล้าน เทียบกับ Opus 5 ที่ 5 และ 25 ดอลลาร์ คอลัมน์ Opus 5 จึงเป็นการเปรียบเทียบครั้งล่าสุดที่เคยเผยแพร่ ไม่ใช่การเปรียบเทียบในปัจจุบัน
แปลงงบประมาณให้เป็นจำนวน run
เอา 0.27 ดอลลาร์คูณ 11.1 แล้ว Opus 5 ที่ระดับสูงสุดก็จะตกอยู่ที่ราว 3.00 ดอลลาร์ต่อ task บน harness นั้น การคำนวณนี้เป็นของเรา โดยอิงจากตัวเลขสองตัวของ OpenAI เอาเพดานรายเดือนมาหารด้วยแต่ละตัว แล้วคุณจะได้ตารางที่เปลี่ยนวิธีอ่านเพดานไปเลย
| งบประมาณโมเดลรายเดือน | จำนวน task บน Sol ระดับสูงพิเศษ | จำนวน task บน Astra ระดับต่ำ | จำนวน task บน Opus 5 ระดับสูงสุด |
|---|---|---|---|
| $250 | ประมาณ 925 | ประมาณ 240 | ประมาณ 83 |
| $1,000 | ประมาณ 3,700 | ประมาณ 950 | ประมาณ 330 |
| $5,000 | ประมาณ 18,500 | ประมาณ 4,750 | ประมาณ 1,660 |
ต้นทุนต่อ task ของ benchmark ไม่ใช่ต้นทุนต่อ task ของคุณ task ใน AutomationBench มีรูปร่างแบบ benchmark คือมีขอบเขตจำกัด สั้น และไม่เหมือน ticket จริงใน repository ที่มีประวัติยาวเป็นปีเลย task ของคุณเองอาจกิน token มากกว่าสิบหรือร้อยเท่า สิ่งที่ถ่ายโอนจาก benchmark มาสู่ repository ของคุณได้คืออัตราส่วนระหว่างโมเดล ไม่ใช่จำนวนดอลลาร์แบบสัมบูรณ์ มองตารางนี้เป็นรูปร่างของการเปลี่ยนแปลง แล้ววัดต้นทุนต่อ run ของคุณเองข้าม agent ต่าง ๆ แล้วปรับสเกลตาม
ยังมีการแก้ไขอีกข้อที่หักลบไปอีกทาง ต้นทุนต่อ task คือต่อความพยายามหนึ่งครั้ง ไม่ใช่ต่อความสำเร็จ ด้วยอัตรา 33.2% ของ benchmark เอง ประมาณสองในสามของความพยายามไม่ประสบผล ดังนั้น Sol จึงมีต้นทุนราว 0.81 ดอลลาร์ต่อหนึ่งความสำเร็จใน benchmark ส่วน Opus 5 ที่ระดับสูงสุดอยู่ที่ราว 11.15 ดอลลาร์ อันนี้ก็การคำนวณของเราและหยาบ ๆ เพราะอัตราการผ่านของ benchmark ไม่ใช่อัตราการยอมรับของทีมคุณ ทิศทางต่างหากที่สำคัญ ตอนนี้ต้นทุนของการลองอะไรซ้ำสองนั้นน้อยพอที่กลยุทธ์การ retry จะกลายเป็นเรื่องของการออกแบบ ไม่ใช่การตัดสินใจเรื่องงบประมาณ
เพดานอยู่ตรงไหนในตอนนี้
มาดูฝั่งการรีวิวบนหน้าเดียวกัน นักรีวิวที่อ่าน diff อย่างจริงจัง เข้าใจสิ่งที่ Agent เลือก และรับผิดชอบต่อผลลัพธ์ จะรีวิวการเปลี่ยนแปลงได้จำนวนหนึ่งในหนึ่งวันทำงาน สมมติว่าหกครั้ง และปรับให้เข้ากับทีมของคุณ
| จำนวนนักรีวิว | การเปลี่ยนแปลงที่ยอมรับต่อเดือน | ต้นทุน Sol ที่ $0.27 | ต้นทุน Opus 5 สูงสุดที่ $3.00 |
|---|---|---|---|
| 1 | ประมาณ 126 | $34 | $378 |
| 2 | ประมาณ 252 | $68 | $756 |
| 4 | ประมาณ 504 | $136 | $1,512 |
| 8 | ประมาณ 1,008 | $272 | $3,024 |
หกการเปลี่ยนแปลงที่ยอมรับได้ต่อนักรีวิวต่อวัน คูณ 21 วันทำงาน นี่คือสมมติฐานและการคำนวณของเรา ลองใส่ตัวเลขของคุณเองดู ข้อสรุปก็ยังอยู่เหมือนเดิม ทุกสิ่งทุกอย่างที่ทีมวิศวกรรมทั่วไปยอมรับได้จริงในหนึ่งเดือนมีต้นทุน inference แค่ไม่กี่ร้อยดอลลาร์ แม้จะอยู่ปลายทางที่แพงก็ตาม เพดาน 1,000 ดอลลาร์สำหรับทีมสี่คนไม่ถือเป็นข้อจำกัดเลย มันคือผลงานจาก agent มากกว่าที่ทีมจะดูไหวถึงประมาณเจ็ดเท่า
นั่นคือประเด็นทั้งหมดของการลดราคาสำหรับทีมที่รีวิวงานของตัวเอง มันไม่ได้เพิ่มผลผลิตของคุณ มันแค่กำจัดข้ออ้างสุดท้ายสำหรับการที่คิวยังสั้นอยู่ และทำให้มองเห็นคอขวดที่เป็นมาโดยตลอด นั่นคือขั้นตอนการรีวิวโดยมนุษย์
การใช้จ่ายภายในของ OpenAI เป็นตัวอย่างสวนทางที่มีประโยชน์ ไม่ใช่ข้อขัดแย้ง นักวิจัยระดับมัธยฐานของที่นั่นใช้ coding-agent inference มากกว่า 600 ดอลลาร์ต่อวันในราคา API ส่วนเปอร์เซ็นไทล์ที่ 90 ใช้ถึง 7,000 ดอลลาร์ต่อวัน นั่นเป็นตัวเลขจริงและมากกว่าตารางข้างบนหลายเท่า เพราะงานลักษณะนั้นมีรูปร่างต่างออกไป คือ fan-out มหาศาล มีการให้คะแนนอัตโนมัติ และไม่มีขั้นตอนที่บุคคลซึ่งระบุชื่อได้ต้องยอมรับผลลัพธ์แต่ละชิ้นเข้า production branch ถ้ากระบวนการของคุณมีขั้นตอนนั้น ใบเรียกเก็บค่าโมเดลของคุณจะยังน้อยอยู่ แต่คิวของคุณจะไม่น้อยตาม
จะซื้ออะไรด้วยงบที่เหลือ
เมื่องบประมาณไม่ใช่ข้อจำกัดอีกต่อไป คำถามก็ไม่ใช่ว่าจะซื้อ run กี่ครั้ง แต่กลายเป็นว่าจะเอาเงินส่วนต่างไปใช้กับอะไรดี มีสองคำตอบที่ช่วยลดงานที่ไหลไปถึงนักรีวิว แทนที่จะเพิ่มมัน
ซื้อ effort ไม่ใช่ปริมาณ reasoning effort เป็นปุ่มปรับต้นทุน และตารางของ OpenAI เองก็ใช้ระดับต่างกันสำหรับ benchmark ต่างกัน ตัวเลข 0.27 ดอลลาร์คือแถวระดับสูงพิเศษ ดังนั้นค่าใช้จ่ายเพิ่มสำหรับ run ที่รอบคอบกว่าจึงรวมอยู่ในตัวเลขที่เป็น 9% ของทางเลือกอื่นอยู่แล้ว การจ่ายเพิ่มในจำนวน task เท่าเดิมแทบไม่มีค่าใช้จ่ายเลย และได้ diff ที่ใช้เวลาตรวจน้อยลงด้วย
ซื้อ cache ไม่ใช่ token GPT-6 ลดราคาการอ่าน input ที่แคชไว้ลง 90% ทำให้อัตราการ hit สูงขึ้นโดยค่าเริ่มต้น และไม่ทำให้ cache ใช้ไม่ได้อีกต่อไปเมื่อคุณเปลี่ยน reasoning effort หรือความพร้อมใช้งานของเครื่องมือ จุดแบ่ง (breakpoint) แบบระบุชัดเจนช่วยให้คุณกำหนดได้ว่า prefix ที่แคชไว้จบตรงไหน OpenAI อ้างว่า GitHub เห็น prompt token ที่ต้องประมวลผลใหม่ลดลงกว่า 50% ท่ามกลางคำขอหลายพันล้านครั้ง สำหรับ Crew หนึ่งทีม นี่คือความต่างระหว่าง Agent ตัวแรกกับตัวที่สิบที่ทำงานบน repository เดียวกัน เพราะพวกมันส่ง prefix เดิมซ้ำ ๆ เกือบทั้งหมด ทั้งโครงสร้าง กฎของบ้าน และธรรมเนียมปฏิบัติ และ prefix นั้นก็คือสิ่งที่ cache ถูกออกแบบมาเพื่อรองรับพอดี ต้นทุน token ของ context ใน repository คือที่ที่ใบเรียกเก็บของฝูง agent อยู่จริง
หลักการตัดสินใจที่ตรงไปตรงมาสองข้อ: เพิ่มจำนวน run ที่ทำพร้อมกันได้เมื่อ run ที่เพิ่มขึ้นนั้นรวมไปสู่ผลลัพธ์เดียวที่คนยอมรับ เช่นลองทำ migration หนึ่งงานสามครั้งแล้วให้ test suite เลือกตัวที่ชนะ อย่าเพิ่มเมื่อแต่ละ run ผลิต diff ของตัวเอง สรุปของตัวเอง และการตัดสินใจยอมรับของตัวเอง ไม่ว่า run จะถูกลงแค่ไหน ในกรณีหลัง ใบแจ้งหนี้เป็นสิ่งเดียวที่สเกลได้ดี
ทำให้เพดานใหม่นับได้
งบประมาณเป็นตัวแทนที่ไม่ดีสำหรับกำลังความสามารถ แต่ก็มีข้อดีอยู่หนึ่งอย่าง นั่นคือมันเป็นตัวเลขที่มีคนคอยดูอยู่ เปลี่ยนไปใช้ตัวเลขที่เป็นข้อจำกัดจริงในตอนนี้แทน นั่นก็คือ run ที่เสร็จแล้วและกำลังรอคนอยู่
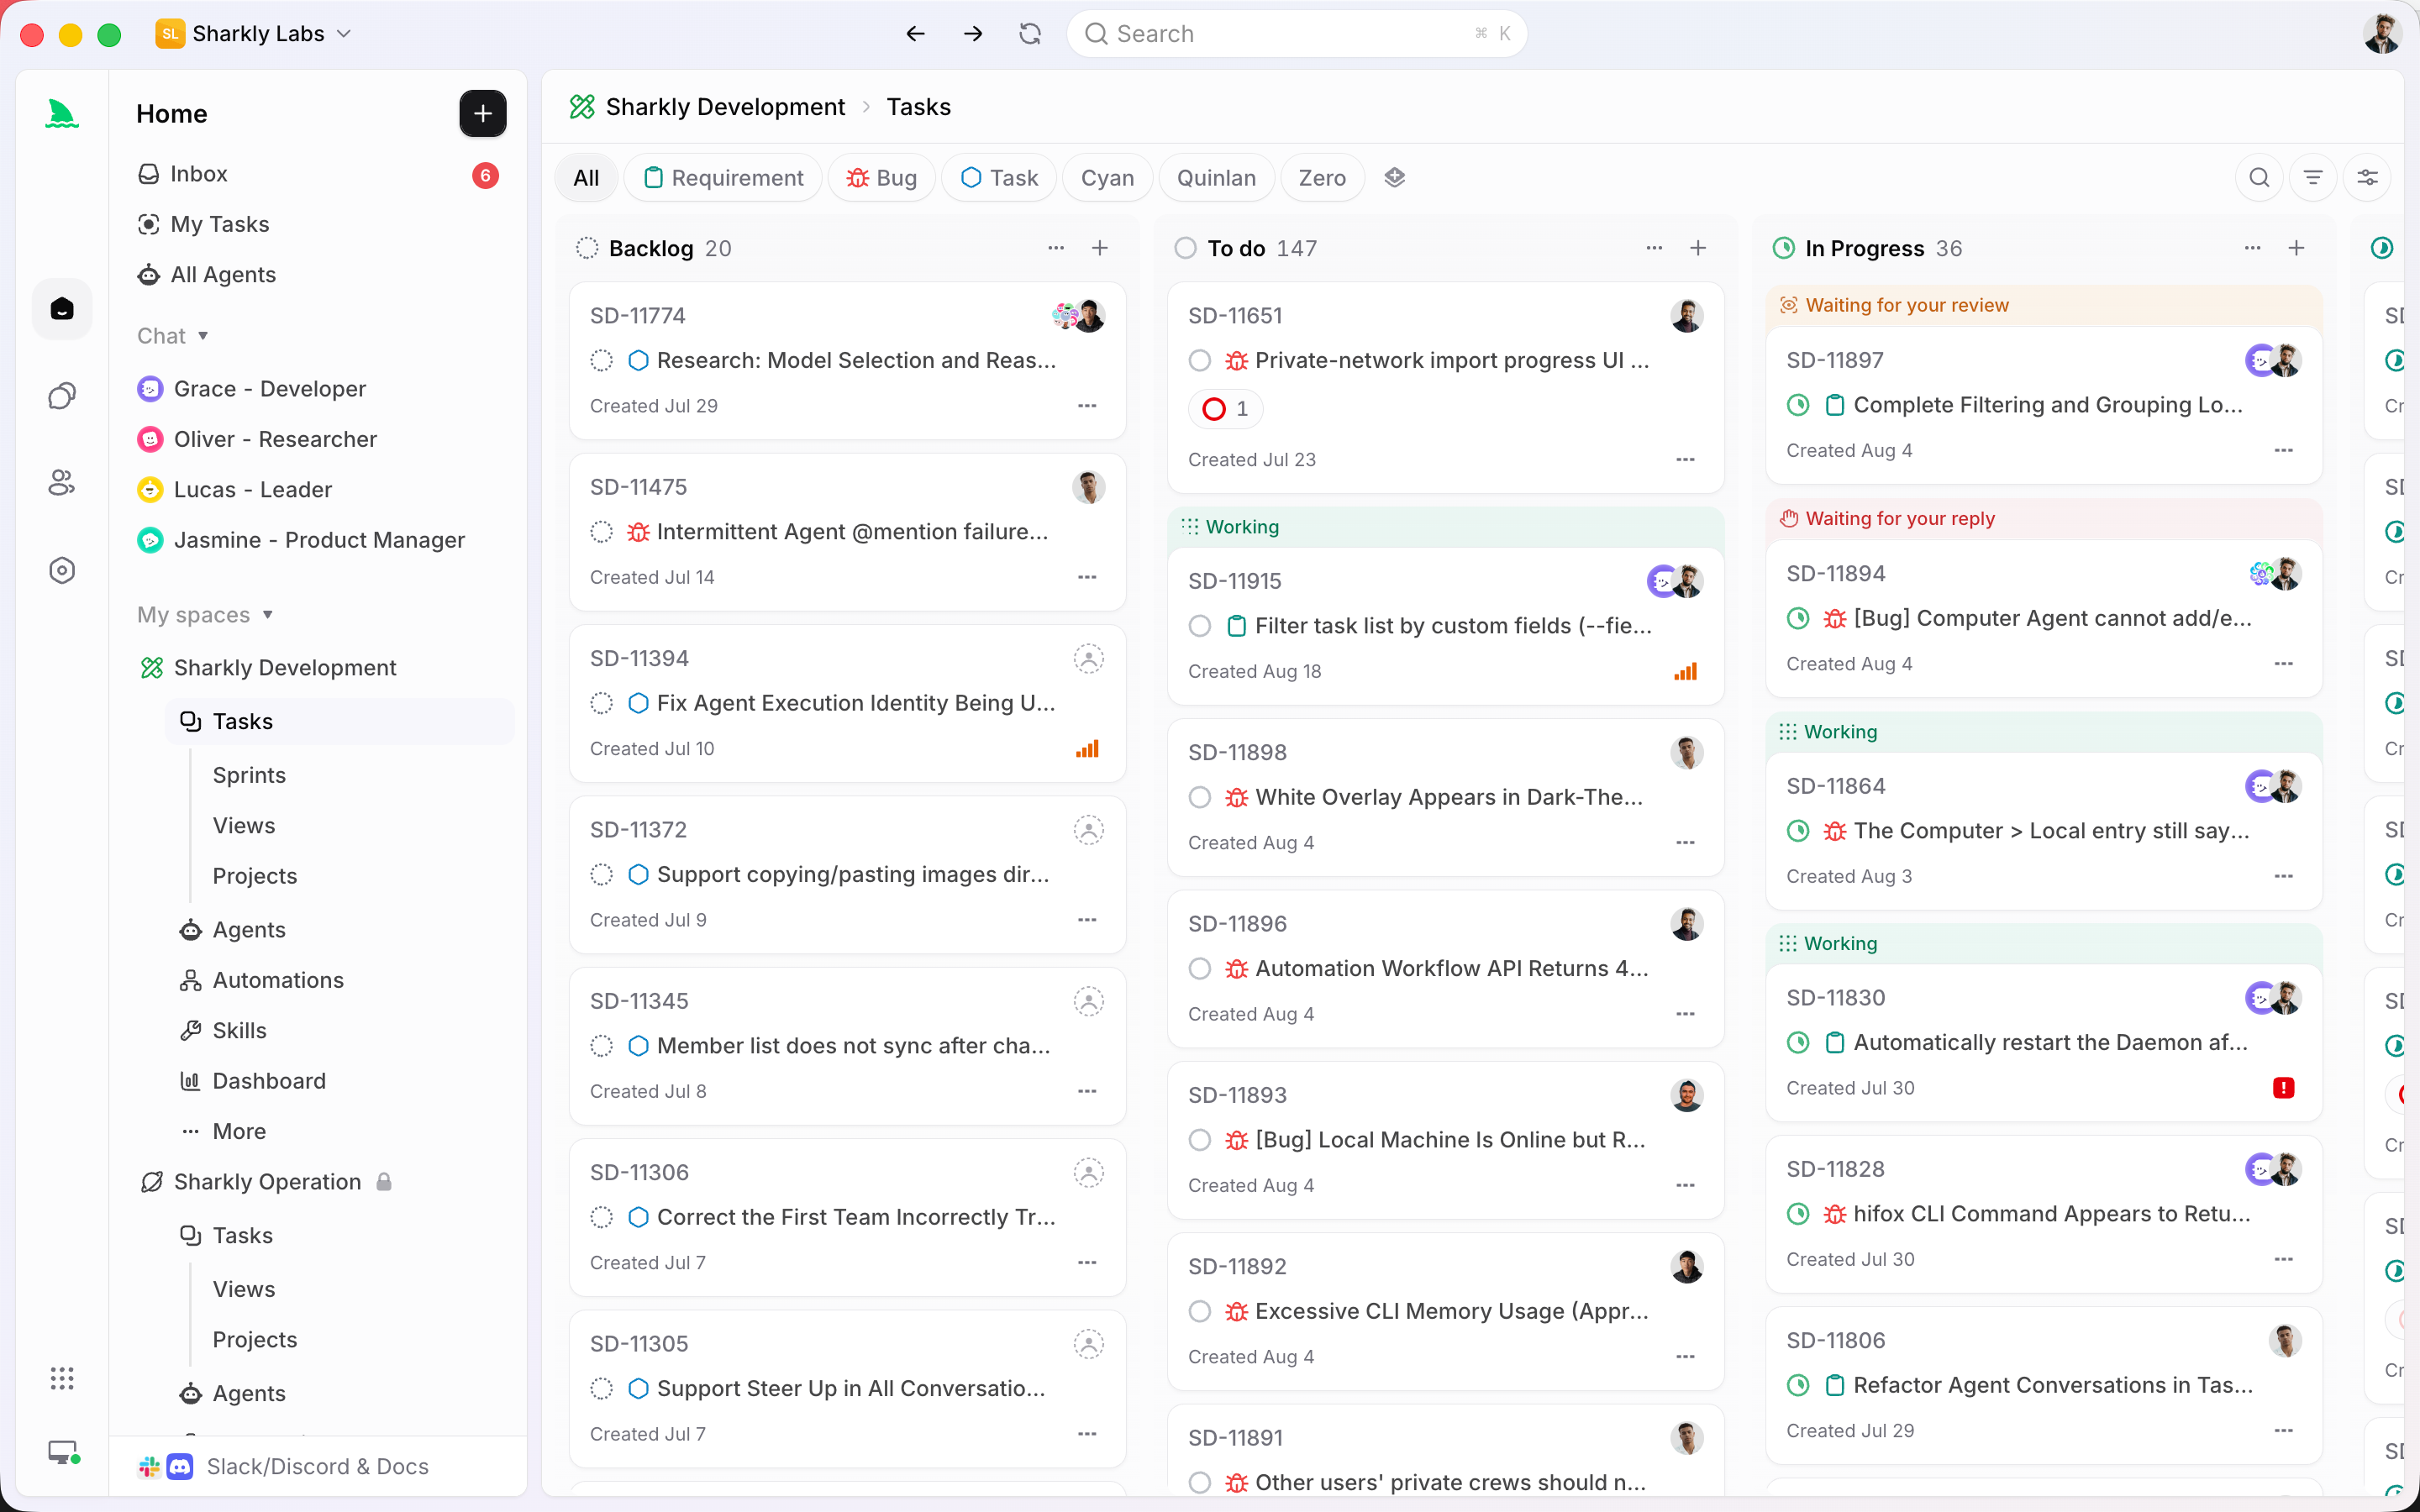
ตัวเลขนั้นจะวัดได้ก็ต่อเมื่อ run เลิกอยู่ใน terminal ส่วนตัวเสียที Sharkly ไม่ใช่ตัวแทนของ Codex, Claude Code หรือเครื่องมืออื่น ๆ ที่รันโมเดลเหล่านี้ แต่มันคือชั้นที่ห่อหุ้มเครื่องมือเหล่านั้นไว้ โดยที่ context ความคืบหน้า อุปสรรค ผลลัพธ์ และการรีวิวโดยมนุษย์ยังมองเห็นได้ตั้งแต่คำขอไปจนถึงการปล่อยงาน การทำงานและอุปสรรคจะย้อนกลับไปที่ Task ดังนั้น "รอคน" จึงกลายเป็นสถานะที่นับได้บนบอร์ด แทนที่จะเป็นความรู้สึกที่เกิดขึ้นบ่ายวันศุกร์ การคำนวณกำลังการรีวิวจะใช้ได้ก็ต่อเมื่อคุณมองเห็นคิว
ถ้าคุณใช้งาน coding agent หลายตัวอยู่แล้ว สิ่งที่ควรทำสัปดาห์นี้ไม่ใช่การปรับเพดานขึ้น แต่คือการหาว่าทีมของคุณยอมรับ run ที่เสร็จสมบูรณ์ได้กี่ครั้งในหนึ่งสัปดาห์ปกติ ตั้งค่า concurrency ให้สอดคล้องกับตัวเลขนั้น และใช้เงินงบที่เหลือไปกับ run ที่ยอมรับได้ง่ายขึ้น


