
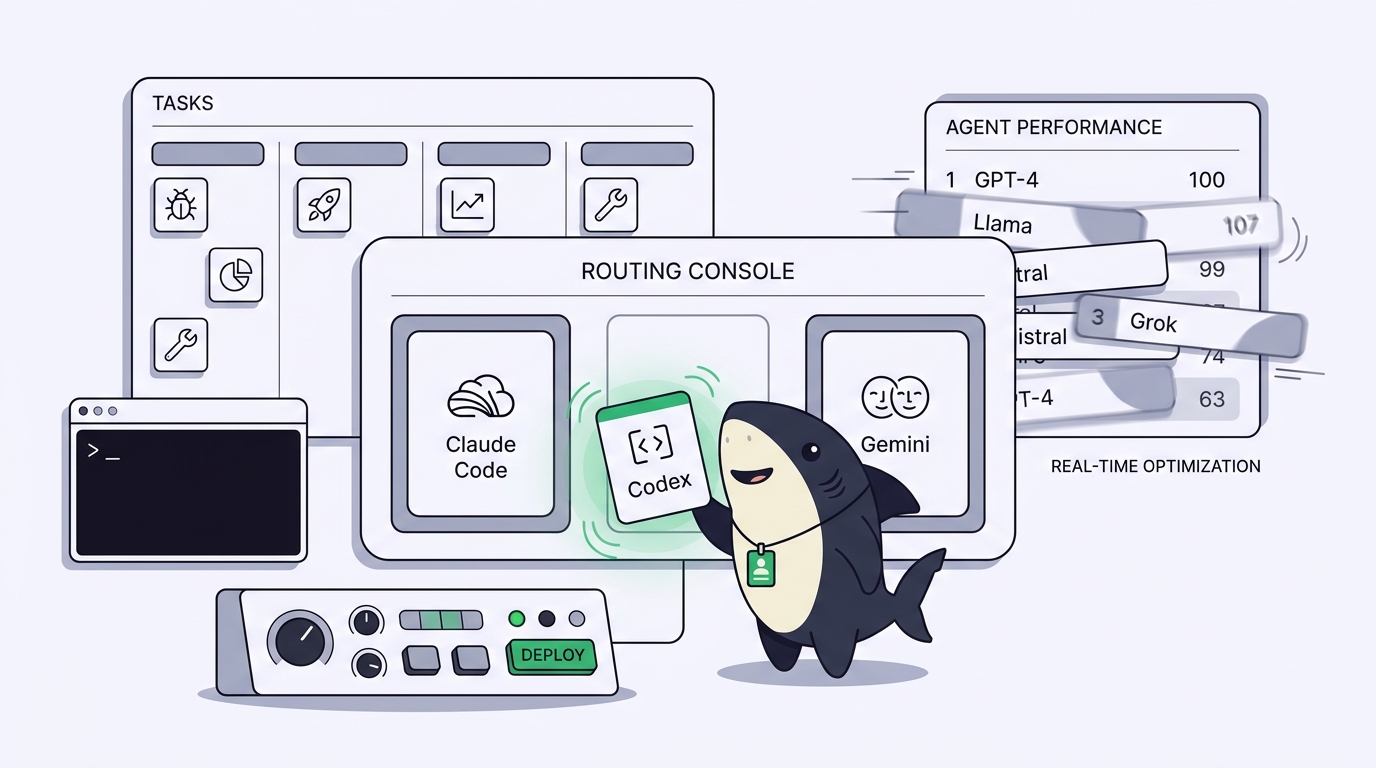
คุณกำลังพยายามเลือกเอเจนต์เขียนโค้ดที่ดีที่สุด คุณอ่านลีดเดอร์บอร์ด ดูโพสต์เปิดตัว ลองรันพรอมป์เดียวกันผ่าน Claude Code, Codex และ Gemini CLI เพื่อดูว่าตัวไหนให้ผลที่คมกว่า จากนั้นก็มีโมเดลใหม่เปิดตัว อันดับถูกสลับใหม่ เอเจนต์ที่คุณเพิ่งตั้งเป็นมาตรฐานเมื่อเดือนที่แล้วจู่ๆ ก็ร่วงไปอยู่กลางตาราง คุณก็เปลี่ยนอีกครั้ง
ส่วนที่ชวนอึดอัดคือตรงนี้ เอเจนต์ที่คุณเลือกมีผลต่อสัปดาห์การทำงานของคุณน้อยกว่าที่คุณคิด สิ่งที่กำหนดว่าคุณส่งงานได้จริงมากแค่ไหนคือสิ่งที่เกิดขึ้นรอบๆ เอเจนต์ต่างหาก เอเจนต์ตัวไหนทำ Task ไหน อะไรเสร็จแล้ว อะไรล้มเหลว อะไรกำลังรอให้คุณรีวิว นักพัฒนาส่วนใหญ่รู้สึกถึงแรงดึงของอันดับบนลีดเดอร์บอร์ด แต่ไม่เคยสังเกตว่าอันดับนั้นไม่เคยเป็นคอขวดเลย
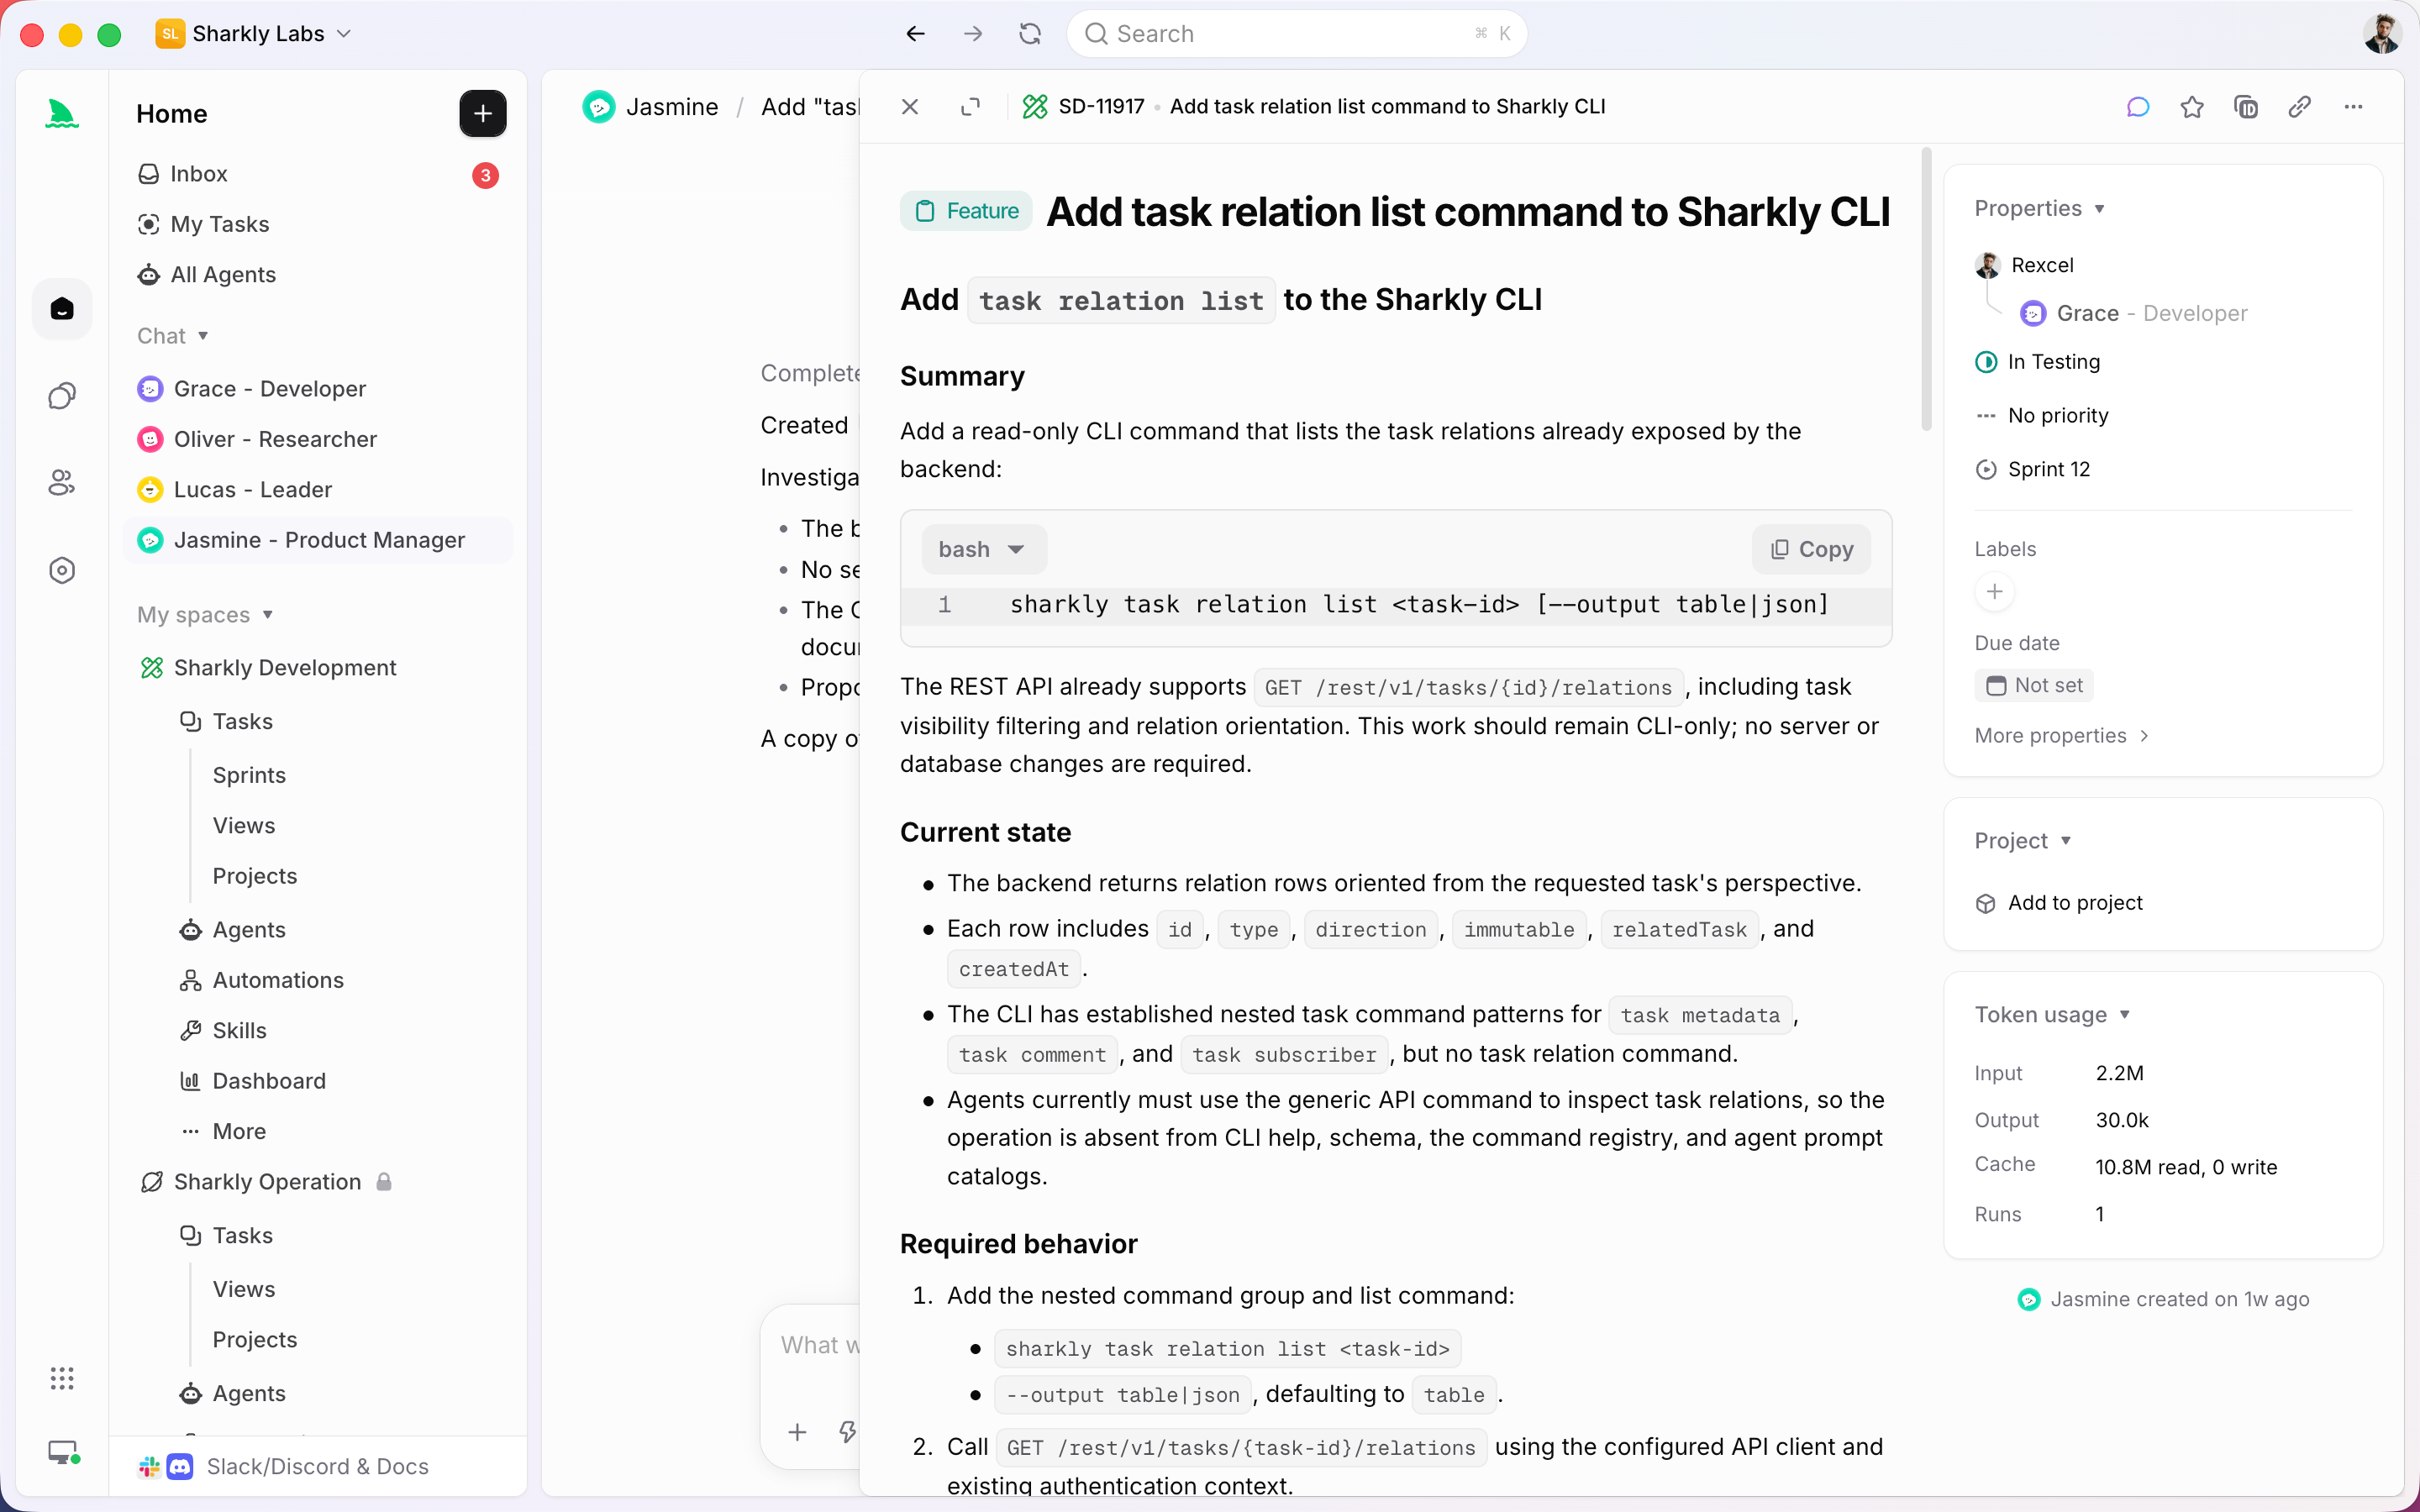
Sharkly สร้างขึ้นจากข้อสังเกตนั้น Sharkly เป็นแพลตฟอร์มสั่งการและจัดการ Agent แบบครบวงจรในตัวเดียว คุณเชื่อมต่อ Computer ของตัวเอง มอบหมาย Task ให้ Agent ตัวไหนก็ได้ที่คุณใช้อยู่ และทุกครั้งที่รัน ผลลัพธ์จะส่งกลับมาที่เดียวทั้ง diff เอาต์พุตการทดสอบ และการรีวิว มันวางตัวอยู่เหนือเอเจนต์ ไม่ได้อยู่ข้างๆ กัน บทความนี้จะพาคุณดูว่าเหตุใดเลเยอร์การจัดการจึงกำหนดผลงานของคุณมากกว่าโมเดล และในไตรมาสนี้ควรทำอะไรแทนการไล่ตามลีดเดอร์บอร์ดตัวถัดไป
เอเจนต์ที่ดีที่สุดคือเป้าที่เคลื่อนที่อยู่เสมอ
ลีดเดอร์บอร์ดเอเจนต์เขียนโค้ดวัดจากชุดปัญหาคงที่และใช้ร่วมกัน ณ ช่วงเวลาหนึ่ง ทั้งสองข้อนี้เสื่อมค่าลงอย่างรวดเร็ว ชุดปัญหาไม่ใช่โค้ดเบสของคุณ และช่วงเวลานั้นก็ไม่ใช่เดือนหน้า
ลองดูความเร็วในการเปลี่ยนแปลง Anthropic, OpenAI และ Google ต่างก็ปล่อยอัปเดตโมเดลที่รองรับการเป็นเอเจนต์เขียนโค้ดหลายครั้งในปีที่ผ่านมา และอันดับสัมพัทธ์ระหว่างกันก็สลับไปมากกว่าหนึ่งครั้งแล้ว [VERIFY: จังหวะการเปิดตัวที่แน่นอนและอันดับปัจจุบันเปลี่ยนแปลงทุกเดือน ควรตรวจสอบก่อนอ้างอิงรายละเอียด] ถ้าคุณมองว่า "ใช้เอเจนต์ที่ดีที่สุด" เป็นการตัดสินใจครั้งเดียว คุณกำลังตกลงว่าจะต้องตัดสินใจเรื่องนี้ใหม่ทุกครั้งที่แล็บไหนปล่อยของออกมา ทุกการสลับมีต้นทุนแฝง ทั้งการตั้งค่าใหม่ ไฟล์ context ใหม่ นิสัยใหม่ และชุดโหมดความล้มเหลวชุดใหม่ที่ทีมต้องเรียนรู้
นี่คือคำทำนาย และขอระบุไว้ชัดๆ ว่าเป็นคำทำนาย ช่องว่างระหว่างเอเจนต์เขียนโค้ดระดับท็อปจะแคบลงเรื่อยๆ ไม่ใช่กว้างขึ้น เมื่อเอเจนต์สามตัวแก้บั๊กเดียวกันในรีโพของคุณได้หมด คำถามก็จะเลิกเป็น "ตัวไหนดีที่สุด" แล้วกลายเป็น "งานชิ้นนี้ควรยกให้ตัวไหน และฉันจะเห็นผลลัพธ์ได้อย่างไร" จุดที่สร้างความต่างจะย้ายจากโมเดลมาสู่เวิร์กโฟลว์ การเปลี่ยนแปลงนี้เห็นได้ชัดอยู่แล้วในวิธีที่ทีมต่างๆ พูดถึงเอเจนต์ และมันจะกลายเป็นวิธีทำงานมาตรฐานก่อนที่จะกลายเป็นข้อยกเว้น
การป้องกันตัวจากเป้าที่เคลื่อนที่ได้ไม่ใช่การเล็งให้แม่นขึ้น แต่เป็นเวิร์กโฟลว์ที่อยู่รอดได้แม้เป้าจะขยับ การเปรียบเทียบเอเจนต์บนโค้ดเบสของคุณเอง บอกคุณได้ว่าตัวไหนคุ้มค่าจะรันในวันนี้ แต่มันไม่ได้ล็อกคุณไว้กับคำตอบนั้นในวันพรุ่งนี้
อะไรกันแน่ที่กำหนดผลงานของคุณ
ลองคำนวณดูว่าภายในงานหนึ่งชิ้น เวลาหมดไปตรงไหน เอเจนต์สร้าง diff เสร็จในไม่กี่นาที ที่เหลือทั้งหมด ทั้งการตัดสินใจว่าเอเจนต์ตัวไหนจะได้งานนี้ การแยกการเปลี่ยนแปลงของมันออกจากเอเจนต์อีกสี่ตัว การรู้ว่ามันค้างอยู่ที่ขั้นตอน build การอ่านสิ่งที่มันสร้างขึ้น การตอบรับหรือปฏิเสธมัน นั่นคือส่วนที่กินเวลาทั้งวันของคุณ และไม่มีข้อใดเลยที่เป็นคุณสมบัติของโมเดล
นี่คือปัญหาด้านการจัดการ และมันจะโผล่ขึ้นมาทันทีที่คุณรันเอเจนต์มากกว่าหนึ่งตัว เอเจนต์ตัวไหนกำลังทำอะไรอยู่ ตัวไหนควรได้งานชิ้นต่อไป อะไรเสร็จ อะไรล้ม อะไรต้องให้คนมาดู ทำอย่างไรไม่ให้เอเจนต์สามตัวที่แก้รีโพเดียวกันไปแตะไฟล์เดียวกัน ยิ่งเอเจนต์แต่ละตัวเก่งขึ้นเท่าไร คุณก็ยิ่งรันมันพร้อมกันมากขึ้นเท่านั้น และคำถามเหล่านี้ก็ยิ่งคมขึ้นตามไปด้วย
Sharkly ตอบคำถามเหล่านี้ในฐานะเลเยอร์ ไม่ใช่เครื่องมือ Task คือหน่วยหลักของงาน คุณมอบหมายมันให้ Agent ตัวหนึ่ง Agent จะรันบน Computer ที่เชื่อมต่อไว้ใน worktree ที่แยกออกมา และการทำงาน อุปสรรค ผลลัพธ์ ตลอดจนงานติดตามผล จะกลับมาอยู่ที่ Task ทั้งหมด เอเจนต์ที่ลงมือทำงานเป็นเพียงการตั้งค่าบน Task ไม่ใช่สถาปัตยกรรมของการตั้งค่าทั้งหมดของคุณ สลับจาก Claude Code เป็น Codex ในงานชิ้นถัดไป แล้วไม่มีอะไรอื่นในกระบวนการของคุณเปลี่ยน นั่นคือสิ่งที่ความเป็นกลางต่อผู้ให้บริการมอบให้คุณ เวิร์กโฟลว์ของคุณอยู่ได้ยืนยาวกว่า ไม่ว่าเอเจนต์ตัวไหนกำลังชนะอยู่ในตอนนี้
กำลังการรีวิวคือเพดานที่แท้จริง
เอเจนต์ที่พิมพ์ว่า "เสร็จแล้ว" ยังไม่ได้ส่งงานอะไรเลย ยังต้องมีคนอ่าน diff ตรวจสอบเทสต์ และตัดสินใจ ขั้นตอนการรีวิวนั้น ไม่ใช่การสร้างโค้ด คือข้อจำกัดที่แทบทุกทีมชนก่อน
คณิตศาสตร์ตรงไปตรงมา ถ้าเอเจนต์ตัวหนึ่งผลิตงานที่ต้องรีวิวเท่ากับหนึ่งวันเสร็จภายในยี่สิบนาที เอเจนต์ห้าตัวก็ผลิตงานรีวิวห้าวันเสร็จในยี่สิบนาทีเดียวกัน และคุณก็ยังมีตาคู่เดิมอยู่ เอเจนต์ที่เร็วขึ้นหรือฉลาดขึ้นทำให้เรื่องนี้แย่ลง ไม่ใช่ดีขึ้น เพราะมันเติมคิวของคุณเร็วขึ้น การเลือกเอเจนต์ที่ดีที่สุดคือการไปจูนขั้นตอนที่ไม่เคยเป็นคอขวด ขณะที่ปล่อยคอขวดจริงไว้ไม่แตะต้อง กำลังการรีวิวคือขีดจำกัดที่แท้จริงของปริมาณงานเอเจนต์แบบขนานที่ทีมจะรับไหว และไม่มีการอัปเกรดโมเดลใดเปลี่ยนคณิตศาสตร์ข้อนี้
ดังนั้นคู่การตัดสินใจที่สำคัญจึงไม่ใช่ "Claude Code หรือ Codex" แต่เป็นแบบนี้ ใช้เอเจนต์ที่เร็วกว่าเมื่อข้อจำกัดของคุณคือการสร้างร่างแรกของการเปลี่ยนแปลง และลงทุนกับเวิร์กโฟลว์การรีวิวเมื่อข้อจำกัดของคุณคือการตัดสินว่าการเปลี่ยนแปลงนั้นถูกต้องหรือไม่ สำหรับทีมส่วนใหญ่ที่รันเอเจนต์แบบขนาน ข้อจำกัดที่สองจะรัดแน่นก่อนข้อแรกมาก ทางแก้คือทำให้ทุกการรัน รีวิวได้ด้วยหลักฐานระดับ Task ทั้ง diff เอาต์พุตการตรวจชนิดข้อมูลและการทดสอบ สรุปการเปลี่ยนแปลง และข้อจำกัดที่เอเจนต์ยอมรับเอง ทั้งหมดอยู่ในที่เดียว แทนที่จะกระจายอยู่ตามเทอร์มินัลต่างๆ
นี่คือจุดที่สัญญาระหว่างคนกับเอเจนต์คุ้มค่ากับการลงทุน เอเจนต์ค้นคว้า ลงมือทำ ทดสอบ และรายงาน ส่วนคนกำหนดทิศทาง มอบอำนาจ และตอบรับผลลัพธ์ ระบบอัตโนมัติหยุดตรงจุดที่ต้องใช้ดุลยพินิจของทีม เอเจนต์ที่ดีขึ้นทำประโยคแรกได้มากขึ้น แต่ไม่ทำประโยคที่สองเลย เพดานอยู่ที่ฝั่งของคุณในเส้นแบ่งนั้น
ทำให้การเลือกเอเจนต์เป็นการตั้งค่า ไม่ใช่สถาปัตยกรรม
นี่คือเส้นแบ่งที่ขอพูดให้ชัดเจน เพื่อไม่ให้ใครเข้าใจผิด Sharkly ไม่ใช่เอเจนต์เขียนโค้ด และไม่ใช่ตัวแทนของ Claude Code, Codex หรือรันไทม์ใดๆ มันไม่ได้เขียนโค้ดเก่งกว่าพวกนั้น แต่เพิ่มเลเยอร์ Task, Computer, context และการรีวิวที่ใช้ร่วมกันไว้รอบๆ เครื่องมือที่ทีมคุณใช้อยู่แล้ว
ความต่างตรงนี้แหละคือประเด็นทั้งหมด เมื่อการเลือกเอเจนต์เป็นการตั้งค่า การลองเอเจนต์ใหม่ก็มีต้นทุนแค่หนึ่งงาน ไม่ใช่การย้ายระบบทั้งหมด คุณเชื่อมต่อรันไทม์ มอบหมายความต้องการจริงให้มัน แล้วอ่านสิ่งที่ส่งกลับมา เทียบกับผลลัพธ์จากเอเจนต์ที่คุณใช้เมื่อวาน แต่ถ้าการเลือกเอเจนต์ถูกฝังลงในสถาปัตยกรรมของคุณ ทุกการทดลองจะมีราคาแพง และทุกครั้งที่ลีดเดอร์บอร์ดสลับอันดับก็กลายเป็นภัยคุกคาม
พูดตรงๆ ว่าตอนไหนที่คุณยังไม่ต้องใช้สิ่งนี้ ถ้าคุณใช้เอเจนต์เขียนโค้ดตัวเดียวและมีความสุขดีอยู่กับเทอร์มินัลเดียว เซสชัน Claude Code ที่ปรับจูนมาดีใน worktree ของตัวเองก็เพียงพอแล้ว และเลเยอร์การจัดการก็เป็นภาระเกินจำเป็นที่ข้ามไปได้ สมการจะเปลี่ยนทันทีที่คุณรันเอเจนต์ตั้งแต่สองตัวขึ้นไป กระจายอยู่บนงานหรือรีโพมากกว่าหนึ่งแห่ง และคุณอยากได้ผลลัพธ์ในรูปแบบที่เพื่อนร่วมทีมอ่านได้โดยไม่ต้องมีคุณมานั่งเล่าไทม์ไลน์ให้ฟัง นั่นคือธรณีประตูที่ การจัดการเอเจนต์เขียนโค้ดกลายเป็นเลเยอร์ที่คุณต้องใช้จริงๆ ไม่ใช่แค่ไอเดียที่ฟังดูดี
ไตรมาสนี้ควรทำอะไรให้ต่างออกไป
เลิกใช้ทั้งสัปดาห์ไปกับการไล่ตามอันดับ แล้วเอาเวลาไปสร้างเลเยอร์ที่ทำให้อันดับกลายเป็นแค่รายละเอียดปลีกย่อย
สามก้าวที่จับต้องได้ ข้อแรก เลือกเอเจนต์แบบเรียบง่ายที่สุด รันสองตัวกับงานจริงจากแบ็กล็อกของคุณ แล้วเก็บตัวที่อ่านผลลัพธ์บนโค้ดของคุณได้ดีกว่า โดยรู้ไว้ว่าคุณจะกลับมาทบทวนอีกครั้ง ข้อสอง วัดปริมาณงานรีวิวของคุณตามจริง ถ้าเอเจนต์ทำงานเสร็จเร็วกว่าที่คุณตอบรับไหว การอัปเกรดเอเจนต์ครั้งต่อไปจะไม่ช่วยคุณ แต่กระบวนการรีวิวที่ดีขึ้นจะช่วย ข้อสาม เลิกฝังเอเจนต์ตัวใดตัวหนึ่งลงในกระบวนการของคุณแบบตายตัว ให้งานไหลผ่านเลเยอร์ที่มองเอเจนต์เป็นสิ่งที่สลับได้ เพื่อให้การเปิดตัวโมเดลครั้งต่อไปเป็นตัวเลือกที่คุณลองใช้ ไม่ใช่การรื้อระบบที่คุณหวั่นเกรง ถ้าคุณยังตัดสินใจไม่ได้ว่าจะให้เอเจนต์แต่ละตัวใช้โมเดลไหน การจับคู่โมเดลกับบทบาทของเอเจนต์ เป็นการใช้เวลาช่วงบ่ายให้คุ้มค่ากว่าการกดรีเฟรชลีดเดอร์บอร์ด
ถ้าคุณอยากใช้เอเจนต์เขียนโค้ดหลายตัวต่อไป แทนที่จะผูกกับระบบนิเวศเดียว นั่นคือโจทย์ที่ Sharkly ถูกออกแบบมาเพื่อแก้ ดาวน์โหลด Sharkly เชื่อมต่อ Computer หนึ่งเครื่อง แล้วมอบหมายงานจริงชิ้นเดียวกันให้เอเจนต์สองตัว ตัวที่ดีที่สุดจะเปลี่ยนไปเรื่อยๆ แต่วิธีที่คุณจัดการพวกมันไม่จำเป็นต้องเปลี่ยนตาม


