
Yapay zeka ajanları için ücretsiz web kazıma artık kendi donanımınızda çalışıyor. Firecrawl Local, siteleri kazıyan, tarayan ve markdown'a dönüştüren tek bir Rust ikili dosyası; Claude Code, Codex, Cursor veya Gemini CLI'ye MCP sunucusu olarak takılıyor ve Firecrawl v2 API'sini localhost üzerinde yanıtlıyor. FIRECRAWL_CLOUD=off ayarını yapın, hiçbir sayfa, sorgu veya URL makinenizden dışarı çıkmaz.
Özet
- Kurulum:
cargo install firecrawl-local(Rust ve bir C derleyicisi gerekir). Bizim derlememiz 5 dakika 55 saniye sürdü ve 19 MB'lık bir ikili dosya oluşturdu. - Bağlama:
firecrawl-local initkomutu, bulduğu tüm desteklenen ajan araçlarına MCP sunucusunu ekler. - Maliyet: scrape, crawl, map ve toplu scrape için $0. Search, engellenen sayfalar ve Alexandria veri sağlayıcıları, siz kapatmadığınız sürece Firecrawl Cloud'a gider.
- Gizlilik anahtarı:
FIRECRAWL_CLOUD=offher şeyi yerelde tutar. - Ekip kurulumu: Ajanlarınızın çalıştığı her Computer'da bir kez kurun, o Computer'daki tüm ajanlar aynı kazıyıcıyı kullanır.
Firecrawl Local nedir
Firecrawl Local, Firecrawl ekibinin geliştirdiği, web sayfalarını getiren, temiz markdown'a dönüştüren ve barındırılan Firecrawl API'sinin döndürdüğü aynı JSON'u döndüren tek bir ikili dosyadır. Veritabanı, kuyruk veya container gerektirmez. Firecrawl bunu 18 Kasım 2026'da duyurdu ve crates.io üzerindeki crate bir hafta önce 0.1.0 sürümüyle yayına girdi.
README bunu kullanmanın üç yolunu açıklıyor: bir CLI, ajanlar için bir MCP sunucusu ve v2 API'sinin yerel bir kopyası. Temizleme kodu, barındırılan API'nin kullandığı aynı kaynaktan derlendiğinden, dizüstü bilgisayarınızdaki bir markdown sayfası, her ikisinin de erişebildiği bir sayfa için bulutun döndüreceği sonuçla eşleşir.
Firecrawl'ın lansman paylaşımı, kendi barındırdığınız Firecrawl'dan 37 kat daha hızlı ve 230 kat daha az bellekle, boşta 11 MB'ta çalışan bir kazıma temel taşı olduğunu iddia ediyor. Bunlar Firecrawl'ın rakamları; README herhangi bir yöntem yayınlamıyor. Bellek kısmını aşağıda kendimiz ölçtük.
Halihazırda birden fazla kodlama ajanı çalıştırıyorsanız, bu, çağrı başına fatura olmadan hepsine verebileceğiniz ilk kazıyıcıdır. Bu rehberin geri kalanı kurulumu, gizlilik anahtarını ve Sharkly üzerinde tüm bir ajan ekibine aynı aracı nasıl vereceğinizi kapsıyor.
Ajanlar neden yerel bir kazıyıcıya ihtiyaç duyar
Web'i okuyamayan bir ajan, bayat eğitim verileriyle çalışır. Görmediği bir API hakkında tahmin yürütür ya da sizden dokümanları sohbete yapıştırmanızı ister.
Barındırılan kazıma API'leri bunu çözer, ancak iki maliyet ekler. Her sayfa ölçümlü bir çağrıdır, yani 400 sayfalık bir dokümantasyon sitesinin taranması faturada bir satır demektir. Ve ajanınızın açtığı her URL başka birinin sunucularından geçer; bu da ajan bir müşterinin alan adını veya henüz yayınlanmamış bir rakip sayfasını araştırırken önem kazanır.
Yerel bir kazıyıcı her ikisini de ortadan kaldırır. Sayfalar kendi ağınızdan getirilir ve kendi CPU'nuzda temizlenir. Bunun bedeli, kurulumun ve bir dizüstü bilgisayarın getirdiği sınırlamaların sorumluluğunu üstlenmenizdir.
Firecrawl Local'i kurun
Rust ve bir C derleyicisine ihtiyacınız var. macOS'ta xcode-select --install derleyiciyi karşılar; Debian veya Ubuntu'da build-essential paketini kurun. Rust'ı rustup üzerinden edinin.
cargo install firecrawl-local
firecrawl-local --version
# firecrawl-local 0.1.0
İki ek bileşen isteğe bağlıdır. Chrome veya Chromium, JavaScript gerektiren sayfaları işlemesini sağlar; bunlar olmadan statik sayfalar yine çalışır ve betik yoğun bir sayfa bir uyarıyla birlikte döner. MCP sunucusu için Node.js 22 veya daha yenisine ihtiyaç vardır, çünkü firecrawl-local mcp komutu firecrawl-mcp npm paketini npx aracılığıyla çalıştırır.
CLI üzerinden scrape, crawl ve map
Üç komut ajan işlerinin çoğunu kapsar.
# Bir sayfa markdown olarak
firecrawl-local scrape https://example.com --markdown

# En fazla 50 sayfa, her biri için bir markdown dosyası
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages

# Bir sitenin sunduğu her URL
firecrawl-local map https://firecrawl.dev
Her birini 19 Kasım 2026'da bulut kapalıyken çalıştırdık. example.com için tek bir scrape 1,6 saniyede tamamlandı. Firecrawl'ın kendi dokümantasyonunun 10 sayfalık taraması 4,2 saniye sürdü ve 144 KB markdown yazdı. map dokümantasyon URL listesini 3,9 saniyede döndürdü.
| Komut | Faydalı bayraklar |
|---|---|
scrape |
--markdown, --format markdown,links, --full-page, --timeout |
crawl |
--limit (varsayılan 100), --max-depth, --include, --exclude, --out |
map |
--search, --limit |
| Herhangi bir komut | --browser auto|never|always |
Testimizden bir dikkat noktası: web'e yalnızca bir proxy üzerinden erişebilen bir ağda, ilk scrape bir TLS hatasıyla başarısız oldu. HTTPS_PROXY ayarını yapmak sorunu çözdü, yani ikili dosya standart proxy değişkenlerini dikkate alıyor.
MCP üzerinden yapay zeka ajanınıza bağlayın
MCP (Model Context Protocol), bir ajan aracının harici araçları yüklemesinin standart yoludur. Firecrawl Local kendini böyle bir araç olarak kaydeder.
firecrawl-local init --dry-run   # nelerin değişeceğini göster
firecrawl-local init             # uygula, önce her yapılandırmayı yedekle
Mac'imizdeki deneme çalıştırması beş hedef listeledi: ~/.claude.json içindeki Claude Code, Claude Desktop, ~/.cursor/mcp.json içindeki Cursor, ~/.gemini/settings.json içindeki Gemini CLI ve ~/.codex/config.toml içindeki Codex. Kuruluysa Windsurf de desteklenir. Sunucuyu yüklemesi için init sonrasında her aracı yeniden başlatın. Yalnızca tek bir aracı kurmak için --agent cursor kullanın.
Elle eklemek için ikili dosyayı bir stdio sunucusu olarak kaydedin:
{
  "mcpServers": {
    "firecrawl": {
      "command": "/Users/you/.cargo/bin/firecrawl-local",
      "args": ["mcp", "--public-only"]
    }
  }
}
Ajan standart Firecrawl MCP araçlarını kullanır. Scrape, crawl, map ve toplu scrape yerelde çalışır; geri kalanı Firecrawl Cloud'a gider. --public-only bayrağı bizim eklememizdir ve aşağıda güvenlik bölümünde açıklanmıştır.
Gizlilik için bulutu kapalı tutun
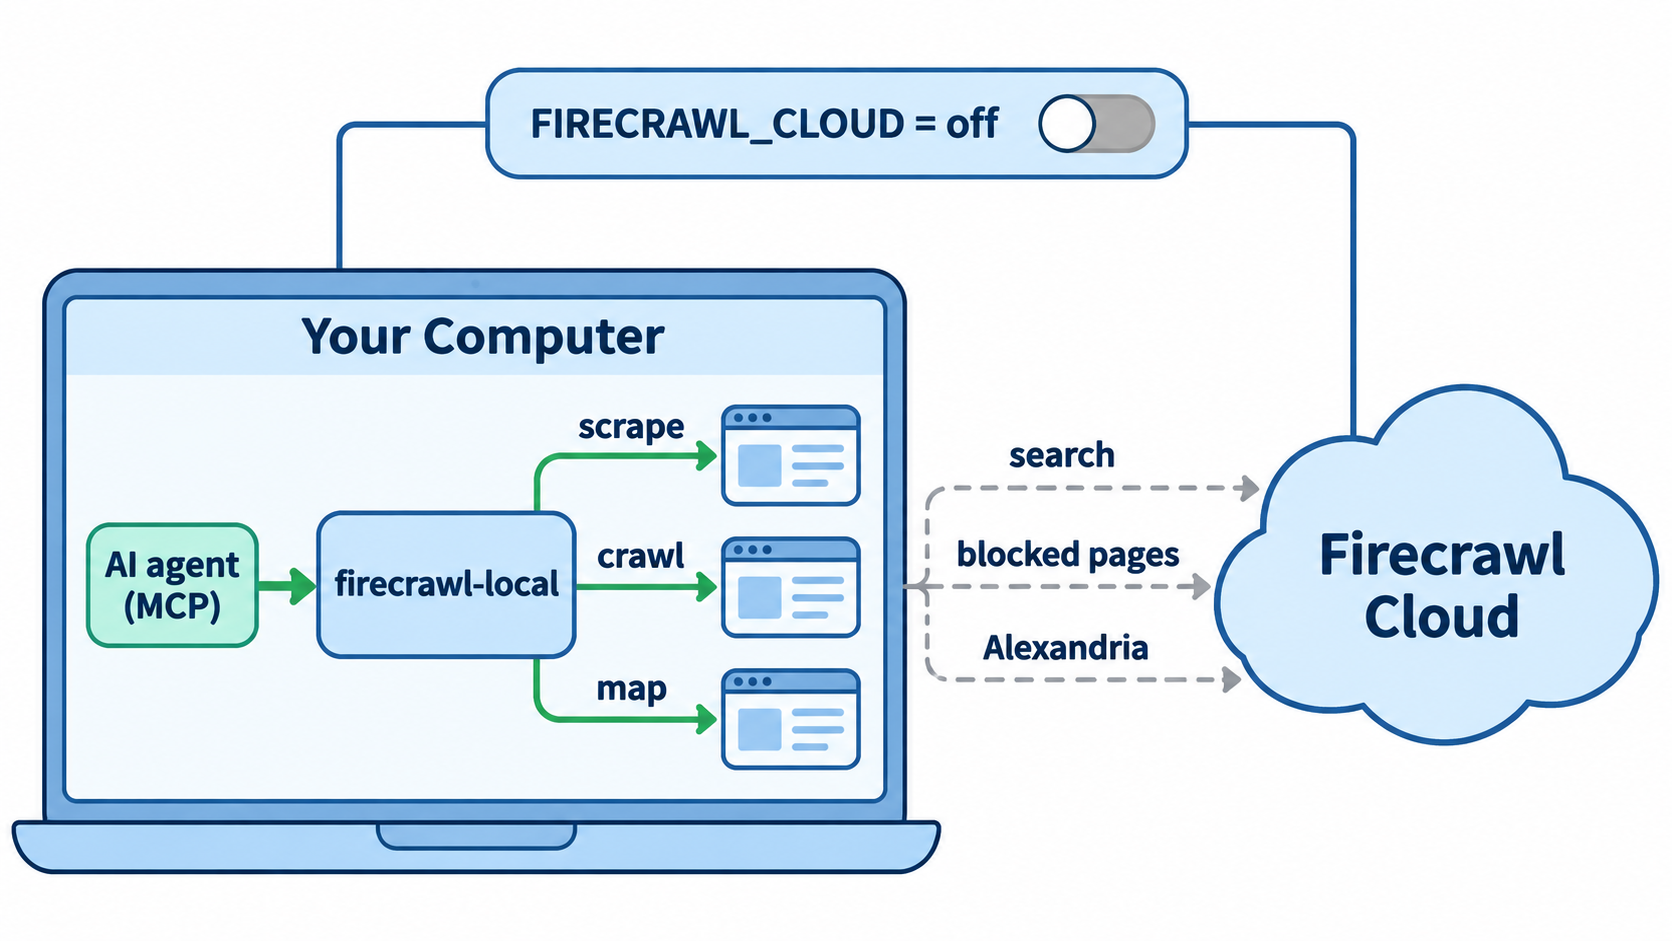
Üç iş Firecrawl Cloud'a ihtiyaç duyar, çünkü bir dizüstü bilgisayarda arama dizini yoktur ve sizi engelleyen bir siteyi aşmanın bir yolu yoktur.
| Firecrawl Cloud'a gönderilen | Neden | Hesap |
|---|---|---|
| Arama sorguları | Yerel arama dizini yok | Hayır; anahtarsız arama hız sınırlamasına tabi |
| Sizi engelleyen bir sayfanın URL'si | Bulut onu sizin için getirir | Hayır |
| Alexandria veri sağlayıcıları | Sağlayıcılar bulutta çalışır | Evet, firecrawl-local login ile ücretsiz bir hesap |
| Rastgele bir kurulum kimliği ve aracınızın adı | Kurulum sayımı | Hayır |
FIRECRAWL_CLOUD değişkeni bu devri kontrol eder. auto (varsayılan) yukarıdakilerin tümüne izin verir. search yalnızca arama sorgularını gönderir. off hiçbir şey göndermez ve tanınmayan bir değer de off olarak sayılır. Buluttan getirilen bir sayfa "source": "firecrawl-cloud" olarak etiketlenir, böylece nelerin dışarı çıktığını denetleyebilirsiniz.
Müşteri siteleri veya dahili araştırmalar üzerinde ajan çalışması için off ile başlayın. Ajanınız web aramasını kaybeder, bu yüzden onu zaten güvendiğiniz arama aracıyla birlikte kullanın.
Firecrawl API'sini yerelde çalıştırın
firecrawl-local serve Firecrawl v2 API'sini yerel rotalar için API anahtarı olmadan 3002 portunda yanıtlar. Mevcut SDK kodları tek bir URL değiştirilerek geçiş yapar.
from firecrawl import Firecrawl

app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)
Yerel rotalar POST /v2/scrape, POST /v2/map, durum ve iptal uç noktalarıyla crawl ve toplu scrape, ve GET /health'tir. /v2/search gibi diğer /v2 rotaları buluta yönlendirir; v0 ve v1 sunulmaz.
Çalışırken belleği ölçtük: serve süreci boştayken 10 MB yerleşik bellekte, bir scrape sonrasında 16 MB'ta duruyordu. Bu, Firecrawl'ın 11 MB iddiasına yakın. API üzerinden bir scrape "creditsUsed": 0 ve "engine": "local-fetch" döndürdü.
Ajanlar için önemli güvenlik varsayılanları
Gizli talimatlar içeren bir sayfayı okuyan bir ajan, dahili bir URL'yi getirmeye yönlendirilebilir. OWASP bu saldırı sınıfını prompt injection olarak listeliyor ve bir kazıyıcı bunun için bariz yoldur.
serve127.0.0.1adresine bağlanır ve--allow-privategeçmediğiniz sürece localhost ve özel adresleri reddeder. Ondaki127.0.0.1:22adresini kazımasını istedik veBLOCKED_TARGETyanıtını aldık.--hostile başka bir ana bilgisayara bağlanmak--tokengerektirir.- Link-local ve bulut metadata adresleri, yönlendirmelerden sonra bile her modda engellenir.
scrape,crawlvemcpvarsayılan olarak özel ağınıza erişebilir, çünkü klavyedeki kişi için çalışırlar. Bir ajan güvenmediğiniz siteleri gezerken--public-onlyekleyin.- Tarama işlemleri
robots.txtdosyasını okur (RFC 9309 standardı) ve site sahipleri kazıyıcıyaFirecrawlLocaladıyla hitap edebilir.
Planlamanız gereken sınırlar
- Yerelde
jsonveyasummaryformatları ve tarayıcıactionsyok. Bizimsummaryisteğimiz metadata artı formatın atlandığına dair bir uyarı döndürdü. - Ekran görüntüleri Chrome gerektirir.
- Crawl ve toplu işler bellekte yaşar, başladıktan bir saat sonra sona erer ve
servedurduğunda biter. - Lisans: depo AGPL-3.0 altında. Değiştirilmiş bir kopyayı barındırılan bir ürünün içinde yayınlamadan önce hukuk ekibinizle görüşün.
Kuyruklar, çalışanlar ve tüm formatlar için Firecrawl'ın kendi sunucunda barındırma rehberi tam sunucuyu kapsar.
Ekipteki her ajana aynı kazıyıcıyı verin
Tek bir ajana sahip tek bir geliştirici burada durabilir. Birden fazla ajan çalıştıran bir ekip farklı bir sorunla karşılaşır: her ajanın araçları çalıştığı bilgisayarın yapılandırmasında yaşar ve kimse hangi ajanın web'i okuyabildiğini takip etmez.
Sharkly'de bir Ajan, bağladığınız bir dizüstü bilgisayar, sunucu veya container olan bir Computer üzerinde, orada kurulu ajan aracı olan bir Runtime (örneğin Claude Code veya Codex) aracılığıyla çalışır. Araçları doğrudan kullanacakmış gibi Computer'a kurarsınız. Ardından bir Ajanın Tools, Knowledge & MCP ayarları, o Computer'daki Claude Code'dan devraldığı MCP sunucularını listeler; buna kullanıcı yapılandırmasındaki stdio sunucuları, yani init komutunun yazdığı kapsam da dahildir.
Yani kurulum şu şekildedir: Firecrawl Local'i Computer'a kurun, init komutunu çalıştırın, Ajanın ayarlarını açın ve Check düğmesine tıklayın. Panelin kullanıcı yapılandırmasındaki stdio sunucularını listelediğini doğruladık; ancak henüz bir Sharkly Task içinde Firecrawl scrape çalıştırmadık, bu yüzden önce salt okunur bir Task'ı test edin.
Kazıyıcıyı her zaman açık bir Computer'a koyun
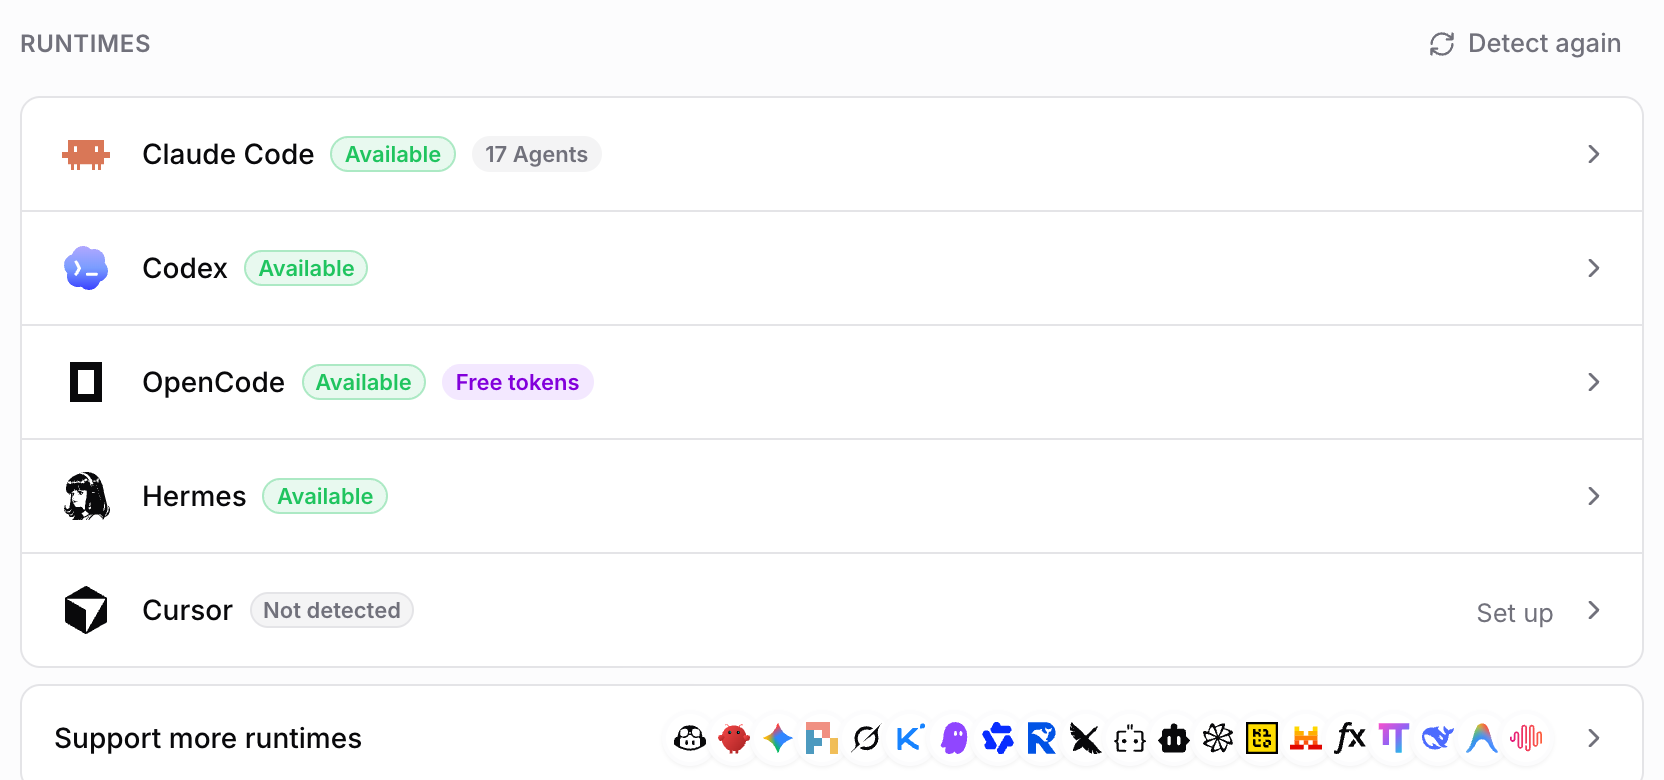
Bir dizüstü bilgisayar uyur. Computer olarak kaydedilmiş küçük bir Linux sunucusu (sit_ kurulum token'ı ile sharkly computer register, Computers dokümanlarına göre) açık kalır, böylece ona yönlendirilen her Ajan tek bir kazıyıcıyı ve tek bir FIRECRAWL_CLOUD politikasını paylaşır. Değişkeni Ajanın Runtime ortamında ayarlayın, böylece politika en son kimin giriş yaptığıyla değil, Ajanla birlikte taşınır.
Buradan itibaren araştırma, atanabilir bir iş haline gelir. Bir Crew lideri "şu beş satıcının dokümanlarını haritala" görevini Task'lara böler, her Ajan kendi payını yerelde tarar ve sonuçlar insan incelemesi için panoya düşer. Sharkly bugün 5 kişiye kadar olan organizasyonlar için ücretsizdir ve Ajanlar ile Computer'lar koltuk işgal etmez; modeller kendi aboneliklerinizde kalır.
Gerçek dünya kullanımları
- Doküman alımı: bir ajan bir bağımlılığı yükseltmeden önce bir kütüphanenin dokümanlarını markdown'a tarayın.
- Potansiyel müşteri araştırması: potansiyel müşteri listesi rehberimizde olduğu gibi yerel kazımayı Alexandria sağlayıcılarıyla birleştirin.
- Değişiklik günlüğü izleme: zamanlanmış bir Task, bir satıcının sitesini her gün haritalar ve yeni URL'leri işaretler.
- Özel araştırma: bulut kapalıyken müşteri veya lansman öncesi sayfaları kazıyın, böylece hiçbir şey ağınızdan çıkmaz. Web aramasını kapatmanın neden veri sızıntılarını durdurmadığı hakkındaki yazımız diğer çıkış noktalarını ele alıyor.
Sonuç
Firecrawl Local, yapay zeka ajanları için ücretsiz web kazımayı altı dakikalık bir derleme ve tek bir init komutuna dönüştürüyor. Gizli işler için FIRECRAWL_CLOUD=off ayarını koruyun, güvenilmeyen siteler için --public-only ekleyin ve siz ölçene kadar hız iddialarını Firecrawl'ın iddiaları olarak kabul edin.
Sıradaki adımınız: ajanlarınızın halihazırda kullandığı Computer'a kurun, ardından o Computer'ı Sharkly'ye bağlayın, böylece ekipteki her Ajan aynı kazıyıcıyı ve aynı kuralları alır. Daha fazla $0 kurulum için ekipler için ücretsiz yapay zeka ajanları yazımıza bakın.
SSS
Firecrawl Local ücretsiz mi? Evet. Scrape, crawl, map ve toplu scrape API anahtarı olmadan yerelde çalışır ve test scrape'imiz 0 kredi kullanıldığını bildirdi. Search ve Alexandria, Firecrawl Cloud'u kullanır.
Firecrawl Local Docker gerektiriyor mu? Hayır. Veritabanı, kuyruk veya container olmayan tek bir ikili dosyadır. Docker yalnızca bir seçenektir ve bir container içinde JavaScript render etmek için Chrome'un sandbox'ına izin veren bir seccomp profili gerekir.
firecrawl-local init hangi ajanları destekler? Claude Code, Claude Desktop, Cursor, Windsurf, Gemini CLI ve Codex. Diğer herhangi bir MCP istemcisi firecrawl-local mcp komutunu bir stdio sunucusu olarak kaydedebilir.
Tüm kazımayı Firecrawl'ın sunucularından uzak tutabilir miyim? Evet. FIRECRAWL_CLOUD=off ayarını yapın. Aramayı, engellenen sayfa yedek mekanizmasını ve Alexandria'yı kaybedersiniz.
Firecrawl Local, kendi barındırdığınız Firecrawl'dan daha hızlı mı? Firecrawl 37 kat daha hızlı ve 230 kat daha az bellek kullandığını söylüyor. Boşta 10 MB bellek ölçtük, bu da bellek iddiasıyla uyuşuyor; hızı kendi barındırdığınız bir sunucuya karşı kıyaslamadık.
Firecrawl Local açık kaynak mı? Depo AGPL-3.0 lisanslıdır. Değiştirilmiş bir kopyayı barındırılan bir hizmetin parçası olarak yayınlamadan önce lisansı okuyun.


