

GPT-6.2 Astra ile Fable 5.2 arasındaki fark, başlıkların ima ettiğinden daha küçük. Her ikisinin de liste fiyatı milyon girdi token'ı başına 8 dolar, milyon çıktı token'ı başına 40 dolar. Anthropic, Fable 5.2 için daha yüksek agentic kodlama puanları yayımlıyor; OpenAI ise Astra için hiçbir kodlama kıyaslama sonucu yayımlamıyor. Önbellek fiyatlandırması, uzun bağlam ek ücretleri ve ekibinizin kendi kabul edilen değişiklik oranı, sizin ekibiniz için kazananı belirliyor.
OpenAI, GPT-6.2 Astra'yı 17 Kasım 2026'da, Anthropic'in Claude Fable 5.2'yi piyasaya sürmesinden sekiz gün sonra yayımladı. Her ikisi de uzun ve zorlu agent işlerini hedefleyen öncü modeller. Kodlama agent'ları çalıştırıyorsanız, artık aynı etiket fiyatına sahip iki amiral gemisi seçeneğiniz var.
Bu konuyu sizin adınıza bir liderlik tablosu çözemez. Bağımlılıklarınız, test paketiniz ve gözden geçirenleriniz çözer. Bu rehber, yayımlanan sayıları karşılaştırıyor, faturaların nerede ayrıştığını gösteriyor ve kendi deponuzda çalıştırabileceğiniz bir birebir test sunuyor. Codex ile Claude Code'u zaten yan yana çalıştırıyorsanız, her ikisine de aynı görevi atadığınız ve sonuçları bir arada tuttuğunuz yer Sharkly'dir.
GPT-6.2 Astra vs Fable 5.2: özellikler yan yana
GPT-6.2 Astra, OpenAI'ın GPT-6.2 ailesindeki öncü modelidir; GPT-6.2 Sol ise onun daha ucuz, günlük kullanıma yönelik kardeş modelidir. Claude Fable 5.2, Anthropic'in genel kullanıma açık en üst modelidir; Mythos 5.2 ise sınırlı erişimli bir sürüm olarak geride tutulmuştur. Her satıcının yayımladığı bilgiler şöyle, 20 Kasım 2026 itibarıyla kontrol edilmiştir.
| GPT-6.2 Astra | Claude Fable 5.2 | |
|---|---|---|
| Yayım tarihi | 17 Kasım 2026 | 9 Kasım 2026 |
| API model kimliği | gpt-6.2-astra |
claude-fable-5-2 |
| Girdi, 1M token başına | $8 | $8 |
| Çıktı, 1M token başına | $40 | $40 |
| Önbelleğe alınmış girdi (önbellek isabeti) | $0.40 | $0.20 |
| Önbellek yazma | $10 (30 dakika) | $10 (5 dakika), $16 (1 saat) |
| Toplu işlem | Standart fiyatın %50'si | $4 girdi, $20 çıktı |
| Hızlı mod | Standart fiyatın 2 katı | $16 girdi, $80 çıktı |
| Bağlam penceresi | 1.050.000 token (en fazla 922.000 girdi) | Standart fiyatlandırmayla 1M token |
| Maksimum çıktı | 128.000 token | 128.000 token |
| Uzun girdi ek ücreti | 272K girdinin üzerinde: girdi ve önbellek oranları ikiye katlanır, çıktı 1.5 katına çıkar | Listelenmiş bir ek ücret yok |
| Olağan kodlama agent'ı | Codex | Claude Code |
Kaynaklar: OpenAI'ın GPT-6.2 Astra model sayfası, Anthropic'in fiyatlandırma belgeleri ve modellere genel bakış sayfası.
Agent'lar için en çok önem taşıyan iki satır bunlar. Bir kodlama agent'ı her turda bağlamını yeniden gönderir, dolayısıyla önbellek isabet oranı faturanın büyük bölümünü şekillendirir. Ayrıca büyük bir depoyu okumuş bir agent, Astra'nın oranlarının değiştiği 272K girdi token'ı eşiğini aşabilir.
Kodlama kıyaslamaları ne söylüyor, ne söylemiyor
Anthropic'in Fable 5.2 duyurusu, Xhigh efor düzeyinde FrontierSWE v2'de %69.9 ve FrontierCode 2.0'da %49.1 oranlarını bildiriyor. Aynı tabloda, OpenAI karşılaştırma sütunu bir önceki nesil olan GPT-6 Astra olarak etiketlenmiş ve %65.5 ve %42.8 değerlerini gösteriyor.
Bu tabloda GPT-6.2 Astra yer almıyor. OpenAI'ın model sayfasında da bunun için herhangi bir SWE tarzı kodlama puanı listelenmiyor. Simon Willison'ın lansman yazısı, "Astra 6.2'nin çeşitli kıyaslamalarda Fable 5.2 kadar yüksek puan almadığını" ve bazı kullanıcıların onun iletişim tarzını "kafa karıştırıcı" bulduğunu belirtiyor.
Yani dürüst okuma üç kısımdan oluşuyor:
- Fable 5.2'nin, bir önceki Astra'nın önünde olan, satıcı tarafından yürütülmüş agentic kodlama puanları yayımlanmış durumda.
- Hiçbir satıcı, GPT-6.2 Astra ile doğrudan bir kodlama karşılaştırması yayımlamadı.
- Yukarıdaki tüm sayılar, modelin kendi satıcısı tarafından, kendi test düzeneğinde, seçilmiş efor düzeylerinde çalıştırıldı.
Kıyaslamaları bir ön eleme filtresi olarak görün. Bu makale, iki modelin hiçbir bağımsız test sonucunu içermiyor.
Faturaların ayrıştığı noktalar
Aynı liste fiyatları, aynı faturalar anlamına gelmez. Üç mekanizma faturaları ayrıştırıyor.
Önbellek isabetleri
Fable 5.2, önbellek isabetinde milyon token başına 0,20 dolar ücret alıyor. Astra ise 0,40 dolar alıyor. Bir oturumda 100.000 token'lık önbelleğe alınmış bir öneki 50 kez yeniden gönderen bir agent için bu önek, yeni girdi ve çıktıdan önce Fable'da 1,00 dolar, Astra'da 2,00 dolara mal oluyor. Simon Willison, Astra'nın önbelleğe alınmış fiyatını hâlâ "daha uzun süren agentic oturumlar için harika haber" olarak nitelendiriyor; bu fiyat, önbelleğe alınmamış 8 dolarlık oranın çok altında.
Uzun bağlam
Astra'nın oranları, bir istek 272K girdi token'ını aştığında yükseliyor. Anthropic ise Fable için 1M'lik tam bağlamı standart oranlarla listeliyor. Agent'larınız rutin olarak bir monorepo'nun yarısını yüklüyorsa, taahhüt vermeden önce bu eşiği hesaplayın.
Efor ve görev başına token
Her iki model de efor düzeyleri sunuyor ve daha yüksek efor daha fazla token tüketiyor. Simon'ın resmi olmayan SVG testi, tek bir istemdeki farkı gösteriyor: GPT-6.2 Astra, High efor düzeyinde 11,55 sente, Max efor düzeyinde ise 88,71 sente mal oldu. Bu bir kodlama kıyaslaması değil, tek bir oyuncak istem, ama 7 kata varan fark, maliyetleri karşılaştırmadan önce efor düzeyini neden sabitlemeniz gerektiğini gösteriyor.
Fable 5.2 fiyatlandırma analizimiz yeniden denemeleri ve inceleme süresini ele alıyor; GPT-6.2 hız limitleri rehberi ise Astra agent'larının ilk önce takıldığı dakika başına token tavanını kapsıyor.
Kendi deponuzda GPT-6.2 Astra vs Fable 5.2 testi nasıl yürütülür
Kendi kodunuz üzerinde yapacağınız birebir karşılaştırma, yayımlanmış herhangi bir tablodan daha iyidir. Aşağıdaki yöntem, daha uzun Fable 5.2'yi kod tabanınızda değerlendirme rehberimizi izliyor; burada ise iki modelli bir düello olarak çalışıyor.
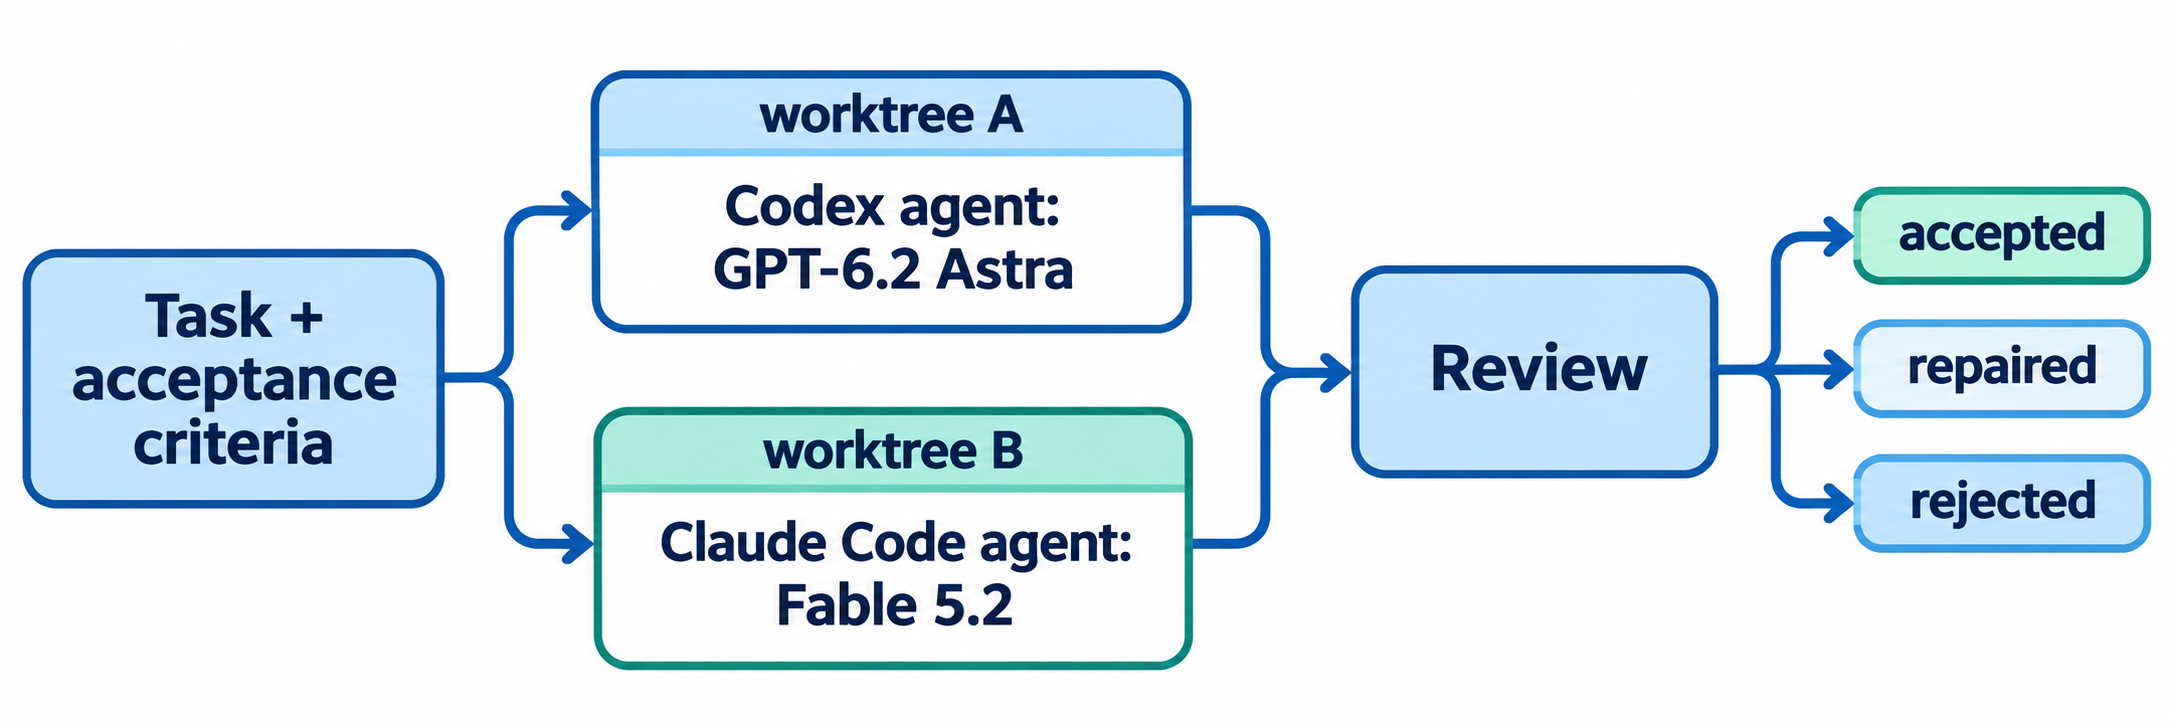
- Backlog'unuzdan 10-12 güncel görev seçin: hata düzeltmeleri, küçük eklemeler, bir refaktör ve bir inceleme.
- Kabul kriterlerini önce yazın, her iki agent çalışmadan önce, böylece hiçbir sonuç çıtayı şekillendirmez.
- Test düzeneğini sabitleyin. Astra en iyi Codex'te, Fable ise Claude Code'da çalışır, yani iki tam iş akışını karşılaştırıyorsunuz. Bunu yazınızda açıkça belirtin.
- Efor düzeyini sabitleyin. Her ikisinde de High seçin ya da kullandığınız tam ayarları belirtin.
- Her denemeyi yeni bir git worktree içinde izole edin, böylece hiçbir agent diğerinin düzenlemelerini devralmaz.
- Her görevi iki modelde de çalıştırın, hangisinin önce gideceğini dönüşümlü olarak değiştirin.
- Mümkün olduğunca kör inceleme yapın ve her sonucu kabul edildi, onarımdan sonra kabul edildi veya reddedildi olarak puanlayın.
- Toplam harcamayı kabul edilen değişikliklere bölün, başarısız denemeler dahil.
Karar veren sayı, kabul edilen değişiklik başına maliyettir. Token başına %20 daha ucuz ama her görevde fazladan bir onarım döngüsüne ihtiyaç duyan bir model, sizin ekibiniz için daha pahalı modeldir.
Her iki modeli de Sharkly'de Agent olarak çalıştırın
Sharkly, zaten kullandığınız kodlama agent'larını çalıştırır; onların yerini almaz. Sharkly'de bir Agent, bağladığınız bir Computer üzerinde, Codex veya Claude Code gibi bir Runtime aracılığıyla Task'ları yürüten, yapılandırılmış bir yapay zeka ekip arkadaşıdır.
Düelloyu iki Agent ile kurun:
- Astra Agent:
gpt-6.2-astraiçin yapılandırılmış bir Codex Runtime. - Fable Agent:
claude-fable-5-2için yapılandırılmış bir Claude Code Runtime.
Her Agent'ın, Runtime'ının bildirdiği modeller arasından Computer, Runtime ve Working directory altında seçilen bir varsayılan modeli vardır. Güncel Agent ayarları için Sharkly yardım merkezine göz atın.
Her iki Agent'a da aynı çalıştırma limitlerini ayarlayın, böylece biri diğerinden daha fazla paralel çalıştırma veya daha uzun bir süre bütçesi almaz.

Geçici çalışma dizini (Temporary working-directory) modunu kullanın, böylece her Task izole bir dizin alır ve depo destekli çalıştırmalar taze bir worktree hazırlayabilir. Kabul kriterlerini Task açıklamasına koyun. Her Agent, yamasını bildirir ve kendi Task'ına rapor verir; bu da her denemeyi gözden geçirenin kararının yanında tutar.
Model kullanımı kendi aboneliklerinizde ve API anahtarlarınızda kalır. Sharkly token satmaz ve model kotası, ekibinizin bağladığı araçlara, planlara ve API hesaplarına bağlıdır.
Doğrudan Astra vs Fable seçimine alternatifler
Tek bir modeli taçlandırmak zorunda değilsiniz.
- Görev türüne göre bölün. Testinizde kazandığı kategorilerde Fable 5.2'yi, geri kalanında Astra'yı kullanın.
- Birini lider yapın, diğerini kadroya alın. Öncü bir model planlar ve inceler; daha ucuz bir model rutin parçaları yapar; bu, GPT-6 Astra'yı Crew lideriniz olarak kullanma yazısındaki yaklaşımdır.
- Bir kademe düşün. GPT-6.2 Sol, milyon token başına 2 dolar girdi ve 10 dolar çıktı olarak listeleniyor. Rutin bakım için çıtanızı dörtte bir fiyata geçebilir.
- İkisini de canlı tutun. Sağlayıcı tarafsızlığı işin özü: Argon, Astra ve Opus yazısında savunulduğu gibi, hiçbir model uzun süre en iyi kalmaz.
Gerçek dünya kullanım senaryoları
- Uzun migrasyonlar. Anthropic, Fable 5.2 agent'larından oluşan bir ekibin bir üretim hizmetini Python'dan Rust'a taşıdığını bildiriyor. Bu tür bir işi, herhangi bir modele güvenmeden önce kendi diliminizde test edin.
- Büyük depo incelemeleri. 272K girdi token'ını aştığınızda Astra'nın fiyatlandırması değişir. Maliyet modelini gerçek bağlam boyutunuzda çalıştırın.
- Paralel hata kuyrukları. İki Agent arasında paylaştırılan on küçük düzeltme, bir hafta içinde size model başına kabul edilen değişiklik oranını verir.
Sonuç
GPT-6.2 Astra ve Fable 5.2, kâğıt üzerinde token başına aynı maliyete sahip. Fable'ın yayımlanmış kodlama puanları daha güçlü ve önbellek isabetleri daha ucuz; Astra'nın bağlam penceresi biraz daha geniş ama 272K girdinin üzerinde oranları daha dik. Bu gerçeklerin hiçbiri, deponuzda hangisinin daha fazla kabul edilen kod teslim ettiğini size söylemez.
Düelloyu çalıştırın. Bir Computer'ı Sharkly'ye bağlayın, GPT-6.2 Astra üzerinde bir Codex Agent'ı ve Fable 5.2 üzerinde bir Claude Code Agent'ı oluşturun ve bu hafta her ikisine de aynı beş görevi atayın. Kabul edilen değişiklik başına maliyette kazanan modeli tutun.
SSS
GPT-6.2 Astra, Claude Fable 5.2'den daha mı ucuz?
Hayır. Her ikisinin de liste fiyatı milyon girdi token'ı başına 8 dolar ve milyon çıktı token'ı başına 40 dolar. Fable'ın önbellek isabetleri daha ucuz (0,40 dolara karşılık 0,20 dolar) ve Astra'nın oranları 272K girdi token'ının üzerinde yükseliyor.
Kodlama için hangisi daha iyi, GPT-6.2 Astra mı yoksa Fable 5.2 mi?
Anthropic, Fable 5.2 için önceki GPT-6 Astra'dan daha yüksek agentic kodlama puanları bildiriyor. Fable 5.2'yi doğrudan GPT-6.2 Astra ile karşılaştıran yayımlanmış bir kıyaslama yok, bu yüzden ikisini de kendi görevlerinizde test edin.
GPT-6.2 Astra ve Fable 5.2'nin bağlam penceresi nedir?
GPT-6.2 Astra, 922.000 token'lık girdi tavanıyla 1.050.000 token listeliyor. Fable 5.2, standart fiyatlandırmayla 1M token'lık bağlam içeriyor. Her ikisi de çıktıyı 128.000 token ile sınırlıyor.
GPT-6.2 Astra'yı Claude Code'da veya Fable 5.2'yi Codex'te kullanabilir miyim?
Her model genellikle kendi satıcısının kodlama agent'ında çalıştırılır: Astra Codex'te, Fable ise Claude Code'da. Bunları karşılaştırmak genellikle iki tam iş akışını, yani model ile test düzeneğini karşılaştırmak anlamına gelir.
İki kodlama modelini adil şekilde nasıl karşılaştırırım?
Aynı görevleri, yazılı kabul kriterlerini, sabit efor düzeylerini ve izole worktree'leri kullanın. Kabul edilen, onarılan ve reddedilen sonuçları puanlayın ve toplam harcamayı kabul edilen değişikliklere bölün.
Sharkly, Agent'ım için modeli mi seçiyor?
Hayır. Her Agent'ın varsayılan modelini, Runtime'ının bildirdiği modeller arasından siz seçersiniz. Sharkly, görevleri modeller arasında otomatik olarak yönlendirmez.


