
Argon mu yoksa Carbon mu? Ajan görevlerinin çoğunu Gemini 4 Argon üzerinde çalıştırın ve yalnızca zor olanları Gemini 4 Carbon'a yönlendirin. Google da bizzat bunu belirtiyor: Argon çoğu yazılım mühendisliği işi için varsayılan model olmayı sürdürürken, Carbon daha zorlu işlere yönelik. Her iki model de 30 Kasım 2026'ya kadar milyon token başına 2 $ girdi ve 10 $ çıktı maliyetine sahip; ancak Carbon, Görev başına daha fazla token harcıyor.
Özetle (TL;DR)
- Varsayılanı ucuz tutun, somut kanıtla üst modele geçin. Her Göreve hızlı modelle başlayın. Yalnızca kontrol edilebilir bir kural görevin zor olduğunu gösterdiğinde veya görev ilk denemede başarısız olduğunda bir üst modele geçin.
- Token başına aynı fiyat, Görev başına aynı maliyet anlamına gelmez. Carbon daha fazla okur, daha derin akıl yürütür ve daha kapsamlı doğrulama yapar; bu yüzden tek bir Görevde daha fazla token harcar.
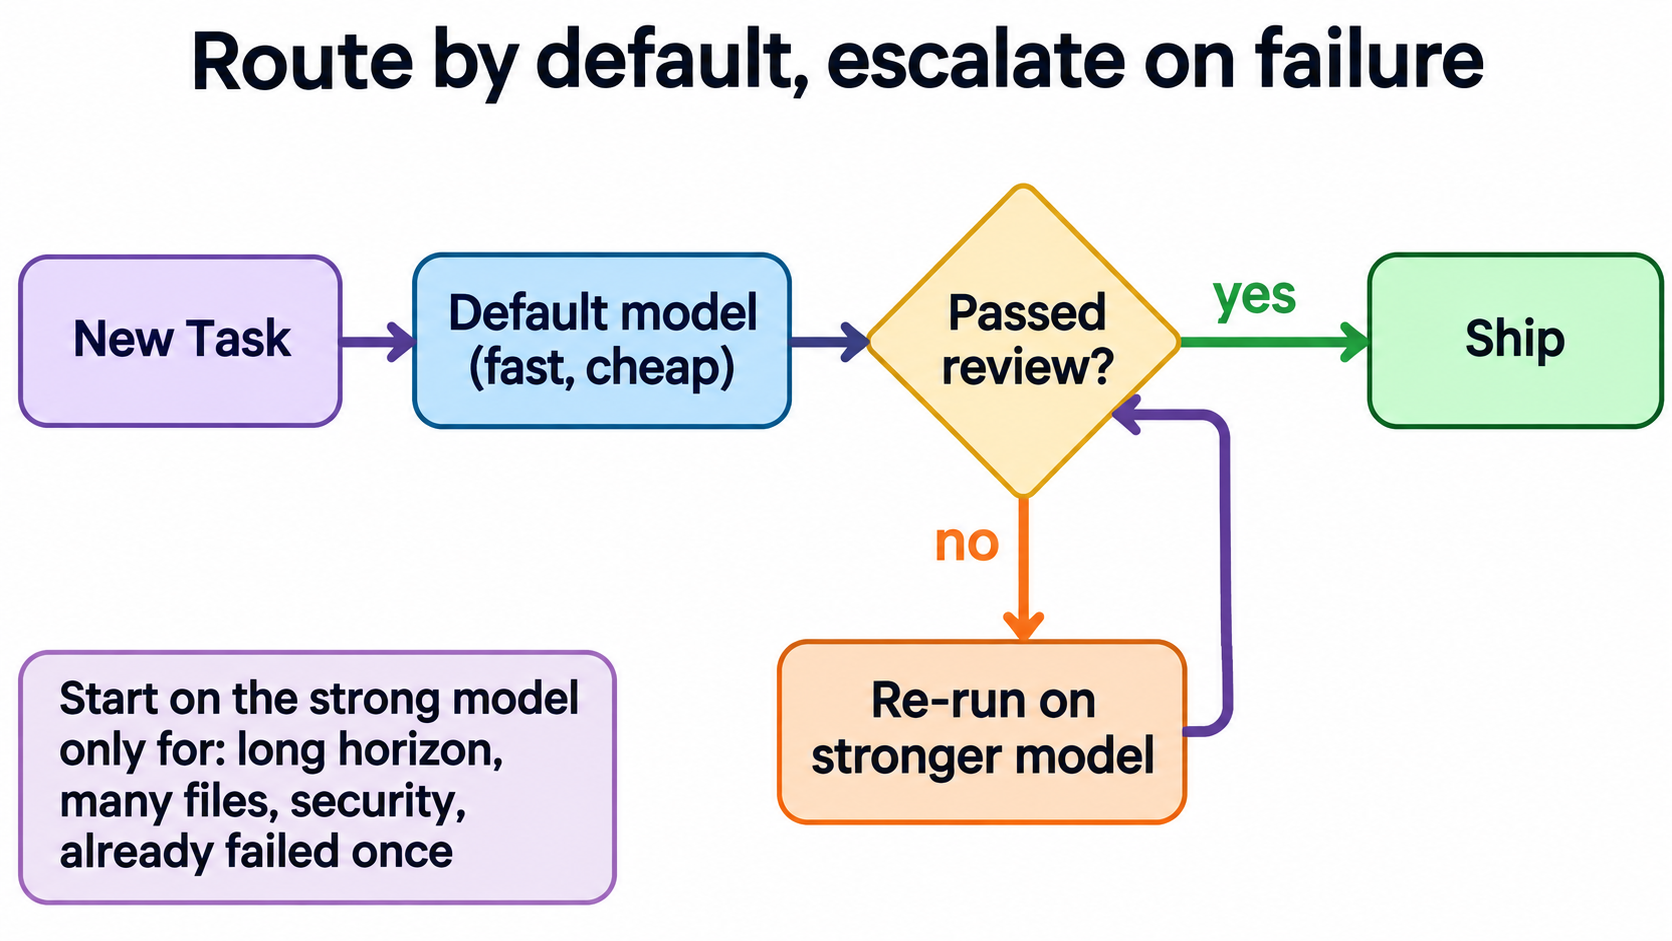
- Zor bir Görevi işaret eden dört sinyal: uzun çalışma süreci (long horizon), çok sayıda dosya, güvenlik etkisi ve başarısız olmuş bir ilk çalıştırma.
- Görev başına iki metriği ölçün: maliyet ve incelemeden (review) geçme oranı. Yönlendirmeyi liderlik tablolarına göre değil, bu metriklere göre yapın.
- Modeli her prompt'ta yeniden vereceğiniz bir karar değil, sabit bir ayar hâline getirin. Sharkly'de her Ajanın varsayılan bir modeli vardır ve Görevi atarken bunu tek bir çalıştırma için geçersiz kılabilirsiniz.
Neden “en iyi model hangisi” yanlış bir sorudur?
Gemini 4 Carbon, 10 Kasım 2026'da gemini-4-carbon model kimliğiyle genel kullanıma (GA) sunuldu. Google'ın GA duyuru yazısı, lansman yazılarında nadiren görülen bir şey yapıyor. Çoğu iş için en yeni modelini kullanmamanızı söylüyor: “Argon, yazılım mühendisliği ve bilgi odaklı işlerin büyük bölümü için ideal tercih olmaya devam ediyor.”
Aynı duyuruya göre Carbon, “bir modelin zekâsının sınırlarını zorlayan görevler için tasarlandı” ve “kapsamlı keşif yapmak, derinlemesine akıl yürütmek ve genişletilmiş doğrulama döngüleri çalıştırmak için Argon'a kıyasla daha fazla token harcıyor.”
Bu yaklaşım, bir ekibin ajanları nasıl çalıştırdığıyla tam olarak örtüşüyor. Elinizde farklı zorluk derecelerine sahip bir Görev kuyruğu var ve her biri, incelemeyi başarıyla geçebilecek en ucuz modeli hak ediyor. Tüm ekip için tek bir “en iyi model” seçmek; kolay Görevlerde gereğinden fazla harcama yapmanıza, zor Görevlerde ise yetersiz güçle kalmanıza yol açar.
Öncelikle Carbon hakkında kapsamlı bilgi edinmek isterseniz Gemini 4 Carbon for coding agents yazımız modelin neler sunduğunu, Gemini 4 Argon rehberimiz ise varsayılan modeli ele alıyor.
Yönlendirme kuralı: Varsayılanı ucuz tutun, zorluk durumunda yükseltin
Kodlama ajanları için model yönlendirme (model routing), ekip bazında değil Görev bazında model seçmek anlamına gelir. Kural tek bir cümleye sığar: Her Görev varsayılan modelle başlar ve yalnızca yazılı bir sinyal görevin zor olduğunu gösterdiğinde veya varsayılan model zaten başarısız olduğunda daha güçlü bir modele aktarılır.
Bu kuralın işlemesini sağlayan iki unsur vardır.
- Çoğu Görev için hızlı ve yeterince iyi bir varsayılan model. Gemini kullanan bir ekip için bu, Google'ın kendi önerisine göre Argon'dur.
- Denetlenebilir bir tetikleyiciye sahip yükseltme yolu. “Bu zor gibi göründü” bir tetikleyici değildir; “Yetkilendirme (auth) koduna dokunuyor” ise geçerli bir tetikleyicidir.
Bir Görevin zor olduğu nasıl anlaşılır?
Bir Görev çalıştırılmadan önce üzerinden okunabilecek somut sinyallere ihtiyacınız vardır. Bu dört sinyal çoğu durumu kapsar.
Uzun soluklu süreçler (Long horizon)
Birbirine bağımlı on değişikliğe sahip bir taşıma (migration) gibi art arda birçok adım gerektiren bir Görev, daha zayıf bir modelin hedeften sapma ihtimalini artırır. Carbon'un ek doğrulama döngüleri tam da bu senaryoyu hedefler. Sinyal: Görev tanımının beşten fazla adımı listelemesi veya benzer bir işin önceki bir çalıştırmada zaman bütçenizi aşmış olması.
Çok sayıda dosya
Sistemin genelini etkileyen (cross-cutting) değişiklikler, modelin kod tabanının daha büyük bir bölümünü aynı anda aklında tutmasını gerektirir. Sinyal: Değişikliğin birkaç pakete veya ondan fazla dosyaya yayılması.
Güvenlik etkisi
Yetkilendirme (auth), ödemeler, gizli anahtarların yönetimi ve izin kontrolleri, modelin kendinden emin şekilde vereceği yanlış bir cevabı affetmez. Google'ın GA duyurusu, siber güvenlik uzmanlarına yönelik Fairwind Programı üzerinden erişildiğinde Carbon'un SEC-bench Pro ve CWE-bench v1 testlerinde lider olduğunu belirtiyor. Sinyal: Görevin hassas olarak işaretlediğiniz bir dosya yoluna temas etmesi.
İlk denemede başarısız olması
Bu, en ucuz ve en dürüst sinyaldir. Varsayılan modelin çalıştırması incelemeden geçemediyse, Görevin bu modelin kapasitesini aştığına dair doğrudan bir kanıtınız var demektir. İnceleyenin yorumunu da ekleyerek görevi daha güçlü modelde yeniden çalıştırın.
Başlangıç için kullanabileceğiniz bir yönlendirme tablosu
Bunu ilk taslak olarak kullanın; iki hafta sonra kendi başarı oranlarınıza göre yeniden düzenleyin.
| Görev türü | Başlangıç modeli | Yükseltilecek model | Neden |
|---|---|---|---|
| Yazım hatası, metin değişikliği, bağımlılık güncellemesi | Hızlı katman (Flash veya mini bir model) | Argon | Küçük diff, kolay inceleme |
| Başarısız bir test içeren hata düzeltmesi | Argon | Carbon | Test net bir geçiş sinyali sunar |
| Tek bir modülde yeni özellik geliştirme | Argon | Carbon | Google'ın çoğu mühendislik işi için belirttiği varsayılan seçenek |
| Çok sayıda dosyayı kapsayan yeniden yapılandırma (refactor) | Carbon | Fable 5.2 veya bir insan | Uzun süreç, çok sayıda dosya |
| Yetkilendirme, ödemeler, izinler | Carbon | Her zaman insan incelemesi | Güvenlik etkisi |
| İncelemede bir kez başarısız olan herhangi bir Görev | Bir üst katman | İnsan | Somut kanıt tahminlerden üstündür |
Claude Fable 5.2, milyon token başına 8 $ girdi ve 40 $ çıktı fiyatıyla listeleniyor; bu da Carbon'un tanıtım fiyatının dört katı. Dolayısıyla varsayılan bir seçenek olmak yerine, Carbon'un üzerinde yer alan son otomatik basamak konumunda. Google'ın dipnotuna göre, 30 Kasım 2026'dan sonra Carbon'un kendi fiyatı 4 $ ve 20 $'a yükselecek ve bu fark daralacak. Bütçelerinizi belirlemeden önce güncel rakamları Gemini API fiyatlandırma sayfasından kontrol edin.
Peşinen değil, başarısızlık durumunda yükseltin
Ekipler, kulağa “zor gelen” her şeyi peşinen en güçlü modele yönlendirme eğilimindedir. Bu güvenli hissettirse de oldukça maliyetlidir; çünkü bu Görevlerin birçoğu aslında varsayılan modelde de incelemeyi başarıyla geçebilirdi.
Başarısızlık durumunda yükseltme yapmak, her Görev için küçük modelin maliyetini ödemenizi, büyük modelin maliyetini ise yalnızca bir Görev buna gerçekten ihtiyaç duyduğunu kanıtladığında ödemenizi sağlar. Ucuz modelle yapılan başarısız bir çalıştırma, genellikle gereksiz yere yapılan pahalı bir çalıştırmadan daha az maliyetlidir.
Bu kuralı bozan iki durum vardır ve yukarıdaki tablo bunları zaten içermektedir. Güvenlik işleri en baştan üst seviyeden başlar; çünkü kötü bir ilk çalıştırma, inceleme sırasında gözden kaçarsa ana koda birleştirilebilir. Çok sayıda dosyayı kapsayan uzun yeniden yapılandırmalar da en baştan üst seviyeden başlar; çünkü orada başarısız bir çalıştırma dakikaları değil, koca bir saati tüketir.
Ayrıca başarısız bir çalıştırma, size yalnızca inceleme aşamasında yakalanırsa bir anlam ifade eder. Modeller testleri manipüle edebilir; bu nedenle yükseltme sürecini kodlama ajanlarının testlerde hile yapması nasıl yakalanır başlıklı yazımızdaki kontrollerle birlikte uygulayın.
Görev başına maliyeti ve incelemeden geçme oranını ölçün
Verilere dayanmayan bir yönlendirme, kişisel görüşlerden ibaret kalır. Her Görev için iki şeyi takip edin:
- Görev başına maliyet: Başarısız olanlar da dâhil olmak üzere, Görevin aldığı her çalıştırmadaki girdi ve çıktı token'larının ilgili modelin fiyatıyla çarpılarak toplanması.
- İncelemeden geçme oranı: İlk çalıştırma onaylandı mı, yoksa yeniden çalıştırma veya bir insanın düzeltmesi gerekti mi?
Ardından bu iki metriği oranlayın. Yönlendirmeye karar veren asıl gösterge, kabul edilen değişiklik başına düşen maliyettir. Yarı yarıya başarısız olan ucuz bir model, ilk denemede başarılı olan güçlü bir modelden daha pahalıya mal olabilir; daha ucuz bir modelin ne zaman daha pahalıya geldiğini anlatan yazımızdaki temel argüman da budur.
Üçüncü taraf verileri de aynı noktaya işaret ediyor. Artificial Analysis, Zekâ Endeksi'ni (Intelligence Index) çalıştırma maliyetinin Gemini 4 Carbon (high) üzerinde 7,76 $, Claude Fable 5.2 (max) üzerinde ise 26,54 $ olduğunu ve Fable'ın 65, Carbon'un ise 60 puan aldığını bildiriyor. 3,4 katlık bir maliyet farkına karşılık gelen beş puanlık bir skor farkı, yalnızca bu beş puanın nihai sonucu gerçekten değiştirdiği Görevler için ödemeye değerdir.
Başlangıç için basit bir kayıt tutmak yeterlidir:
task       model          runs  tokens_in  tokens_out  cost_usd  passed_first
COIN-212   gemini-4-argon    1     48,000      9,500      0.19   yes
COIN-213   gemini-4-argon    2    121,000     22,000      0.46   no
COIN-213   gemini-4-carbon   1    210,000     41,000      0.83   yes
Burada COIN-213, Argon üzerinde başarısız oldu, üst modele aktarıldı ve Carbon'da başarıyla tamamlandı. Görev toplamda 1,29 $'a mal oldu ve bu satır, buna benzer Görevlerin bir dahaki sefere doğrudan Carbon ile başlayıp başlamaması gerektiğini size gösterir.
Bunu bir pano üzerinden Görev bazında yönetin
Her geliştirici kendi terminalinde kafasına göre model seçtiğinde bu kuralı ifade etmek kolay, uygulamak ise zordur. Yönlendirmeyi doğrudan Görevlerin bulunduğu yere taşıyın.
Her Ajana sabit bir model atayın
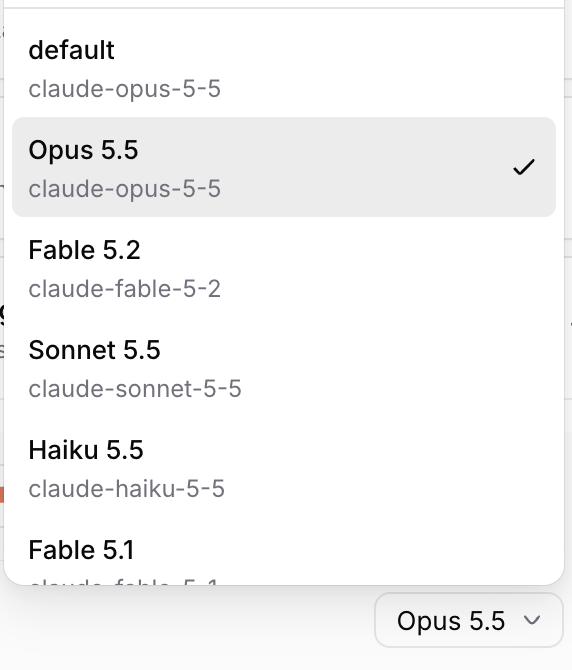
Sharkly'de bir Ajan varsayılan olarak kendi Çalışma Zamanı'nın (Runtime) modelini izler. Ajan ayarlarındaki Model satırı ise ilgili Runtime kataloğundan başka bir model ve eğer model destekliyorsa bir düşünme derinliği (thinking depth) seçmenize olanak tanır. Konuyla ilgili ayrıntıları Agents belgelerinde bulabilirsiniz. Bu sayede her katman için bir Ajan elde edersiniz: Hızlı modelde çalışan varsayılan bir Ajan ve güçlü modelde çalışan bir eskalasyon Ajanı.
Tek bir çalıştırmayı yükseltin
Bir Görev atadığınızda, yalnızca o çalıştırmaya özel olarak Ajanın varsayılan modelini geçersiz kılabilir ve farklı bir model seçebilirsiniz. Bu, başarısızlık durumunda yükseltmeyi tek adımda çözmenizi sağlar: İnceleyen kişi Görevi geri gönderir ve diğer herkesin kullandığı Ajanı değiştirmeye gerek kalmadan yeni çalıştırma doğrudan Carbon üzerinde başlatılır.
Tüm kayıtları tek bir yerde tutun
Her çalıştırma kendi yürütme günlüğünü saklar; böylece maliyet ve başarı oranı tablonuz tahminlere değil, tamamlanıp teslim edilen gerçek Görevlere dayanır. İşi zorluk derecesine göre değil de role göre bölen Ekipler (Crews) için model routing for agent Crews yazımıza göz atabilirsiniz. Denetim boyutu için ise ekibinizin elindeki kontrolleri ele alan who stops your agents başlıklı yazımızı inceleyebilirsiniz. Sharkly'yi kullanmaya ücretsiz başlayabilirsiniz.
Görev bazında yönlendirmeye alternatifler
- Her şey için tek bir model. Bireysel bir geliştirici için uygun olabilir ancak Görevler çeşitlendikçe israfa dönüşür.
- Otomatik yönlendirici model. Küçük bir model her prompt'u sınıflandırıp hedef modeli seçer. Karar mekanizmasını gizler ve inceleme aşamasındaki başarısızlığı göremez.
- Ajan-ekip (agent-team) modları. Google'ın Antigravity içindeki /swarm önizlemesi, daha hafif modeller paralel çalışırken planlama ve denetleme görevlerini Carbon'a verir. Bu, tek bir iş içinde role göre yönlendirmedir ve Görev bazında yönlendirmenin tamamlayıcısıdır.
Sonuç
Google, yönlendirme kuralını bizzat kendi duyuru yazısında verdi: Varsayılan olarak Argon, Görev bunu hak ettiğinde ise Carbon. Zor Görevleri işaret eden dört sinyalinizi belirleyin, geri kalan her şeye ucuz modelle başlayın, başarısız incelemelerde üst modele geçin ve Görev başına maliyet ile başarı oranını kaydedin. İki hafta sonra kendi verileriniz, bu tabloyu herhangi bir kıyaslama testinden çok daha iyi şekilde baştan yazacaktır.
Sonraki adım: Sharkly'de biri varsayılan modelinizde, diğeri ise yükseltme modelinizde çalışan iki Ajan oluşturun ve bu haftanın Görevlerini onlar üzerinden yönlendirin.
Sıkça Sorulan Sorular
Kodlama ajanları için Gemini 4 Carbon mu yoksa Argon mu kullanmalıyım?
Görevlerin çoğu için Argon'u, zor olanlar için ise Carbon'u kullanın. Google'ın GA duyurusu, Argon'un “yazılım mühendisliğinin büyük bölümü için ideal tercih olmaya devam ettiğini”, Carbon'un ise bir modelin sınırlarını zorlayan Görevler için olduğunu belirtiyor.
Gemini 4 Carbon, Argon'dan daha mı pahalı?
Token bazında hayır: 30 Kasım 2026'ya kadar her iki model de milyon token başına girdi için 2 $, çıktı için 10 $ maliyete sahiptir. Görev bazında ise genellikle evet; çünkü Google'ın belirttiği üzere Carbon keşfetmek ve doğrulamak için daha fazla token harcar.
30 Kasım'dan sonra Gemini 4 Carbon fiyatlandırmasına ne olacak?
Google'ın dipnotuna göre tanıtım fiyatı 30 Kasım 2026'da sona erecek ve Carbon milyon girdi token'ı başına 4 $, milyon çıktı token'ı başına ise 20 $ fiyatlandırmaya geçecek.
Yapay zekâ ajanları için model yönlendirme nedir?
Model yönlendirme, kabul edilen değişiklik başına en düşük maliyeti hedefleyerek her Görev için zorluğuna uygun modeli seçmek anlamına gelir.
Bir Görevin ne zaman daha güçlü bir modele yükseltilmesi gerektiğini nasıl anlarım?
Görev uzun bir sürece yayılıyorsa, çok sayıda dosyayı kapsıyorsa, güvenlik açısından kritik koda temas ediyorsa veya varsayılan modelde incelemeden zaten geçemediyse daha güçlü bir modele yükseltin.
Sharkly'de her ajan için farklı bir model belirleyebilir miyim?
Evet. Her Ajanın ayarlarında, kendi Çalışma Zamanı kataloğundan seçim yapabileceğiniz bir Model satırı bulunur ve bir Görev atarken modeli tek bir çalıştırma için geçersiz kılabilirsiniz.


