
Anthropic cho biết chạy Claude Opus 5.5 tốn ít hơn 40% so với Opus 5. Hẳn ai đó trong nhóm bạn đã làm ngay phép tính hiển nhiên: cùng ngân sách thì được khoảng 1,7 lần số lượt chạy agent, tức là khoảng 1,7 lần khối lượng công việc được đưa ra. Phép tính đó đúng về mặt số học nhưng sai về mặt vận hành, và tuần mà nó được đem ra áp dụng cũng chính là tuần bảng điều khiển của bạn ngập đầy những lượt chạy đã xong mà chẳng ai buồn đọc.
Rào cản đối với việc chạy nhiều agent song song chưa bao giờ nằm ở hóa đơn model. Nó nằm ở khả năng của một con người: đọc một diff, hiểu agent đã quyết định điều gì và chấp nhận nó. Một đợt giảm giá không làm thay đổi con số đó chút nào. Nó chỉ khiến công việc ùn tới đó nhanh hơn.
TL;DR
Trần đánh giá là số lượt chạy agent đã hoàn thành mà một nhóm thực sự có thể đọc, đánh giá và chấp nhận trong một ngày, và con số này do con người quyết định chứ không phải do token. Các model rẻ hơn làm tăng tốc độ công việc đổ về cái trần đó nhưng không hề lay chuyển chính nó, nên hiệu ứng dễ thấy đầu tiên của một đợt giảm giá là hàng đợi dài hơn, chứ không phải bản release nhanh hơn. Agent nghiên cứu, thực thi, kiểm thử và báo cáo. Con người định hướng, trao quyền và chấp nhận kết quả. Cách ứng phó hữu ích là giới hạn số lượng chạy song song dựa trên số người review thay vì dựa trên ngân sách, đồng thời tách công việc agent hội tụ về một kết quả duy nhất có thể review khỏi công việc agent tỏa ra thành nhiều kết quả. Sharkly giữ cho bối cảnh, tiến độ, điểm nghẽn, kết quả và phần review của con người luôn hiển thị trên Task từ lúc có yêu cầu đến lúc release — chính điều này khiến hàng đợi trở thành thứ đếm được ngay từ đầu.
Thực ra thứ gì đã rẻ đi
Hai phòng lab cùng ra mắt sản phẩm vào ngày 22/09/2026. Đây là phần liên quan đến hóa đơn của bạn.
| Claude Opus 5 | Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|---|
| ID API | claude-opus-5 |
claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| Đầu vào mỗi 1M token | $5 | $4 | $2 | $0.10 |
| Đầu ra mỗi 1M token | $25 | $20 | $10 | $0.50 |
| Đầu vào từ cache | không áp dụng | $0.20 cho đọc, $5 cho ghi | giảm 90% cho lượt đọc | giảm 90% cho lượt đọc |
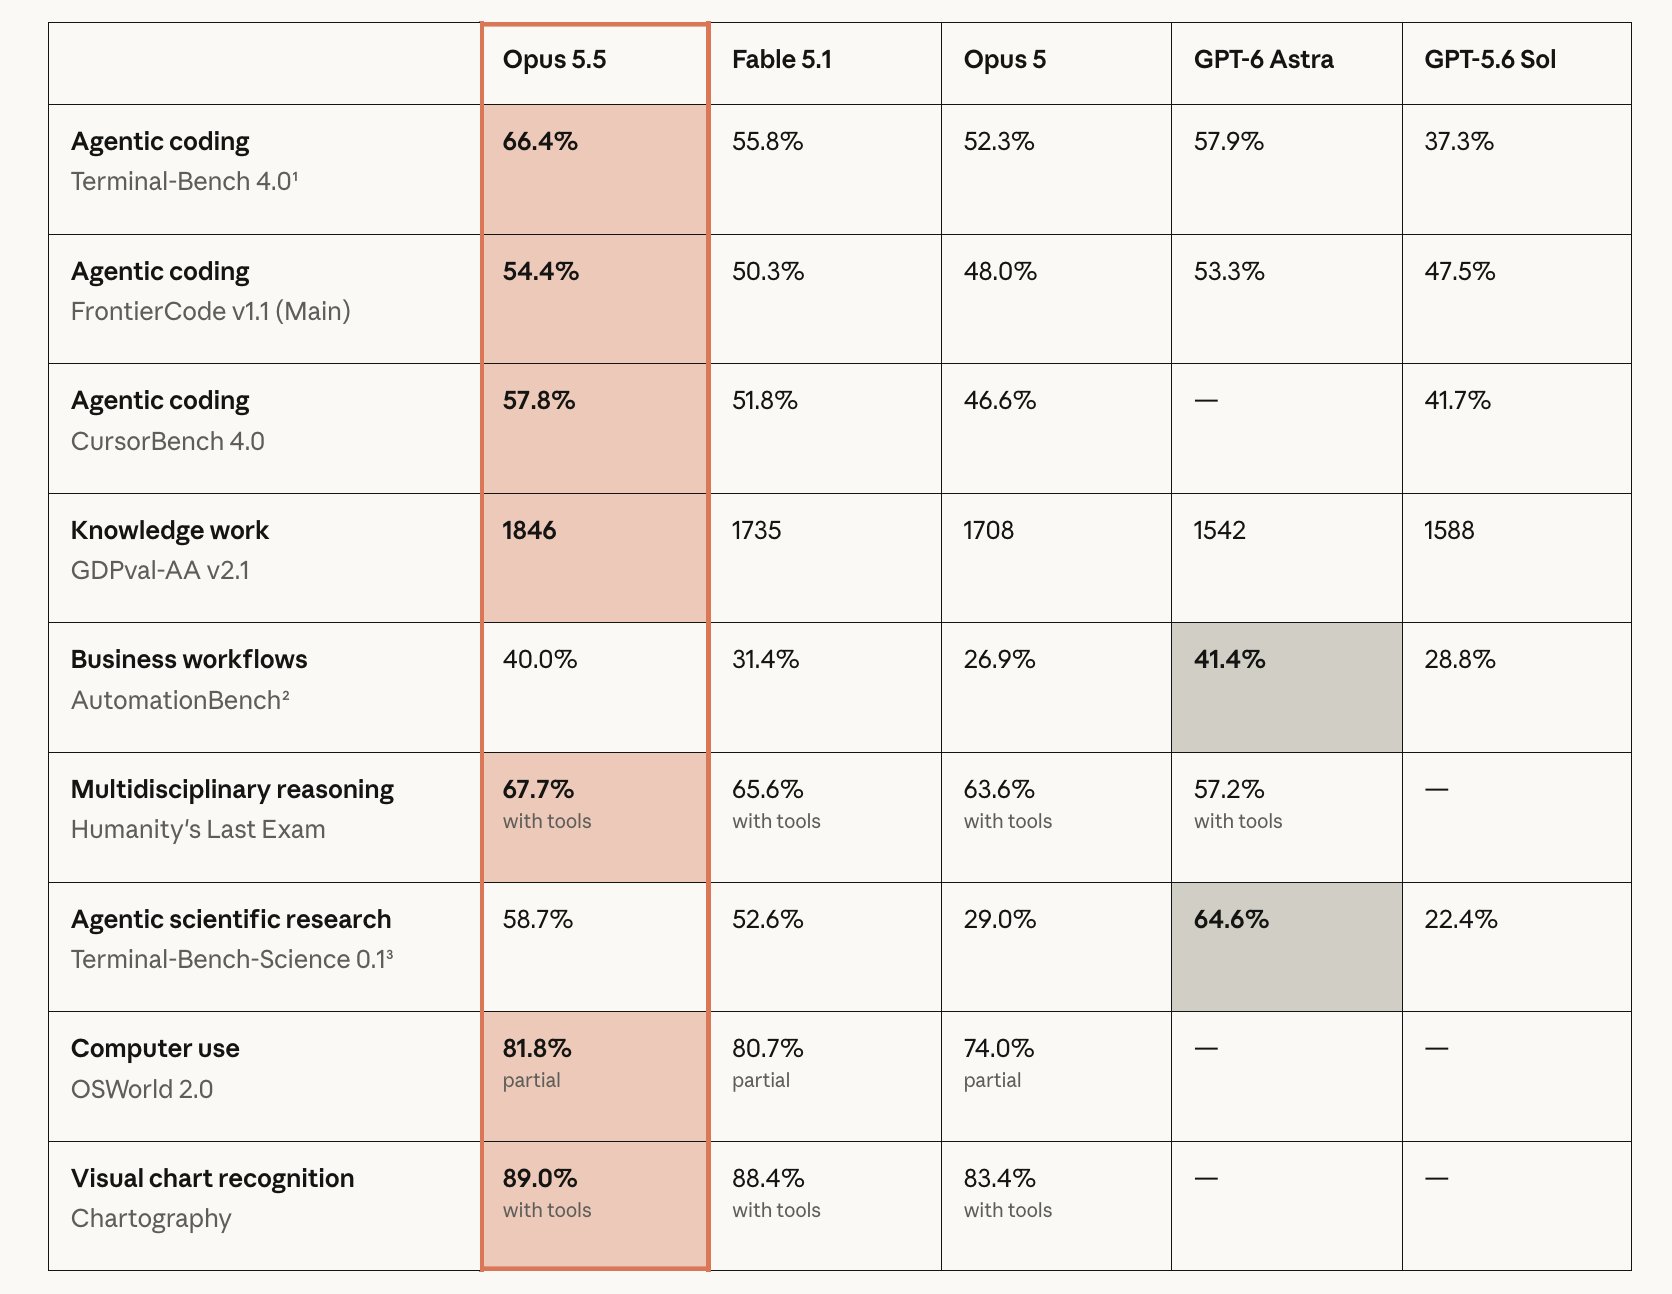
Anthropic khẳng định chạy Opus 5.5 tốn ít hơn 40% so với Opus 5 và cho ra kết quả nhanh hơn khoảng 30%. Mức giá niêm yết ở trên thấp hơn 20% so với giá token của Opus 5 — đây là phép tính của chúng tôi dựa trên hai con số đã công bố, và là một khẳng định riêng biệt với con số 40%. OpenAI nói rằng Sol và Luna đều rẻ hơn 50% so với giá khuyến mãi của GPT-5.6, và "khuyến mãi" là từ của chính OpenAI, nên con số đập vào mắt đó được đo so với một mức giá đã giảm chứ không phải giá niêm yết.
Chi phí cho mỗi tác vụ hoàn thành giảm mạnh hơn nhiều so với chi phí mỗi token. Trên AutomationBench 1.0.6, OpenAI báo cáo GPT-6 Sol ở mức suy luận extra high đạt 33,2% với 0,27 USD mỗi tác vụ, so với Claude Opus 5 ở mức suy luận max đạt 26,9% với chi phí đắt gấp 11,1 lần Sol. Trên DeepSWE 1.1, OpenAI cho biết GPT-6 Luna ở mức suy luận max đạt 66,6% và rẻ hơn 93% tính theo mỗi tác vụ so với Opus 5.
Vậy là giá của một lần thử đã giảm rất mạnh, ở cả hai nhà cung cấp, chỉ trong một ngày. Còn mọi thứ khác trong tuần của bạn thì không đổi.
Phép tính mà ai cũng làm trong tuần này
Giữ nguyên mức chi tiêu rồi chia ra. Với chi phí chạy thấp hơn 40%, cùng một khoản tiền mỗi tháng sẽ mua được khoảng 1,67 lần số lượt chạy Opus 5.5 so với số lượt chạy Opus 5 trước đây. Chuyển nửa phần công việc thường nhật sang Luna thì hệ số nhân này không còn đáng bàn nữa, vì với mức 0,10 USD và 0,50 USD mỗi triệu token, khoản chi cho model không còn là thứ bạn phải cân đối ngân sách nữa.
Giờ hãy làm phép tính thứ hai, phép tính quyết định xem có bao nhiêu phần trong đó thực sự được đưa ra. Lấy số lượt chạy đã hoàn thành mà một kỹ sư của bạn có thể đọc kỹ trong một ngày. Không phải đọc lướt, cũng không phải bấm duyệt khi thấy dấu tick xanh: mà là đọc diff, hiểu agent đã chọn làm gì và chịu trách nhiệm về nó. Dù con số đó là bao nhiêu, nó vẫn y nguyên vào ngày 21/09/2026 và sẽ vẫn thế vào quý sau. Bài toán năng lực review vốn đã cho kết quả tệ ngay cả trước khi có đợt giảm giá, và giảm giá thì chỉ thay đổi phía đầu vào.
Giảm giá không phải là tăng năng lực. Nó chỉ thay đổi mức độ rẻ của việc tạo ra một thứ vẫn cần đến con người.
Dấu hiệu rõ ràng: chi phí không phải là thứ cản bạn
Nếu chi phí model là ràng buộc thực sự, các nhóm hẳn đã chạy cấu hình rẻ nhất có thể hoạt động được. Nhưng họ không làm vậy. Chính số liệu của OpenAI cho thấy một researcher ở mức trung vị trong tổ chức của họ chạy hơn 600 USD inference mỗi ngày theo giá API, còn nhóm percentile 90 chạy tới 7.000 USD mỗi ngày. Bảng benchmark đã công bố của họ cho thấy các nhóm cố tình dùng cấu hình đắt gấp 11,1 lần tính theo mỗi tác vụ để có điểm số thấp hơn, bởi một kết quả bạn tin tưởng thì đáng giá hơn một kết quả bạn phải kiểm tra lại hai lần.
Đó chính là hình hài của ràng buộc thật sự. Người ta sẵn sàng trả cao gấp nhiều lần cho kết quả cần ít sự soi xét của con người hơn trên mỗi đơn vị. Nguồn lực khan hiếm được mua ở đây là sự tập trung, không phải năng lực tính toán, và nó vốn đã được mua với cái giá cắt cổ từ lâu rồi.
Điều đó có nghĩa là một đợt giảm giá tác động không đồng đều. Nó làm phía tạo ra kết quả rẻ hơn, còn phía chấp nhận kết quả thì vẫn giậm chân tại chỗ.
Fan-out hội tụ, và fan-out đổ thẳng lên bảng điều khiển
Đây là sự phân biệt khiến model rẻ trở nên thực sự hữu ích thay vì âm thầm đắt đỏ, và cũng là điều mà hầu hết các nhóm bỏ qua.
Có những dạng song song hội tụ. Ba agent cùng thử một migration trong các worktree tách biệt, một bộ test suite cùng một Agent đóng vai leader chọn ra phương án vượt qua, và chỉ một kết quả đến tay con người. Chi phí gấp ba nhưng khối lượng review không hề tăng. Đây là chỗ một đợt giảm giá mang lại thông lượng thực sự, và cũng là chỗ nền kinh tế mới đáng để bạn thay đổi cách bài binh bố trận.
Có những dạng song song lại phân kỳ. Mười agent nhận mười Task chẳng liên quan gì tới nhau và tạo ra mười diff, mười bản tóm tắt thay đổi và mười quyết định chấp nhận. Chi phí vẫn là mười lượt chạy đó. Nhưng khối lượng review thì gấp mười lần đơn vị tập trung của một người.
| Fan-out hội tụ | Fan-out phân kỳ | |
|---|---|---|
| Ví dụ | 3 lần thử cho cùng một migration, phương án tốt nhất thắng | 10 Task, 10 Assignee, 10 diff |
| Model rẻ hơn mang lại gì | Nhiều lần thử hơn, khả năng có một phương án tốt cao hơn | Nhiều việc đã xong đang chờ hơn |
| Số hạng mục cần review tạo ra | 1 | 10 |
| An toàn để mở rộng chỉ dựa vào giá | Có | Không |
Hãy dùng model rẻ để mở rộng fan-out hội tụ đến mức độ kiên nhẫn của bạn với việc thử lại còn cho phép. Đừng dùng chúng để mở rộng fan-out phân kỳ vượt quá số người review, dù các lượt chạy đã trở nên rẻ đến đâu. Đó là cặp quyết định trung thực, và chính vế thứ hai mới là thứ khiến bạn tốn tiền nếu bị bỏ qua.
Nên thay đổi điều gì thay vì ngân sách
Giới hạn số lượng chạy song song theo số người review, không theo mức chi tiêu. Hãy viết quy tắc đó ra ở nơi Crew có thể thấy: số Task đang mở chờ con người chấp nhận không được vượt quá số reviewer đang trong ca nhân với số lượng review mà một người trong số họ hoàn thành trong một ca. Hai con số của bạn, không phải của chúng tôi. Khi chạm trần, agent dừng nhận Task mới dù ngân sách vẫn cho phép. Một quy tắc định tuyến được viết ra sẽ thắng một sở thích cá nhân, bởi sở thích cá nhân âm thầm thua trước một mức giá rẻ hơn.
Biến "đang chờ con người" thành một trạng thái hữu hình. Một lượt chạy đã xong và một lượt chạy dừng lại để hỏi điều gì đó trông giống hệt nhau từ bên ngoài, và cả hai đều vô hình nếu bản ghi duy nhất chỉ là một cửa sổ terminal. Việc thực thi, điểm nghẽn, kết quả và thảo luận tiếp theo nên quay trở lại dòng thời gian của Task, để hàng đợi là thứ bạn đếm được chứ không phải một cảm giác mơ hồ nổi lên vào chiều thứ Sáu.
Định giá phần review, không phải token. Theo dõi chi phí xuyên các agent theo kiểu báo cáo số USD mỗi lượt chạy là đang trả lời một câu hỏi không còn là ràng buộc nữa. Con số đáng đưa lên dashboard là số phút công của con người cho mỗi thay đổi được chấp nhận. Nếu con số đó tăng lên sau khi bạn chuyển sang model rẻ hơn, thì model rẻ hơn thực ra lại đang đắt hơn.
Dùng một phần khoản tiết kiệm để mua bằng chứng. Một lượt chạy đính kèm kết quả typecheck, kết quả test, bản tóm tắt thay đổi và các giới hạn đã biết sẽ tốn thêm token nhưng tiết kiệm sự tập trung. Với mức 0,20 USD mỗi triệu token đọc từ cache trên Opus 5.5 và mức giảm 90% cho lượt đọc cache trên GPT-6, lượt xác minh thêm gần như miễn phí mà lại mua về đúng nguồn lực vốn thực sự khan hiếm.
Vậy tuần này sẽ đi về đâu
Hai phòng lab cùng giảm giá một lần thử trong cùng một ngày, và một trong hai còn benchmark với một model bị thay thế chỉ vài giờ sau đó. Cả hai đều không tung ra thứ gì có thể đọc diff thay bạn. Quyền sở hữu công việc thuộc về con người là phần không hề rẻ đi 40%, và cũng chính là phần quyết định điều gì được lên production.
Nếu bạn đang chạy nhiều coding agent, động thái hữu ích trong tuần này không phải là nâng con số chạy song song. Mà là tìm ra trần đánh giá thực sự của bạn là bao nhiêu, rồi đặt mức chạy song song cho khớp với nó. Sharkly cho bạn một nơi duy nhất để xem các lượt chạy, các điểm nghẽn, kết quả và hàng đợi công việc đang chờ một người chấp nhận.


