
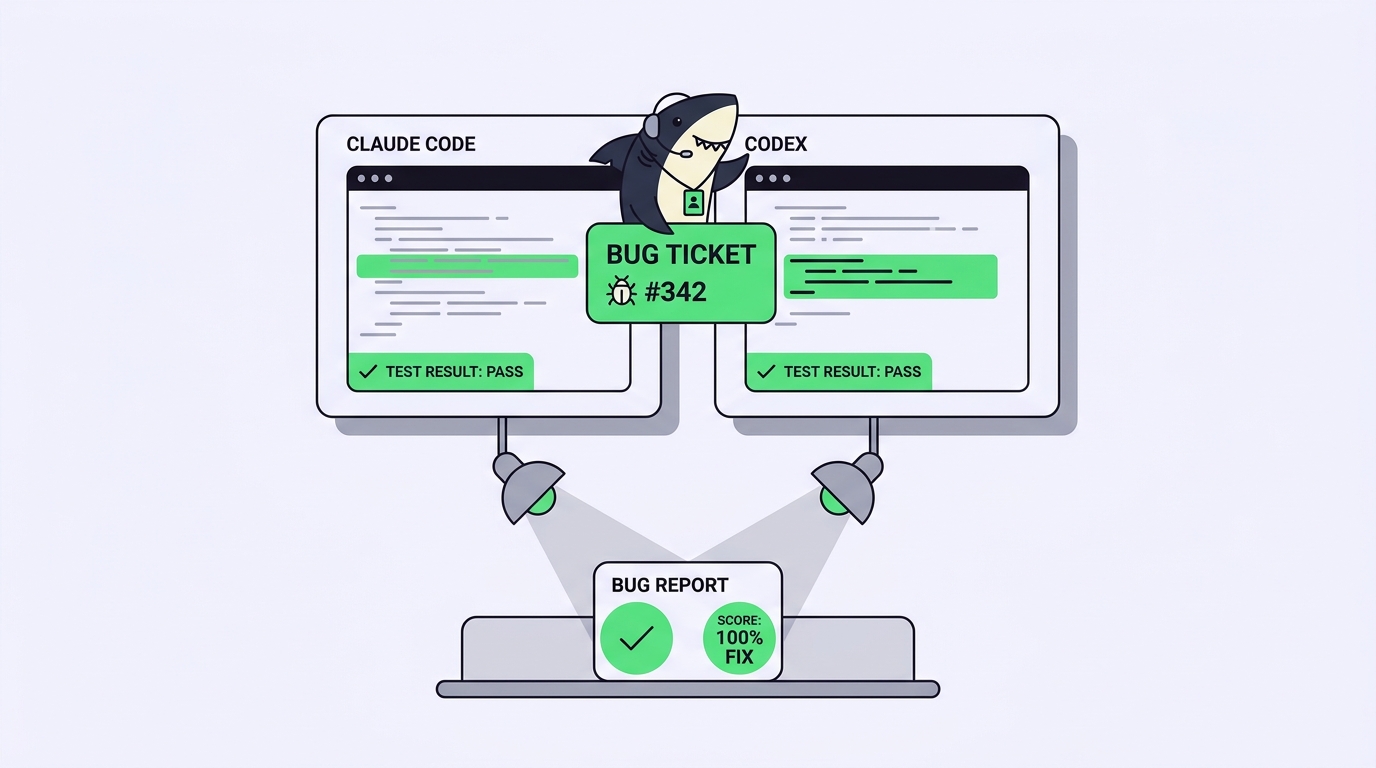
Bạn đang có một bug thật đang mở, và hai agent có thể sửa được nó: Claude Code và Codex. Các tab đầy ắp những ý kiến về việc cái nào thông minh hơn, mà không cái nào cho bạn biết nên chỉ định cái nào vào đúng bug này, trong đúng repo này, ngay hôm nay. Các con số benchmark công khai cũng vậy. Bảng xếp hạng chỉ đo một tập vấn đề mã nguồn mở cố định bằng một harness đã được tinh chỉnh. Bug của bạn là một bài toán riêng tư: quy ước của bạn, cái test chập chờn của bạn, cái module chỉ có một người hiểu.
Cách trung thực để trả lời câu hỏi “Claude Code hay Codex” là chạy cả hai trên cùng một bug, trong cùng điều kiện, rồi xem mỗi bên trả về cái gì. Nghe thì đơn giản nhưng nhanh chóng thành một mớ bòng bong: hai agent cùng sửa một đống file, hai terminal, hai bộ kết quả test, và không có cách nào gọn gàng để đối chiếu chúng cạnh nhau. Thứ bạn muốn so sánh là về các agent. Còn công việc trước mắt lại là giữ cho chúng không đụng nhau.
Chính sự va chạm đó là thứ Sharkly loại bỏ. Sharkly là một nền tảng quản lý và điều khiển Agent tất cả trong một: bạn giao cùng một Task cho hai Agent khác nhau, mỗi Agent chạy trên một Computer đã kết nối trong worktree biệt lập của riêng nó, và mỗi lượt chạy đều trả về diff, kết quả test và phần review về cùng một chỗ. Sharkly không thay thế Claude Code hay Codex, và cũng không phải một harness chấm benchmark. Nó là lớp giúp bạn so kè trực tiếp một cách công bằng mà không cần mở thêm terminal thứ hai. Bài hướng dẫn này sẽ đi qua phương pháp, thang điểm chấm cho một bug duy nhất, và những chỗ mà mỗi agent thường chiếm ưu thế.
Câu trả lời nhanh
Để so sánh Claude Code và Codex một cách trung thực, hãy giao cho cả hai đúng cùng một bug, cùng commit khởi đầu và cùng acceptance test, mỗi bên chạy ở cấu hình tốt nhất của mình. Sau đó chấm điểm những gì trả về: bản fix có pass không, diff có nằm trong phạm vi cần thiết không, và bạn mất bao lâu để review thay đổi đó. Agent thắng một bug thì cũng chỉ mới thắng đúng một bug. Hãy chạy phương pháp này trên vài bug trước khi tin vào kết luận.
Vì sao “cái nào tốt hơn” là câu hỏi sai
Claude Code và Codex đều là những coding agent ưu tiên terminal. Chúng đọc repository của bạn, sửa file, chạy lệnh và báo cáo lại. Chúng khác nhau ở cách bạn cấu hình và cách chúng hành xử dưới áp lực, nhưng không bên nào vượt trội toàn diện trong khối công việc lấp đầy một sprint bình thường.
Một bảng xếp hạng tổng thể duy nhất sẽ che mất đúng phần bạn quan tâm. “Cái nào tốt hơn” gộp tất cả thành một con số không trụ nổi khi chạm vào codebase của bạn. “Cái nào tốt hơn với loại bug này, trong repo của tôi, ở bước review” mới là câu trả lời được, và cũng là phiên bản duy nhất đáng bỏ công. Nếu bạn vẫn đang cân nhắc mỗi agent nên chạy model nào, thì ghép model với vai trò của agent là câu hỏi đầu tiên hay hơn bất kỳ bảng xếp hạng nào.
Chạy cả hai trên cùng một bug: một phương pháp đáng tin
Một so sánh công bằng phải giữ mọi thứ cố định, chỉ thay đổi agent. Bốn nguyên tắc giúp bạn làm được điều đó.
- Chọn một bug thật, không phải một prompt đồ chơi. Hãy chọn một lỗi gọn gàng trong backlog, có acceptance test chạy được và diff đọc xong trong vài phút. Viết nó ra đúng kiểu tracker của bạn: một task như
SH-312: fix the timezone drift in the invoice export. “Build a todo app” không nói lên điều gì về code của bạn. - Cho cả hai cùng một đầu vào y hệt. Cùng mô tả task, cùng commit khởi đầu, cùng tiêu chí nghiệm thu. Nếu Claude Code nhận được prompt phong phú hơn Codex, thì bạn đang đo prompt của mình chứ không phải đo agent.
- Cho mỗi bên chạy ở trạng thái tốt nhất. Cấp cho Claude Code file
CLAUDE.md, cấp cho CodexAGENTS.mdvà config của nó, và cho mỗi bên quyền hạn cùng model mà tài liệu riêng của nó khuyến nghị. So sánh một agent được cấu hình kỹ với một agent trần trụi chỉ đo xem bạn chịu khó cấu hình bên nào hơn. - Cô lập hai lượt chạy. Mỗi agent cần bản sao làm việc riêng. Hai agent trong cùng một checkout sẽ ghi đè lên nhau, và bạn sẽ tốn cả buổi chiều gỡ rối một mớ merge thay vì đọc hai bản thử sạch sẽ. Đây chính là việc mà worktree biệt lập sinh ra để giải quyết.
Chạy hai bản thử, rồi vứt bỏ nhánh thua. Bạn giữ lại bản fix mình tin tưởng cùng bằng chứng vì sao lại chọn nó.
Thang điểm chấm cho một bản fix bug duy nhất
“Nó có pass không” chỉ là một bit thông tin. Một bản fix thật sự được quyết định bởi nhiều thứ hơn thế, và việc viết thang điểm ra trước khi xem kết quả sẽ giữ cho so sánh được khách quan.
| Bạn chấm cái gì | Câu hỏi nó trả lời | Vì sao quan trọng |
|---|---|---|
| Tính đúng đắn | Acceptance test có pass không, và có làm hỏng thứ gì khác không? | Mức sàn. Một agent in ra chữ “done” thì chưa chứng minh được gì. |
| Kỷ luật phạm vi | Diff có chỉ chạm vào đúng những gì bug cần không? | Một bản fix viết lại bốn file không liên quan sẽ tốn công review hơn cả giá trị nó mang lại. |
| Chất lượng test | Agent có thêm hoặc cập nhật test đủ để bắt được regression không? | Bản fix không có test là bản fix bạn sẽ phải làm lại. |
| Thời gian review | Bạn mất bao lâu để tin tưởng vào thay đổi đó? | Thường là nút thắt thật sự, và dễ bị bỏ qua cho đến khi nó ngốn mất cả buổi chiều của bạn. |
| Sự trung thực | Agent có nêu rõ giới hạn và giả định của chính nó không? | Lượt chạy đáng tin là lượt chạy nói cho bạn biết nó đã không kiểm chứng điều gì. |
Chấm cả hai bản thử theo đúng năm tiêu chí đó, trên cùng một bug, thì người thắng sẽ không còn là chuyện sở thích. Thời gian review xứng đáng được nhân trọng số cao hơn: hai agent có thể đều hoàn thành trong hai mươi phút mà vẫn tốn một giờ mỗi bên để kiểm tra. Chính giờ đó thường là giới hạn thật sự cho lượng công việc agent mà một team có thể hấp thụ.
Mỗi bên thường thắng ở đâu
Ở đây không có con số nào bịa ra, chỉ là những gì bạn nên để mắt tới. Claude Code dựa vào bộ nhớ dự án CLAUDE.md và có xu hướng bám sát quy ước của repository khi thay đổi nhiều file, điều này thể hiện rõ ở các đợt refactor trải dài qua nhiều module. Codex thoải mái trong môi trường sandbox, điều khiển bằng config, và thường cấu trúc code mới cùng test của nó rất gọn gàng, điều này thể hiện rõ ở các bản fix gọn trong phạm vi hẹp. Cả hai đều đi lạc nhiều hơn khi repo phình to, và cả hai đều có thể tự tin đưa cho bạn một thay đổi không pass. Hãy chạy thử trên bug của chính bạn trước khi coi bất cứ điều gì ở đây là chốt hạ.
Đây là phần trung thực mà hầu hết các so sánh đều bỏ qua. Nếu bạn chỉ dùng một agent và sống trong một terminal duy nhất, bạn không cần nền tảng nào để làm việc này. Một phiên Claude Code được tinh chỉnh kỹ trong một worktree, hoặc một lượt chạy Codex, là đủ, và bạn có thể tự nhìn diff bằng mắt. Phương trình thay đổi ngay khi bạn so sánh hai agent, trên nhiều hơn một bug, và bạn muốn kết quả ở dạng người khác cũng đọc được.
Chạy màn đối đầu trực tiếp trong Sharkly
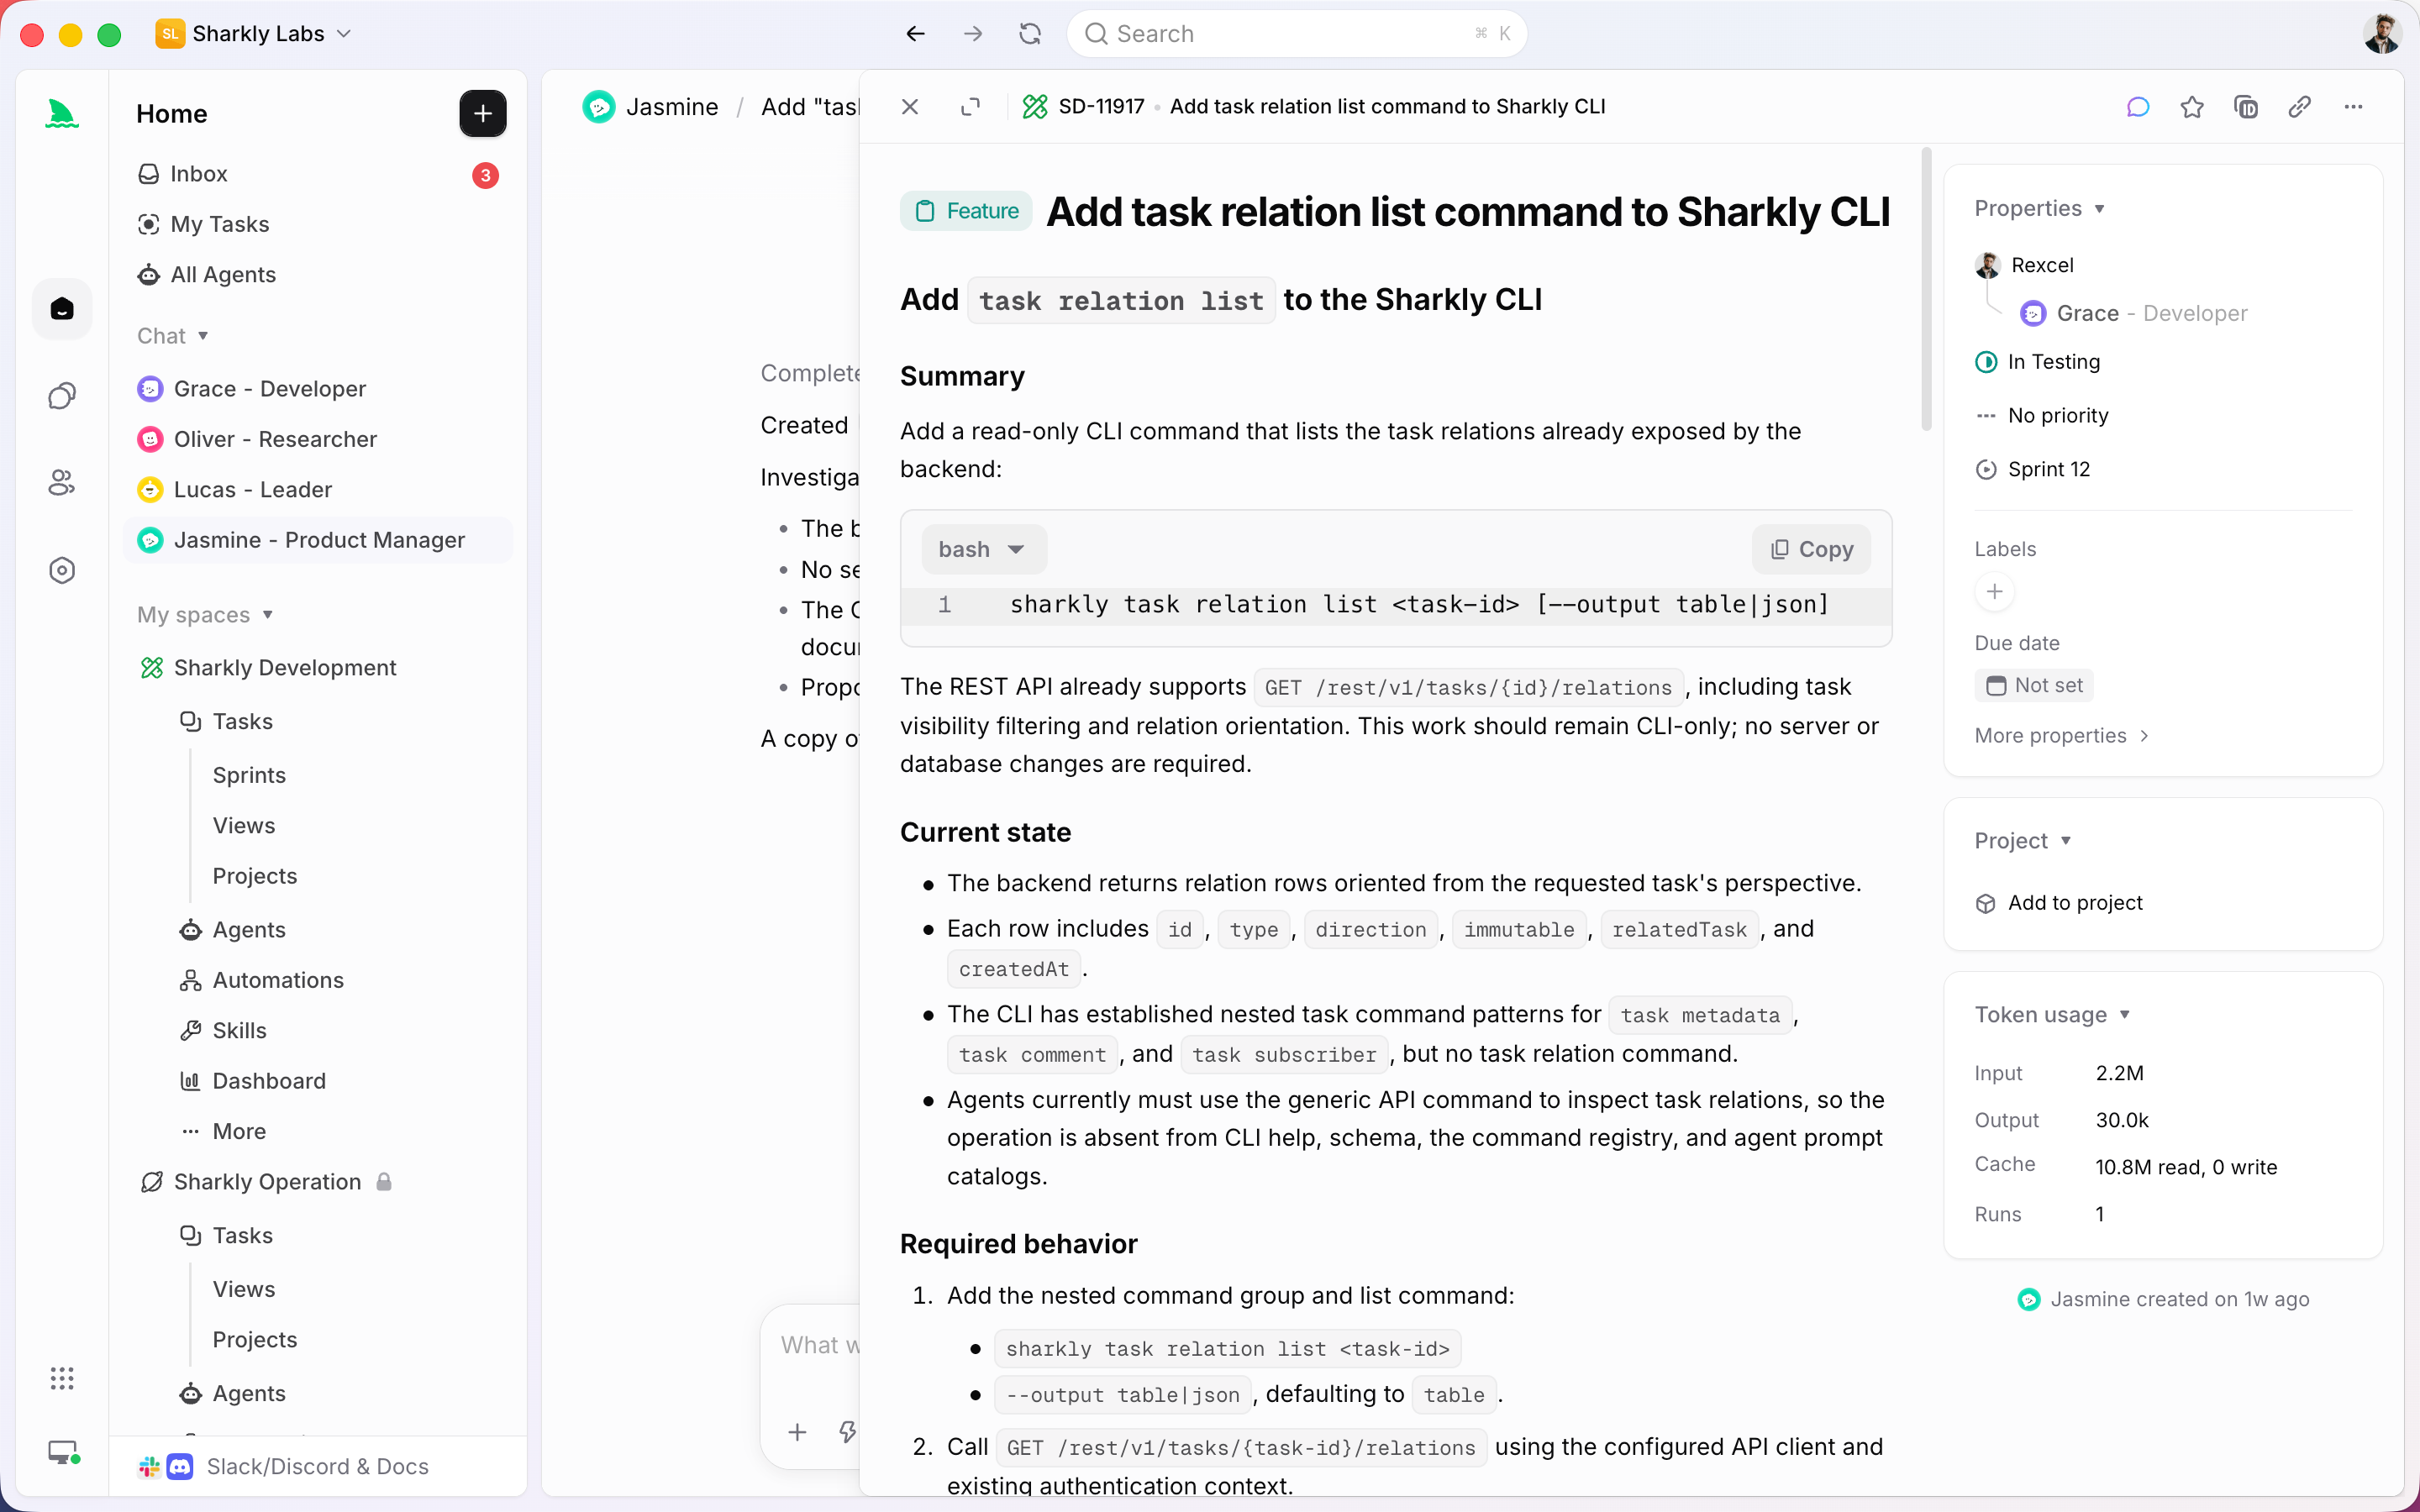
Đây là chỗ Sharkly khẳng định vị trí của mình. Bạn tạo một Task cho bug đó, rồi giao nó cho cả một Claude Code Agent lẫn một Codex Agent. Mỗi Agent chạy trên một Computer đã kết nối trong worktree riêng, nên hai bản thử không bao giờ chạm vào cùng một file. Quá trình thực thi, các điểm tắc, kết quả và bản tóm tắt thay đổi đều trở về dòng thời gian của Task, và bạn đối chiếu hai diff cùng hai lượt chạy test với nhau trong một màn hình duy nhất, thay vì phải nhớ terminal nào chứa cái gì.
Sự phân chia công việc vẫn rõ ràng. Agent nghiên cứu, thực thi, kiểm thử và báo cáo. Con người định hướng và nghiệm thu kết quả. Tự động hóa dừng lại ở đúng chỗ cần đến phán đoán của bạn, và Sharkly giữ cho bối cảnh, tiến độ, các điểm tắc, kết quả và bước review của con người luôn hiển thị rõ từ lúc đưa ra yêu cầu đến lúc release. Bạn không giao quyết định cho một công cụ; bạn chỉ đang được bày sẵn cả hai bản thử để việc chọn lựa chỉ tốn vài phút. Khi bạn muốn giữ cả hai agent cho công việc hằng ngày thay vì chỉ thử một lần, thì chạy Claude Code và Codex song song trên một codebase cũng chính là quy trình đó, được biến thành thói quen.
Nên chọn cái nào, theo quy mô team
Lựa chọn đúng phụ thuộc vào việc ai là người chọn và kết quả so sánh phải trụ được đến đâu.
| Quy mô team | Ưu tiên nặng nhất | Nên chọn gì |
|---|---|---|
| Lập trình viên độc lập | Thời gian review và việc chạy trên máy của chính mình | Agent nào bạn review nhanh hơn; bạn là người đọc duy nhất |
| Team nhỏ | Chạy song song và khả năng nhìn thấy chung | Cả hai, giao qua cùng một Task để mọi người thấy cùng một bằng chứng |
| Team platform | Khả năng tích hợp và tính trung lập với nhà cung cấp | Giữ cả hai; quy trình phải trụ được bất kể agent nào dẫn đầu trong quý tới |
Hàng cuối đó chính là lý do thật sự để bạn chạy so sánh thay vì chọn một ứng viên yêu thích rồi ra sức bảo vệ nó. Agent tốt nhất quý này có thể không còn tốt nhất quý sau, và việc đập đi xây lại quy trình mỗi khi ngôi đầu đổi chủ cũng là một thứ thuế riêng. So sánh trên chính bug của bạn, trong một quy trình chạy được bất kỳ agent nào, sẽ giúp bạn thoải mái đổi bên khi câu trả lời thay đổi.
Nếu bạn muốn tiếp tục dùng nhiều coding agent thay vì gắn chặt với một hệ sinh thái, thì đó chính là bài toán mà Sharkly được thiết kế để giải quyết. Tải Sharkly, kết nối một Computer, và giao cùng một bug thật cho cả hai agent. Kết luận bạn nhận lại là về chính codebase của bạn — thứ duy nhất dự báo được tuần làm việc của bạn.
Câu hỏi thường gặp
Claude Code hay Codex sửa bug tốt hơn? Không bên nào thắng một cách chung chung. Trên cùng một bug, ở cấu hình tốt nhất của mỗi bên, thường một bên nhỉnh hơn bên kia, và bên nào nhỉnh hơn lại thay đổi tùy loại bug và quy mô repo. Hãy chạy cả hai trên một lỗi thật trong backlog của bạn rồi chấm điểm tính đúng đắn, phạm vi, test và thời gian review.
Tôi có thể chạy Claude Code và Codex trên cùng một bug cùng lúc không? Có, miễn là mỗi bên có bản sao làm việc riêng. Hai agent trong cùng một checkout sẽ ghi đè lên nhau. Hãy cấp cho mỗi bên một worktree biệt lập, hoặc giao Task cho cả hai trong Sharkly và để mỗi Agent chạy trên Computer riêng.
Điểm benchmark có cho tôi biết nên dùng agent nào không? Chúng cho bạn biết agent nào đáng để thử, chứ không cho biết một agent sẽ hành xử thế nào trong repo của bạn. Một dataset công khai không bao giờ chứa được các thư viện nội bộ, cấu hình lint hay module chưa từng được test của bạn. Hãy coi bảng xếp hạng như một bộ lọc, rồi chạy phép so sánh thật sự quan trọng trên chính code của bạn.
Sharkly có thay thế Claude Code hay Codex không? Không. Sharkly là lớp giao việc, quản lý bối cảnh và review bao quanh những coding agent mà team bạn đã dùng. Các agent thực thi; Sharkly quản lý Task, giữ cho các lượt chạy luôn hiển thị rõ, và để việc nghiệm thu lại cho con người.
Tôi nên so sánh bao nhiêu bug trước khi quyết định? Một bug chỉ cho bạn biết về đúng một bug. Hãy chạy phương pháp này trên một vài loại lỗi khác nhau trước khi tin vào một quy luật nào đó, và giữ nguyên thang điểm mỗi lần để kết quả có thể cộng dồn lại với nhau.


