
Tóm tắt nhanh: Một nhóm tại MIT CSAIL đã cho một mô hình frontier đọc và chỉnh sửa trọng số của Qwen3.5-0.8B bên trong một sandbox Python, với ngân sách forward pass cứng và nhật ký đầy đủ cho từng bước. Các tác giả báo cáo MATH-500 tăng từ 7,9% lên 48,1%. Bạn cũng có thể để một coding agent chỉnh sửa trọng số mô hình theo cách tương tự: năm task trên một board, ngân sách ghi rõ trong từng task, một agent thứ hai phụ trách đánh giá, và một người phê duyệt file đã chỉnh sửa.
Ngày 2 tháng 11 năm 2026, Rikiya Takehi, Jayden Teoh, Alex Zhang và Omar Khattab đã công bố Sparks of Weight-Space Programming. Mô hình trong nghiên cứu của họ, GPT-6 Astra, đã mở các tensor trọng số, viết numpy và PyTorch để thao tác trên chúng, đưa ra giả thuyết, và thay đổi 131.072 con số trong một mô hình 0,8B tham số.
Đọc phần thiết lập, bạn sẽ thấy quen thuộc: một sandbox, một ngân sách công cụ, nhật ký ghi lại mọi prompt và mọi cell đã thực thi. Đó chính là một coding agent có harness, và harness là phần mà team bạn có thể sao chép ngay hôm nay.
Nhóm MIT đã làm gì, nhìn qua các con số
Lập trình trong không gian trọng số (weight-space programming) nghĩa là một LLM đọc các tham số của mạng như dữ liệu và chỉnh sửa chúng trực tiếp, không cần gradient descent và không cần chạy huấn luyện. Bài viết của MIT báo cáo kết quả này trên các mô hình nhỏ, dưới những giới hạn công cụ nghiêm ngặt, với mọi lượt đều được ghi log.
Kết quả nổi bật nhất là lần chỉnh sửa Qwen3.5-0.8B:
| Chỉ số (theo số liệu của tác giả) | Mô hình gốc | Mô hình đã chỉnh sửa |
|---|---|---|
| MATH-500 | 7,9% | 48,1% |
| GSM8K | 13,8% | 67,1% |
| IFEval | 21,0% | 62,3% |
| Số lần chạy chạm giới hạn 32.768 token | 93,0% | 33,1% |
Astra truy vết thói quen lặp đi lặp lại cho đến khi cạn token của mô hình về một hướng được ghi bởi các MLP ở lớp 15 và 19, rồi trừ nó khỏi 64 cột đầu ra ở mỗi lớp: 131.072 trọng số, tương đương 0,016% mô hình. Checkpoint được công bố theo giấy phép Apache-2.0, và model card của nó cho biết chỉ có hai tensor khác biệt so với mô hình gốc: các ma trận down_proj.weight ở hai lớp đó.
Vì sao harness quyết định kết quả
Hai phát hiện trong bài viết quan trọng hơn cả kết quả nổi bật đối với một team.
Ngân sách thay đổi kết quả. Mỗi forward pass lấy trung bình trên một batch 64 chuỗi. Với 10 pass, MATH-500 đạt 12,3%. Với 25 pass, đạt 14,1%. Với 50 pass, đạt 48,1%. Cùng một mô hình, cùng một task, nhưng trần số lần agent có thể thử nghiệm một ý tưởng lại khác nhau.
Công cụ thay đổi kết quả. Khi chỉ được cung cấp trọng số của hai biến thể Gemma 3 270M, Astra không thể phân biệt đâu là bản hay nịnh hót (sycophantic) trong cả bốn lần thử. Khi có một công cụ trả về trọng số attention trên tối đa 16 đoạn văn bản do chính nó viết, nó chỉ đúng bản sycophant trong cả ba cặp.
Vậy là có hai đòn bẩy: agent được phép tiêu tốn bao nhiêu và được phép nhìn vào cái gì. Cả hai đều phải được viết rõ trước khi bắt đầu chạy.
Những giới hạn cũng rõ ràng không kém. Astra không thể cải thiện Gemma 3 270M trên MATH-500: từ mức gốc 6,8%, bản chỉnh sửa tốt nhất chỉ đạt 7,7%. Các tác giả lý giải đây là việc gỡ bỏ một rào cản, chứ không phải bổ sung một năng lực mà mô hình còn thiếu. Họ gọi các phát hiện này là còn sơ khai, và một số chỉ đến từ một lần chạy duy nhất. Hãy lên kế hoạch cho thí nghiệm của bạn như một phép thử, chứ không phải một bản vá.
Cách để một coding agent chỉnh sửa trọng số mô hình một cách an toàn
Một thí nghiệm weight-space an toàn có năm đặc điểm:
- Trọng số gốc ở chế độ chỉ đọc đối với mọi agent.
- Ngân sách forward pass là một con số nằm trong task, được sandbox thực thi.
- Tập eval mà agent chỉnh sửa nhìn thấy tách biệt với tập regression mà agent review chạy.
- Log của mỗi lần chạy luôn được gắn với đúng giai đoạn mà nó thuộc về.
- Có một người phê duyệt file đã chỉnh sửa trước khi bất cứ thứ gì tải nó ra ngoài sandbox.
Sharkly không đếm forward pass hay kiểm tra tensor. Script sandbox của bạn làm việc đó, còn runtime của bạn (Claude Code, Codex, hoặc một agent khác bạn đang dùng) đảm nhiệm việc đọc và chỉnh sửa. Sharkly nắm giữ công việc: ai phụ trách từng giai đoạn, được phép tiêu tốn bao nhiêu, kết quả trả về là gì, và ai đã phê duyệt. Kho log của chính nhóm MIT có thư mục harness/ chứa cấu hình Codex và script sandbox — một tài liệu tham khảo hữu ích cho phần sandbox.
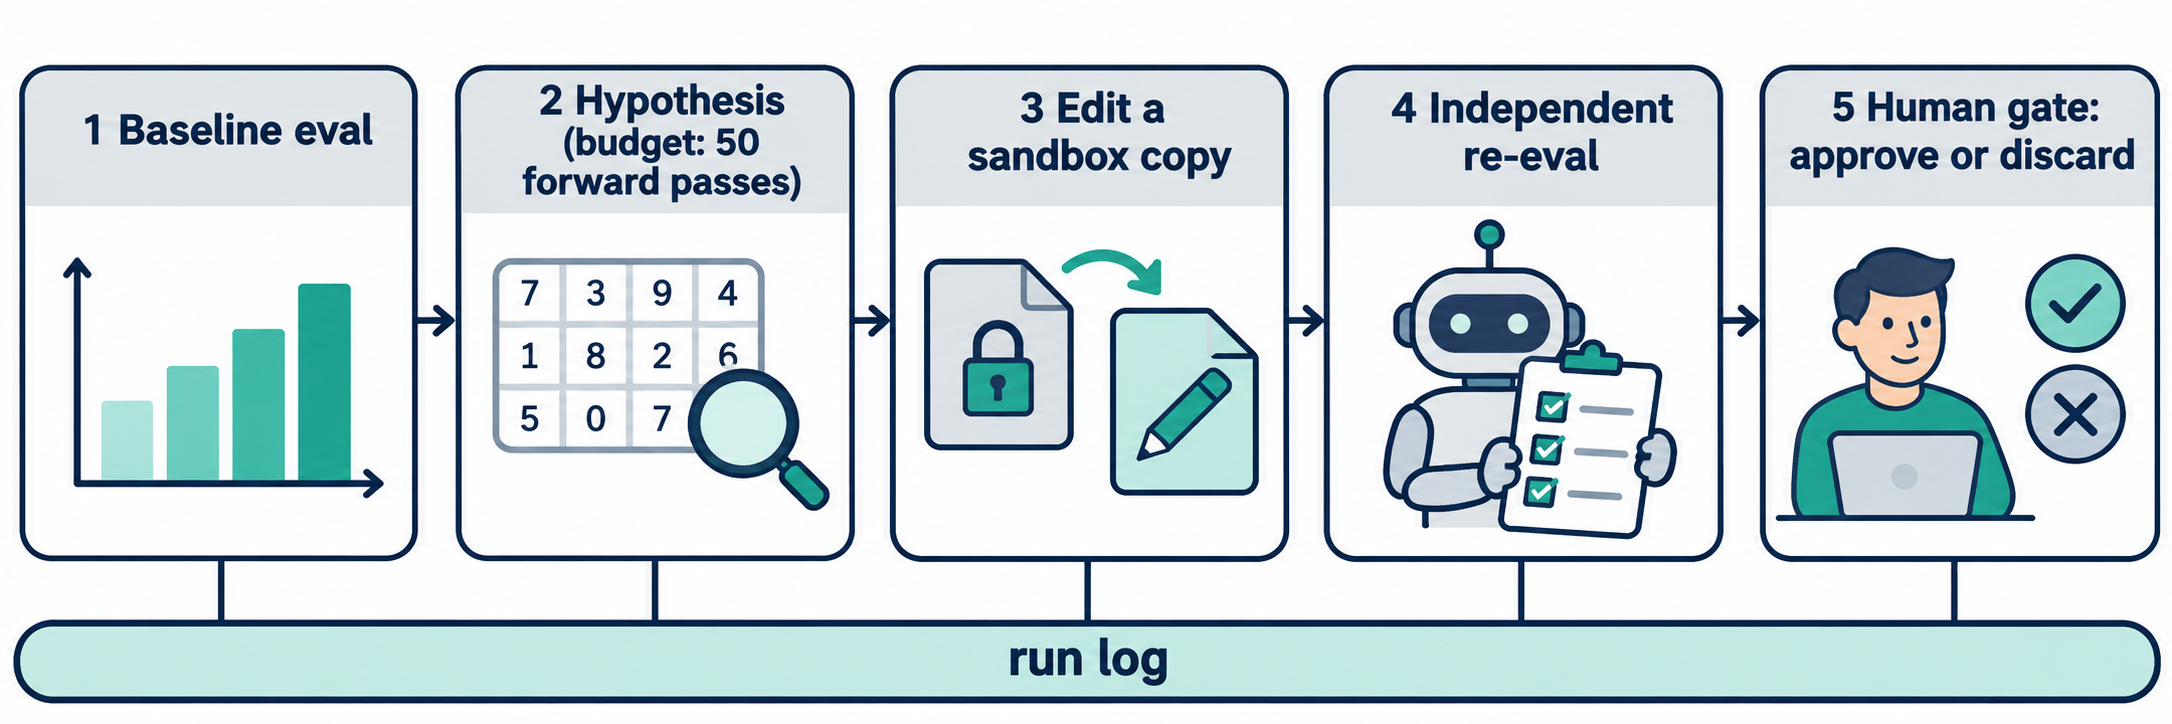
Giai đoạn 1: Đánh giá baseline trên mô hình chưa chỉnh sửa
Task đầu tiên chạy eval của bạn trên checkpoint gốc và ghi lại điểm số cùng những chỗ mô hình thất bại. Với Qwen3.5-0.8B, 93,0% số lần chạy chạm giới hạn token. Task đặt giả thuyết cần đến mô tả thất bại đó.
Giai đoạn 2: Đọc trọng số và viết giả thuyết
Đây là task có gắn ngân sách. Hãy đặt con số ngay trong nội dung, ở dạng mà agent không thể hiểu sai:
## Stage 2: Hypothesis from weights

Model: ./models/qwen3.5-0.8b-base (READ-ONLY, mounted ro)
Budget: 50 forward passes, batch 64. The sandbox stops at 50.
Tools: numpy, torch (CPU), forward() wrapper. No attention tool.
Inputs: Stage 1 failure notes (task COIN-xxx), GSM8K/MATH practice split only.
Output: one-page hypothesis naming layers, tensors and the direction to change,
plus the passes used. Do not write any weights in this stage.
Ngân sách ghi trong task chỉ là một lời hứa; ngân sách trong wrapper của sandbox mới là sự bảo đảm. Hãy viết cả hai, và cho wrapper in ra số pass đã dùng để con số đó xuất hiện trong log chạy.
Giai đoạn 3: Thực hiện chỉnh sửa trên bản sao trong sandbox
Agent chỉnh sửa thay đổi trên một bản sao của checkpoint và báo cáo diff. Nó không bao giờ có quyền ghi vào bản gốc. Trên Sharkly, mỗi lần chạy task có thư mục riêng biệt, và công việc với repository có thể dùng worktree riêng cho từng lần chạy, nên giai đoạn 3 không thể đụng vào thứ mà giai đoạn 1 đã đo.
Giai đoạn 4: Đánh giá lại độc lập bởi một agent review
Hãy giao giai đoạn này cho một agent khác với agent đã thực hiện chỉnh sửa. Nó chạy lại eval của giai đoạn 1 và thêm một tập regression mà agent chỉnh sửa chưa từng thấy. Nếu bạn dùng một Crew, leader có thể giao bản chỉnh sửa cho một thành viên và việc đánh giá lại cho một thành viên khác. Cách làm này khớp với mô hình Crew dùng nhiều mô hình với reviewer riêng: agent viết ra thay đổi không phải là agent chấm điểm nó.
Agent chỉnh sửa tối ưu dựa trên những gì nó nhìn thấy, nên một mức cải thiện chỉ xuất hiện trên đúng những bài toán đó thì chẳng chứng minh được nhiều.
Giai đoạn 5: Cổng phê duyệt của con người trên diff
Task cuối cùng đến tay một người kèm ba tệp đính kèm: danh sách tensor đã thay đổi, bảng so sánh trước và sau, và kết quả regression của reviewer. Không có gì được phép tải checkpoint đã chỉnh sửa ra ngoài sandbox cho đến khi task này được chuyển tiếp.
Đoạn script ngắn sau tạo ra tệp đính kèm đầu tiên. Nó so sánh hai checkpoint safetensors và liệt kê mọi tensor đã thay đổi:
from safetensors import safe_open
import torch

BASE = "models/qwen3.5-0.8b-base/model.safetensors"
EDIT = "sandbox/qwen3.5-0.8b-edit/model.safetensors"

changed, total = [], 0
with safe_open(BASE, "pt") as a, safe_open(EDIT, "pt") as b:
    assert set(a.keys()) == set(b.keys()), "tensor names differ"
    for name in a.keys():
        x, y = a.get_tensor(name), b.get_tensor(name)
        total += x.numel()
        n = (x != y).sum().item()
        if n:
            changed.append((name, n, (x - y).abs().max().item()))

for name, n, dmax in changed:
    print(f"{name}: {n:,} weights changed, max |delta| {dmax:.4g}")
print(f"{sum(c[1] for c in changed):,} of {total:,} weights changed")
Với checkpoint đã công bố, model card cho biết bạn sẽ thấy đúng hai tensor down_proj.weight. Nếu bản chỉnh sửa của bạn đụng đến những tensor mà giả thuyết không hề nhắc tới, đó chính là lý do để loại bỏ nó.
Chạy board trên Sharkly
Đây là board cho một thí nghiệm. Mỗi dòng là một task với người phụ trách, trạng thái và lịch sử chạy riêng.
| Task | Người phụ trách | Ngân sách hoặc cổng | Hoàn thành khi |
|---|---|---|---|
| 1. Đánh giá baseline | Agent đánh giá | Chỉ dùng tập eval | Điểm số và ghi chú thất bại đã được đăng |
| 2. Giả thuyết từ trọng số | Agent chỉnh sửa | 50 forward pass | Giả thuyết đã đăng, số pass đã dùng được ghi log |
| 3. Chỉnh sửa trong sandbox | Agent chỉnh sửa | Chỉ bản sao, bản gốc chỉ đọc | Diff và file đã chỉnh sửa nằm trong sandbox |
| 4. Đánh giá lại và regression | Agent review | Tập regression giữ riêng (held-out) | Bảng trước/sau đã được đăng |
| 5. Phê duyệt hoặc loại bỏ | Một người | Cổng phê duyệt của con người | Quyết định được ghi lại trên task |
Hãy liên kết các giai đoạn bằng quan hệ blocks để board hiển thị được chuỗi phụ thuộc. Quan hệ task của Sharkly nói rõ về phạm vi của nó: quan hệ thể hiện sự phụ thuộc và tiến độ trên thẻ, nhưng không tự động di chuyển task hay khởi chạy một lượt chạy. Hãy giữ mỗi giai đoạn ở Backlog cho đến khi giai đoạn trước hoàn tất. Một task được giao cho agent sẽ không bắt đầu chạy khi còn nằm ở Backlog, nên việc chuyển nó ra khỏi Backlog chính là cú kích hoạt.
Khi giai đoạn 4 kết thúc, agent có thể để task ở trạng thái chờ người review, và người đó sẽ thấy nó trong Inbox. Log thực thi ghi lại thời điểm bắt đầu, kết thúc, các lệnh gọi công cụ và cú kích hoạt của mỗi lần chạy: đó là dấu vết kiểm toán của bạn, được lưu ngay tại giai đoạn mà nó thuộc về. Để tìm hiểu thêm về việc nên dừng agent ở đâu, xem approval gate cho coding agent.
Những giới hạn thực tế trước khi bắt đầu
- Bắt đầu từ cái nhỏ. Nghiên cứu dùng các mô hình 0,8B và 270M với truy cập tensor trên CPU. Hãy chọn một mô hình bạn có thể đánh giá trong vài phút.
- Đừng kỳ vọng cải thiện những kỹ năng còn thiếu. Kết quả với Gemma cho thấy một chỉnh sửa có thể gỡ rào cản cho mô hình, chứ không dạy nó.
- Coi một lần chạy chỉ là giai thoại. Hãy lặp lại thí nghiệm với một agent mới trước khi tin vào bản chỉnh sửa.
Kết luận
Bài học có thể tái sử dụng từ bài viết của MIT chính là harness: ngân sách được viết rõ, công cụ bị giới hạn, log đầy đủ, và kết quả để người khác kiểm chứng được. Đó đều là những cơ chế kiểm soát mà bạn vốn đã muốn có quanh một coding agent chỉnh sửa code.
Để thử, hãy tạo năm task trong một Sharkly Space, giao giai đoạn 1 đến 4 cho các agent trên Computer đã kết nối, và giữ giai đoạn 5 cho chính bạn. Sharkly miễn phí để bắt đầu tại sharkly.ai.
Câu hỏi thường gặp
Coding agent có thể chỉnh sửa trọng số mô hình không?
Theo nghiên cứu của MIT CSAIL thì có. GPT-6 Astra đọc các tensor của Qwen3.5-0.8B trong một sandbox Python và thay đổi 131.072 trọng số. Các tác giả báo cáo MATH-500 tăng từ 7,9% lên 48,1%. Công trình còn sơ khai, chỉ trên các mô hình nhỏ, và một số kết quả chỉ đến từ một lần chạy duy nhất.
Weight-space programming là gì?
Đó là việc một LLM đọc các tham số của mạng như dữ liệu và chỉnh sửa chúng trực tiếp, không cần huấn luyện. Nó phân tích tensor bằng code, đưa ra giả thuyết, thay đổi trọng số, rồi đo hiệu quả bằng một số lượng forward pass hạn chế.
Vì sao ngân sách forward pass lại quan trọng?
Trong thí nghiệm ablation với Qwen của các tác giả, 10 pass đạt 12,3% trên MATH-500, 25 pass đạt 14,1%, và 50 pass đạt 48,1%. Ngân sách quy định agent có thể thử bao nhiêu ý tưởng. Hãy ghi nó vào task và thực thi nó trong sandbox.
Chỉnh sửa trọng số có thể bổ sung năng lực mới cho mô hình không?
Nghiên cứu cho thấy là không. Bản chỉnh sửa tốt nhất của Astra chỉ đưa Gemma 3 270M từ 6,8% lên 7,7% trên MATH-500. Các tác giả kết luận rằng việc chỉnh sửa đã gỡ bỏ một rào cản ở Qwen chứ không bổ sung thêm năng lực.
Làm sao để trọng số đã chỉnh sửa không lọt vào production?
Hãy mount bản gốc ở chế độ chỉ đọc, chỉnh sửa trên một bản sao, chạy đánh giá lại độc lập, và yêu cầu một người phê duyệt diff tensor trước khi bất cứ thứ gì tải file ra ngoài sandbox.


