
OpenAI đã phát hành GPT-6 Luna vào ngày 22 tháng 9 với mức giá 0,10 USD mỗi triệu token đầu vào và 0,50 USD mỗi triệu token đầu ra, với API id là gpt-6-luna và cửa sổ ngữ cảnh 1M. Với mức giá đó, câu hỏi đáng bàn không còn là liệu mô hình có đủ tốt trên lý thuyết hay không, mà là bạn sẵn sàng giao cho nó những làn việc nào trên bảng của mình, và làm sao để làn rẻ lẫn làn đắt cùng chạy trên một Computer mà không ai mất dấu làn nào đã tạo ra kết quả nào.
Đây trước hết là một bài toán cấu hình, rồi mới là bài toán mô hình. Một nhóm gán Luna ở mọi chỗ sẽ tiết kiệm được tiền rồi đốt lại đúng chừng đó vào khâu review. Một nhóm không bao giờ gán nó thì tiếp tục trả giá cao để một Agent đi đổi tên file test. Hướng dẫn này đi theo con đường hữu ích ngắn nhất: đặt gpt-6-luna lên một Computer, giữ nó trong làn riêng, giao một Task thật, và đọc kết quả ở nơi cả nhóm đều nhìn thấy.
Tóm tắt nhanh
Gán gpt-6-luna làm mô hình mặc định của một Runtime trên một Computer đã kết nối, xác nhận Runtime đó hiển thị trạng thái Available trong Sharkly, cấp cho nó một Agent riêng thay vì dùng lại Agent đắt tiền, tăng timeout mỗi Task trước khi tin tưởng một lượt chạy dài, và chỉ để Luna đảm nhận những việc mà con người có thể kiểm tra kết quả trong chưa đầy một phút. Sharkly sẽ không hiển thị tên mô hình. Nó sẽ hiển thị lượt chạy, log, các câu hỏi và kết quả trên Task. Agent nghiên cứu, thực thi, kiểm thử và báo cáo. Con người định hướng, trao quyền và nghiệm thu kết quả.
Thiết lập mô hình nằm ở đâu
Sharkly không tự chọn mô hình. Tài liệu về Agents nói rõ: “Agent tuân theo mô hình mặc định của Runtime. Nó không cam kết hay hiển thị tên mô hình cụ thể. Hãy thay đổi mô hình trong cấu hình công cụ của Runtime hoặc Computer, không phải trên Agent.”
Vì vậy không có menu chọn mô hình trên Agent, cũng không có điều khiển độ sâu suy luận. Bốn vai trò, mỗi vai một việc. Agent quyết định công việc sẽ được xử lý như thế nào. Computer cung cấp host và tài nguyên cục bộ. Runtime thực hiện phiên agent thực tế. Task vẫn là bản ghi chung cho cả nhóm. Toàn bộ quy trình thiết lập đó được trình bày trong hướng dẫn GPT-6 Sol của chúng tôi; bài viết này chỉ tập trung vào phần riêng của việc đưa một mô hình rẻ lên bảng.
Bước 1: gán gpt-6-luna trên Computer
Trên Computer sẽ chạy nó, hãy cập nhật công cụ agent của bạn và đăng nhập bằng tài khoản hoặc API key có quyền truy cập Luna. OpenAI đã đưa Luna lên ChatGPT Work và Codex cho các gói Plus, Pro, Business, Enterprise và Edu, cho người dùng Free và Go dùng Luna trong ứng dụng desktop, và vẫn chưa đưa nó vào Chat. Nếu codex -m gpt-6-luna khởi động được một phiên trong terminal thông thường trên host đó, Sharkly có thể dùng nó.
Sau đó đặt mặc định để các lượt chạy trên Runtime đó tự nhận:
# ~/.codex/config.toml
model = "gpt-6-luna"
model_provider = "openai"
model_reasoning_effort = "high"
Có hai điều cần lưu ý ở đoạn này. Tên khóa reasoning-effort khác nhau giữa các phiên bản Codex, nên hãy đối chiếu với file cấu hình mẫu của bản build đang cài trên Computer đó. Và high được đặt ở đây là có chủ đích chứ không phải giá trị mặc định: mọi kết quả Luna được công bố bên dưới đều đo ở mức effort high hoặc max, chứ không phải ở mức bạn sẽ chọn để làm cho một mô hình rẻ càng rẻ hơn. [VERIFY]
Quay lại Sharkly, mở chi tiết Computer và chạy rescan hoặc kiểm tra kết nối. Runtime phải hiển thị Available. Một Computer chỉ hiện online nghĩa là dịch vụ cục bộ của nó đang gửi heartbeat. Chính trạng thái năng lực của Runtime mới cho bạn biết rằng một lượt chạy có thể bắt đầu.
Bước 2: tách làn rẻ một cách rõ ràng
Một Computer có thể lộ ra một hoặc nhiều Runtime, mỗi Runtime báo cáo trạng thái kết nối riêng, và một Runtime ACP tùy chỉnh có thể được thêm từ chi tiết Computer với tên riêng và lệnh khởi động riêng. Đó chính là đòn bẩy đáng dùng ở đây. Hãy dành cho làn Luna một mục Runtime riêng và một Agent riêng, đặt tên theo làn chứ không theo mô hình, và bảng sẽ cho bạn biết một Task đã chạy ở làn nào mà không cần ai đọc log thực thi.
Điều này không phải chuyện hình thức. Sharkly không thể đọc một cách đáng tin cậy mô hình mà một Runtime thực sự đang dùng, và đó chính là lý do Agent tuân theo mặc định của Runtime và không hiển thị tên mô hình. Nếu một Agent lặng lẽ đổi mô hình từ thứ Ba sang thứ Năm vì ai đó sửa file cấu hình, thì hai lượt chạy trông giống hệt nhau trên Task đã không còn giống nhau nữa. Mỗi mức chi phí một làn sẽ khiến điều đó hiện rõ ngay ở nơi mà cả nhóm vốn đã nhìn vào. Xem Computers trong Sharkly để biết cách Runtime được phát hiện và kiểm tra.
Một cặp tiêu chí quyết định, vì duy trì hai làn cũng tốn công. Hãy tách Runtime khi có nhiều hơn một người giao việc trên Computer đó và sự khác biệt giữa một lượt chạy 0,10 USD và một lượt chạy 10 USD có ý nghĩa với ai đó. Đừng tách khi chỉ một kỹ sư chạy vài Task mỗi tuần; một Runtime duy nhất cùng phán đoán theo từng Task sẽ ít thứ phải nhớ hơn, và cô lập bằng worktree vốn đã giữ cho các lượt chạy không đụng nhau.
Bước 3: chọn quy mô lượt chạy phù hợp với mô hình khởi động chậm
Rẻ không đồng nghĩa với nhanh, và đây là thiết lập mà người ta hay làm sai đầu tiên. Artificial Analysis, một bên thứ ba chứ không phải bên bán nào, đo được 153,9 token đầu ra mỗi giây đối với biến thể reasoning max của GPT-6 Luna, với 124,23 giây cho token đầu tiên. Lâu hơn khoảng thời gian mà hầu hết mọi người chờ trước khi cho rằng tiến trình đã treo.
Vì vậy hãy đặt timeout mỗi Task một cách có chủ đích, và giữ thư mục làm việc ở chế độ Temporary để mỗi Task có một thư mục riêng biệt và một worktree mới. Khi đó hai lượt chạy Luna trên cùng một repository không thể ghi đè lên nhau, và một lượt chạy đang suy nghĩ sẽ trông khác một lượt chạy đã chết, bởi Task có trạng thái còn terminal scrollback thì không.
Một Runtime rẻ nên nằm ở đâu trong một Crew
Crew là một nhóm People và Agents có thể tái sử dụng, được điều phối bởi một leader Agent. Quy tắc bố trí rút ra từ chính các con số của OpenAI là Luna thuộc về hàng thành viên, không phải vị trí dẫn dắt.
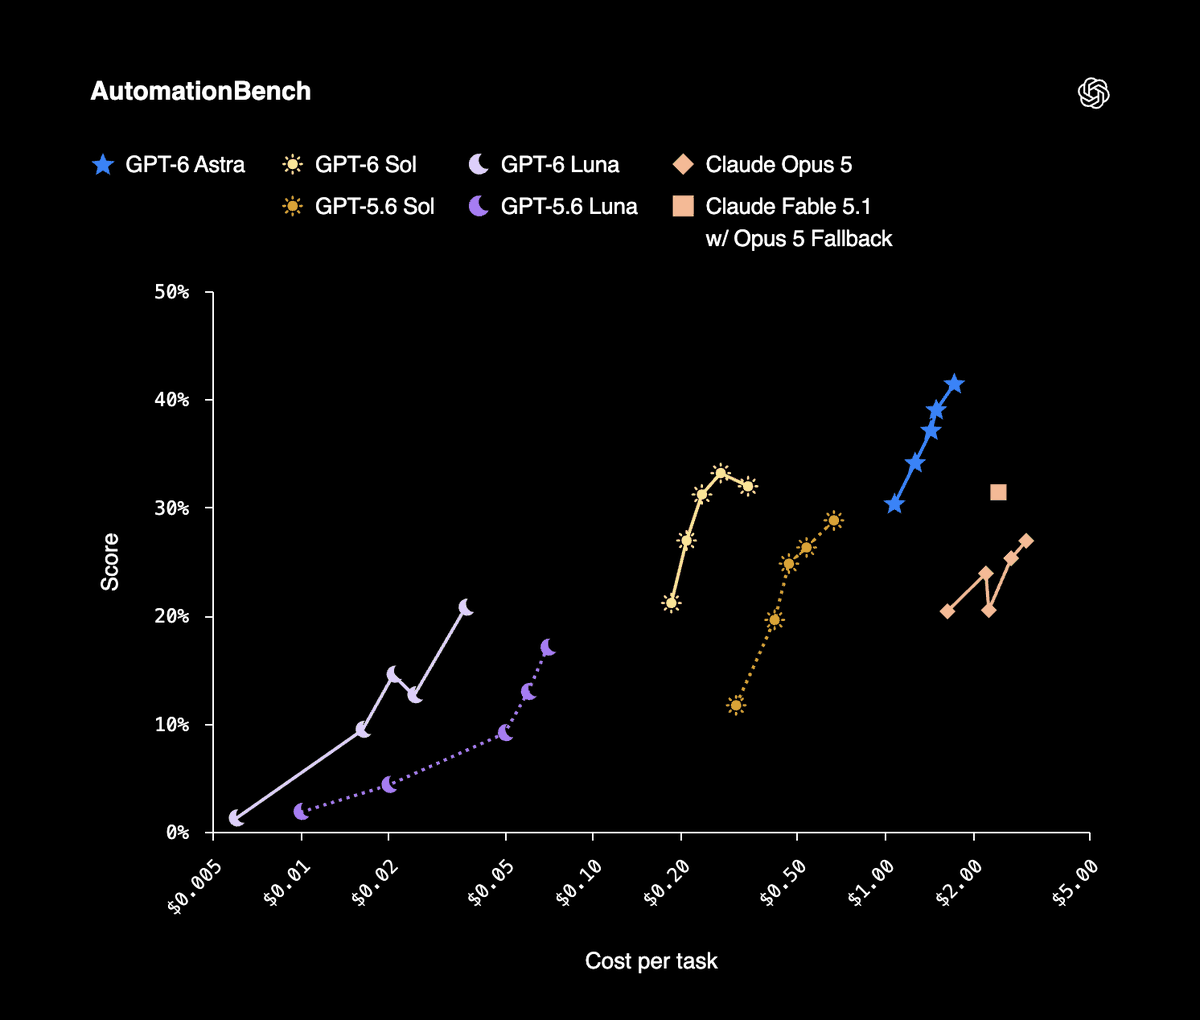
Trường hợp làm thành viên rất mạnh. Trên DeepSWE 1.1, OpenAI báo cáo Luna ở mức effort max đạt 66,6%, tương đương Claude Opus 5 và Fable 5 ở mức effort medium, với chi phí mỗi task thấp hơn Opus 5 tới 93% và thấp hơn Fable 5 tới 96%. Trên OSWorld 2.0 offline, Luna ở mức max đánh bại GPT-5.6 Sol ở mức medium với chi phí bằng một phần mười. Trên AutomationBench 1.0.6, Luna ở mức high đạt điểm cao hơn phiên bản tiền nhiệm 5,4 điểm phần trăm với chi phí mỗi task thấp hơn 58%, và về độ xác thực thông tin, Luna ở mức effort cao hơn ngang bằng GPT-5.6 Sol với chi phí chỉ khoảng một phần trăm. OpenAI cũng mô tả Sol và Luna rẻ hơn 50% so với giá khuyến mại của GPT-5.6, và lưu ý đó là của chính OpenAI: mốc so sánh là giá khuyến mại chứ không phải giá niêm yết.
Trường hợp làm leader thì yếu, và không phải vì bất kỳ benchmark nào. Leader diễn giải mục tiêu, quyết định các thành viên làm gì, và gom kết quả của họ về một Task duy nhất. Một sai sót trong diễn giải ở vị trí dẫn dắt không phải là một lượt chạy hỏng, mà là mọi lượt chạy của mọi thành viên đều nhắm sai hướng, và khoản tiết kiệm token của leader chỉ là sai số làm tròn so với điều đó. Hướng dẫn về Crew leader của chúng tôi cũng lập luận tương tự ở đầu kia của bảng giá.
| Công việc | Làn | Lý do |
|---|---|---|
| Phân loại, dán nhãn, dọn dẹp backlog | Luna | Khối lượng lớn, và con người có thể kiểm tra phán quyết trong vài giây |
| Dựng khung test, ghi chú review lần đầu | Luna ở mức effort high | Các kết quả được công bố đều ở mức high hoặc max, không phải ở mức thấp hơn |
| Thay đổi trên code sẽ được phát hành | GPT-6 Sol ở mức $2 / $10 | AutomationBench 33,2% với $0,27 mỗi task |
| Diễn giải một mục tiêu mơ hồ cho một Crew | GPT-6 Sol, hoặc Astra ở mức $10 / $50 | Sai lầm của leader sẽ nhân lên theo từng thành viên |
Hãy ghi điều đó thành một quy tắc thay vì một thói quen. Mô hình nào cho tác vụ coding nào trình bày đầy đủ câu hỏi về định tuyến.
Một lưu ý khi đọc các mức tiết kiệm của OpenAI: bài công bố ra mắt của họ benchmark với Claude Opus 5, và Anthropic đã thay Opus 5 bằng Opus 5.5 chỉ vài giờ sau đó trong cùng ngày. Các so sánh về Luna ở trên được đo với thế hệ trước của đúng mô hình mà họ nêu tên.
Những thứ một Runtime rẻ không làm rẻ đi được
Luna làm giảm chi phí tạo ra một thay đổi. Nó không tác động gì đến chi phí nghiệm thu thay đổi đó. Mười lượt chạy rẻ tạo ra mười diff, mười bộ kết quả test, và mười quyết định mà chỉ con người mới đưa ra được, còn chính các con số chi tiêu của OpenAI là một lời cảnh báo chứ không phải một lời trấn an: họ báo cáo mức chi trung vị của một researcher trên 600 USD mỗi ngày cho các coding agent, với phân vị thứ 90 lên tới 7.000 USD. Rẻ hơn trên mỗi task chính là cách một hóa đơn như vậy được tạo ra.
Vậy nên đây là phiên bản trung thực của lời chào hàng. Một Runtime rẻ đáng để gán khi công việc nó đảm nhận là việc mà con người có thể kiểm chứng nhanh, và nó là một khoản tiết kiệm giả tạo khi nó nhân lên hàng đợi trước mặt người review của bạn. Hãy giữ ngữ cảnh, tiến độ, điểm tắc, kết quả và bước review của con người luôn hiển thị từ lúc đặt yêu cầu đến lúc phát hành, và quyết định làn ngay khi giao việc chứ không phải lúc review. Review của con người mới là điểm nghẽn nói về khía cạnh lập lịch của vấn đề này.
Nếu bạn đã chạy nhiều coding agent, hãy kết nối một Computer, tạo một Agent trên làn rẻ, và giao cho nó một việc nhàm chán.


