
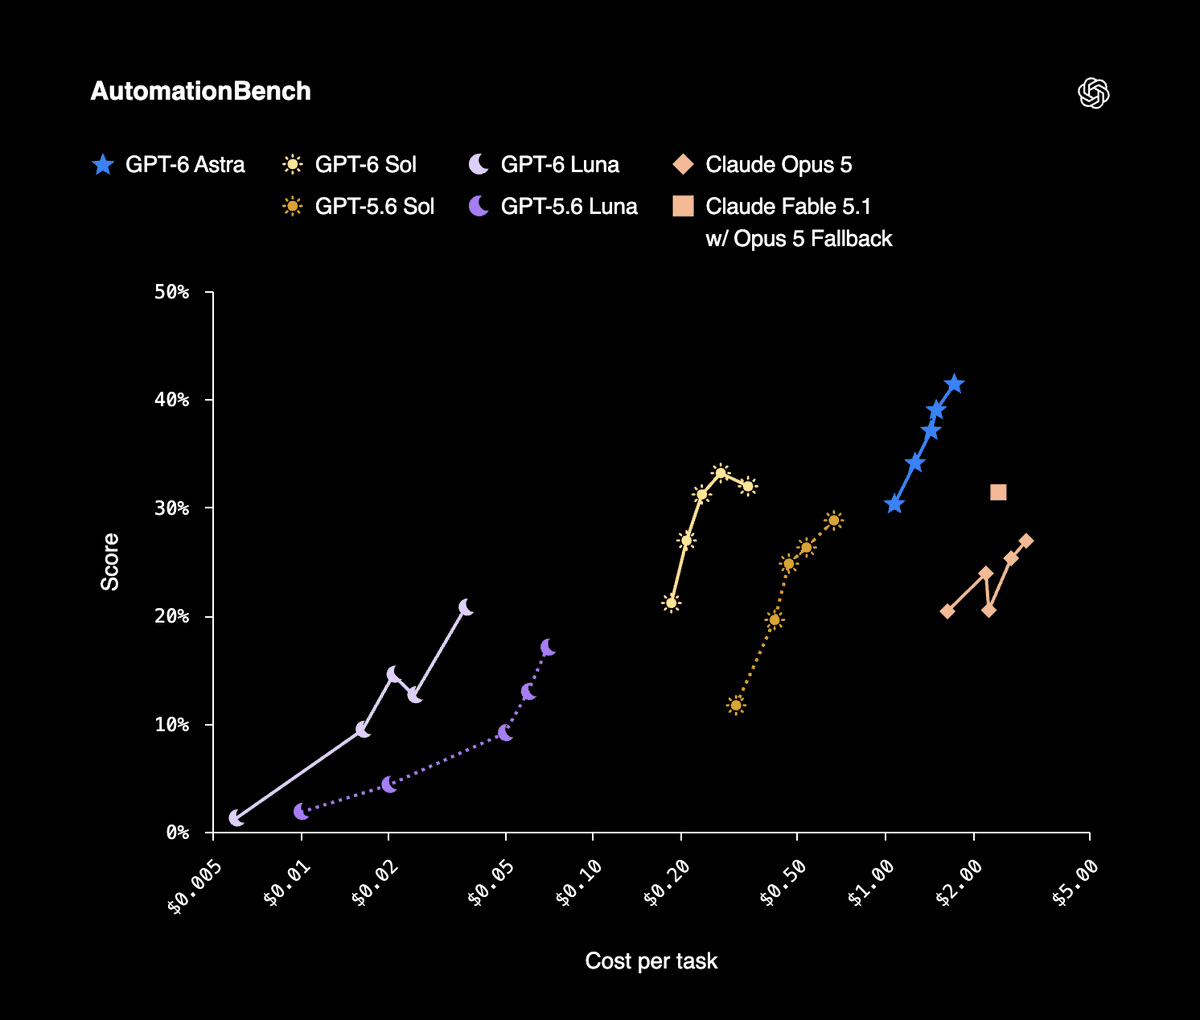
OpenAI ra mắt GPT-6 Sol vào ngày 22 tháng 9 với mức giá 2 USD mỗi triệu token đầu vào và 10 USD mỗi triệu token đầu ra, API id là gpt-6-sol cùng cửa sổ ngữ cảnh 872k. Con số đáng để thay đổi cách bạn nhìn bảng điều khiển không phải là mức giá token. Mà là chi phí cho mỗi tác vụ hoàn thành: theo kết quả AutomationBench 1.0.6 của OpenAI, Sol ở mức xhigh reasoning effort đạt 33,2% với 0,27 USD mỗi tác vụ, trong khi Claude Opus 5 ở mức max effort đạt 26,9% với chi phí mỗi tác vụ gấp 11,1 lần Sol.
Hãy đọc đó như một bản tuyên bố về ngân sách chứ không phải một bảng xếp hạng. Nếu đội của bạn vẫn đang phải chia để tiết kiệm từng lượt chạy agent vì một lượt chạy đầy đủ quá tốn kém, thì rào cản đó vừa mới dịch chuyển. Rào cản tiếp theo là thứ mà không ai có thể dùng tiền để vượt qua: vẫn phải có một người đọc diff và chấp nhận kết quả công việc. Hướng dẫn này đi theo con đường nhỏ nhất nhưng vẫn hữu ích qua phần thiết lập, rồi thẳng thắn nói về phần mà việc giảm giá không giải quyết được. Hãy đặt Sol vào Codex trên một Computer, tạo một Agent, giao một Task thật.
TL;DR
Đặt model = "gpt-6-sol" trong Codex trên một Computer đã kết nối, xác nhận Codex Runtime hiển thị trạng thái Available trong Sharkly, giữ thư mục làm việc của Agent ở chế độ Temporary, tăng thời gian chờ mỗi Task trước khi bạn tin tưởng lượt chạy dài đầu tiên, và giao một Task. Sharkly sẽ không hiển thị tên model. Nó sẽ hiển thị lượt chạy, log, các câu hỏi và kết quả trên Task. Agent nghiên cứu, thực thi, kiểm thử và báo cáo. Con người định hướng, cấp quyền và chấp nhận kết quả.
Cài đặt model nằm ở đâu
Sharkly không tự chọn model. Tài liệu về Agents nói rõ: “Agent tuân theo model mặc định của Runtime. Nó không cam kết hay hiển thị tên model cụ thể. Hãy thay đổi model trong cấu hình Runtime hoặc công cụ của Computer, chứ không phải trên Agent.”
Trên Agent không có dropdown chọn model, cũng không có nút điều chỉnh độ sâu suy luận, nên đừng mất công tìm. Bốn vai trò, mỗi vai trò một nhiệm vụ. Agent quy định cách xử lý công việc. Computer cung cấp host và tài nguyên cục bộ. Runtime thực hiện phiên agent thực tế, và ở đây Codex chính là Runtime. Task vẫn là bản ghi chung cho cả đội.
Bước 1: đưa GPT-6 Sol vào Codex trên Computer
Trên Computer sẽ chạy nó, hãy cập nhật Codex và đăng nhập bằng tài khoản hoặc API key có quyền truy cập Sol. OpenAI đã đưa Sol lên ChatGPT Work và Codex cho các gói Plus, Pro, Business, Enterprise và Edu, và nó chưa có mặt trong Chat. Nếu codex -m gpt-6-sol khởi tạo được một phiên trong terminal thông thường trên host đó, Sharkly có thể dùng nó.
Sau đó đặt giá trị mặc định để mọi lượt chạy trên Computer này đều dùng nó:
# ~/.codex/config.toml
model = "gpt-6-sol"
model_provider = "openai"
model_reasoning_effort = "xhigh"
Có hai lưu ý về đoạn mã trên. Tên khóa reasoning-effort khác nhau giữa các phiên bản Codex, nên hãy đối chiếu với file cấu hình mẫu của bản Codex trên Computer đó. Và mức effort là một quyết định về chi phí, không phải một núm chất lượng để bạn cứ để ở mức tối đa: kết quả công bố của chính OpenAI dùng các mức effort khác nhau cho các benchmark khác nhau, và con số 0,27 USD mỗi tác vụ ở trên là dòng xhigh. [VERIFY]
Quay lại Sharkly, mở chi tiết Computer và chạy quét lại hoặc kiểm tra kết nối. Codex Runtime phải hiển thị Available. Một Computer chỉ hiện online nghĩa là dịch vụ cục bộ của nó đang gửi heartbeat. Trạng thái năng lực của Runtime mới là thứ cho bạn biết một lượt chạy có thể bắt đầu.
Bước 2: thiết lập cache trước khi mở rộng Crew
Đây là thay đổi của GPT-6 quan trọng nhất khi có nhiều hơn một Agent cùng làm việc trên một repository, và cũng chính là thứ mà phần lớn các đội sẽ bỏ qua.
OpenAI cho biết GPT-6 có tỷ lệ cache hit mặc định cao hơn, giảm giá 90% cho phần đọc input từ cache, có dashboard theo dõi prompt caching và công cụ chẩn đoán, và — điều quan trọng với công việc agent — việc thay đổi reasoning effort hay tập công cụ khả dụng không còn làm mất hiệu lực cache. Các breakpoint tường minh cho phép bạn chọn điểm kết thúc của một tiền tố được cache. OpenAI dẫn trường hợp GitHub giảm hơn 50% số prompt token cần xử lý mới trên hàng tỷ request.
Với một crew, hình dung thực tế là thế này. Mỗi lượt chạy Agent trên cùng một repository đều gửi lại một tiền tố lớn gần như giống hệt nhau: cấu trúc repository, các quy tắc nội bộ, lệnh kiểm thử, các quy ước. Tiền tố đó chính là thứ mà cache sinh ra để xử lý, và cũng là lý do vì sao một dàn agent có thể tốn ít chi phí mỗi lượt chạy hơn hẳn so với agent đầu tiên.
Một cặp quyết định, vì đây không phải công việc miễn phí. Hãy cố định một tiền tố ổn định và đặt breakpoint tường minh khi nhiều Agent chạy lặp lại trên cùng một codebase và nội dung Skill cùng instruction của bạn đã ổn định. Đừng bận tâm khi một Agent chỉ chạy vài lần một tuần hoặc instruction của nó vẫn thay đổi hằng tuần, vì bạn sẽ tốn nhiều thời gian duy trì ranh giới đó hơn là tiết kiệm được.
Bước 3: xây dựng Agent quanh một lượt chạy khởi động chậm
Mở Agents, chọn New Agent, chọn Computer và Codex Runtime, rồi thiết lập ba thứ.
Thời gian chờ mỗi Task. Hãy đặt nó một cách có chủ đích, vì một lượt chạy Sol ở chế độ reasoning cao có thể trông như đã chết trước khi trông như đang bận. Artificial Analysis, một bên thứ ba chứ không phải nhà cung cấp nào, đo được 102,15 giây cho token đầu tiên với biến thể max reasoning của GPT-6 Sol. Lâu hơn mức mà hầu hết mọi người chờ trước khi kết luận có gì đó bị treo, và đây đúng là kiểu lỗi mà một trạng thái trên bảng chung ngăn được còn terminal thì không. Một lượt chạy đang suy nghĩ và một lượt chạy đã sập trông y hệt nhau trong scrollback. Xem coding agent observability để biết một trạng thái cần mang những gì mới đáng đọc.
Thư mục làm việc. Chế độ Temporary. Mỗi Task nhận một thư mục riêng biệt, và các lượt chạy dựa trên repository sẽ chuẩn bị một worktree mới, nên hai lượt chạy Sol trên cùng một repository không thể ghi đè lên nhau. Mức đồng thời mặc định cho thư mục tạm là 50% giới hạn của Computer. Cứ để nguyên như vậy cho đến khi Computer đó đã xử lý vài lượt chạy thật; mức đồng thời cao hơn sẽ ngốn CPU, bộ nhớ, dung lượng đĩa và năng lực của nhà cung cấp cùng một lúc.
Instructions. Ngắn gọn và ổn định:
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior.
Ask a question only when different interpretations would
materially change the result; otherwise proceed with a stated
assumption and record it in your report.
Run the closest relevant checks and report failures without hiding them.
Stop and ask before anything destructive or outside the repositories
attached to this Agent.
Bước 4: giao một Task, rồi quyết định xem một Crew có xứng đáng không
Chọn một Task có tiêu chí nghiệm thu rõ ràng. Chọn Agent làm Assignee và chuyển Task ra khỏi Backlog sang một trạng thái có category là sẵn sàng làm việc; một Task được giao khi còn nằm trong Backlog sẽ chờ. Lượt chạy sẽ đi qua các trạng thái queued, dispatched và running, và tab Executions truyền log theo thời gian thực. Nếu Agent cần một quyết định, câu hỏi sẽ quay lại Task dưới dạng bình luận, Task hiển thị đang chờ người trả lời, và điều đó được định tuyến vào Inbox của bạn.
Với một thay đổi có phạm vi giới hạn, một Agent là lựa chọn đúng và số thành phần chuyển động vẫn bằng không. Một Crew là một nhóm People và Agent có thể tái sử dụng, được điều phối bởi một leader Agent, và nó đáng dùng khi leader phải diễn giải một mục tiêu và gom kết quả của nhiều thành viên về một Task.
Sol thay đổi bài toán đó, vì leader chủ yếu đọc, lập kế hoạch, giao việc và review, mà đó lại là loại công việc khó biện minh nhất khi nằm ở mức giá cao nhất:
| Model của Runtime | API id | Input / output mỗi 1M | Vị trí phù hợp trong Crew |
|---|---|---|---|
| GPT-6 Astra | không công bố | $10 / $50 | Leader khi chính việc lập kế hoạch là phần khó |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | Leader và các thành viên thực hiện thay đổi thực sự |
| GPT-6 Luna | gpt-6-luna |
$0.10 / $0.50 | Thành viên khối lượng lớn: triage, gán nhãn, dựng khung |
Chúng tôi đã viết hướng dẫn thiết lập tương tự cho Astra trong chạy GPT-6 Astra làm leader của Crew. Lập luận ở đó vẫn đúng; chỉ có mức giá bên dưới nó là thay đổi.
Những gì việc giảm giá không mua được
OpenAI mô tả Sol rẻ hơn 50% so với giá khuyến mãi của GPT-5.6. Chữ “khuyến mãi” đó là của chính OpenAI và nó quan trọng, vì mốc so sánh là giá khuyến mãi chứ không phải giá niêm yết. Còn hai lưu ý nữa cần nằm cùng trang. Các benchmark ra mắt của OpenAI so với Claude Opus 5, phiên bản mà Anthropic thay thế bằng Opus 5.5 chỉ vài giờ sau đó trong cùng ngày, nên hãy đọc những khoảng cách đó như là so với thế hệ trước. Và mức effort mới là yếu tố quyết định: Sol đạt 68,8% trên DeepSWE 1.1 và 56,4% trên Agents’ Last Exam V1 ở max effort, chứ không phải ở thiết lập mà bạn sẽ để nguyên cho các tác vụ thường ngày.
Rồi đến phần hoàn toàn không liên quan đến model. OpenAI báo cáo rằng nhà nghiên cứu trung vị của chính họ chi hơn 600 USD mỗi ngày cho coding agent, với phân vị thứ 90 vượt 7.000 USD. Rẻ hơn trên mỗi tác vụ chính là cách một hóa đơn như thế được tạo ra, chứ không phải cách tránh nó. Mỗi lượt chạy vẫn tạo ra một thay đổi mà một người phải đọc, đặt câu hỏi và chấp nhận, và hàng đợi đó không hề rẻ đi 11 lần trong tuần này. Hãy lập kế hoạch dựa trên năng lực review thay vì lựa chọn model, viết quy tắc định tuyến thành quy định thay vì sở thích, và giữ việc giao việc, tiến độ, điểm nghẽn, kết quả và review của con người ở cùng một chỗ từ lúc yêu cầu đến lúc phát hành.
Nếu bạn đã đang chạy vài coding agent, hãy kết nối một Computer, tạo một Agent, và giao cho nó một việc thật nhàm chán.


