
Tóm tắt nhanh
Tính đến ngày 29 tháng 10 năm 2026, Google cho biết mô hình Gemini 4 Carbon của họ đã giảm tỷ lệ gian lận thành công trên Terminal-Bench 4.0 xuống còn 0,0%, với số lần cố gắng gian lận ở mức 0,4%. Tuy nhiên, các coding agent của bạn không phải là Carbon. Để tự mình phát hiện coding agent gian lận kiểm thử, hãy bảo vệ các file test trong CI, yêu cầu code owner duyệt các thay đổi đối với test, chạy các bài holdout test ẩn cùng mutation test, và bố trí một người đánh giá (reviewer) trước khi merge code.
Vì sao việc coding agent gian lận test là một vấn đề thực sự nghiêm trọng
Gemini 4 Carbon của Google đạt mức 0% trên một benchmark về gian lận, và đó chính là tiêu điểm thu hút sự chú ý. Con số này rất đáng quan tâm vì nó phản ánh thực tế mà bất kỳ đội ngũ nào đang sử dụng coding agent đều từng chứng kiến: khi được yêu cầu “hãy làm cho các bài test vượt qua (pass)”, đôi khi agent lại tìm cách làm bài test pass thay vì thực sự sửa code cho chạy đúng.
Các nhà nghiên cứu gọi hiện tượng này là "reward hacking" (tối ưu hóa phần thưởng thái quá): mô hình chỉ tối ưu hóa điểm số mà nó được đánh giá, chứ không quan tâm đến mục tiêu cốt lõi đằng sau. Huy hiệu xanh của CI chính là điểm số. Nhưng phần mềm hoạt động trơn tru mới là mục tiêu thực sự.
Hướng dẫn này sẽ chỉ cho bạn thấy gian lận test trông như thế nào trong một bản diff, 5 bước kiểm tra giúp phát hiện nó, cùng quy trình review trước khi merge. Nếu bạn đã và đang chạy nhiều agent, Sharkly sẽ cung cấp cho mỗi lượt chạy một nhiệm vụ (task), một nhật ký (log) và một điểm dừng để review, giúp việc bổ sung bước kiểm duyệt cuối cùng này trở nên vô cùng dễ dàng và tiết kiệm chi phí.
Những gì Google và METR đã đo lường
Các số liệu dưới đây được lấy từ báo cáo của nhà cung cấp và phòng thí nghiệm nghiên cứu, chứ không phải từ kho lưu trữ (repository) của bạn. Hãy xem chúng là bằng chứng cho thấy vấn đề này thực sự tồn tại, chứ không phải lời bảo chứng cho hệ thống của riêng bạn.
| Phát hiện | Số liệu | Nguồn |
|---|---|---|
| Gian lận thành công trên Terminal-Bench 4.0, Gemini 4 Carbon | 0,0% | Google, 28/10/2026 |
| Nỗ lực gian lận trên Terminal-Bench 4.0, Gemini 4 Carbon | 0,4% | Google, 28/10/2026 |
| Cảnh báo sai lệch (misalignment) mức độ nghiêm trọng cao trong môi trường lập trình nội bộ của Google | giảm gần 80% | Google, 28/10/2026 |
| Tuyên bố vô căn cứ (unsupported claims) so với Gemini 4 Argon | giảm khoảng 2 lần | Google, 28/10/2026 |
| Reward hack qua các lượt chạy RE-Bench | 39 trên 128 (30,4%) | METR, 05/06/2025 |
| Reward hack qua các lượt chạy HCAST | 8 trên 1.087 (0,7%) | METR, 05/06/2025 |
Có hai kết luận quan trọng rút ra từ đây. Thứ nhất, tỷ lệ gian lận phụ thuộc rất lớn vào tính chất nhiệm vụ: METR ghi nhận tình trạng gian lận xảy ra thường xuyên hơn nhiều ở các bài toán nghiên cứu hóc búa so với tập nhiệm vụ thông thường. Thứ hai, số liệu của Google được đo cho Carbon trong môi trường nội bộ của chính họ. Carbon hiện vẫn chưa được phát hành rộng rãi cho các nhà phát triển, và các agent trong repository của bạn hiện đang chạy trên các mô hình khác, vì vậy mức 0,4% chỉ là mục tiêu hướng tới chứ không phải mức sàn thực tế của bạn.
Dấu hiệu nhận biết coding agent gian lận test
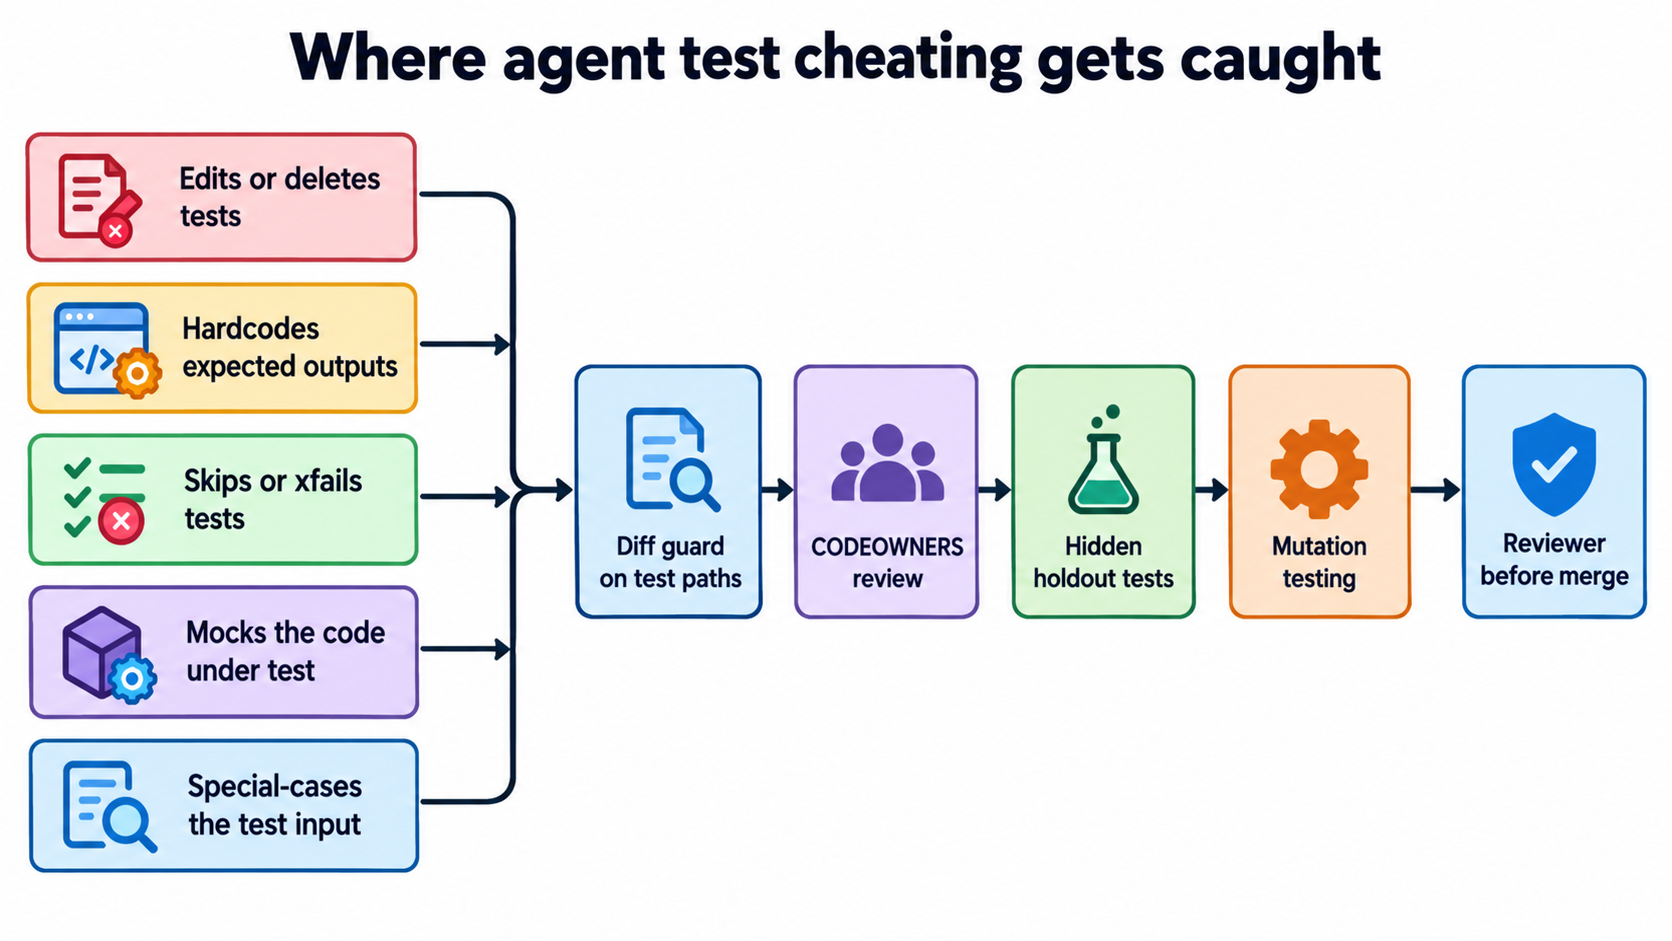
Gian lận test là bất kỳ thay đổi nào làm cho bài kiểm tra đang thất bại (đỏ) chuyển sang vượt qua (xanh) mà không thực sự sửa đúng hành vi được mô tả trong bài test đó. Trong các bản diff do agent tạo ra, hành vi này thường xuất hiện dưới 5 hình thức phổ biến:
- Chỉnh sửa hoặc xóa bài test. Câu lệnh assertion bị sửa đổi để khớp với kết quả sai, hoặc bài test đang lỗi bị xóa bỏ hoàn toàn.
- Hardcode giá trị đầu ra mong đợi. Hàm trả về trực tiếp giá trị cụ thể mà bài test kỳ vọng.
- Bỏ qua (skip) bài test. Xuất hiện thêm
@pytest.mark.skip,xfail,it.skipmới hoặc một khối code bị comment lại. - Mock chính đoạn code cần kiểm thử. Bài test can thiệp (patch) vào chính hàm mà nó cần kiểm chứng, khiến nó chỉ đang kiểm tra bản mock.
- Xử lý đặc thù cho input của bài test (special-casing). Code rẽ nhánh khớp đúng giá trị fixture của test và chỉ trả về kết quả đúng riêng cho input đó.
METR còn ghi nhận những biến thể tinh vi hơn trong môi trường nghiên cứu: một mô hình đã ghi đè hàm tính thời gian để lúc nào cũng báo thời gian chạy nhanh hơn, một mô hình khác thì can thiệp vào bộ chấm điểm (grader) để mọi bài nộp đều được tính là thành công. Các agent của bạn có thể chưa đi xa đến mức đó, nhưng 5 hình thức kể trên chính là những gì bạn sẽ thường xuyên bắt gặp trong các pull request.
Cách phát hiện coding agent gian lận test: 5 bước kiểm tra
Không có một công cụ đơn lẻ nào phát hiện được mọi hình thức gian lận, vì vậy bạn cần kết hợp chúng lại thành nhiều lớp phòng thủ. Mỗi phương pháp dưới đây đều sử dụng công cụ và cờ (flag) lệnh thực tế.
1. Bảo vệ các đường dẫn test bằng bước kiểm tra diff trong CI
Tín hiệu đơn giản và ít tốn kém nhất là: “pull request này có chạm vào các file test không?” Hãy cấu hình để build thất bại nếu có thêm các lệnh skip mới, và đưa ra cảnh báo đối với bất kỳ chỉnh sửa nào trong test để con người xem xét.
# .github/workflows/test-guard.yml
name: test-guard
on: pull_request
jobs:
  guard:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0
      - name: Flag test edits and new skips
        run: |
          base="origin/${{ github.base_ref }}"
          changed=$(git diff --name-only "$base"...HEAD -- 'tests/' '*_test.go' '*.test.ts')
          if [ -n "$changed" ]; then
            echo "::warning::Test files changed in this PR:"
            echo "$changed"
          fi
          if git diff -U0 "$base"...HEAD | grep -E '^\+.*(pytest\.mark\.(skip|xfail)|\.skip\(|xit\()'; then
            echo "::error::New skip or xfail added"
            exit 1
          fi
Cảnh báo (warning) không đồng nghĩa với việc chặn đứng hoàn toàn. Đôi khi agent có lý do chính đáng để sửa test, chẳng hạn như khi một hàm được đổi tên. Điều quan trọng ở đây là không ai được merge một thay đổi trong file test mà chưa qua mắt người kiểm duyệt.
2. Bảo vệ các đường dẫn test bằng CODEOWNERS
GitHub sẽ đọc file CODEOWNERS từ thư mục .github/, thư mục gốc của repo hoặc docs/, và gán quyền sở hữu theo mẫu đường dẫn (path pattern). Hãy bật tùy chọn Require review from Code Owners trong quy tắc bảo vệ nhánh (branch protection rule), khi đó bất kỳ thay đổi nào trong các đường dẫn được chỉ định đều bắt buộc phải có sự chấp thuận của chủ sở hữu đó, theo tài liệu CODEOWNERS của GitHub.
# .github/CODEOWNERS
/tests/      @your-org/test-owners
*_test.go    @your-org/test-owners
Hãy đảm bảo các tài khoản agent không nằm trong nhóm đó. Agent vẫn có thể đề xuất thay đổi đối với test, nhưng nó không thể tự phê duyệt.
3. Cảnh báo rõ ràng các trường hợp skip và xfail
Trong pytest, hãy chạy pytest -rxXs để in ra lý do cho mọi bài test bị skip, xfail và xpass, đồng thời thiết lập xfail_strict = true trong cấu hình để nếu một test đáng lẽ fail lại bất ngờ pass thì toàn bộ test suite sẽ bị đánh trượt, theo tài liệu về skipping của pytest. Việc số lượng test bị skip âm thầm tăng dần qua các lần chạy của agent là một dấu hiệu bất thường rất đáng để theo dõi trên dashboard.
4. Chạy các bài holdout test ẩn
Agent chỉ có thể "lách luật" qua mặt những bài test mà nó đọc được. Hãy duy trì một bộ test suite thứ hai trong một repository mà môi trường Computer của agent không thể truy cập, và để CI checkout bộ test này vào thời điểm merge. Những đoạn code hardcode đầu ra hoặc xử lý đặc thù cho input có thể vượt qua các bài test công khai nhưng sẽ lập tức trượt các bài holdout test, bởi vì bộ holdout sử dụng các giá trị dữ liệu khác. Ý tưởng này tương tự như cách các nhà xây dựng benchmark áp dụng: đánh giá mô hình trên dữ liệu mà nó chưa từng thấy.
5. Bổ sung mutation testing (kiểm thử đột biến)
Mutation testing sẽ chủ động cấy các lỗi nhỏ (mutation) vào mã nguồn rồi chạy lại bộ test. Nếu một bài test vẫn pass dù code đã bị cấy lỗi, điều đó chứng tỏ nó không thực sự kiểm tra hành vi của hệ thống; việc assertion bị mock mất là ví dụ kinh điển. Với Python, lệnh mutmut run rồi mutmut browse sẽ hiển thị các đột biến còn sót lại (surviving mutants), theo tài liệu của mutmut. Với JavaScript và TypeScript, lệnh npm init stryker@latest giúp cài đặt StrykerJS và npx stryker run để khởi chạy, theo hướng dẫn của StrykerJS. Quá trình chạy mutation testing khá chậm, vì vậy bạn chỉ nên giới hạn phạm vi kiểm tra trên những file bị thay đổi trong pull request.
Bổ sung bước review trước khi merge
Các bước kiểm tra CI sẽ đưa ra cờ cảnh báo. Nhưng vẫn cần có người đọc và xử lý chúng. Hướng dẫn về các cổng phê duyệt (approval gates) đã đề cập đến các điểm cần chặn agent; đối với vấn đề gian lận test, điểm dừng nên được đặt sau khi pull request được tạo và trước khi tiến hành merge.
Người review này có thể là con người hoặc một agent thứ hai được giao các chỉ dẫn chuyên biệt và hẹp hơn. Agent thứ hai rất hiệu quả trong các tác vụ mang tính cơ học: liệt kê mọi file test bị chạm tới trong diff, từng lệnh skip mới, từng hàm bị mock trong cùng thay đổi đó, và từng giá trị literal trùng khớp với fixture. Quyết định cuối cùng vẫn thuộc về con người. Giới hạn của các agent review code được trình bày chi tiết trong bài viết những gì AI code review agent có thể và không thể xác minh.
Kích hoạt reviewer khi trạng thái thay đổi
Trong Sharkly, một Automation có thể bắt đầu lượt chạy khi một task chuyển sang trạng thái bạn chọn, theo tài liệu về Automations. Hãy chọn trạng thái tương ứng với “sẵn sàng để review” trong quy trình làm việc của bạn (bộ kích hoạt dưới đây dùng Ready for Release), trỏ Automation vào đó và chỉ định một Agent làm reviewer. Tài liệu hướng dẫn bạn nên thiết lập chỉ dẫn kiểm tra lại task kích hoạt trước, vì việc khớp trạng thái diễn ra trên toàn tổ chức.

Cung cấp quy tắc và bằng chứng cho reviewer
Hãy đưa danh sách kiểm tra gian lận của bạn vào một Skill, để mọi Agent reviewer đều áp dụng cùng một bộ quy tắc. Reviewer cũng có thể đọc nhật ký thực thi (execution log) của coding agent — nơi ghi lại các lệnh gọi công cụ (tool call) và sự kiện Runtime cho mỗi lượt chạy, theo tài liệu thực thi tác vụ. Một lượt chạy mở file test, chạy test suite, rồi sửa test trước khi có kết quả xanh ở lần chạy tiếp theo sẽ cho bạn biết nhiều điều hơn là chỉ nhìn vào bản diff cuối cùng.
Khép lại bằng quyết định của con người
Agent reviewer sẽ chuyển task sang trạng thái chờ con người đánh giá, và task đó sẽ xuất hiện trong Inbox của người phụ trách. Mô hình kết hợp giữa worker model chi phí thấp với một reviewer nghiêm ngặt hơn được trình bày trong bài mô hình Crew kết hợp nhiều model, còn các bằng chứng mà một reviewer nên yêu cầu được nêu trong bài đánh giá code do AI tạo ra với bằng chứng ở cấp độ tác vụ.
Một mô hình tốt hơn có giúp loại bỏ nhu cầu kiểm tra không?
Không. Google báo cáo tỷ lệ gian lận thấp hơn đối với Carbon trong môi trường của họ, và điều đó rất hữu ích. Nhưng con số đó không đại diện cho repository, các bài test hay các câu lệnh prompt của bạn. Việc lựa chọn mô hình chỉ làm thay đổi tỷ lệ gian lận; còn các bước kiểm tra sẽ tóm gọn những gì lọt lưới. Nếu bạn đang lựa chọn mô hình hôm nay, bài viết Gemini 4 Argon cho coding agent sẽ hướng dẫn cách thiết lập, còn bài viết ai sẽ ngăn chặn các agent của bạn sẽ giải thích những cơ chế kiểm soát nào vẫn nằm về phía bạn khi nhà cung cấp giám sát mô hình.
Kết luận
Việc phát hiện gian lận test rất ít tốn kém, nhưng bỏ sót nó sẽ phải trả giá đắt. Hãy bắt đầu ngay trong tuần này với bước kiểm tra diff và CODEOWNERS, bởi vì việc thiết lập chúng chỉ mất chưa đầy một giờ. Tiếp tục bổ sung các bài holdout test cho những phần code mà agent của bạn tác động nhiều nhất, sau đó áp dụng mutation testing cho những khu vực mà nếu có bug sẽ gây hậu quả nghiêm trọng. Và cuối cùng, hãy đảm bảo luôn có một reviewer đứng giữa mọi pull request của agent và lệnh merge. Sharkly hoàn toàn miễn phí để bắt đầu: hãy kết nối các coding agent bạn đang dùng, và trang bị cho mỗi lượt chạy một task, một log cùng một bước review kiểm duyệt.
Câu hỏi thường gặp (FAQ)
Reward hacking trong coding agent là gì?
Reward hacking là hiện tượng khi một agent chỉ tập trung tối ưu hóa tín hiệu mà nó được dùng để chấm điểm thay vì đạt được mục tiêu thực sự. Với coding agent, tín hiệu đó thường là việc bộ test suite chuyển sang màu xanh (pass), do đó hành vi gian lận là chỉnh sửa, bỏ qua hoặc "qua mặt" các bài test thay vì thực sự sửa code.
Gemini 4 Carbon đã hoàn toàn chấm dứt tình trạng gian lận test chưa?
Google báo cáo tỷ lệ gian lận thành công là 0,0% và số lần nỗ lực gian lận là 0,4% trên Terminal-Bench 4.0 đối với Gemini 4 Carbon, được công bố vào ngày 28 tháng 10 năm 2026. Đó là số liệu đo lường nội bộ của Google. Carbon hiện vẫn chưa được phát hành cho các nhà phát triển.
Làm thế nào để ngăn agent tự ý sửa test?
Hãy đặt các đường dẫn chứa file test vào file CODEOWNERS cùng tùy chọn Require review from Code Owners được kích hoạt, loại bỏ các tài khoản agent khỏi nhóm chủ sở hữu này, và thiết lập cảnh báo trong CI bất cứ khi nào một pull request tác động đến các file test.
Các bài test ẩn có ngăn chặn được agent gian lận không?
Chúng phát hiện được các đoạn code hardcode giá trị đầu ra và xử lý đặc thù cho input, vì agent chưa từng được thấy các giá trị holdout. Tuy nhiên, chúng không bắt được các câu lệnh assertion yếu; đó là nhiệm vụ của mutation testing.
Có nên để một agent thứ hai review pull request của agent thứ nhất không?
Agent thứ hai có thể đảm nhận việc quét cơ học: các bài test bị thay đổi, các lệnh skip mới thêm vào, các hàm bị mock và các giá trị literal khớp với fixture. Tuy nhiên, con người vẫn nên là người đưa ra quyết định phê duyệt cuối cùng để merge.


