
Bạn đang cố quyết định xem nên giao phó công việc thực sự cho coding agent nào: Claude Code, Codex, Gemini CLI, OpenCode, hay hai trong số đó cùng lúc. Thế là bạn đọc điểm benchmark. Một agent giải quyết được 68% bộ tác vụ công khai, agent khác đạt 71%, và bạn được cho là phải chọn dựa trên con số đó. Rồi agent đi vào repository của bạn và mắc kẹt ở một bước build mà chưa một bộ dữ liệu công khai nào từng thấy.
Benchmark đo một tập vấn đề cố định, dùng chung. Còn codebase của bạn là một tập vấn đề riêng tư: quy ước của bạn, cách bố trí monorepo của bạn, cái test chập chờn mà ai cũng ngó lơ, cái script deploy chỉ một người hiểu. Điểm số quyết định tuần làm việc của bạn là điểm bạn tự tạo ra trên chính code đó, chứ không phải điểm mà một phòng lab công bố. Hướng dẫn này trình bày một phương pháp để so sánh các coding agent trên phần mềm bạn thực sự ship, và cách chạy so sánh đó mà không phải mở năm terminal chỉ để giữ các agent tách biệt nhau.
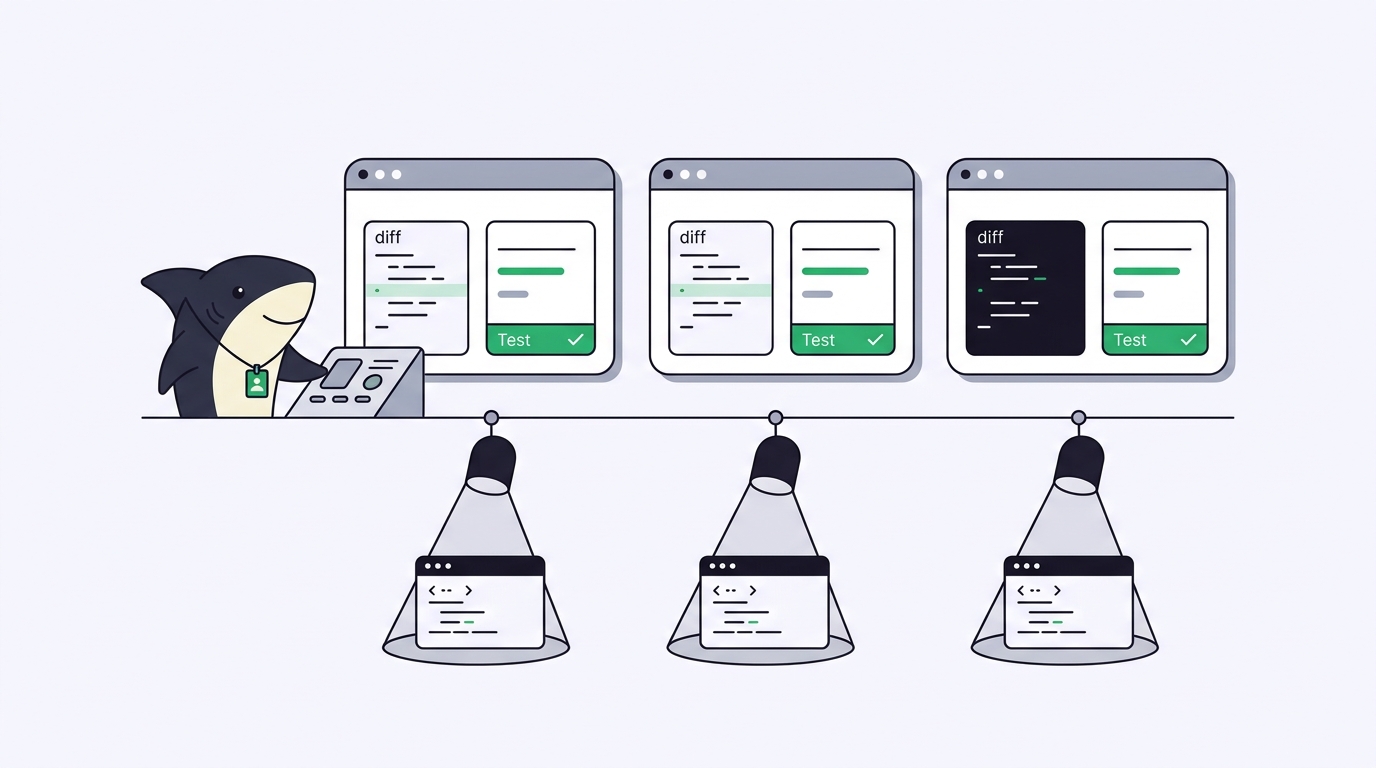
Sharkly là nơi phương pháp đó thành hiện thực. Sharkly là một nền tảng quản lý và điều khiển Agent tất-cả-trong-một: bạn kết nối Computer của riêng mình, giao cùng một Task cho các Agent khác nhau, và mỗi lần chạy đều trả về diff, kết quả test và phần review của nó tại một chỗ. Đó chính là điều khiến một so sánh công bằng trở nên khả thi. Biến số bạn muốn đo là agent, chứ không phải cái trò tung hứng terminal mà nếu không bạn sẽ phải làm để giữ ba lần chạy không giẫm lên nhau.
Điểm benchmark đo một bộ dữ liệu, không đo repository của bạn
Benchmark coding-agent là một bộ kiểm thử công khai cố định, được chấm điểm giống nhau với mọi người. Đó chính xác là điều khiến nó hữu ích cho các lab đang xây dựng model, và cũng chính xác là điều khiến nó trở thành một công cụ dự đoán yếu đối với bạn.
Các benchmark công khai như SWE-bench lấy tác vụ từ những dự án mã nguồn mở nổi tiếng, với một harness đã được tinh chỉnh và các kiểm tra nghiệm thu được tuyển chọn kỹ. Không có gì trong đó mô tả được cái ngày thứ Ba của bạn. Những thứ quyết định hiệu suất của một agent trên code của bạn lại chính là những thứ mà một bộ dữ liệu công khai không bao giờ có thể chứa: các thư viện nội bộ mà model chưa từng đọc, file cấu hình lint của bạn, file ngữ cảnh dài 400 dòng giải thích dịch vụ thực sự khởi động thế nào, cái module duy nhất không có test.
Điểm benchmark cao không dự đoán được cách một agent hành xử trong repository của bạn. Nó chỉ dự đoán cách agent hành xử trong repository của người khác. Hãy coi bảng xếp hạng như một bộ lọc thô để biết agent nào đáng đem ra thử nghiệm, rồi làm cái bài test thực sự có ý nghĩa. Nếu bạn vẫn đang chọn xem nên trỏ mỗi agent vào model nào, thì ghép model với vai trò của agent là câu hỏi khởi đầu tốt hơn điểm số thô.
Chọn một tác vụ thực sự, không phải một prompt đồ chơi
Hãy bắt đầu với phép so sánh nhỏ nhất có ích. Đừng benchmark agent bằng kiểu "xây một app todo". Chọn một yêu cầu thật từ backlog của bạn: một bug gọn gàng, một tính năng nhỏ trên một module duy nhất, một migration mà dù sao bạn cũng định làm. Một thứ gì đó có acceptance test bạn có thể chạy và có diff bạn có thể đọc trong vài phút.
Sau đó cho mọi agent cùng một đầu vào y hệt: cùng mô tả tác vụ, cùng commit khởi đầu, cùng tiêu chí nghiệm thu. Hãy viết nó ra theo đúng cách mà hệ thống tracker của bạn sẽ viết, một tác vụ kiểu SH-312: fix the timezone drift in the invoice export. Nếu một agent nhận được prompt phong phú hơn agent khác, thì bạn đang đo prompt của mình, chứ không phải đo agent.
Dùng một bản sửa bug khi bạn muốn xem agent đọc code hiện có và bám sát khuôn khổ như thế nào. Dùng một tính năng nhỏ khi bạn muốn xem nó cấu trúc code mới ra sao và liệu nó có tự viết test không. Hãy chạy cả hai theo thời gian; một tác vụ đơn lẻ chỉ cho bạn biết về đúng một tác vụ đơn lẻ mà thôi.
So sánh mọi agent ở trạng thái tốt nhất, đừng bao giờ ở trạng thái tệ nhất
Mỗi agent đều có một cách thiết lập mà ở đó nó làm việc hiệu quả nhất: đúng model, đúng file ngữ cảnh, đúng các quyền mà nó thực sự cần. Hãy cho Claude Code file CLAUDE.md của nó, cho Codex config của nó, cho mỗi Runtime môi trường mà tài liệu của nó khuyến nghị. Đem một agent được cấu hình tốt so với một agent trần trụi thì chẳng cho bạn biết gì ngoài việc bạn đã bỏ công thiết lập cái nào.
Chạy chúng ở trạng thái tốt nhất, song song cạnh nhau, chính là lúc phương pháp dùng terminal sụp đổ. Trên Sharkly bạn giao cùng một Task cho mỗi Agent, và mỗi Agent chạy trên một Computer đã kết nối trong một worktree tách biệt, nên ba agent cùng sửa một repository sẽ không bao giờ chạm vào file của nhau. Bạn nhận được ba lần thử sạch sẽ cho cùng một vấn đề thay vì một cây làm việc dùng chung và một mớ merge bạn phải tự tay gỡ rối. Nếu bạn đang làm việc này thủ công, thì chạy nhiều agent cùng lúc chính là phần mà Sharkly được xây dựng để gỡ khỏi vai bạn.
Nếu bạn chỉ dùng một agent và sống trong terminal, thì một phiên Claude Code được tinh chỉnh tốt trong một worktree là đủ, và có thể bạn không cần đến bất cứ thứ gì ở đây. Phương trình thay đổi ngay khi bạn so sánh từ hai agent trở lên, trên nhiều hơn một tác vụ, và bạn muốn kết quả ở dạng bạn thực sự có thể đọc song song cạnh nhau.
Năm tiêu chí quyết định trên công việc thực
Benchmark chấm một con số duy nhất: tác vụ có pass hay không. Công việc thực lại được quyết định bởi năm thứ mà con số đó bỏ sót.
| Tiêu chí | Câu hỏi mà nó trả lời |
|---|---|
| Thực thi song song | Tôi có thể chạy các agent trên cùng một tác vụ cùng lúc, trong môi trường tách biệt, mà không xung đột không? |
| Khả năng hiển thị cho nhóm | Người khác ngoài tôi có thể thấy mỗi agent đã làm gì, và vì sao không? |
| Luồng review | Tôi có thể đọc diff, test và các giới hạn đã biết rồi chấp nhận hay từ chối nhanh đến mức nào? |
| Thực thi trên máy của mình | Agent có chạy trên Computer của tôi, dựa trên môi trường và secret thực của tôi không? |
| Tích hợp | Kết quả có về đúng tracker, repo và các công cụ review mà chúng tôi đang dùng không? |
Bốn tiêu chí đầu tiên chính là chỗ mà hầu hết các agent trông giống hệt nhau trong một benchmark nhưng lại hành xử chẳng giống nhau chút nào trên code của bạn. Riêng thực thi trên máy của mình là thứ vô hình trước một bài test công khai: một agent chạy dựa trên đúng toolchain thực của bạn, database cục bộ của bạn, các CI hook thật của bạn, đang được kiểm tra trên chính thứ bạn ship, chứ không phải trên một sandbox na ná giống nó.
Agent nghiên cứu, thực thi, kiểm thử và báo cáo. Bạn định hướng, trao quyền và chấp nhận kết quả. Một so sánh chỉ trung thực nếu bạn thấy được từng phần của quá trình đó, với từng agent, mà không phải dựng lại từ đống scrollback.
Chấm điểm thứ trả về, không chấm điểm lời agent tự nhận
Một agent in ra chữ "done" không đồng nghĩa với một thay đổi pass. Hãy chấm mỗi lần chạy dựa trên thứ trả về, chứ không dựa trên lời nó khẳng định. Với mỗi lần thử, bằng chứng hữu ích vẫn là cùng một danh sách ngắn: diff, kết quả typecheck và test, bản tóm tắt thay đổi, và những giới hạn mà agent thừa nhận. Sharkly giữ cho ngữ cảnh, tiến độ, điểm tắc nghẽn, kết quả và phần review của con người luôn hiển thị từ lúc yêu cầu đến lúc phát hành, nên phép so sánh đọc lên như một bảng kết quả thay vì năm terminal bạn phải cố nhớ.
Đây cũng là chỗ điểm nghẽn thực sự lộ ra. Hai agent có thể cùng "hoàn thành" một tác vụ trong hai mươi phút và vẫn ngốn của bạn cả tiếng đồng hồ mỗi cái để review. Việc review đầu ra của agent thường là giới hạn thực sự đối với lượng công việc song song mà một nhóm có thể hấp thụ, và nó nên có trọng số lớn khi bạn chọn agent. Cần đặt trọng số vào đâu thì phụ thuộc vào người đang chọn:
| Chọn cho | Đặt trọng số cao nhất vào |
|---|---|
| Lập trình viên độc lập | Luồng review và thực thi trên máy của mình; bạn là người review duy nhất |
| Nhóm nhỏ | Thực thi song song và khả năng hiển thị cho nhóm; nhiều người cần thấy cùng một lượt chạy |
| Nhóm nền tảng | Tích hợp và khả năng hiển thị; quy trình phải trụ được qua cả agent tốt nhất kế tiếp |
Hàng cuối cùng đó chính là lý do để so sánh ngay từ đầu. Agent tốt nhất hôm nay có thể không phải là agent tốt nhất vào quý sau, và việc đập đi xây lại quy trình mỗi khi ngôi đầu đổi chủ cũng là một khoản thuế riêng. Sharkly không phải là một coding agent và cũng không phải một harness benchmark; nó là lớp cho phép bạn tiếp tục thử nghiệm các agent trên chính code của mình mà không phải dựng lại quy trình quanh chúng mỗi lần.
Nếu bạn muốn tiếp tục dùng nhiều coding agent thay vì cam kết với một hệ sinh thái duy nhất, thì đó chính là bài toán mà Sharkly được thiết kế để giải. Tải Sharkly, kết nối một Computer, và giao cùng một tác vụ thực cho hai agent. Phép so sánh bạn nhận về sẽ nói về codebase của bạn, và đó là phép so sánh duy nhất dự đoán được tuần làm việc của bạn.


