
Bốn coding agent hoàn thành công việc trong cùng một giờ và mở ra bốn pull request. Một cái đụng đến luồng retry của hệ thống thanh toán, một cái đổi tên một test helper, một cái thêm migration, một cái sửa lỗi typo trong README. Nút thắt không nằm ở code hay test. Nó nằm ở câu hỏi mà một người phải trả lời trước khi đọc dù chỉ một dòng diff: tôi nên xem cái nào trước? Chúng tôi đã lập luận rằng review của con người là nút thắt một khi các agent chạy song song. Bài viết này bàn về phần cơ học của vấn đề đó, tức là việc sắp thứ tự hàng đợi, và cách một decision model như Jev có thể gỡ nó khỏi vai của người review mà không lấy đi chính việc review.
Jev là gì
Jev là một System One Model của TypeSafe AI: bạn gửi cho nó một piece of state và một tập câu hỏi có kiểu (typed questions), và nó trả về câu trả lời cho từng câu hỏi kèm xác suất đã được hiệu chỉnh, không bao giờ là free text. Để rõ ràng về cái tên, đây là Jev của TypeSafe, không phải YouTuber hay vắc-xin viêm não Nhật Bản. Bài đăng ra mắt của TypeSafe mô tả nó là "unstructured state in, typed probabilistic decisions out" (đầu vào là state phi cấu trúc, đầu ra là các quyết định xác suất có kiểu). API chỉ có một endpoint, POST https://api.typesafe.ai/v1/systemone, Bearer key, model jev-latest, ba loại câu hỏi: noul (xác suất có/không), choice (chọn một trong tối đa 255 lựa chọn), và score (một vị trí trên thang đánh giá từ 2 đến 10 mức). Chỉ nhận text, 64k token mỗi request với 32k dành cho state, $0.042 cho mỗi triệu input token, output không tính phí. Bài viết song song của chúng tôi về Jev như một decision layer cho coding agent bàn chung về model này; ở đây chúng tôi dùng nó cho một việc duy nhất.
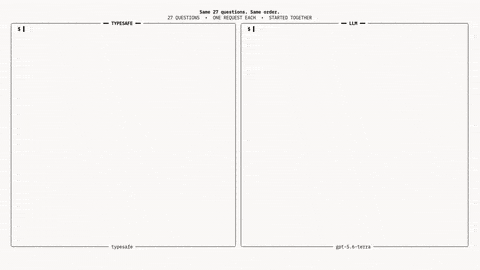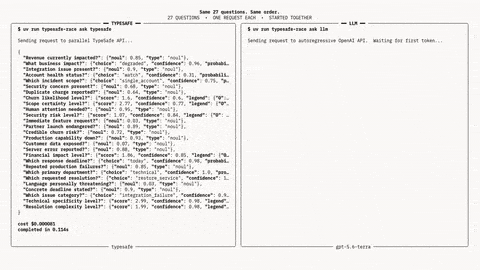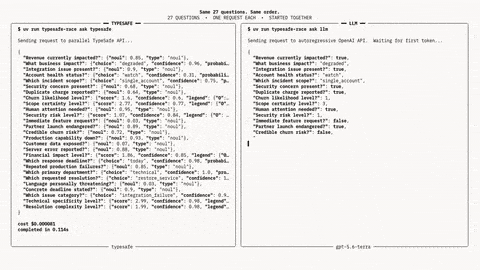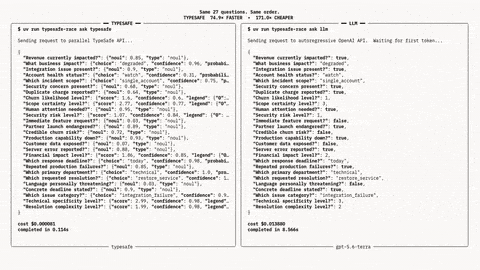
Ba câu hỏi review
Mỗi PR mà một coding agent mở ra đều đặt ra đúng ba câu hỏi, và mỗi câu ánh xạ tới một primitive. State thì giống nhau cho cả ba: một bản tóm tắt diff, kết quả test, và các đường dẫn bị đụng tới. Không phải toàn bộ diff. Một bản tóm tắt giữ cho call nằm trong ngân sách và giữ cho model trả lời câu hỏi định tuyến thay vì review lại code.
Cái này có cần người xem trước khi merge không? Một câu noul. Đây là bộ lọc. Nó quyết định liệu một PR có vào hàng đợi của con người hay không, hay chờ trong một làn ưu tiên thấp.
Reviewer nào hoặc hàng đợi nào? Một câu choice trên các hàng đợi mà team bạn thực sự vận hành. Câu trả lời mang theo lựa chọn cộng với toàn bộ phân phối, nên một tỉ lệ 0.48 / 0.44 giữa hai hàng đợi cho bạn biết PR này nằm vắt qua ranh giới ownership, và bản thân điều đó cũng đáng để biết.
Nó mang theo bao nhiêu rủi ro? Một câu score trên một thang đánh giá có thứ tự. Kết quả là một vị trí có trọng số xác suất, nên một thay đổi có thể nằm ở 2.6 giữa "thay đổi logic đã được test bao phủ" và "đụng tới auth, billing, hoặc data". Con số đó chính là khóa sắp xếp cho hàng đợi.
Một request trả lời cả ba:
{
  "model": "jev-latest",
  "state": {
    "task": "SH-418 Fix double charge on retried webhook",
    "diff_summary": "billing/retry.ts adds an idempotency key check; new test covers the retry path",
    "tests": "58 passed, 0 failed",
    "touched_paths": ["billing/retry.ts", "billing/retry.test.ts"]
  },
  "questions": {
    "needs_human": {
      "type": "noul",
      "instructions": "Does this change need a person to read it before merge?"
    },
    "queue": {
      "type": "choice",
      "instructions": "Which review queue owns this change?",
      "criteria": {
        "payments": "billing, invoicing, refunds, retries",
        "infra": "deploy, migrations, config",
        "frontend": "UI and client code",
        "docs": "documentation and comments only"
      }
    },
    "risk": {
      "type": "score",
      "instructions": "How much damage can this change do if it is wrong?",
      "criteria": ["cosmetic", "logic change covered by tests", "touches auth, billing, or data"]
    }
  }
}
Phản hồi là ba câu trả lời có kiểu dưới cùng các key. Với SH-418, hãy kỳ vọng needs_human gần 0.9, queue chọn payments, và risk gần đỉnh của thang đánh giá. Một bản sửa retry billing với test xanh vẫn đi thẳng lên đầu hàng đợi payments, bởi test xanh không trả lời được câu "liệu một người có nên đọc cái này không".
Các ngưỡng và mỗi dải làm gì
Một xác suất chỉ hữu ích khi code biến nó thành hành động. Các dải dưới đây là điểm khởi đầu, không phải khuyến nghị cho repository của bạn; hãy tinh chỉnh chúng sau một tuần chạy thử.
needs_human |
Hành động |
|---|---|
| 0.85 trở lên | Đầu hàng đợi của con người, sắp xếp theo risk giảm dần |
| 0.15 đến 0.85 | Hàng đợi của con người, sắp xếp theo risk, sau dải phía trên |
| dưới 0.15 | Làn ưu tiên thấp; vẫn có người merge, theo lịch riêng của họ |
Hai quy tắc giữ cho việc này trung thực. Thứ nhất, risk ở đỉnh thang đánh giá luôn đẩy một PR lên dải đầu, bất kể needs_human nói gì. Một model chỉ tự tin 0.12 rằng một schema migration cần review nghĩa là nó đã nhìn thấy một bản tóm tắt diff gọn gàng, chứ không phải môi trường production. Thứ hai, một câu choice mà hai lựa chọn hàng đầu nằm trong khoảng cách 0.1 đổ lại thì định tuyến tới cả hai hàng đợi, chứ không phải không hàng đợi nào. Sự mơ hồ về ownership là lý do để hai người liếc qua một thay đổi, chứ không phải để không ai làm.
Hãy để ý điều vẫn thuộc về con người trong mọi dải: việc merge. Các dải thay đổi thứ tự đọc và độ sâu khi đọc. Chúng không bao giờ thay đổi ai là người quyết định.
Dùng Jev cho hàng đợi, không phải cho phán quyết
Dùng Jev khi câu hỏi có một tập câu trả lời cố định, state là một bản tóm tắt trung thực, và bạn muốn dùng sự chú ý của con người theo một thứ tự tốt hơn: ai đọc cái này, sớm đến mức nào, ở hàng đợi nào. Những câu hỏi đó xuất hiện ở mọi PR và đủ rẻ ở mức giá này để hỏi trong mọi lần chạy.
Dùng một người, hoặc một language model có thể trình bày lập luận của nó, khi câu hỏi là liệu thay đổi có đúng hay không. Một xác suất rằng một thay đổi cần review không phải là một bản review. Jev không có compiler, không có test runner, và không có quyền truy cập vào file mà nó đang chấm điểm, chỉ có bản tóm tắt bạn gửi. Một con số 0.96 cho "an toàn để merge" là lý do mạnh để đưa PR đó lên đầu danh sách của ai đó, không bao giờ là lý do để bỏ qua ai đó. Cổng phê duyệt nằm sau model, và model không có cách nào mở nó.
Cộng đồng đã xây dựng những gì
Trong vòng vài ngày sau khi ra mắt, một developer đã công bố jev-review, mà README của nó mô tả là "a small code-review workflow built with TypeSafe Jev" (một workflow code-review nhỏ được xây bằng TypeSafe Jev). Nó review hoặc một Git diff hoặc cả một codebase, sàng lọc về tính đúng đắn, bảo mật, độ tin cậy, khả năng tương thích, và độ bao phủ test, chọn các vùng code trước khi chấm điểm impact, áp dụng các ngưỡng và policy workflow bằng code, và hiển thị kết quả trên một dashboard cục bộ. README rất cẩn thận về phạm vi: nó gọi dự án là "an experiment in composing fast typed judgments into a review workflow" và nói rằng nó "does not yet integrate compiler diagnostics, static analyzers, repository indexing, or generated explanations".
Có hai điều trong thiết kế đó đáng để sao chép: orchestration nằm trong code và Jev chỉ trả lời những câu hỏi có phạm vi giới hạn, và công việc được chia theo giai đoạn, chọn một vùng, rồi chấm điểm nó, thay vì một câu hỏi khổng lồ trên toàn bộ diff. Jev cũng có mặt trên Vercel AI Gateway dưới tên typesafe-ai/jev thông qua experimental_evaluate trong AI SDK 7; tài liệu Gateway lưu ý rằng tính năng này chỉ khả dụng qua AI SDK.
Điều này nằm ở đâu trong Sharkly
Sharkly không gọi Jev thay bạn, và nó không phải một decision model. Nó là lớp task, Computer, context, và review dùng chung quanh các coding agent mà team bạn đã vận hành. Điều một hàng đợi đã được xếp hạng cần từ lớp đó là một nơi để chạy và một nơi để đáp xuống.
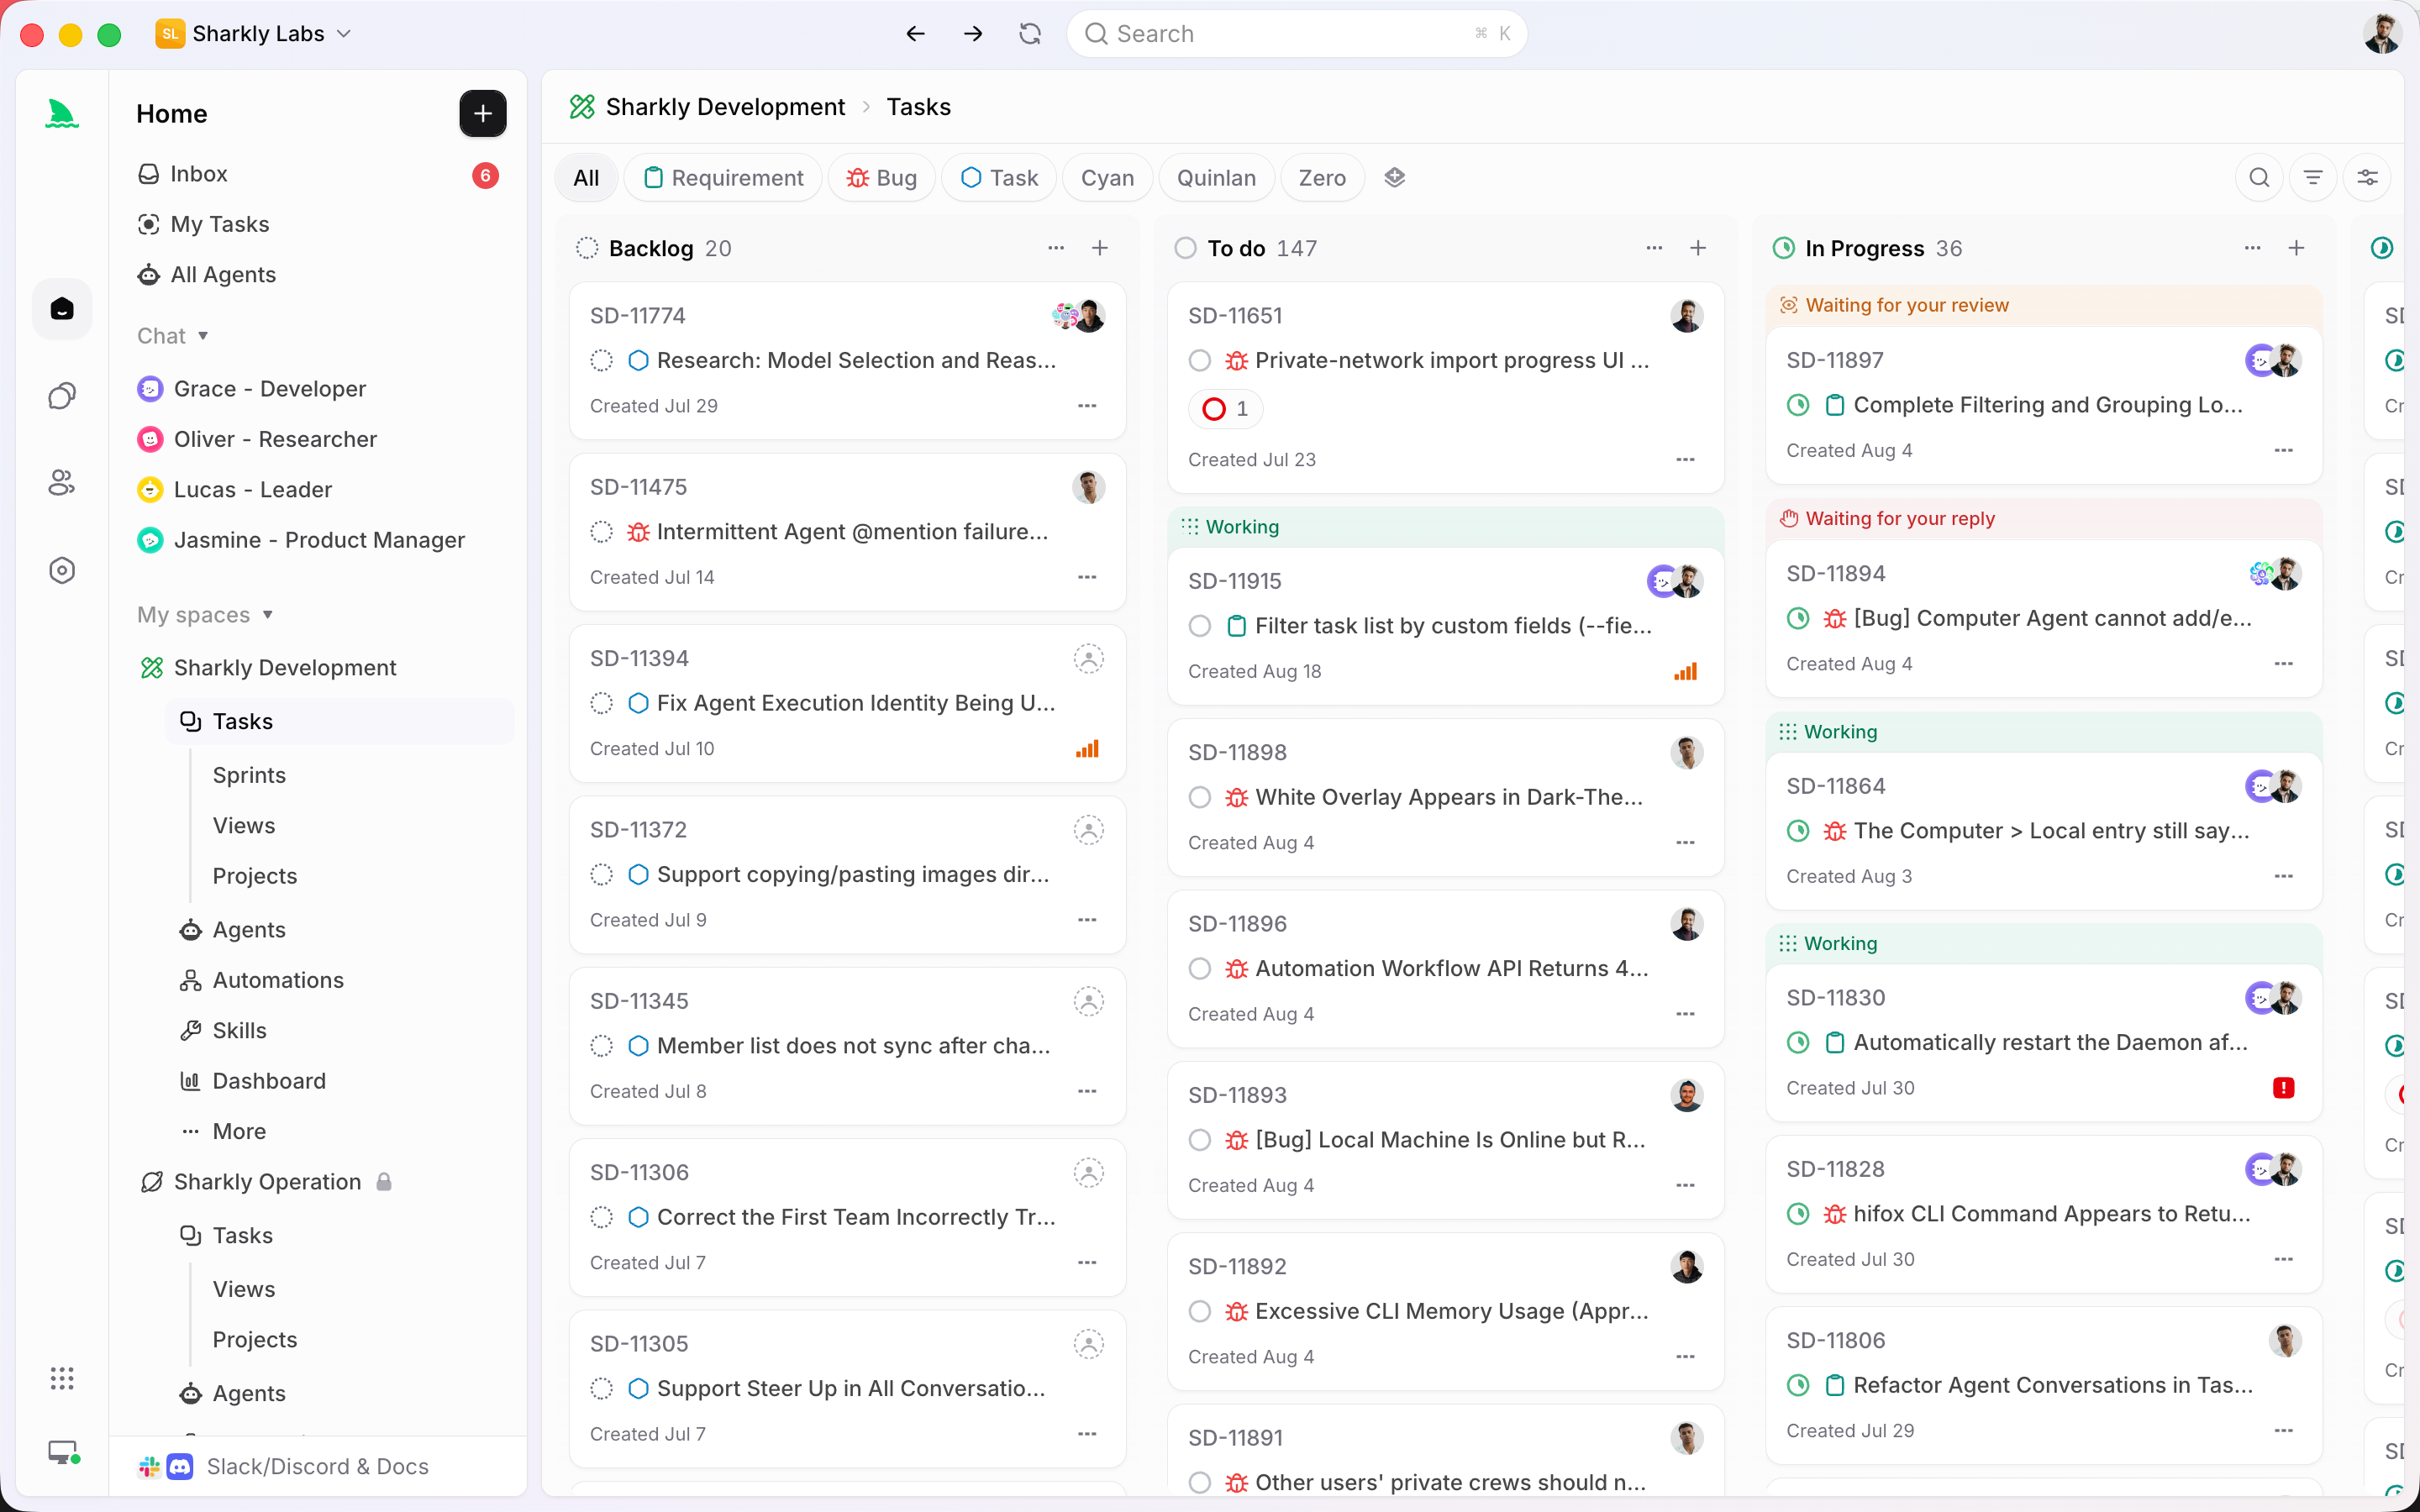
Nơi để chạy là một Automation: một quy tắc thuộc sở hữu của Space, khởi động một Agent với một tập hướng dẫn khi có trigger, và một trigger là khi một task chuyển sang một trạng thái đã chọn. Hãy trỏ nó vào trạng thái mà các Agent của bạn đạt tới khi một PR được mở, và phần hướng dẫn trở thành: đọc diff summary, kết quả test, và các đường dẫn bị đụng tới của Task; gọi Jev với ba câu hỏi; ghi các câu trả lời và dải vào lại dưới dạng một comment trên Task; đặt một label cho hàng đợi. Tài liệu nói rõ rằng một lần chạy đã hoàn thành "is not a promise that every downstream business outcome was correct" (không phải là lời hứa rằng mọi kết quả kinh doanh ở hạ nguồn đều đúng), đúng ranh giới mà các dải review cũng vạch ra.
Nơi để đáp xuống là chính Task. Dải, hàng đợi, và điểm rủi ro quay trở về Task nơi người review vốn đã nhìn, ngay cạnh phần tóm tắt thay đổi và kết quả xác minh của lần chạy. Một người mở board đã sắp theo rủi ro và thấy vì sao mỗi PR nằm ở vị trí của nó. Agent mở pull request, chạy test, và báo cáo. Con người đọc theo thứ tự mà hàng đợi gợi ý, rồi chấp nhận hoặc từ chối. Thứ tự đến từ một xác suất; quyết định thì không.
Nếu bạn đã chạy vài agent và hàng đợi review chính là chỗ đau đầu, thì đó là workflow mà bắt đầu với Sharkly thiết lập: một Computer, một Agent, một Task với bằng chứng mà việc xếp hạng cần.
FAQ
Jev có thể đọc toàn bộ diff thay vì một bản tóm tắt không?
Nó nhận tối đa 32k token state, nên một diff nhỏ thì vừa. Dù vậy hãy gửi một bản tóm tắt: diff của agent vượt xa ngân sách, và một bản tóm tắt giữ câu hỏi ở mức định tuyến. Toàn bộ diff là thứ con người đọc, cùng với bằng chứng ở cấp task bên cạnh.
Nếu chính agent viết bản tóm tắt diff thì sao?
Vậy thì bản tóm tắt có thể sai theo hướng có lợi cho agent, và việc xếp hạng kế thừa điều đó. Hãy ưu tiên một bản tóm tắt được tạo ra từ diff bởi một bước riêng, và luôn để một điểm risk ở mức cao nhất ghi đè một needs_human thấp. Những giới hạn của AI code review áp dụng ở đây: model có thể xếp hạng những gì nó được cho xem, nó không thể xác minh những gì nó không được cho xem.
Một dải thấp có nghĩa là PR tự động được merge không?
Không. Một dải thấp nghĩa là một người merge nó sau đó, theo lịch riêng của họ, mà không đọc nó trước trong hàng đợi. Quyền sở hữu việc merge, và cả công việc mà agent tạo ra, vẫn thuộc về một người được nêu tên trong mọi dải.
Jev có miễn phí qua Sharkly không?
Sharkly không bán lại Jev hay bất kỳ model nào; bạn tự mang TypeSafe hoặc Gateway key của mình, giống như cách các lần chạy tính phí dựa trên các subscription gắn với Runtimes của bạn. Bản thân Sharkly hiện đang miễn phí cho các tổ chức tối đa 5 người.


