
Tóm tắt nhanh: Đội ngũ AI agent của OpenAI đã rà soát 5.034 mục tiêu kiểm thử trong nhân Linux và tạo ra 948 mã khai thác leo thang đặc quyền cục bộ (LPE) riêng biệt với chi phí khoảng 1,2 triệu USD tín dụng API, sau đó các chuyên gia bảo mật đã tiến hành đánh giá lại kết quả. Bạn hoàn toàn có thể áp dụng mô hình này cho mã nguồn của mình: các agent khảo sát những điểm có thể tiếp cận, phân tích, kiểm chứng độc lập từng phát hiện rồi phác thảo bản vá, cuối cùng con người sẽ phê duyệt.
Vào ngày 4 tháng 11 năm 2026, OpenAI đã công bố bài viết “A thousand fewer paths to root”. Tiêu đề bài viết nêu bật con số 948 mã khai thác trên Linux. Nhưng bài học cốt lõi dành cho các đội ngũ phát triển phần mềm lại nằm ở tầng sâu hơn: kết quả này đến từ các agent chuyên biệt hoạt động theo từng giai đoạn, mỗi giai đoạn chuyển giao bằng chứng xác thực cho giai đoạn tiếp theo, và chốt chặn cuối cùng là con người.
Mô hình thiết kế này không phụ thuộc vào kiến thức chuyên sâu về kernel, vì vậy bạn hoàn toàn có thể áp dụng cấu trúc tương tự cho các dịch vụ của chính mình. Tính cấp bách là có thật: OpenAI cho biết quy trình này mang lại “lợi nhuận ròng” khi so sánh với mức tiền thưởng bug bounty công khai. Giới tấn công cũng hoàn toàn có thể làm bài toán kinh tế đó, vì vậy hãy bắt đầu ngay từ bây giờ.
Những phát hiện của đội ngũ AI agent tại OpenAI
OpenAI đã vận hành quy trình này vào giữa tháng 10 năm 2026 trên phiên bản nhân Linux mới nhất, sử dụng một mô hình chuyên về an ninh mạng sắp ra mắt. Các mục tiêu thử nghiệm là những máy ảo (VM) cô lập chạy hệ điều hành máy bàn mặc định với đầy đủ các cơ chế bảo vệ tiêu chuẩn được bật.
| Giai đoạn | Kết quả | Chi phí API |
|---|---|---|
| Khảo sát (Scout) | 5.034 mục tiêu kiểm thử, khoảng 2,8 triệu dòng mã, chiếm khoảng 7% nhân Linux | $3,426 |
| Phân tích | 2.308 phát hiện tiềm năng | $316,549 |
| Kiểm chứng | Tái hiện thành công 1.724 lỗi (khoảng 74,7%) | $73,330 |
| Đánh giá khả năng khai thác | 948 mã khai thác LPE riêng biệt, 291 PoC rò rỉ thông tin | $820,123 |
| Tổng cộng | $1,213,430 |
Đây là những số liệu ở quy mô nhân hệ điều hành của OpenAI, chứ không phải con số ước tính cho kho mã nguồn (repo) của bạn. OpenAI gọi chi phí của họ “thiên về mức chặn trên” vì mục tiêu của thử nghiệm là đo lường năng lực chứ không phải tối ưu hiệu quả chi phí.
Cần lưu ý ba giới hạn sau:
- Đây là các lỗ hổng leo thang đặc quyền cục bộ (LPE). Kẻ tấn công trước hết phải chiếm được quyền truy cập cục bộ trên hệ thống. Bản thân chúng không phải là các mã khai thác từ xa (remote exploit).
- Nhiều lỗ hổng vẫn chưa được vá. Khi đợt quét và phân tích kéo dài 10 ngày kết thúc, mới có 61 lỗi LPE được vá ở nhánh upstream, 43 lỗi có bản vá đang thử nghiệm (staging) và 299 lỗi đang được thảo luận công khai. OpenAI đã gửi hàng trăm báo cáo và bản vá cho các lỗi nghiêm trọng, đồng thời đang tiếp tục gửi dần phần còn lại cùng các đối tác trong chương trình Patch the Planet.
- Bài viết của OpenAI không đề cập đến việc những lỗ hổng này bị khai thác trên thực tế.
Khuyến nghị của OpenAI rất thẳng thắn. Trên một hệ điều hành chưa được cập nhật các bản vá mới nhất, họ cho rằng một tài khoản đặc quyền thấp “nên được xem là có chức năng tương đương với quyền truy cập root đối với một tác nhân đe dọa có đủ nguồn lực”. Do đó, hãy cập nhật bản vá kịp thời và thu hẹp phạm vi ảnh hưởng với các giải pháp cô lập như Firecracker và gVisor.
Năm giai đoạn trong quy trình bảo mật bằng AI agent
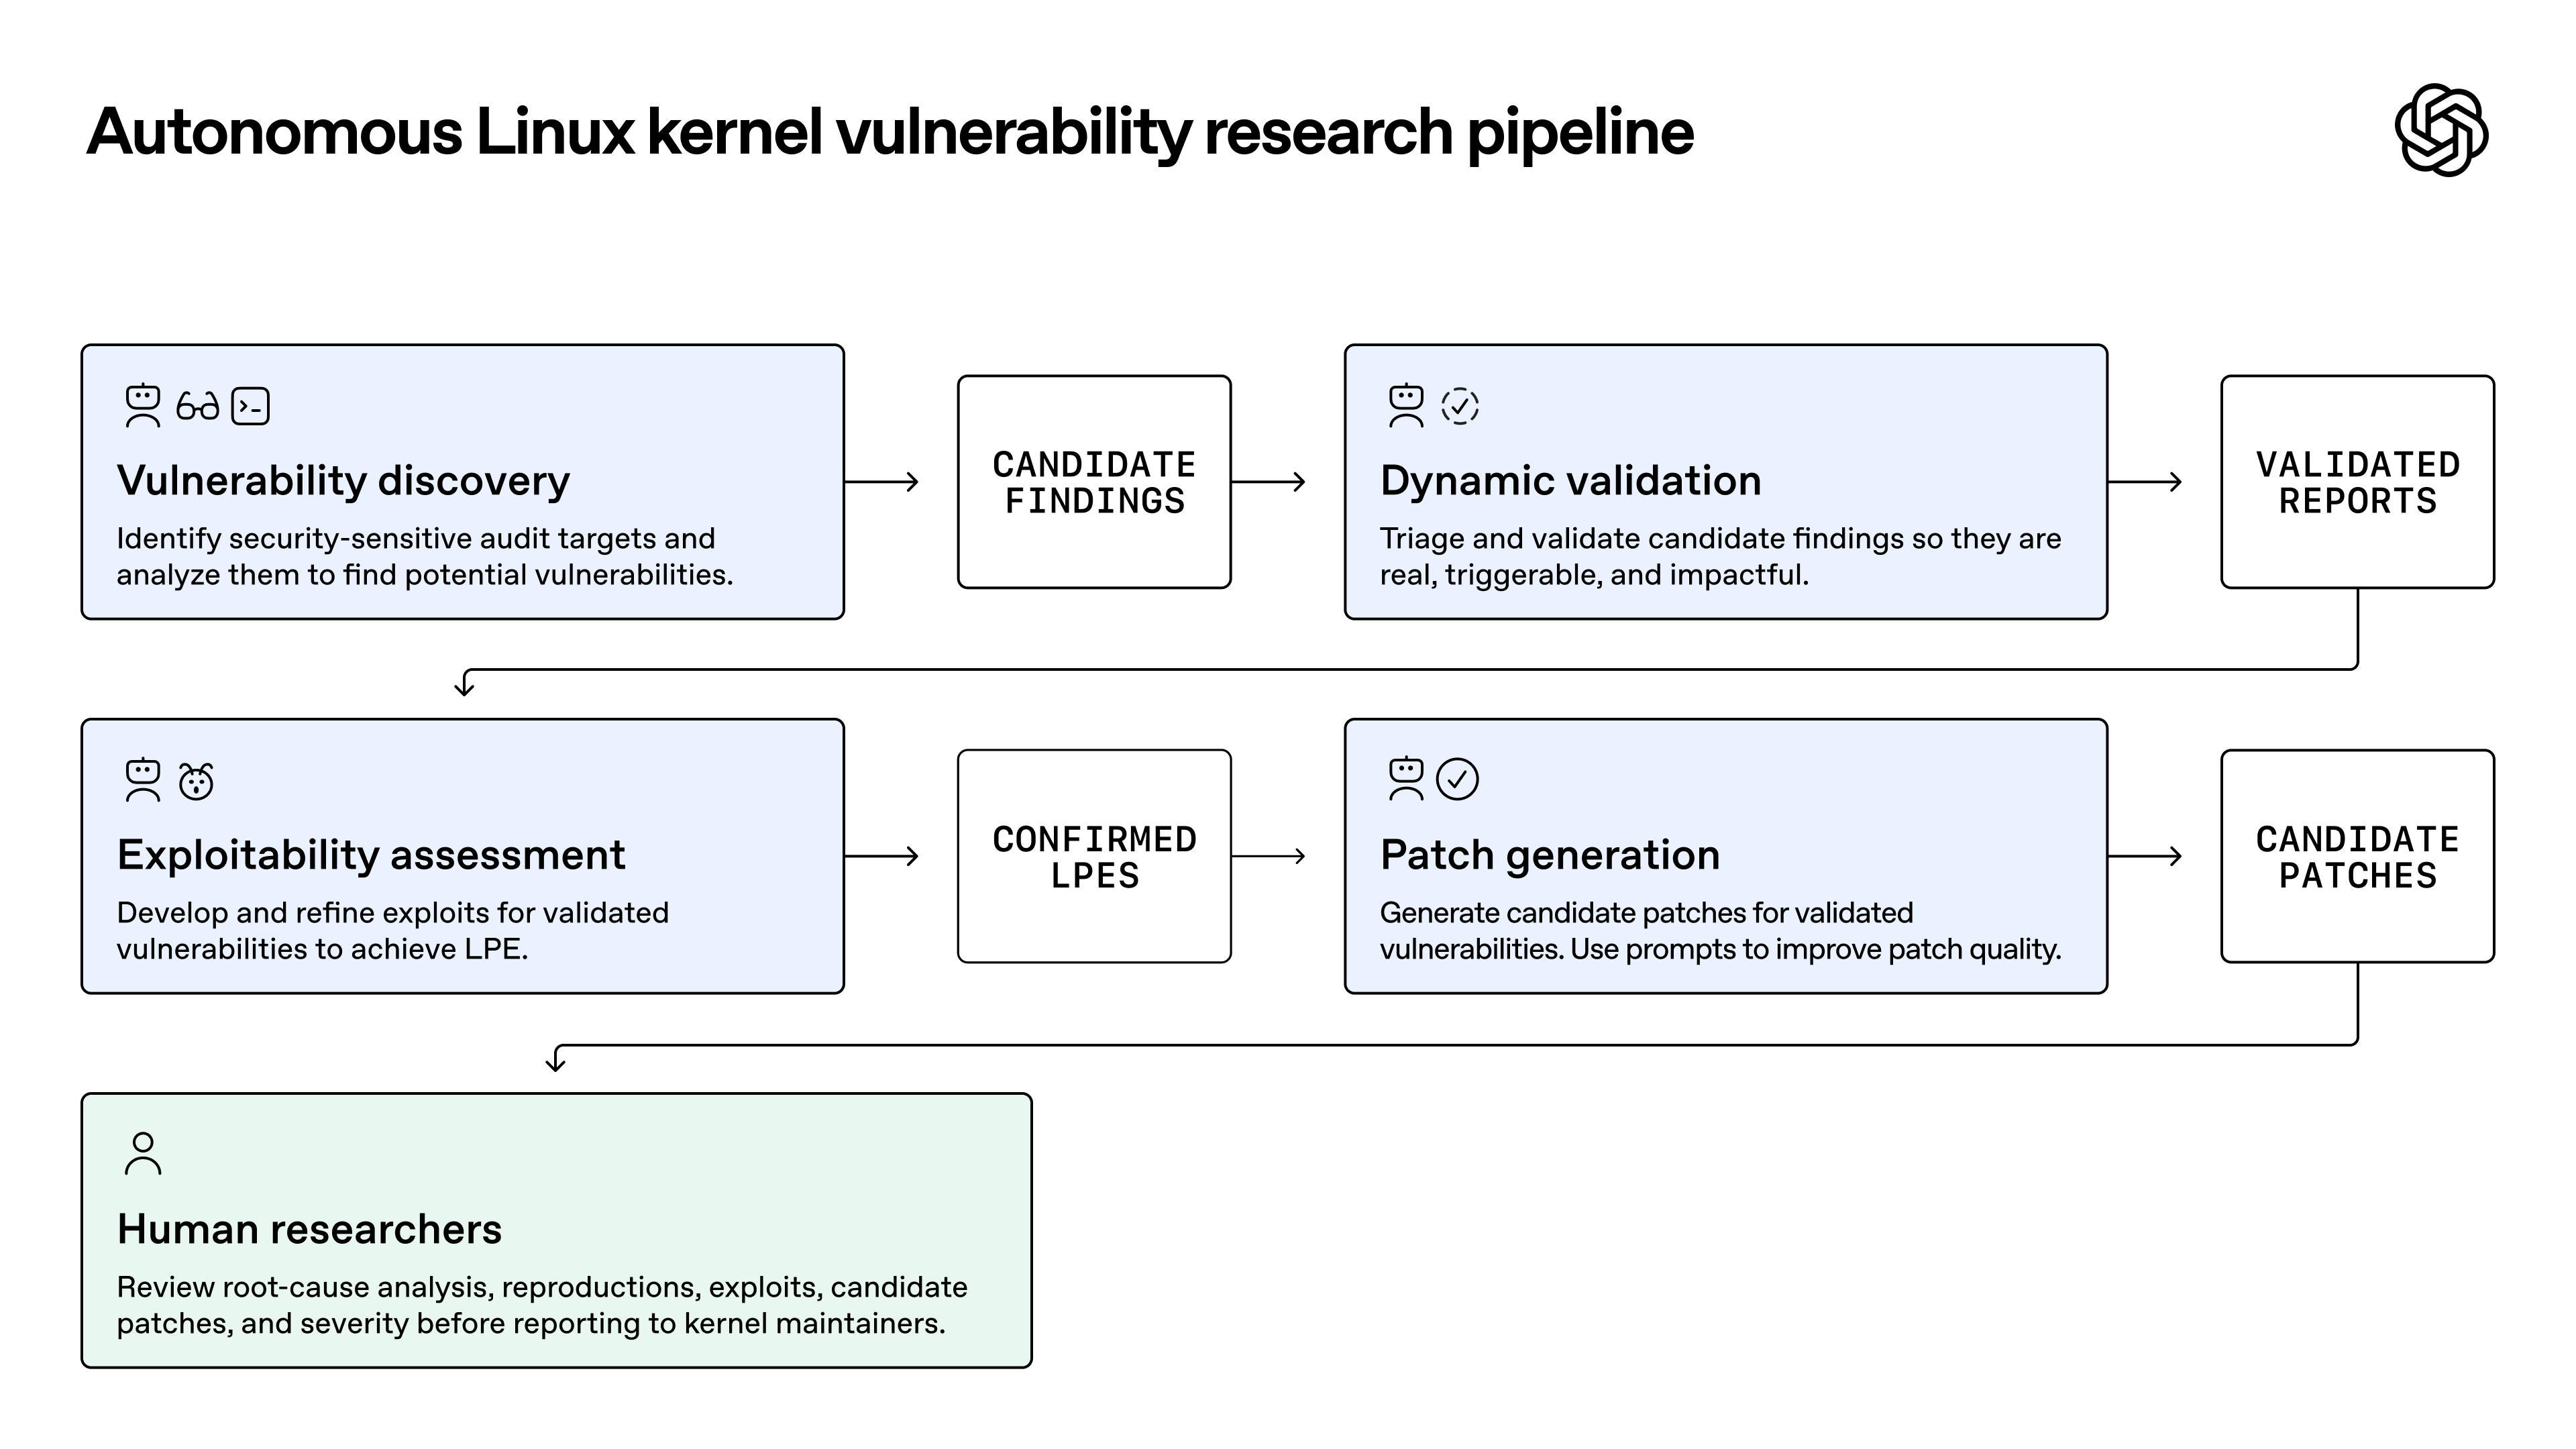
Một quy trình bảo mật sử dụng AI agent chia việc rà soát thành nhiều giai đoạn, trong đó mỗi giai đoạn sẽ thu hẹp phạm vi công việc và tạo ra bằng chứng xác thực cho giai đoạn tiếp theo. Phiên bản của OpenAI gồm năm bước:
- Khám phá (Discovery). Các agent khảo sát (Scout agent) chọn mục tiêu kiểm thử dựa trên khả năng tiếp cận và mức độ liên quan đến bảo mật. Các agent phân tích (Analyst agent) đọc từng mục tiêu, xây dựng mô hình đe dọa (threat model) và báo cáo các phát hiện tiềm năng.
- Kiểm chứng động (Dynamic validation). Các agent phân loại (Triage agent) viết mã kiểm chứng khái niệm (PoC) và chạy thử trong một VM cô lập có bật KASAN—công cụ phát hiện lỗi bộ nhớ nhân—rồi tinh chỉnh cho đến khi tái hiện được lỗi hoặc cạn kiệt phương án.
- Đánh giá khả năng khai thác (Exploitability assessment). Một agent sàng lọc sẽ loại bỏ những phát hiện không có đường dẫn khả thi. Các agent phát triển khai thác (ExploitDev agent) sẽ thử nghiệm các trường hợp còn lại.
- Tạo bản vá (Patch generation). Các agent phác thảo bản vá cho từng lỗi đã được kiểm chứng, tuân thủ quy ước mã nguồn xung quanh và kiểm tra các biến thể liên quan.
- Chuyên gia đánh giá (Human review). Các nhà nghiên cứu bảo mật xem xét kỹ mã khai thác, bản vá và mức độ nghiêm trọng trước khi gửi bất cứ thông tin nào cho đội ngũ duy trì dự án (maintainer).
Mỗi lần bàn giao giữa các bước đều đi kèm bằng chứng xác thực chứ không phải suy đoán chủ quan, nhờ đó người đưa ra quyết định cuối cùng có thể căn cứ vào các dữ kiện thực tế.
Cách áp dụng từng giai đoạn vào kho mã nguồn của bạn
Chỉ áp dụng quy trình này trên mã nguồn mà bạn sở hữu hoặc được cấp quyền kiểm thử. Đối với repo của riêng bạn, hãy bỏ hẳn giai đoạn xây dựng mã khai thác. Một ca kiểm thử thất bại (failing test) đã đủ để chứng minh khiếm khuyết mà không cần phải tạo ra công cụ tấn công.
| Giai đoạn của OpenAI | Phiên bản của bạn | Đầu ra |
|---|---|---|
| Scout | Liệt kê các điểm truy cập (entry point) mà người dùng ẩn danh hoặc có đặc quyền thấp có thể chạm tới: routes, webhooks, uploads, parsers, queue consumers | Danh sách kiểm thử |
| Analyst | Mỗi lượt chạy một mục tiêu: đọc code, viết mô hình đe dọa ngắn gọn, báo cáo các lỗi khả nghi | Các phát hiện tiềm năng |
| Validate | Viết một bài kiểm thử thất bại tối thiểu trong môi trường dùng một lần (disposable environment) | File kiểm thử kèm log |
| Assess | Đánh giá mức độ ảnh hưởng dựa trên ranh giới tin cậy (trust boundary) bị vượt qua | Mức độ nghiêm trọng kèm lý do |
| Patch | Phác thảo bản sửa lỗi dưới dạng một pull request có kèm bài kiểm thử | Pull request |
| Human | Rà soát, sau đó hợp nhất (merge) hoặc từ chối | Bản sửa lỗi đã merge hoặc phát hiện được đóng lại |
Việc thu hẹp phạm vi mang lại hiệu quả kinh tế rõ rệt. Giai đoạn khảo sát của OpenAI chỉ tiêu tốn 3.426 USD nhưng đã thu gọn phạm vi kiểm thử xuống còn khoảng 7% nhân Linux. Hãy bắt đầu với một dịch vụ duy nhất và các điểm truy cập công khai của nó. Yêu cầu (task) dành cho một phát hiện có thể ngắn gọn như sau:
Title: Validate finding: path traversal in /api/exports/download

Scope: this repository only. Disposable test environment only.
No production credentials, no external network targets.

Goal: write a minimal failing test that proves or disproves the finding.
Evidence: test file, command output, code path from entry point to flaw.
Give up: stop after two approaches with no new evidence. Report what you tried.
Do not: fix the bug here, build an attack payload, or merge anything.
Xác minh đường dẫn, không chỉ dừng lại ở kết quả
Trong một lượt chạy thử nghiệm ban đầu, giai đoạn khai thác của OpenAI đã báo cáo 200 trường hợp thành công. Khi con người rà soát lại, họ phát hiện 20 trường hợp trong số đó chiếm được quyền root thông qua một lỗ hổng 0-day hoàn toàn khác với lỗ hổng được phân công. Hệ thống đã ghi nhận thành công dựa trên kết quả đầu ra, và kết quả đó đúng nhưng lại do nguyên nhân sai.
OpenAI đã thắt chặt các ràng buộc của nhiệm vụ và bổ sung thêm bước kiểm tra độc lập để đảm bảo mỗi mã khai thác đều sử dụng đúng lỗ hổng được chỉ định. Bài học rút ra: cần xác minh lộ trình dẫn đến kết quả chứ không chỉ nhìn vào bản thân kết quả.
Trường hợp tương tự ở phía bạn cũng rất quen thuộc: một agent khẳng định bài kiểm thử của nó chứng minh được lỗi xác thực, nhưng thực tế bài kiểm thử lại thất bại chỉ vì thiếu dữ liệu mẫu (fixture). Hãy thêm một agent kiểm tra độc lập—agent không trực tiếp viết bài test đó—và đặt cho nó một câu hỏi duy nhất: lỗi thất bại này có thực sự xuất phát từ luồng mã nguồn (code path) đã được báo cáo hay không?
Kiểm chứng sớm, vì báo động giả cũng tốn kém không kém
OpenAI nhận thấy rằng chi phí để xác thực một lỗi thực sự (true positive) và một báo động giả (false positive) là gần như tương đương. Do đó, mỗi phát hiện sai lọt vào giai đoạn kiểm chứng đều ngốn trọn vẹn chi phí của một lượt chạy.
Hãy lọc kỹ trước khi tiến hành kiểm chứng. OpenAI chỉ kiểm chứng những phát hiện mà người dùng đặc quyền thấp có thể tiếp cận, không đòi hỏi các quyền hạn đặc biệt và có thể tạo ra bằng chứng đo lường được. Hãy thiết lập các cổng kiểm soát (gate) tương tự cho mã nguồn của bạn, chẳng hạn như “có thể truy cập mà không cần quyền quản trị”. Những phát hiện không vượt qua được cổng này sẽ bị đóng lại kèm theo lý do cụ thể.
Sau đó, hãy đối chiếu lại các phát hiện với phiên bản mã nguồn mới nhất trước khi báo cáo, đúng như khuyến nghị của OpenAI, nhằm tránh các báo cáo trùng lặp hoặc đã lỗi thời.
Thiết lập quy tắc dừng cuộc chơi trước khi bắt đầu chạy
Những lần thử thất bại mới chính là thủ phạm ngốn nhiều chi phí nhất. Đối với các ứng viên LPE, 69 lần thất bại tiêu tốn trung bình 3.922 USD cho mỗi lần, trong khi 1.169 lần thành công chỉ tốn trung bình 360 USD. Theo tính toán của chúng tôi, chỉ khoảng 6% số lần thử đã chiếm tới khoảng 39% trong tổng số 691.000 USD chi cho giai đoạn đó.
Giải pháp do OpenAI đề xuất là đặt ra điều kiện dừng (give-up condition), chẳng hạn như tự động dừng sau một giờ nếu không có tiến triển mới. Hãy đưa quy tắc đó vào yêu cầu của nhiệm vụ, đồng thời thiết lập giới hạn cứng (hard limit) cho mỗi lượt chạy.
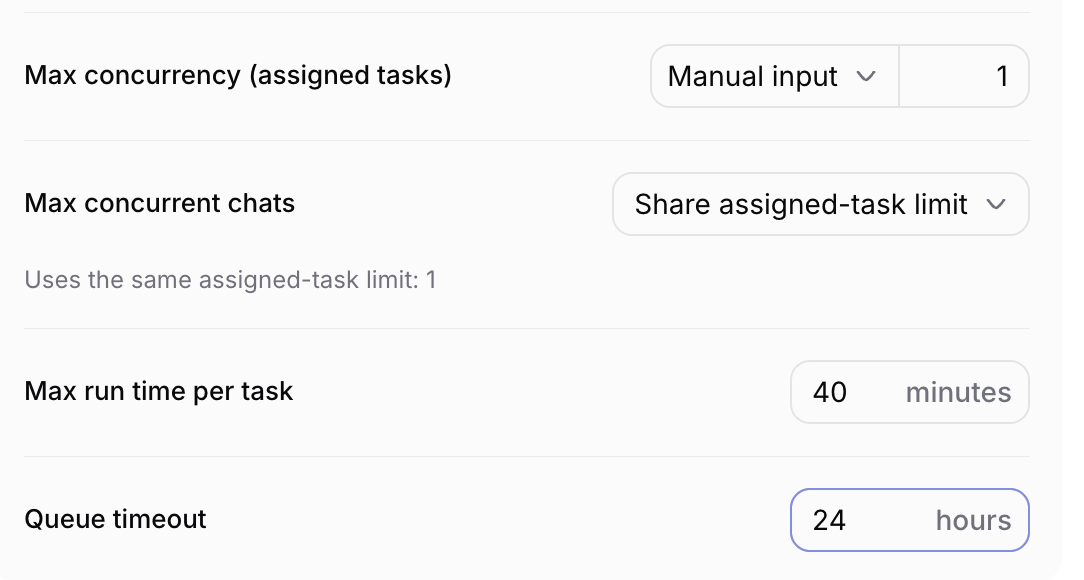
Trong Sharkly, thời gian chờ tối đa (timeout) cho mỗi Task nằm ở mục Run settings của Agent. Đây là giới hạn về mặt thời gian chứ không phải bộ phát hiện tiến độ, vì vậy hãy giữ nguyên quy tắc “dừng lại nếu không có bằng chứng mới” trong phần hướng dẫn chỉ thị.
Giữ cấu trúc điều phối gọn nhẹ khi các mô hình ngày càng thông minh hơn
OpenAI từng xây dựng một tầng hướng dẫn gồm 103 kỹ thuật khai thác dành riêng cho GPT-5.5 Cyber, giúp nâng tỷ lệ thành công từ 76,2% lên 88,9%. Tuy nhiên, tầng kỹ thuật tương tự chỉ giúp GPT-5.6 Cyber tăng thêm khiêm tốn 1,5 điểm phần trăm, do đó OpenAI đã loại bỏ nó.
Hãy kiểm thử lại bộ khung điều phối (scaffolding) của bạn mỗi khi đổi mô hình. Đồng thời hãy quét lại định kỳ: đợt chạy vào tháng 10 đã phát hiện số lượng lỗ hổng LPE mới gấp hơn 5 lần so với đợt chạy hồi tháng 7 bằng GPT-5.6 Sol, ngay trên cùng một khối mã nguồn đã trải qua thêm 3 tháng gia cố bảo mật.
Luôn duy trì bước rà soát của con người trước khi phát hành
Các agent sẽ phác thảo bản sửa lỗi dưới dạng pull request. Con người sẽ là người phê duyệt hợp nhất (merge). OpenAI nhận thấy các bản vá ở lượt đầu tiên có thể cồng kềnh hơn mức cần thiết, bỏ sót các biến thể hoặc vi phạm quy ước lập trình, và việc cho agent rà soát lại nhiều lượt sẽ giúp cải thiện chất lượng bản vá.
OpenAI cũng khuyến nghị sử dụng các mô hình để rà soát đối kháng (adversarial review) cho cả bản vá do con người lẫn AI tạo ra. Hãy để một agent tìm cách vượt qua (bypass) bản vá, sau đó để con người đưa ra quyết định cuối cùng. Nếu quy trình rà soát vốn đã là nút thắt cổ chai của đội ngũ, hãy đọc bài viết cách thiết kế quy trình rà soát cho các agent chạy song song trước khi bổ sung thêm một luồng pull request mới.
Cách vận hành quy trình dưới dạng Task trong Sharkly
Task là đơn vị công việc chính trong Sharkly. Dưới đây là một cách để xây dựng quy trình này:
- Tạo loại nhiệm vụ (task type). Một task type quản lý một Workflow gồm các trạng thái có thứ tự. Một loại nhiệm vụ có tên “Security finding” có thể trải qua các trạng thái: Candidate, Reproduced, Patch drafted, In review, Closed.
- Tạo một Crew. Một Crew là một nhóm cộng tác tái sử dụng được gồm Con người và các Agent do một Agent trưởng nhóm điều phối. Hãy thêm các Agent khảo sát (scout), phân tích (analyst), kiểm tra (check) và vá lỗi (patch). Trưởng nhóm sẽ khởi động trước và gọi tên (mention) các thành viên để thực hiện phần việc cụ thể.
- Cô lập các lượt chạy. Sử dụng một thư mục tạm thời để mỗi Task có một worktree riêng biệt, và tham khảo hướng dẫn về worktree cô lập nếu bạn đang mở rộng quy mô chạy song song. Tắt tùy chọn thư mục dùng chung của Crew ở những khâu mà Agent kiểm tra cần tính độc lập.
- Tự động hóa các bước bàn giao. Một thiết lập Automation với bộ kích hoạt trạng thái nhiệm vụ có thể tự động khởi chạy Agent vá lỗi khi Task chuyển sang trạng thái Reproduced. Các lượt chạy này hoàn toàn tự động và không thể đặt câu hỏi tương tác, đồng thời việc khớp trạng thái áp dụng trên toàn tổ chức, vì vậy hãy thiết lập chỉ thị để xác thực lại Task kích hoạt.
- Liên kết pull request. Với tính năng tích hợp GitHub, ID của nhiệm vụ nằm trong tên nhánh, tiêu đề hoặc mô tả sẽ tự động liên kết với pull request tương ứng. Việc merge mã nguồn không làm thay đổi trạng thái của nhiệm vụ, vì vậy người rà soát sẽ là người đóng Task.
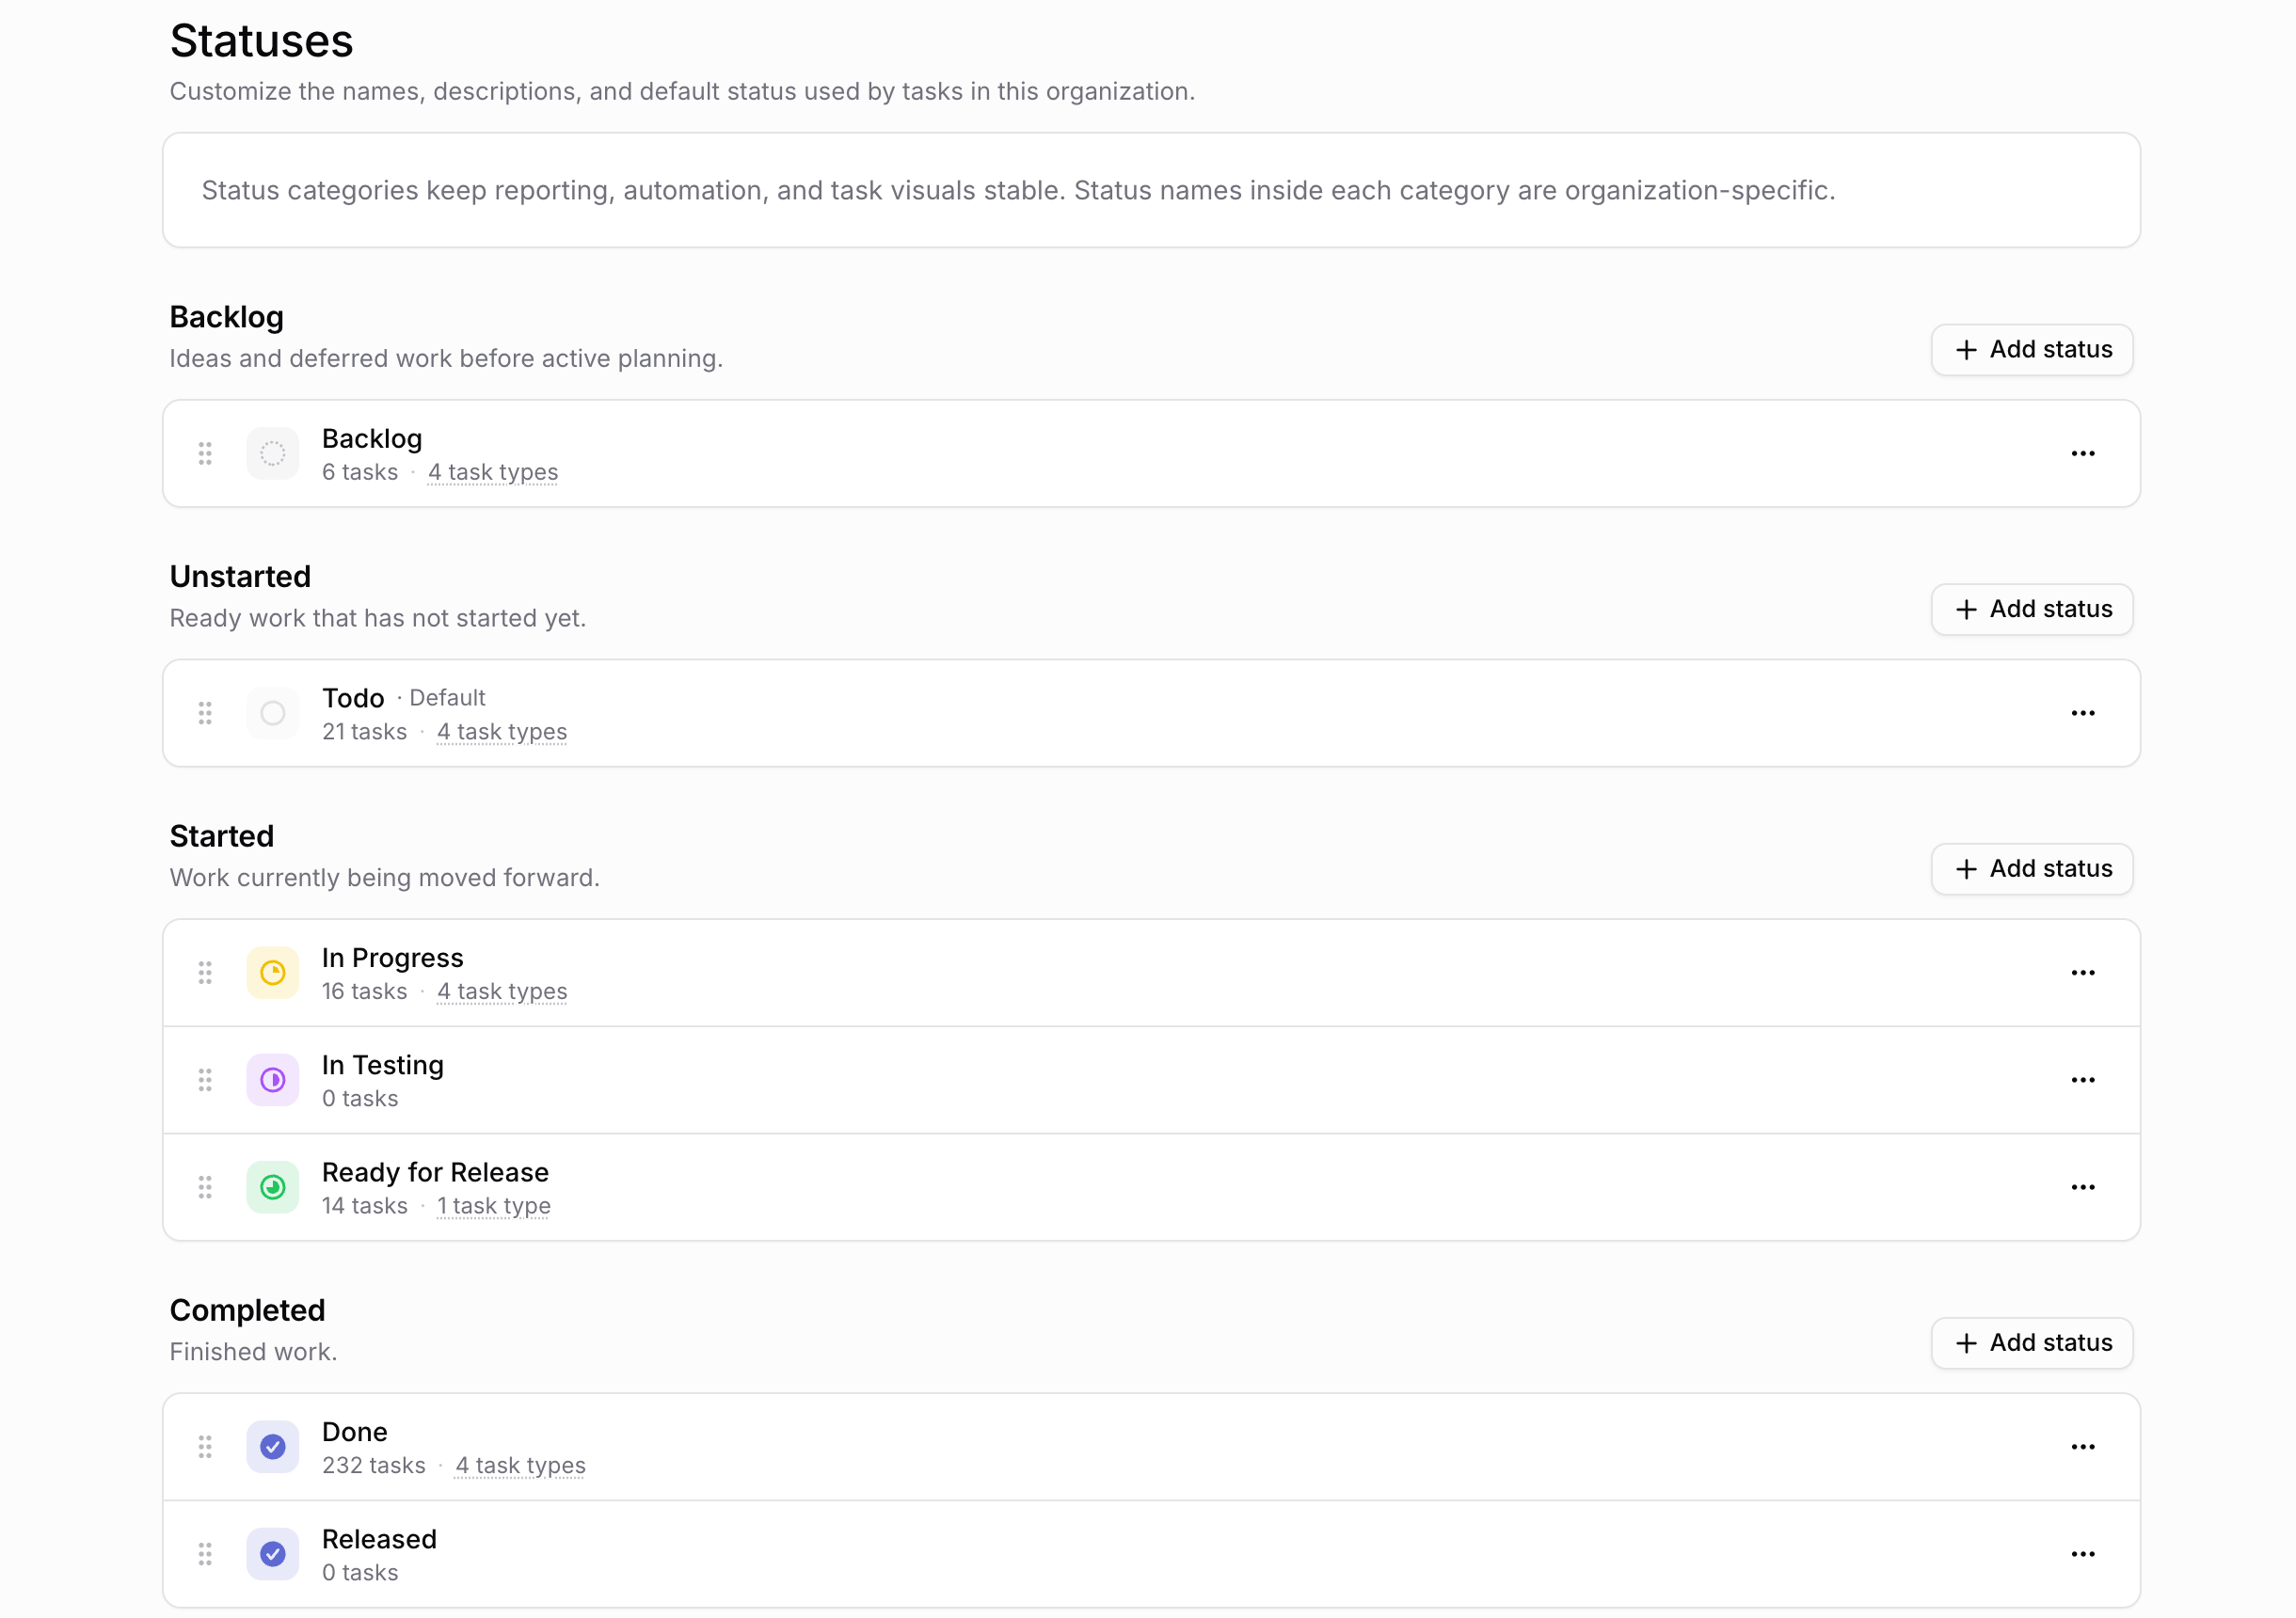
Các trạng thái được chia sẻ trong toàn bộ Tổ chức, vì vậy hãy tạo thêm trạng thái mới cho quy trình này thay vì đổi tên các trạng thái hiện có.
Có một ranh giới quan trọng cần lưu ý: worktree giúp các Task không bị xung đột mã nguồn, nhưng nó không phải là sandbox bảo mật. Hãy chạy các bài kiểm thử tái hiện lỗi trong một container hoặc VM dùng một lần không chứa bất kỳ thông tin bí mật (secret) nào của môi trường production, đồng thời cấp cho các Agent quyền truy cập Git ở mức tối thiểu cần thiết.
Sharkly đảm nhận việc điều phối quy trình này. Claude Code, Codex và các công cụ tương tự sẽ trực tiếp thực thi, và việc sử dụng mô hình vẫn thông qua các gói đăng ký hoặc API key được cấu hình trong các công cụ đó. Nếu bạn đang muốn mở rộng quy mô, hãy tham khảo cách vận hành 10 AI coding agent cùng lúc.
Đối với một repo nhỏ, bạn chỉ cần gán một Agent cho một Task và có thể bỏ qua phần thiết lập Crew. Hãy sử dụng Crew khi cần một trưởng nhóm điều phối tuần tự nhiều vai trò khác nhau và tổng hợp kết quả về lại một Task duy nhất.
Lời kết
Kết quả của OpenAI là một bản thiết kế mẫu giá trị cho đội ngũ của bạn: thu hẹp phạm vi, yêu cầu bằng chứng xác thực ở mỗi khâu bàn giao, kiểm tra lộ trình thực thi, dừng sớm các lượt chạy không hiệu quả và luôn để con người giữ quyền nhấn nút merge.
Hãy bắt đầu ngay trong tuần này. Chọn một dịch vụ do bạn quản lý, liệt kê các điểm truy cập công khai của nó và tạo một Task kiểm chứng cho mỗi lỗ hổng khả nghi. Hướng dẫn khởi đầu nhanh của Sharkly sẽ giúp bạn chạy Agent đầu tiên trên một Computer đã kết nối, và sharkly.ai sẽ cho bạn thấy cách tầng quản lý nhiệm vụ và rà soát kết hợp hài hòa với các agent của bạn.
Câu hỏi thường gặp (FAQ)
Các agent của OpenAI có tấn công các hệ thống Linux đang hoạt động thực tế không?
Không. Các mã khai thác chỉ chạy trong các máy ảo cô lập thuộc một môi trường nghiên cứu được kiểm soát, và các chuyên gia bảo mật đã rà soát kỹ kết quả trước khi báo cáo.
Cả 948 lỗ hổng Linux này đã được vá hết chưa?
Chưa. Nhiều lỗ hổng vẫn đang trong quá trình báo cáo và vá lỗi. Tại thời điểm kết thúc đợt quét kéo dài 10 ngày, mới có 61 lỗi được vá ở upstream và 43 lỗi có bản vá thử nghiệm (staging).
Các mã khai thác này có thể tấn công chiếm quyền máy chủ từ xa không?
Bản thân chúng không thể làm được điều đó. Đây là các lỗ hổng leo thang đặc quyền cục bộ, vì vậy kẻ tấn công trước tiên phải có được quyền truy cập cục bộ trên hệ thống. Hãy luôn cập nhật bản vá cho hệ thống và cô lập các khối lượng công việc không đáng tin cậy.
Quy trình này sẽ tiêu tốn bao nhiêu chi phí trên repo của tôi?
Các con số của OpenAI không thể áp dụng trực tiếp cho dự án của bạn, vì chúng dành cho quy mô của toàn bộ nhân hệ điều hành. Hãy bắt đầu với một dịch vụ, thiết lập giới hạn cho các lượt chạy và đo lường chi phí trên mỗi phát hiện đã được kiểm chứng.
Tôi có nhất thiết phải dùng mô hình bảo mật của OpenAI không?
Hiện tại bạn cũng chưa thể sử dụng mô hình này vì OpenAI cho biết nó vẫn chưa chính thức ra mắt. Các giai đoạn trong quy trình hoàn toàn không phụ thuộc vào bất kỳ mô hình cụ thể nào, vì vậy bạn có thể thử nghiệm ngay với các coding agent mà đội ngũ của bạn đang sử dụng và đánh giá kết quả dựa trên các bằng chứng thu thập được.


