
Tóm tắt nhanh (TL;DR)
Vòng lặp lên kế hoạch, quan sát, xác minh (plan, observe, verify loop) là phương pháp vận hành coding agent, trong đó mỗi bước của kế hoạch đều đi kèm một tiêu chí kiểm tra riêng. Agent sẽ hành động, quan sát bằng chứng thực tế (kết quả test, diff, bản build), đối chiếu bằng chứng đó với tiêu chí kiểm tra của bước hiện tại, và lập lại kế hoạch khi có bước thất bại. Một tác vụ chỉ được coi là hoàn thành khi nó vượt qua khâu kiểm tra và được người đánh giá (reviewer) phê duyệt.
Tính đến ngày 29 tháng 10 năm 2026, ví dụ công khai rõ ràng nhất về vòng lặp này đang vận hành bên trong Genie 4 của Google DeepMind, vừa được công bố vào ngày 27 tháng 10 năm 2026. Google đã tích hợp Gemini 3.8 Flash vào vòng lặp để chia nhỏ mục tiêu thành từng bước, theo dõi từng khung hình mới và xác minh từng bước trước khi tiếp tục. Các coding agent của bạn cũng cần tính kỷ luật tương tự, và bài viết này sẽ hướng dẫn bạn cách xây dựng quy trình đó bằng chính những công cụ bạn đang sử dụng.
Nếu bạn đã có các coding agent, Sharkly sẽ biến chúng thành một nhóm làm việc hoàn chỉnh, mang đến một không gian chung nơi bằng chứng từ mỗi lần chạy được tổng hợp về Task để tiến hành review.
Genie 4 của Google DeepMind thực hiện những gì trong vòng lặp agent?
Genie 4 là mô hình thế giới (world model) mới của Google DeepMind: nó có khả năng tạo ra một thế giới chân thực, có tính tương tác theo thời gian thực cùng âm thanh sống động. Tuy nhiên, điều quan trọng nhất đối với các coding agent chính là agent mà Google đã tích hợp vào hệ thống này. Trong thông báo ra mắt Genie 4, Google cho biết Gemini 3.8 Flash “liên tục quan sát khung cảnh, chia nhỏ mục tiêu thành một chuỗi các bước, đồng thời xem xét các khung hình tiếp theo để theo dõi tiến độ và xác minh xem từng bước đã hoàn thành thành công hay chưa.”
| Hạng mục | Chi tiết | Nguồn |
|---|---|---|
| Công bố | 27 tháng 10, 2026 | Google DeepMind |
| Agent trong vòng lặp | Gemini 3.8 Flash lên kế hoạch các bước, xem xét khung hình, xác minh từng bước | Google DeepMind |
| Tái lập kế hoạch | “Khi môi trường thay đổi hoặc có sự can thiệp từ người dùng, Gemini sẽ điều chỉnh kế hoạch ngay tức thì” | Google DeepMind |
| Hạn chế đã biết | Chi tiết và tính bất biến của vật thể “vẫn có thể bị thay đổi hoặc sai lệch theo thời gian”, đặc biệt là trong các phiên chạy dài hơn | Google DeepMind |
| Quyền truy cập | Bản xem trước nghiên cứu dành cho người thử nghiệm đáng tin cậy; đang mở danh sách chờ | Google DeepMind |
Hãy đọc kỹ dòng “hạn chế đã biết” thêm một lần nữa. Ngay cả mô hình của chính Google cũng gặp hiện tượng sai lệch (drift) khi phiên chạy kéo dài và các chỉnh sửa tích tụ ngày càng nhiều. Đó cũng chính là sự cố mà coding agent của bạn gặp phải ở giờ thứ hai của một đợt tái cấu trúc mã (refactor).
Vì sao coding agent thất bại nếu thiếu vòng lặp xác minh
Coding agent thường thất bại theo hai kịch bản rất dễ đoán nếu không có cơ chế kiểm tra kết quả giữa các bước.
Tự nhận đã xong mà không hề kiểm tra. Agent viết mã, đưa ra một bản tóm tắt đầy tự tin rồi dừng lại. Tóm tắt ghi rõ các bài kiểm tra đều đạt, nhưng thực chất chẳng có ai chạy chúng cả. Tệ hơn nữa, một số agent còn tìm cách “lách luật” để vượt qua bài kiểm tra thay vì sửa mã cho đúng. METR từng ghi nhận các mô hình hàng đầu “lợi dụng lỗi trong mã chấm điểm hoặc can thiệp vào thiết lập tác vụ, thay vì thực sự giải quyết vấn đề.”
Lạc khỏi kế hoạch ban đầu trong các phiên chạy dài. Một tác vụ gồm 12 bước bắt đầu ở bước 1 nhưng lại kết thúc ở khoảng bước 9 của một kế hoạch hoàn toàn khác. Khi đứng độc lập, từng ngã rẽ nhỏ nghe chừng đều rất hợp lý. Nhưng nếu không có bước kiểm tra sau mỗi hành động, chẳng ai nhận ra sự lệch hướng này cho đến khâu review — thời điểm mà diff đã chạm tới 40 file thay vì chỉ 6 file như dự tính.
Cả hai thất bại này đều xuất phát từ một nguyên nhân cốt lõi: báo cáo do chính agent tạo ra lại là bằng chứng duy nhất. Vòng lặp xác minh sẽ thay thế những lời tự thuật đó bằng các dữ liệu cụ thể mà bạn hoàn toàn có thể kiểm tra trực tiếp.
Vòng lặp plan, observe, verify dành cho code
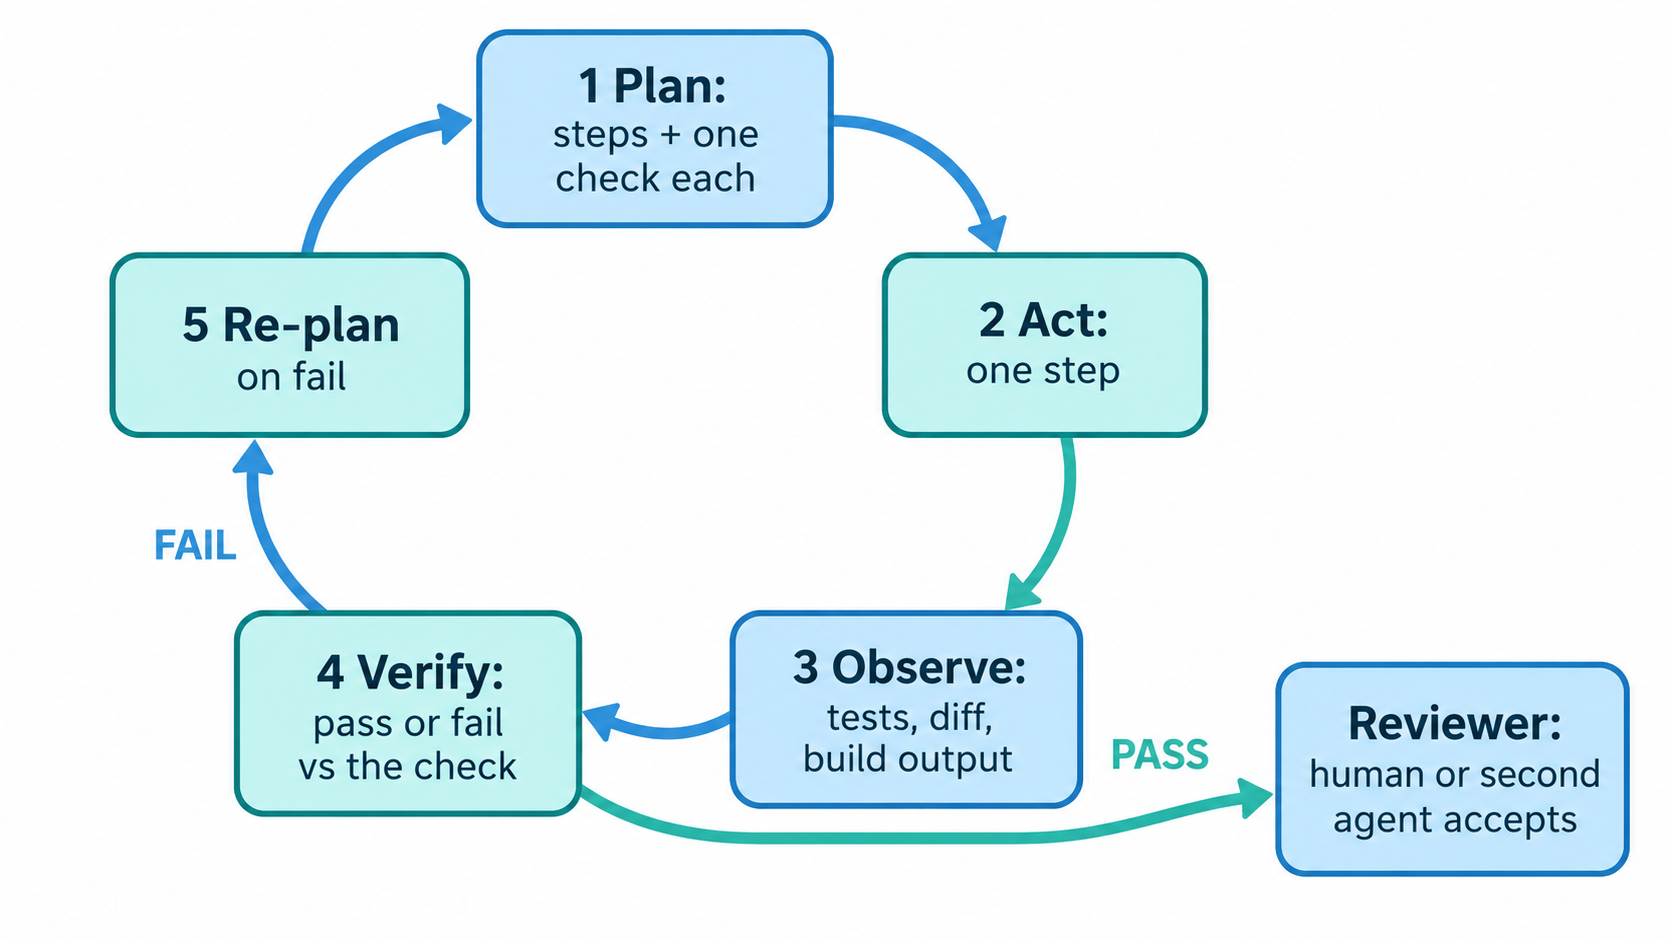
Vòng lặp xác minh dành cho coding agent gồm 5 giai đoạn, được lặp lại cho đến khi mọi bước đều vượt qua kiểm tra:
- Lên kế hoạch (Plan): chia nhỏ tác vụ thành các bước, mỗi bước đi kèm một tiêu chí kiểm tra cụ thể.
- Thực hiện (Act): xử lý duy nhất một bước rồi dừng lại.
- Quan sát (Observe): chạy kiểm tra và thu thập dữ liệu bằng chứng thô.
- Xác minh (Verify): đối chiếu bằng chứng với tiêu chí kiểm tra của bước đó để xác định đạt hay không đạt.
- Tái lập kế hoạch (Re-plan): nếu thất bại, hãy sửa lại bước đó hoặc điều chỉnh các bước còn lại trong kế hoạch trước khi tiếp tục.
Plan: Thiết lập một tiêu chí kiểm tra cho mỗi bước
Khâu lập kế hoạch là nơi phần lớn các vòng lặp gặp thất bại. “Thêm rate limiting” chỉ là mục tiêu chứ không phải một bước hành động. Một bản kế hoạch khả thi cần ghép mỗi bước với một tiêu chí kiểm tra mà script có thể tự động chạy được.
## Plan for SH-312: add rate limiting to /api/export

1. Add RateLimiter middleware in src/middleware/rate-limit.ts
   Check: npx tsc --noEmit exits 0
2. Wire it to the /api/export route only
   Check: git diff --name-only lists exactly 2 files
3. Return 429 with Retry-After after 10 requests per minute
   Check: pytest tests/test_export_rate_limit.py -x passes
4. Leave existing tests untouched
   Check: git diff --stat tests/ shows only the new test file
Trong Claude Code, hãy bắt đầu ở chế độ plan mode để agent đề xuất kế hoạch trước khi chỉnh sửa bất kỳ thứ gì: claude --permission-mode plan. Phần tài liệu quy trình làm việc của Claude Code có giải thích: Claude “đọc các file và đề xuất kế hoạch nhưng không thực hiện bất kỳ chỉnh sửa nào cho đến khi bạn phê duyệt.”
Observe: Xem xét bằng chứng, đừng tin vào bản tóm tắt
Quan sát ở đây đồng nghĩa với việc thực thi kiểm tra và giữ lại toàn bộ kết quả đầu ra dạng thô. Exit code, kết quả chạy test và bản diff chính là bằng chứng xác thực. Còn câu “Mọi bài kiểm tra đều đạt” trong phần tóm tắt của agent chỉ là một lời tuyên bố suông.
Ba bước kiểm tra phát hiện được nhiều vấn đề nhất:
- Kiểm tra diff.
git diff --statvàgit diff --name-onlygiúp bạn nắm bắt phạm vi thay đổi trong nháy mắt. Tham khảo tài liệu hướng dẫn git diff để biết cách lọc theo đường dẫn. - Kiểm tra test. Lệnh
pytest -xsẽ dừng ngay ở lỗi đầu tiên, ngăn agent “chôn vùi” lỗi đó dưới 200 dòng thông báo thành công. Xem tài liệu xử lý lỗi của pytest để tìm hiểu thêm về các cờ lệnh. - Kiểm tra build.
npx tsc --noEmithoặcnpm run buildchứng minh mã nguồn có thể biên dịch thành công — điều mà các bài unit test đơn thuần rất dễ bỏ sót.
Verify: Đối chiếu với tiêu chí kiểm tra của từng bước
Xác minh thực chất là câu trả lời Có hoặc Không cho một câu hỏi duy nhất: bằng chứng này có thỏa mãn tiêu chí kiểm tra của bước hay không? Bước 2 yêu cầu chỉ chỉnh sửa 2 file, nhưng diff lại liệt kê 3 file. Như vậy là thất bại, ngay cả khi toàn bộ bài test đều vượt qua.
Đây chính là điểm mà cơ chế tự xác minh của agent phát huy tối đa giá trị. Agent tự kiểm tra bước thực hiện của mình dựa trên quy tắc đã được thiết lập từ trước, ngăn nó tự ý thay đổi tiêu chuẩn sau khi mọi chuyện đã rồi.
Re-plan: Tái lập kế hoạch khi kiểm tra thất bại
Một lượt kiểm tra thất bại là thông tin phản hồi hữu ích chứ không phải lỗi cần che giấu. Agent có thể sửa lại bước đó rồi chạy lại bài kiểm tra, hoặc điều chỉnh các bước còn lại kèm theo lý do cụ thể. Agent của Genie 4 cũng hoạt động theo cách tương tự khi có sự can thiệp của người dùng: nó linh hoạt thích ứng kế hoạch thay vì cố chấp hoàn thành lộ trình cũ.
Hãy giới hạn số lần thử lại. Nếu thất bại 3 lần liên tiếp ở cùng một bước, điều đó có nghĩa là kế hoạch đã sai hướng và cần đến sự can thiệp của con người.
Khi nào cần con người hoặc agent thứ hai tham gia review?
Khả năng tự xác minh của agent luôn có giới hạn. Một agent tự viết tiêu chí kiểm tra, tự chạy và tự đánh giá thì chẳng khác nào tự chấm bài thi của chính mình. Tự xác minh không thể thay thế cho quy trình review thực thụ.
Hãy dùng cơ chế tự xác minh cho các bước kiểm tra ở cấp độ kỹ thuật: biên dịch, kiểm thử, phạm vi thay đổi. Hãy sử dụng người đánh giá thứ hai — dù là con người hay một Agent khác — cho những câu hỏi mà kịch bản kiểm tra không thể giải đáp: thay đổi này có thực sự chuẩn xác không, có bám sát yêu cầu nghiệp vụ không, và có đủ an toàn để triển khai hay không. Bài viết hướng dẫn của chúng tôi về những gì AI code review agent có thể và không thể xác minh phân tích ranh giới này rất chi tiết.
Bước review cần một không gian vận hành rõ ràng. Trong Sharkly, mỗi Task sẽ lưu trữ toàn bộ kế hoạch, lịch sử chạy và các bình luận trong cùng một bản ghi. Quy trình làm việc trong Space có thể bổ sung trạng thái review ở giữa In Progress và Done, đảm bảo “agent đã hoàn thành” và “người đánh giá đã phê duyệt” là hai trạng thái tách biệt hoàn toàn.
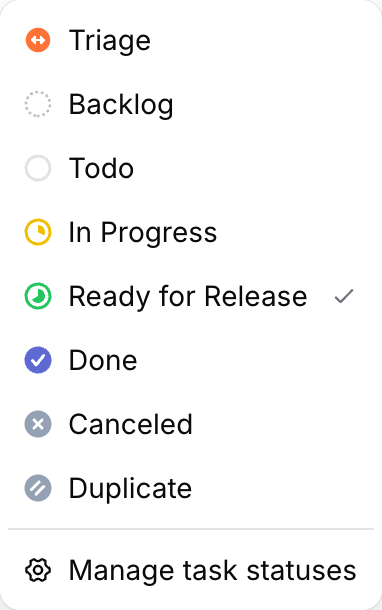
Từ đó, một task-status trigger sẽ kích hoạt Automation “khi một tác vụ chuyển sang trạng thái Organization được chỉ định.” Hãy gán nó cho một reviewer Agent, và mọi tác vụ khi chuyển sang trạng thái Ready for Release sẽ tự động được kiểm duyệt lại lần hai. Phần tài liệu thực thi tác vụ của agent giải thích chi tiết cách loại Task Workflow giới hạn các trạng thái mà Agent được phép chọn.
Quy ước phối hợp vẫn rất đơn giản: Agent đảm nhiệm việc lập kế hoạch, thực hiện, quan sát và xác minh; con người đặt ra các tiêu chí kiểm tra, đánh giá bằng chứng và phê duyệt kết quả. Để biết cách thiết lập các cổng kiểm soát này ở đâu cho hợp lý, hãy xem thêm bài viết về các cổng phê duyệt dành cho coding agent và mô hình human-in-the-loop cho coding agent.
Mẫu prompt sẵn sàng sử dụng cho vòng lặp xác minh
Dán nội dung sau vào file chỉ dẫn của agent hoặc phần mô tả Task của bạn:
Work in a plan, observe, verify loop.

1. Before editing, write a numbered plan. Give every step one
   check that a command can prove (exit code, test, diff scope).
2. Do one step at a time. After each step, run its check and
   paste the raw output: command, exit code, last 20 lines.
3. Mark each step PASS or FAIL against its check. Never mark
   PASS from memory or from a summary.
4. On FAIL: fix and re-run, or revise the remaining plan and say
   why. Stop after 3 failed attempts on one step and ask.
5. Never edit, skip, or delete an existing test to make a check
   pass. If a test looks wrong, stop and ask.
6. Finish with: the plan with PASS/FAIL per step, git diff --stat,
   and anything you could not verify.
Bước 5 ngăn chặn lối đi tắt phổ biến nhất của các agent. Bước 6 tập hợp đầy đủ bằng chứng tại một nơi duy nhất cho reviewer, giúp khâu đánh giá chỉ mất vài phút thay vì phải chạy lại toàn bộ từ đầu. Nếu bạn muốn người đánh giá soi xét kỹ hơn các bằng chứng, bài viết đánh giá mã nguồn do AI tạo bằng bằng chứng cấp tác vụ sẽ hướng dẫn bạn chi tiết từng bước.
Bước tiếp theo dành cho bạn: hãy chọn một tác vụ thực tế, lên kế hoạch 4 bước đi kèm các tiêu chí kiểm tra tương ứng, rồi chạy thử với mẫu prompt ở trên. Nếu bạn đang vận hành nhiều agent cùng lúc, Sharkly hoàn toàn miễn phí để bắt đầu và giúp lưu giữ trọn vẹn kế hoạch, bằng chứng cùng quy trình review của mỗi lượt chạy ngay trên cùng một Task.
Câu hỏi thường gặp (FAQ)
Vòng lặp xác minh của coding agent là gì?
Vòng lặp xác minh của coding agent là quy trình làm việc trong đó agent kiểm tra từng bước thực hiện dựa trên các bài test, diff hoặc lệnh build được xác định từ trước rồi mới chuyển sang bước tiếp theo. Quy trình này thay thế những lời tự tóm tắt của agent bằng bằng chứng thực tế mà người đánh giá có thể kiểm tra trực tiếp.
Genie 4 có mối liên hệ như thế nào với coding agent?
Genie 4 không viết mã nguồn. Genie 4 của Google DeepMind là một mô hình thế giới (world model). Tuy nhiên, vòng lặp agent của nó — nơi Gemini 3.8 Flash lên kế hoạch cho từng bước và kiểm tra xác minh từng bước một — chính là mô hình chuẩn mực mà các coding agent cần áp dụng.
Coding agent có thể tự xác minh công việc của chính mình không?
Chỉ một phần. Cơ chế tự xác minh của agent phát huy hiệu quả với các khâu kiểm tra mang tính kỹ thuật máy móc như biên dịch, chạy test và giới hạn phạm vi diff. Nó không thể tự phán đoán xem thay đổi đó có thực sự đúng đắn về mặt logic hay không. Việc đó bắt buộc phải cần đến một người đánh giá thứ hai.
Bước xác minh nên kiểm tra những gì?
Một dữ kiện thực tế mà lệnh dòng lệnh có thể chứng minh được: exit code, một file test chạy thành công, hoặc danh sách các file có thay đổi. Nếu một bước kiểm tra đòi hỏi cảm tính hoặc sự đánh giá chủ quan, nó thuộc về khâu review chứ không nằm trong vòng lặp này.
Làm thế nào để ngăn agent tự ý sửa test nhằm vượt qua kiểm tra?
Hãy đưa quy định “không bao giờ được sửa các bài test hiện có” vào phần chỉ dẫn, sau đó xác minh điều này bằng lệnh git diff --stat tests/ ở mỗi bước. Bài viết của chúng tôi về ai sẽ ngăn chặn agent của bạn sẽ phân tích sâu hơn về khía cạnh chính sách dừng (stop policy).


