
Argon hay Carbon? Hãy chạy phần lớn các Task của agent trên Gemini 4 Argon và chỉ chuyển những tác vụ phức tạp sang Gemini 4 Carbon. Chính Google cũng khẳng định điều này: Argon vẫn là lựa chọn mặc định cho hầu hết các công việc kỹ thuật phần mềm, còn Carbon dành cho những tác vụ nặng nề hơn. Cả hai đều có giá 2 USD đầu vào và 10 USD đầu ra cho mỗi triệu token cho đến ngày 30 tháng 11 năm 2026, nhưng Carbon tiêu tốn nhiều token hơn cho mỗi Task.
Tóm tắt nhanh
- Mặc định chọn rẻ, nâng cấp khi có bằng chứng. Khởi đầu mọi Task trên mô hình tốc độ cao. Chỉ chuyển lên cấp cao hơn khi có quy tắc rõ ràng xác định đó là tác vụ khó, hoặc khi tác vụ đó đã thất bại một lần.
- Giá mỗi token bằng nhau không đồng nghĩa với chi phí mỗi Task như nhau. Carbon đọc nhiều hơn, suy luận lâu hơn và xác minh kỹ hơn, do đó một Task sẽ tiêu tốn nhiều token hơn.
- Bốn dấu hiệu nhận biết một Task khó: quy trình dài hơi, liên quan đến nhiều file, tác động đến bảo mật, hoặc đã thất bại ở lượt chạy đầu tiên.
- Đo lường hai chỉ số cho mỗi Task: chi phí và tỷ lệ vượt qua vòng review. Hãy điều hướng dựa trên những con số đó, chứ không phải bảng xếp hạng benchmark.
- Thiết lập mô hình dưới dạng cấu hình thay vì quyết định lại theo từng prompt. Trong Sharkly, mỗi Agent đều có một mô hình mặc định và bạn có thể ghi đè mô hình đó cho một lượt chạy duy nhất khi giao Task.
Vì sao “mô hình nào tốt nhất” là một câu hỏi sai
Gemini 4 Carbon chính thức phát hành (GA) vào ngày 10 tháng 11 năm 2026 với mã định danh mô hình gemini-4-carbon. Bài viết công bố GA của Google mang đến một thông điệp hiếm thấy ở các buổi ra mắt: khuyên bạn không nên dùng mô hình mới nhất này cho hầu hết các công việc: “Argon vẫn là lựa chọn lý tưởng cho phần lớn các tác vụ kỹ thuật phần mềm và công việc trí thức.”
Cũng theo bài viết đó, Carbon được “xây dựng cho các tác vụ thử thách giới hạn trí tuệ của mô hình” và nó sử dụng “nhiều token hơn Argon để khám phá kỹ lưỡng, suy luận sâu sắc và chạy các vòng kiểm chứng mở rộng.”
Cách tiếp cận này rất phù hợp với cách các đội ngũ vận hành agent hiện nay. Bạn có một hàng đợi các Task với độ khó khác nhau, và mỗi Task chỉ nên dùng mô hình tiết kiệm chi phí nhất miễn là vượt qua được vòng review. Dùng duy nhất một “mô hình tốt nhất” cho toàn đội ngũ sẽ gây lãng phí ngân sách vào các tác vụ đơn giản, hoặc lại không đủ mạnh cho những bài toán hóc búa.
Nếu muốn tìm hiểu bức tranh toàn diện về Carbon trước, bài viết Gemini 4 Carbon for coding agents của chúng tôi sẽ giải thích chi tiết về mô hình này, còn hướng dẫn về Gemini 4 Argon sẽ phân tích kỹ hơn về lựa chọn mặc định.
Quy tắc điều hướng: mặc định chọn rẻ, nâng cấp khi gặp khó
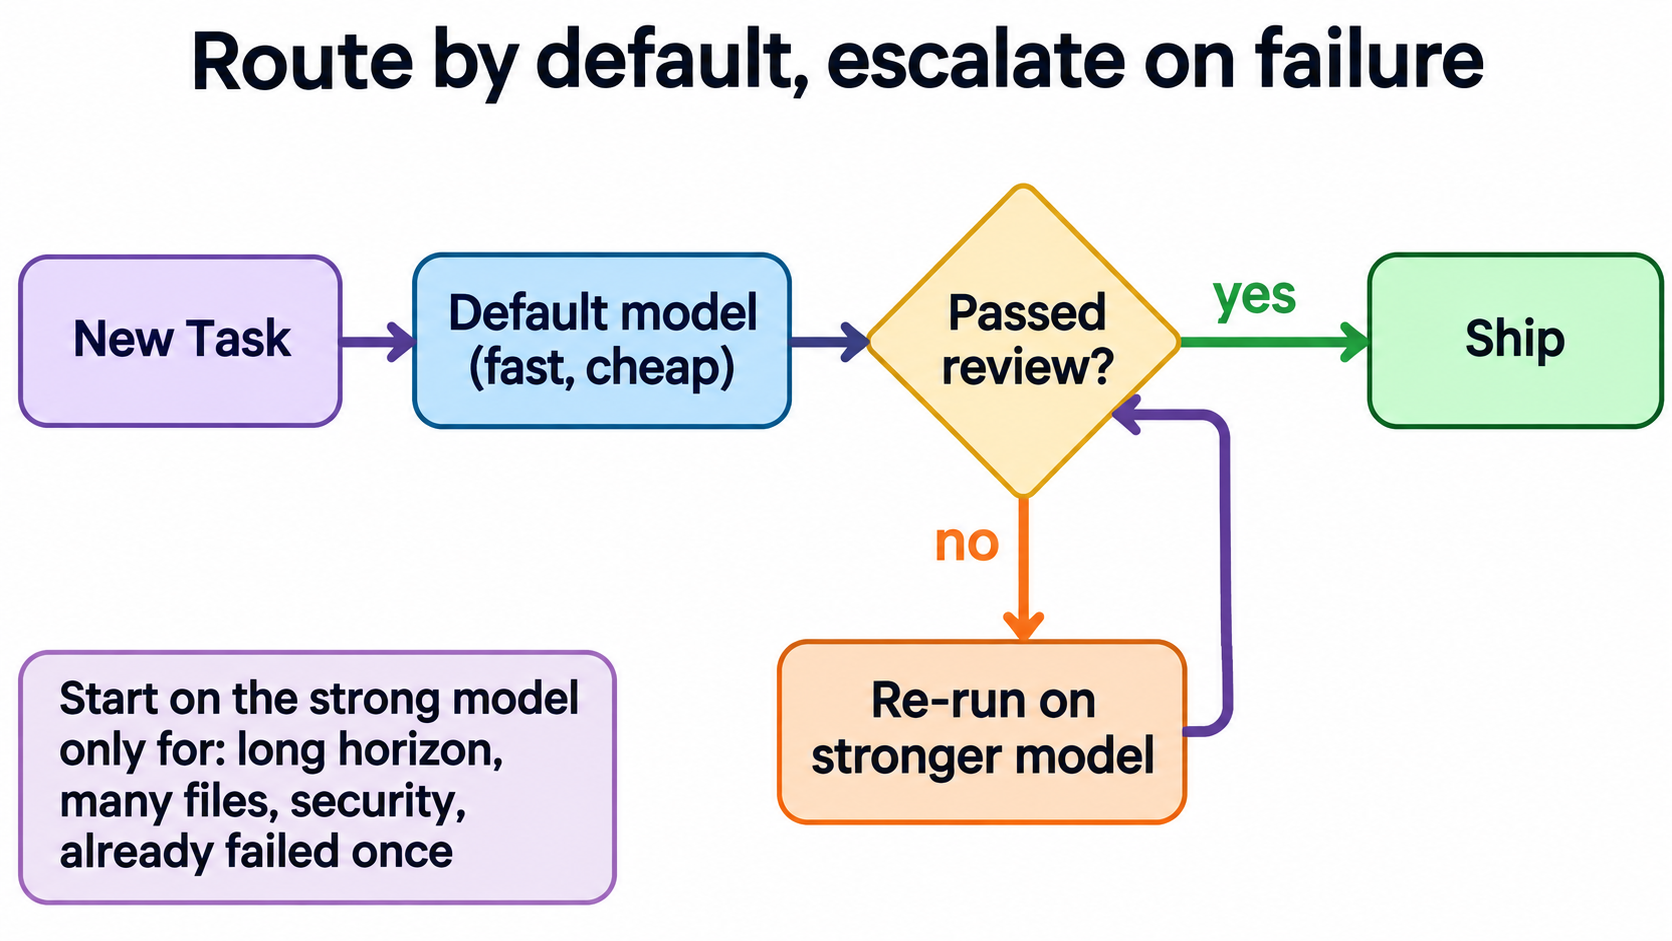
Điều hướng mô hình (model routing) cho coding agent nghĩa là lựa chọn mô hình theo từng Task thay vì áp dụng cố định cho cả đội ngũ. Quy tắc này có thể tóm gọn trong một câu: mọi Task đều bắt đầu trên mô hình mặc định, và một Task chỉ được chuyển sang mô hình mạnh hơn khi có dấu hiệu cụ thể cho thấy nó phức tạp, hoặc khi mô hình mặc định đã xử lý thất bại.
Có hai yếu tố giúp quy tắc này phát huy hiệu quả.
- Một mô hình mặc định tốc độ cao và đủ tốt cho hầu hết các Task. Với các đội ngũ sử dụng Gemini, đó chính là Argon, theo đúng khuyến nghị của Google.
- Một quy trình nâng cấp (escalation path) với điều kiện kích hoạt có thể kiểm chứng rõ ràng. Cảm giác “thấy có vẻ khó” không phải là một điều kiện hợp lệ. Nhưng “chạm vào mã nguồn xác thực (auth)” thì đúng là như vậy.
Cách nhận biết một Task khó
Bạn cần những dấu hiệu có thể nhận biết ngay từ thông tin của Task trước khi chạy. Bốn dấu hiệu dưới đây bao quát phần lớn các trường hợp.
Quy trình dài hơi
Một Task đòi hỏi nhiều bước liên tiếp, chẳng hạn như đợt di chuyển hệ thống (migration) với mười thay đổi phụ thuộc lẫn nhau, sẽ khiến mô hình yếu hơn dễ bị lệch hướng (drift). Các vòng kiểm chứng bổ sung của Carbon sinh ra chính là để giải quyết trường hợp này. Dấu hiệu: phần mô tả Task liệt kê hơn năm bước, hoặc một lượt chạy tác vụ tương tự trước đây đã vượt quá thời gian cho phép.
Nhiều file
Các thay đổi mang tính bao quát (cross-cutting) đòi hỏi mô hình phải ghi nhớ và xử lý một phạm vi lớn của codebase cùng lúc. Dấu hiệu: thay đổi trải rộng trên nhiều package hoặc hơn mười file.
Tác động đến bảo mật
Các tác vụ liên quan đến xác thực (auth), thanh toán, xử lý secret và kiểm tra quyền hạn sẽ phải trả giá rất đắt nếu mô hình tự tin đưa ra câu trả lời sai. Bài viết công bố GA của Google cho biết Carbon dẫn đầu trên các benchmark SEC-bench Pro và CWE-bench v1 khi được truy cập qua chương trình Fairwind Program dành cho các chuyên gia an ninh mạng. Dấu hiệu: Task can thiệp vào một đường dẫn mà bạn đã đánh dấu là nhạy cảm.
Đã từng thất bại một lần
Đây là dấu hiệu ít tốn kém nhất và cũng trung thực nhất. Nếu lượt chạy của mô hình mặc định không qua được vòng review, bạn đã có bằng chứng trực tiếp cho thấy Task vượt quá khả năng của nó. Hãy chạy lại tác vụ trên mô hình mạnh hơn kèm theo nhận xét của người review.
Bảng điều hướng khởi đầu dành cho bạn
Hãy dùng bảng này làm bản thảo ban đầu, sau đó cập nhật lại dựa trên tỷ lệ vượt qua vòng review thực tế của bạn sau hai tuần.
| Loại Task | Bắt đầu với | Nâng cấp lên | Lý do |
|---|---|---|---|
| Lỗi chính tả, sửa nội dung (copy), cập nhật dependency | Tầng tốc độ cao (mô hình Flash hoặc mini) | Argon | Diff nhỏ, dễ review |
| Sửa bug với test case đang fail | Argon | Carbon | Test case đưa ra tín hiệu pass/fail rõ ràng |
| Tính năng trong một module | Argon | Carbon | Lựa chọn mặc định theo công bố của Google cho hầu hết tác vụ kỹ thuật |
| Tái cấu trúc (refactor) trên nhiều file | Carbon | Fable 5.2 hoặc con người | Quy trình dài hơi, liên quan nhiều file |
| Xác thực, thanh toán, phân quyền | Carbon | Luôn cần con người review | Tác động đến bảo mật |
| Bất kỳ Task nào đã thất bại ở vòng review một lần | Lên một cấp cao hơn | Con người | Bằng chứng thực tế luôn chuẩn hơn suy đoán |
Claude Fable 5.2 có mức giá niêm yết là 8 USD đầu vào và 40 USD đầu ra cho mỗi triệu token, gấp bốn lần mức giá giới thiệu của Carbon, do đó mô hình này xếp trên Carbon như một nấc tự động hóa cuối cùng chứ không phải lựa chọn mặc định. Mức giá của chính Carbon sẽ tăng lên 4 USD và 20 USD sau ngày 30 tháng 11 năm 2026 theo ghi chú của Google, giúp thu hẹp khoảng cách đó. Hãy kiểm tra các con số hiện tại trên trang bảng giá Gemini API trước khi bạn thiết lập ngân sách.
Chỉ nâng cấp khi thất bại, không nâng cấp trước
Các đội ngũ thường có xu hướng định tuyến trước bất kỳ tác vụ nào “nghe có vẻ khó” sang mô hình mạnh nhất. Cách làm này tạo cảm giác an tâm nhưng lại rất tốn kém, bởi lẽ nhiều Task trong số đó hoàn toàn có thể hoàn thành tốt trên mô hình mặc định.
Chiến lược nâng cấp khi thất bại giúp bạn chỉ phải trả chi phí của mô hình nhỏ cho mọi Task, và chỉ trả chi phí của mô hình lớn khi Task đó thực sự chứng minh rằng nó cần tới. Một lần chạy thất bại trên mô hình giá rẻ thường vẫn tốn ít chi phí hơn nhiều so với một lần chạy mô hình đắt tiền không cần thiết.
Có hai ngoại lệ đối với quy tắc này, và bảng trên đã đề cập đến chúng. Các công việc liên quan đến bảo mật nên bắt đầu ngay ở cấp cao vì một lượt chạy kém chất lượng có thể bị merge nếu vòng review bỏ sót. Tương tự, các đợt refactor lớn trên nhiều file cũng nên bắt đầu ở cấp cao vì một lượt chạy thất bại ở đây sẽ ngốn cả tiếng đồng hồ chứ không chỉ vài phút.
Một lượt chạy thất bại cũng chỉ mang lại giá trị cảnh báo nếu vòng review phát hiện ra được. Các mô hình đôi khi tìm cách “qua mặt” bài test, vì vậy hãy kết hợp việc nâng cấp với các phương pháp kiểm tra trong bài viết cách phát hiện coding agent gian lận test.
Đo lường chi phí và tỷ lệ pass trên từng Task
Điều hướng mà không dựa vào số liệu sẽ chỉ dừng lại ở cảm tính. Hãy theo dõi hai yếu tố này cho mỗi Task.
- Chi phí cho mỗi Task: số token đầu vào và đầu ra nhân với đơn giá của mô hình đó, cộng tổng qua tất cả các lượt chạy của Task, bao gồm cả những lần thất bại.
- Tỷ lệ vượt qua vòng review: lượt chạy đầu tiên có đạt yêu cầu hay không, hay phải chạy lại hoặc cần con người can thiệp sửa chữa?
Sau đó, hãy làm phép chia. Chi phí trên mỗi thay đổi được chấp nhận (cost per accepted change) chính là con số quyết định cách bạn điều hướng. Một mô hình giá rẻ nhưng thất bại một nửa số lần có thể tiêu tốn nhiều chi phí hơn một mô hình mạnh vượt qua ngay từ lần thử đầu tiên — đây cũng chính là luận điểm trong bài viết khi mô hình rẻ hơn lại tốn kém hơn.
Dữ liệu từ bên thứ ba cũng chỉ ra điều tương tự. Artificial Analysis báo cáo rằng việc chạy Intelligence Index tiêu tốn 7,76 USD trên Gemini 4 Carbon (high) và 26,54 USD trên Claude Fable 5.2 (max), trong đó Fable đạt 65 điểm so với 60 điểm của Carbon. Khoảng cách 5 điểm với mức chi phí gấp 3,4 lần chỉ thực sự đáng tiền ở những Task mà 5 điểm chênh lệch đó làm thay đổi hoàn toàn kết quả.
Một bảng ghi log đơn giản là đủ để bắt đầu:
task       model          runs  tokens_in  tokens_out  cost_usd  passed_first
COIN-212   gemini-4-argon    1     48,000      9,500      0.19   yes
COIN-213   gemini-4-argon    2    121,000     22,000      0.46   no
COIN-213   gemini-4-carbon   1    210,000     41,000      0.83   yes
Ở đây, COIN-213 đã thất bại trên Argon, được nâng cấp lên và vượt qua trên Carbon. Toàn bộ Task tốn tổng cộng 1,29 USD, và dòng log đó sẽ cho bạn biết liệu các Task tương tự có nên bắt đầu ngay trên Carbon trong lần tới hay không.
Thiết lập theo từng Task trên bảng công việc
Quy tắc này nói thì dễ nhưng khó áp dụng đồng bộ nếu mỗi lập trình viên tự chọn mô hình ngay trong terminal của riêng mình. Hãy đưa tính năng điều hướng đến đúng nơi quản lý các Task.
Gán một mô hình cố định cho từng Agent
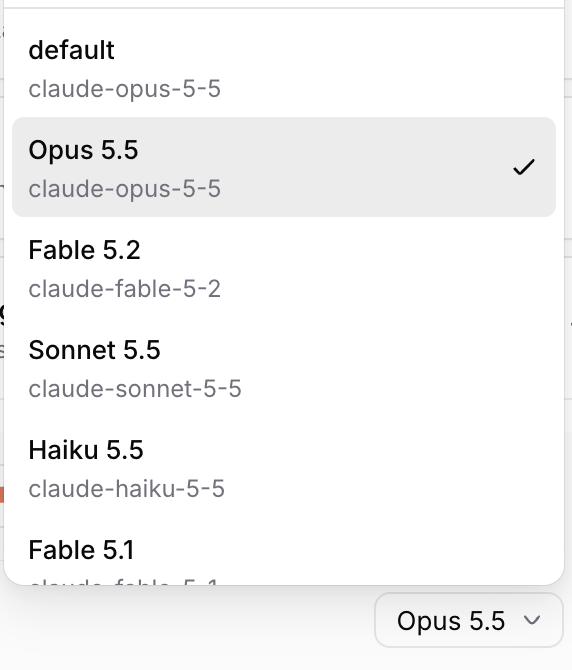
Trong Sharkly, một Agent sẽ mặc định dùng mô hình theo Runtime của nó, và mục Model trong cài đặt Agent cho phép bạn chọn một mô hình khác từ danh mục của Runtime đó, cùng với độ sâu tư duy (thinking depth) nếu mô hình có hỗ trợ. Tài liệu Agents docs sẽ hướng dẫn chi tiết về phần này. Nhờ đó, bạn sẽ có một Agent cho mỗi cấp: một Agent mặc định dùng mô hình tốc độ cao và một Agent nâng cấp dùng mô hình mạnh mẽ.
Nâng cấp cho một lượt chạy duy nhất
Khi giao một Task, bạn có thể chọn mô hình riêng cho lượt chạy đó để ghi đè thiết lập mặc định của Agent chỉ trong lần chạy này. Đây chính là quy trình nâng cấp khi thất bại chỉ với một bước: người review gửi trả Task, và lượt chạy lại sẽ được thực hiện trên Carbon mà không làm ảnh hưởng đến cấu hình Agent mà những người khác đang dùng.
Lưu trữ dữ liệu tập trung tại một nơi
Mỗi lượt chạy đều lưu lại log thực thi, do đó bảng thống kê chi phí và tỷ lệ pass của bạn được tổng hợp từ các Task đã hoàn thành thực tế chứ không phải dựa vào phỏng đoán hay trí nhớ. Đối với các Crew phân chia công việc theo vai trò thay vì theo độ khó, hãy tham khảo bài viết model routing for agent Crews. Về khía cạnh giám sát, bài viết who stops your agents trình bày các cơ chế kiểm soát nằm trong tay đội ngũ của bạn. Bạn có thể bắt đầu sử dụng Sharkly hoàn toàn miễn phí.
Các giải pháp thay thế cho việc điều hướng theo từng Task
- Dùng một mô hình duy nhất cho mọi thứ. Phù hợp cho lập trình viên làm việc độc lập, nhưng rất lãng phí khi tính chất các Task bắt đầu phân hóa.
- Sử dụng một mô hình router tự động. Một mô hình nhỏ sẽ phân loại từng prompt và chọn đích đến. Cách này làm ẩn đi quy trình ra quyết định và không thể nhận biết được một lượt review thất bại.
- Chế độ nhóm agent (Agent-team modes). Bản xem trước /swarm của Google trong Antigravity sử dụng Carbon cho việc lập kế hoạch và kiểm tra, trong khi các mô hình nhẹ hơn xử lý công việc song song. Đây là hình thức điều hướng theo vai trò trong cùng một đầu việc, bổ trợ rất tốt cho việc điều hướng theo từng Task.
Kết luận
Google đã gợi ý cho bạn quy tắc điều hướng ngay trong bài viết ra mắt của họ: mặc định dùng Argon, và chỉ dùng Carbon khi Task thực sự cần đến. Hãy ghi lại bốn dấu hiệu nhận biết Task khó, khởi đầu mọi tác vụ khác bằng mô hình tiết kiệm chi phí, nâng cấp khi không qua được vòng review, và ghi log chi phí cùng tỷ lệ pass cho từng Task. Sau hai tuần, chính những con số thực tế của bạn sẽ hoàn thiện bảng điều hướng chuẩn xác hơn bất kỳ benchmark nào.
Bước tiếp theo: hãy thiết lập hai Agent trong Sharkly, một Agent dùng mô hình mặc định và một Agent dùng mô hình nâng cấp, rồi bắt đầu điều hướng các Task trong tuần này qua chúng.
Câu hỏi thường gặp
Tôi nên dùng Gemini 4 Carbon hay Argon cho coding agent?
Hãy dùng Argon cho hầu hết các Task và dùng Carbon cho những tác vụ khó. Bài viết công bố GA của Google nêu rõ Argon “vẫn là lựa chọn lý tưởng cho phần lớn các tác vụ kỹ thuật phần mềm”, trong khi Carbon dành cho các Task thử thách giới hạn của mô hình.
Gemini 4 Carbon có đắt hơn Argon không?
Tính theo token thì không: cả hai đều có giá 2 USD đầu vào và 10 USD đầu ra cho mỗi triệu token cho đến ngày 30 tháng 11 năm 2026. Nhưng tính theo Task thì thường là có, vì Google cho biết Carbon sử dụng nhiều token hơn để khám phá và kiểm chứng.
Giá của Gemini 4 Carbon sẽ thay đổi thế nào sau ngày 30 tháng 11?
Ghi chú của Google cho biết mức giá giới thiệu sẽ hết hạn vào ngày 30 tháng 11 năm 2026, và giá của Carbon sẽ chuyển sang 4 USD cho mỗi triệu token đầu vào và 20 USD cho mỗi triệu token đầu ra.
Điều hướng mô hình (model routing) cho AI agent là gì?
Điều hướng mô hình là việc lựa chọn mô hình phù hợp cho từng Task dựa trên độ khó của nó, với mục tiêu đạt được chi phí thấp nhất trên mỗi thay đổi được chấp nhận.
Làm sao để biết khi nào cần nâng cấp một Task lên mô hình mạnh hơn?
Hãy nâng cấp khi Task có quy trình dài hơi, trải rộng trên nhiều file, đụng chạm đến mã nguồn nhạy cảm về bảo mật, hoặc đã không qua được vòng review trên mô hình mặc định.
Tôi có thể thiết lập mô hình khác nhau cho từng agent trong Sharkly không?
Có. Mỗi Agent đều có mục Model trong phần cài đặt để chọn từ danh mục của Runtime tương ứng, và bạn có thể ghi đè mô hình cho một lượt chạy duy nhất khi giao Task.


