
Hầu hết các đội nhóm vận hành nhiều coding agent đều đặt ra một mức trần chi tiêu hàng tháng cho model vào một thời điểm nào đó, thường là sau một tuần tồi tệ. Chọn một con số, giới hạn số lượng chạy song song cho đến khi hóa đơn nằm dưới mức đó, rồi xem lại vào quý sau. Đến ngày 22/09/2026, con số đó lặng lẽ không còn mang ý nghĩa như trước nữa.
OpenAI ra mắt GPT-6 Sol với giá 2 đô cho mỗi triệu token đầu vào và 10 đô cho mỗi triệu token đầu ra, API id gpt-6-sol, và công bố một thứ hữu ích hơn cả đơn giá token: chi phí cho mỗi tác vụ. Trên AutomationBench 1.0.6, Sol ở mức nỗ lực suy luận cực cao đạt 33,2% với chi phí 0,27 đô mỗi tác vụ. Claude Opus 5 ở mức nỗ lực tối đa đạt 26,9% với chi phí mỗi tác vụ gấp 11,1 lần Sol trên cùng một harness.
Vậy hãy tính xem mức trần của bạn hiện mua được những gì, trước khi bạn nâng nó lên. Câu trả lời với hầu hết các đội nhóm là nó đã mua được nhiều lượt chạy hoàn chỉnh hơn mức mà bất kỳ ai có thể đọc hết. Nghĩa là mức trần đó chưa bao giờ bảo vệ ngân sách. Nó vô tình bảo vệ những người review của bạn, và điều đó sắp không còn nữa.
TL;DR
Chi phí cho mỗi thay đổi được chấp nhận là số tiền đội của bạn chi cho suy luận model tính trên mỗi diff mà một người thực sự đọc và chấp nhận, và đây là con số chi phí agent duy nhất gắn liền với công việc đã được ship. Với mức giá đã công bố, toàn bộ lượng thông lượng có thể review trong một tháng của một đội bốn người review chỉ tốn khoảng 136 đô cho GPT-6 Sol. Nút thắt ràng buộc đã chuyển từ hóa đơn sang bước chấp nhận, và không có bản phát hành model nào chạm tới điều đó. Agent nghiên cứu, thực thi, kiểm thử và báo cáo. Con người định hướng, trao quyền và chấp nhận kết quả.
Những con số OpenAI thực sự công bố
OpenAI báo cáo điểm số song song với chi phí mỗi tác vụ, một cách làm trung thực một cách hiếm thấy và hữu ích hơn nhiều so với một bảng giá.
| Model, ở mức nỗ lực mà OpenAI đã dùng | AutomationBench 1.0.6 | Chi phí mỗi tác vụ |
|---|---|---|
| GPT-6 Sol, cực cao | 33,2% | 0,27 đô |
| GPT-6 Astra, thấp | 30,3% | gấp 3,9 lần Sol |
| Claude Opus 5, tối đa | 26,9% | gấp 11,1 lần Sol |
| Fable 5.1 với fallback Opus 5, tối đa | 31,4% | hơn 8,9 lần Sol |
Tóm tắt của chính OpenAI về hàng thứ nhất và hàng thứ ba: Sol ở mức cực cao đánh bại Opus 5 ở mức tối đa với chi phí mỗi tác vụ chỉ bằng khoảng 9% của Opus 5. Cùng một kiểu mẫu xuất hiện ở những chỗ khác trong bài đăng của họ. Trên Agents’ Last Exam V1, Sol ở mức tối đa đạt 56,4%, cao hơn kết quả tốt nhất của Opus 5, với chi phí mỗi tác vụ thấp hơn 60%. Trên DeepSWE 1.1, Sol ở mức tối đa đạt 68,8%, chỉ kém 1,1 điểm phần trăm so với Fable 5 ở mức cực cao (69,9%), nhưng rẻ hơn khoảng 80% mỗi tác vụ.
Có hai lưu ý đi kèm những con số đó mà hiếm khi được nhắc cùng. Tiêu đề của OpenAI là Sol và Luna đều rẻ hơn 50% so với giá khuyến mãi của GPT-5.6, và “khuyến mãi” là từ của chính OpenAI: phép so sánh được thực hiện với một mức giá đã giảm. Và OpenAI đã đánh giá đối chiếu với Claude Opus 5, bởi vì Claude Opus 5.5 ra mắt chỉ vài giờ sau đó với giá 4 và 20 đô mỗi triệu token, so với mức 5 và 25 đô của Opus 5. Cột Opus 5 là phép so sánh được công bố gần nhất, không phải phép so sánh hiện tại.
Quy đổi ngân sách thành số lượt chạy
Nhân 0,27 đô với 11,1 và Opus 5 ở mức tối đa rơi vào khoảng 3,00 đô mỗi tác vụ trên harness đó. Phép tính đó là của chúng tôi, dựa trên hai con số của OpenAI. Chia một mức trần hàng tháng cho từng mức giá và bạn sẽ có bảng làm thay đổi cách hiểu về mức trần đó.
| Ngân sách model hàng tháng | Số tác vụ trên Sol, cực cao | Số tác vụ trên Astra, thấp | Số tác vụ trên Opus 5, tối đa |
|---|---|---|---|
| 250 đô | khoảng 925 | khoảng 240 | khoảng 83 |
| 1.000 đô | khoảng 3.700 | khoảng 950 | khoảng 330 |
| 5.000 đô | khoảng 18.500 | khoảng 4.750 | khoảng 1.660 |
Chi phí mỗi tác vụ trên benchmark không phải chi phí mỗi tác vụ của bạn. Các tác vụ trên AutomationBench mang hình dạng của benchmark: có giới hạn, ngắn, và không giống chút nào một ticket thực tế trong một repository với nhiều năm lịch sử. Tác vụ của chính bạn có thể đốt lượng token gấp mười hoặc một trăm lần. Thứ chuyển dịch được giữa benchmark và repository của bạn là tỷ lệ giữa các model, chứ không phải con số đô la tuyệt đối. Hãy coi bảng này như hình dạng của sự thay đổi, rồi tự đo chi phí mỗi lượt chạy trên các agent của bạn và quy đổi lại cho phù hợp.
Còn một điều chỉnh thứ hai, và nó đi theo hướng ngược lại. Chi phí mỗi tác vụ là tính trên mỗi lần thử, không phải mỗi lần thành công. Với tỷ lệ 33,2% của chính benchmark, khoảng hai trong ba lần thử không đi đến đích, nên Sol tốn khoảng 0,81 đô cho mỗi lần thành công trên benchmark và Opus 5 ở mức tối đa tốn khoảng 11,15 đô. Lại là phép tính của chúng tôi, và vẫn thô, vì tỷ lệ đạt của benchmark không phải tỷ lệ chấp nhận của đội bạn. Điều quan trọng là hướng đi: chi phí để thử một việc hai lần giờ đây đã đủ nhỏ để chiến lược thử lại trở thành một lựa chọn thiết kế chứ không còn là một quyết định ngân sách.
Mức trần hiện nằm ở đâu
Hãy đặt phía review lên cùng một trang. Một người review đọc kỹ một diff, hiểu được lựa chọn của Agent, và chịu trách nhiệm về kết quả thì xử lý được một số lượng thay đổi nhất định trong một ngày làm việc. Cứ tạm tính là sáu, và hãy điều chỉnh theo đội của bạn.
| Số người review | Số thay đổi được chấp nhận mỗi tháng | Chi phí Sol ở 0,27 đô | Chi phí Opus 5 tối đa ở 3,00 đô |
|---|---|---|---|
| 1 | khoảng 126 | 34 đô | 378 đô |
| 2 | khoảng 252 | 68 đô | 756 đô |
| 4 | khoảng 504 | 136 đô | 1.512 đô |
| 8 | khoảng 1.008 | 272 đô | 3.024 đô |
Sáu thay đổi được chấp nhận mỗi người review mỗi ngày trong 21 ngày làm việc, đây là giả định và phép tính của chúng tôi. Hãy thay bằng con số của bạn và kết luận vẫn đứng vững: mọi thứ mà một đội kỹ thuật thông thường thực sự có thể chấp nhận trong một tháng chỉ tốn vài trăm đô suy luận, ngay cả ở mức đắt đỏ. Mức trần 1.000 đô cho một đội bốn người không phải là một ràng buộc. Nó tương đương khoảng bảy lần lượng đầu ra agent so với sức hấp thụ của đội.
Đó chính là toàn bộ ý nghĩa của việc giảm giá đối với một đội có review công việc của mình. Nó không nâng sản lượng của bạn lên. Nó gỡ bỏ lý do cuối cùng để hàng đợi ngắn, và phơi bày một nút thắt mà vốn dĩ luôn tồn tại: bước con người review.
Chi tiêu nội bộ của OpenAI là ví dụ đối chứng hữu ích, chứ không phải một mâu thuẫn. Nhà nghiên cứu trung vị của họ chạy hơn 600 đô mỗi ngày cho suy luận coding agent ở mức giá API, và phân vị thứ 90 chạy tới 7.000 đô một ngày. Đó là những con số thật và chúng vượt xa bảng ở trên, bởi vì công việc đó có hình dạng khác: phân nhánh cực lớn, chấm điểm tự động, và không có bước nào mà một người có tên cụ thể chấp nhận từng kết quả vào một nhánh production. Nếu quy trình của bạn có bước đó, hóa đơn model sẽ vẫn nhỏ và hàng đợi của bạn sẽ không.
Mua gì với khoảng dư đó
Một khi ngân sách không còn là ràng buộc, câu hỏi không còn là mua bao nhiêu lượt chạy nữa mà trở thành dùng phần chênh lệch đó vào việc gì. Có hai câu trả lời giúp giảm khối lượng công việc đổ về người review thay vì làm tăng nó.
Mua nỗ lực, đừng mua khối lượng. Mức nỗ lực suy luận là một nút điều chỉnh chi phí, và chính bảng của OpenAI dùng các mức khác nhau cho các benchmark khác nhau. Con số 0,27 đô là ở hàng cực cao, nên phần phụ trội cho một lượt chạy cẩn thận hơn vốn đã nằm trong một con số chỉ bằng 9% của phương án thay thế. Trả phần đó trên cùng số lượng tác vụ tốn gần như không đáng kể mà lại tạo ra những diff mất ít thời gian kiểm tra hơn.
Mua cache, đừng mua token. GPT-6 giảm giá 90% cho việc đọc đầu vào từ cache, mặc định giữ tỷ lệ trúng cache cao hơn, và không còn vô hiệu hóa cache khi bạn thay đổi mức nỗ lực suy luận hay mức sẵn có của tool. Các breakpoint tường minh cho phép bạn quyết định nơi một prefix được cache kết thúc. OpenAI dẫn chứng việc GitHub chứng kiến số prompt token cần xử lý mới giảm hơn 50% trên hàng tỷ request. Với một Crew, đây là khác biệt giữa Agent đầu tiên trên một repository và Agent thứ mười: chúng gửi lại gần như cùng một prefix về bố cục, quy tắc nội bộ, và quy ước, và prefix đó chính xác là thứ mà cache sinh ra để phục vụ. Chi phí token cho ngữ cảnh repository là nơi hóa đơn của cả một đội agent thực sự nằm.
Cặp quyết định trung thực là: tăng số lượt chạy đồng thời khi các lượt chạy thêm đó cùng hội tụ về một kết quả mà một người chấp nhận, ví dụ ba lần thử cho một cuộc migration mà bộ test chọn ra người thắng. Đừng tăng khi mỗi lượt chạy tạo ra diff riêng, bản tóm tắt riêng, và quyết định chấp nhận riêng, cho dù các lượt chạy đã trở nên rẻ đến đâu. Trong trường hợp thứ hai, hóa đơn là thứ duy nhất mở rộng tốt.
Biến mức trần mới thành thứ đếm được
Ngân sách là một đại diện tồi cho năng lực, nhưng nó có một ưu điểm: đó là một con số mà ai đó theo dõi. Hãy thay nó bằng con số giờ đây mới là ràng buộc, tức số lượt chạy đã hoàn thành đang chờ một người xử lý.
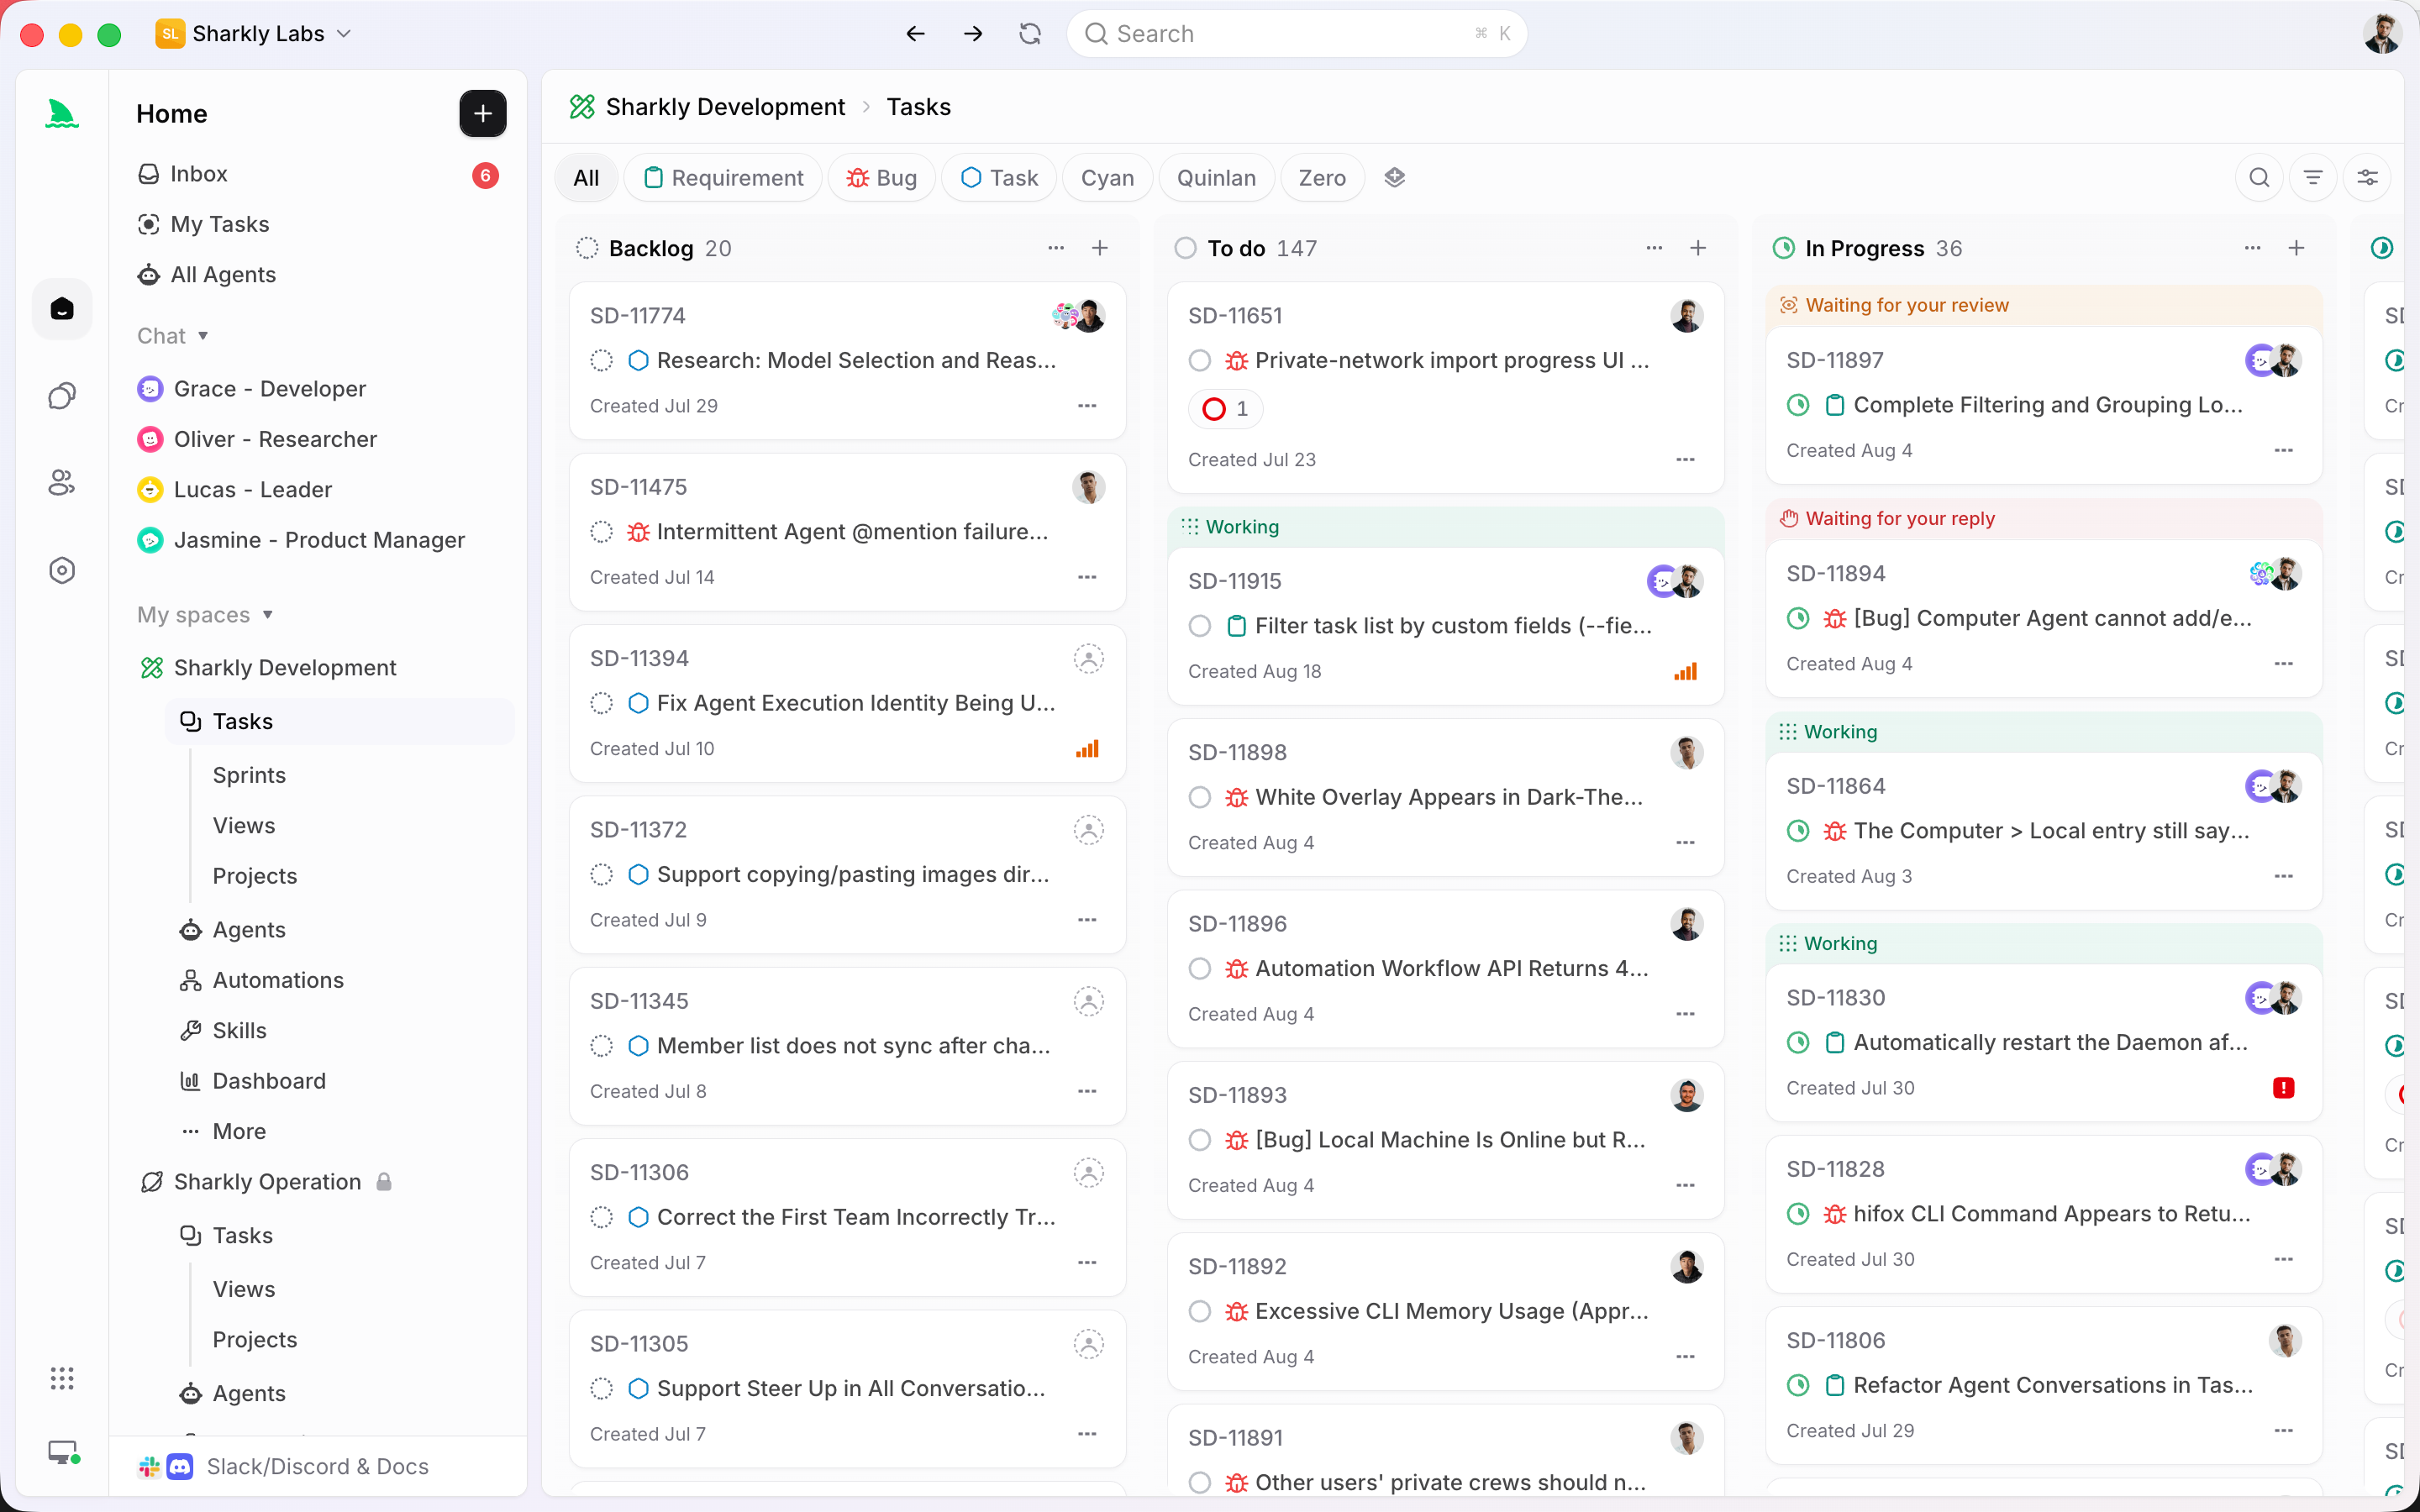
Điều đó chỉ đo lường được nếu các lượt chạy không còn sống trong những terminal riêng tư. Sharkly không phải là thứ thay thế Codex, Claude Code, hay những tool khác đang vận hành các model này. Nó là lớp bao quanh chúng, nơi ngữ cảnh, tiến độ, điểm nghẽn, kết quả, và việc review của con người luôn hiển thị rõ từ lúc yêu cầu đến lúc phát hành. Việc thực thi và các điểm nghẽn quay trở về Task, nên “đang chờ con người” trở thành một trạng thái bạn có thể đếm trên bảng thay vì một cảm giác vào chiều thứ Sáu. Phép tính năng lực review chỉ hiệu quả khi bạn nhìn thấy được hàng đợi.
Nếu bạn đã và đang vận hành nhiều coding agent, động thái trong tuần này không phải là nâng mức trần. Mà là tìm xem đội bạn chấp nhận được bao nhiêu lượt chạy hoàn chỉnh trong một tuần bình thường, đặt số lượt chạy đồng thời dựa trên đó, và dùng phần ngân sách còn lại cho những lượt chạy dễ được chấp nhận hơn.


