
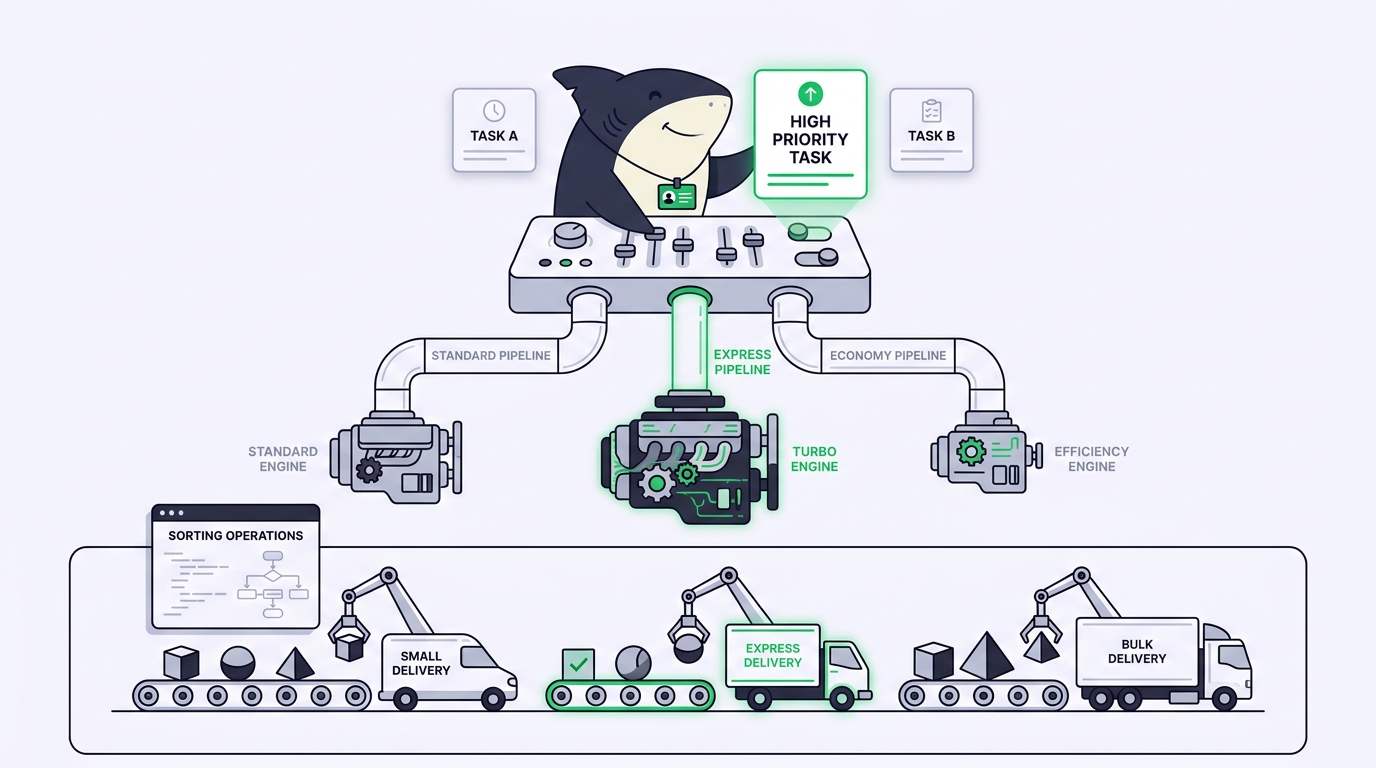
TL;DR: Đừng mất công đi tìm một model tốt nhất duy nhất nữa. Hãy ghép mỗi model với hình dạng của task trước mắt: suy luận sâu cho kiến trúc và refactor xuyên nhiều file, nhanh và rẻ cho boilerplate và test, context dài cho các câu hỏi về toàn bộ repo, khả năng tuân thủ tool ổn định cho những chỉnh sửa nhiều bước. Chọn model theo từng terminal chỉ ổn khi bạn có một hai agent. Khi đã chạy nhiều task trên nhiều repo, ánh xạ đó nên nằm trong một Agent đã lưu, chứ không phải trong đầu bạn. Dưới đây là bản đồ, một ví dụ cụ thể và một checklist bạn có thể áp dụng ngay hôm nay.
Bạn đang mở năm terminal. Một cái chứa một màn refactor hóc búa, một cái cần một loạt unit test, một cái đang trả lời các câu hỏi về codebase mà bạn chỉ nhớ mang máng, một cái đang truy lùng một integration test chập chờn, một cái đang đổi tên một symbol trên bốn mươi file. Mỗi cái đều âm thầm hỏi cùng một câu: model nào nên chạy việc này? Giao một model suy luận hạng nặng cho việc đổi tên thì bạn đốt token và thời gian cho công việc mà bất kỳ model nhanh nào cũng làm gọn gàng. Giao một model nhanh cho thay đổi kiến trúc thì nó bỏ sót một dependency ở tận ba file khác. Lời than phiền lặp đi lặp lại hiếm khi là “model dở”. Mà là “tôi không biết nên dùng cái nào”.
Cách khắc phục không phải là một bảng xếp hạng. Thứ hạng thay đổi vài tuần một lần, và người thắng một benchmark tổng quát thường lại là lựa chọn sai cho task cụ thể của bạn. Nước đi bền vững là ghép model với hình dạng của task: cần bao nhiêu suy luận, phải giữ bao nhiêu context, tuân thủ tool đáng tin đến đâu, và bạn sẽ tốn bao nhiêu cho mỗi lần chạy. Những đặc tính đó gần như không đổi, kể cả khi tên model có thay đổi.
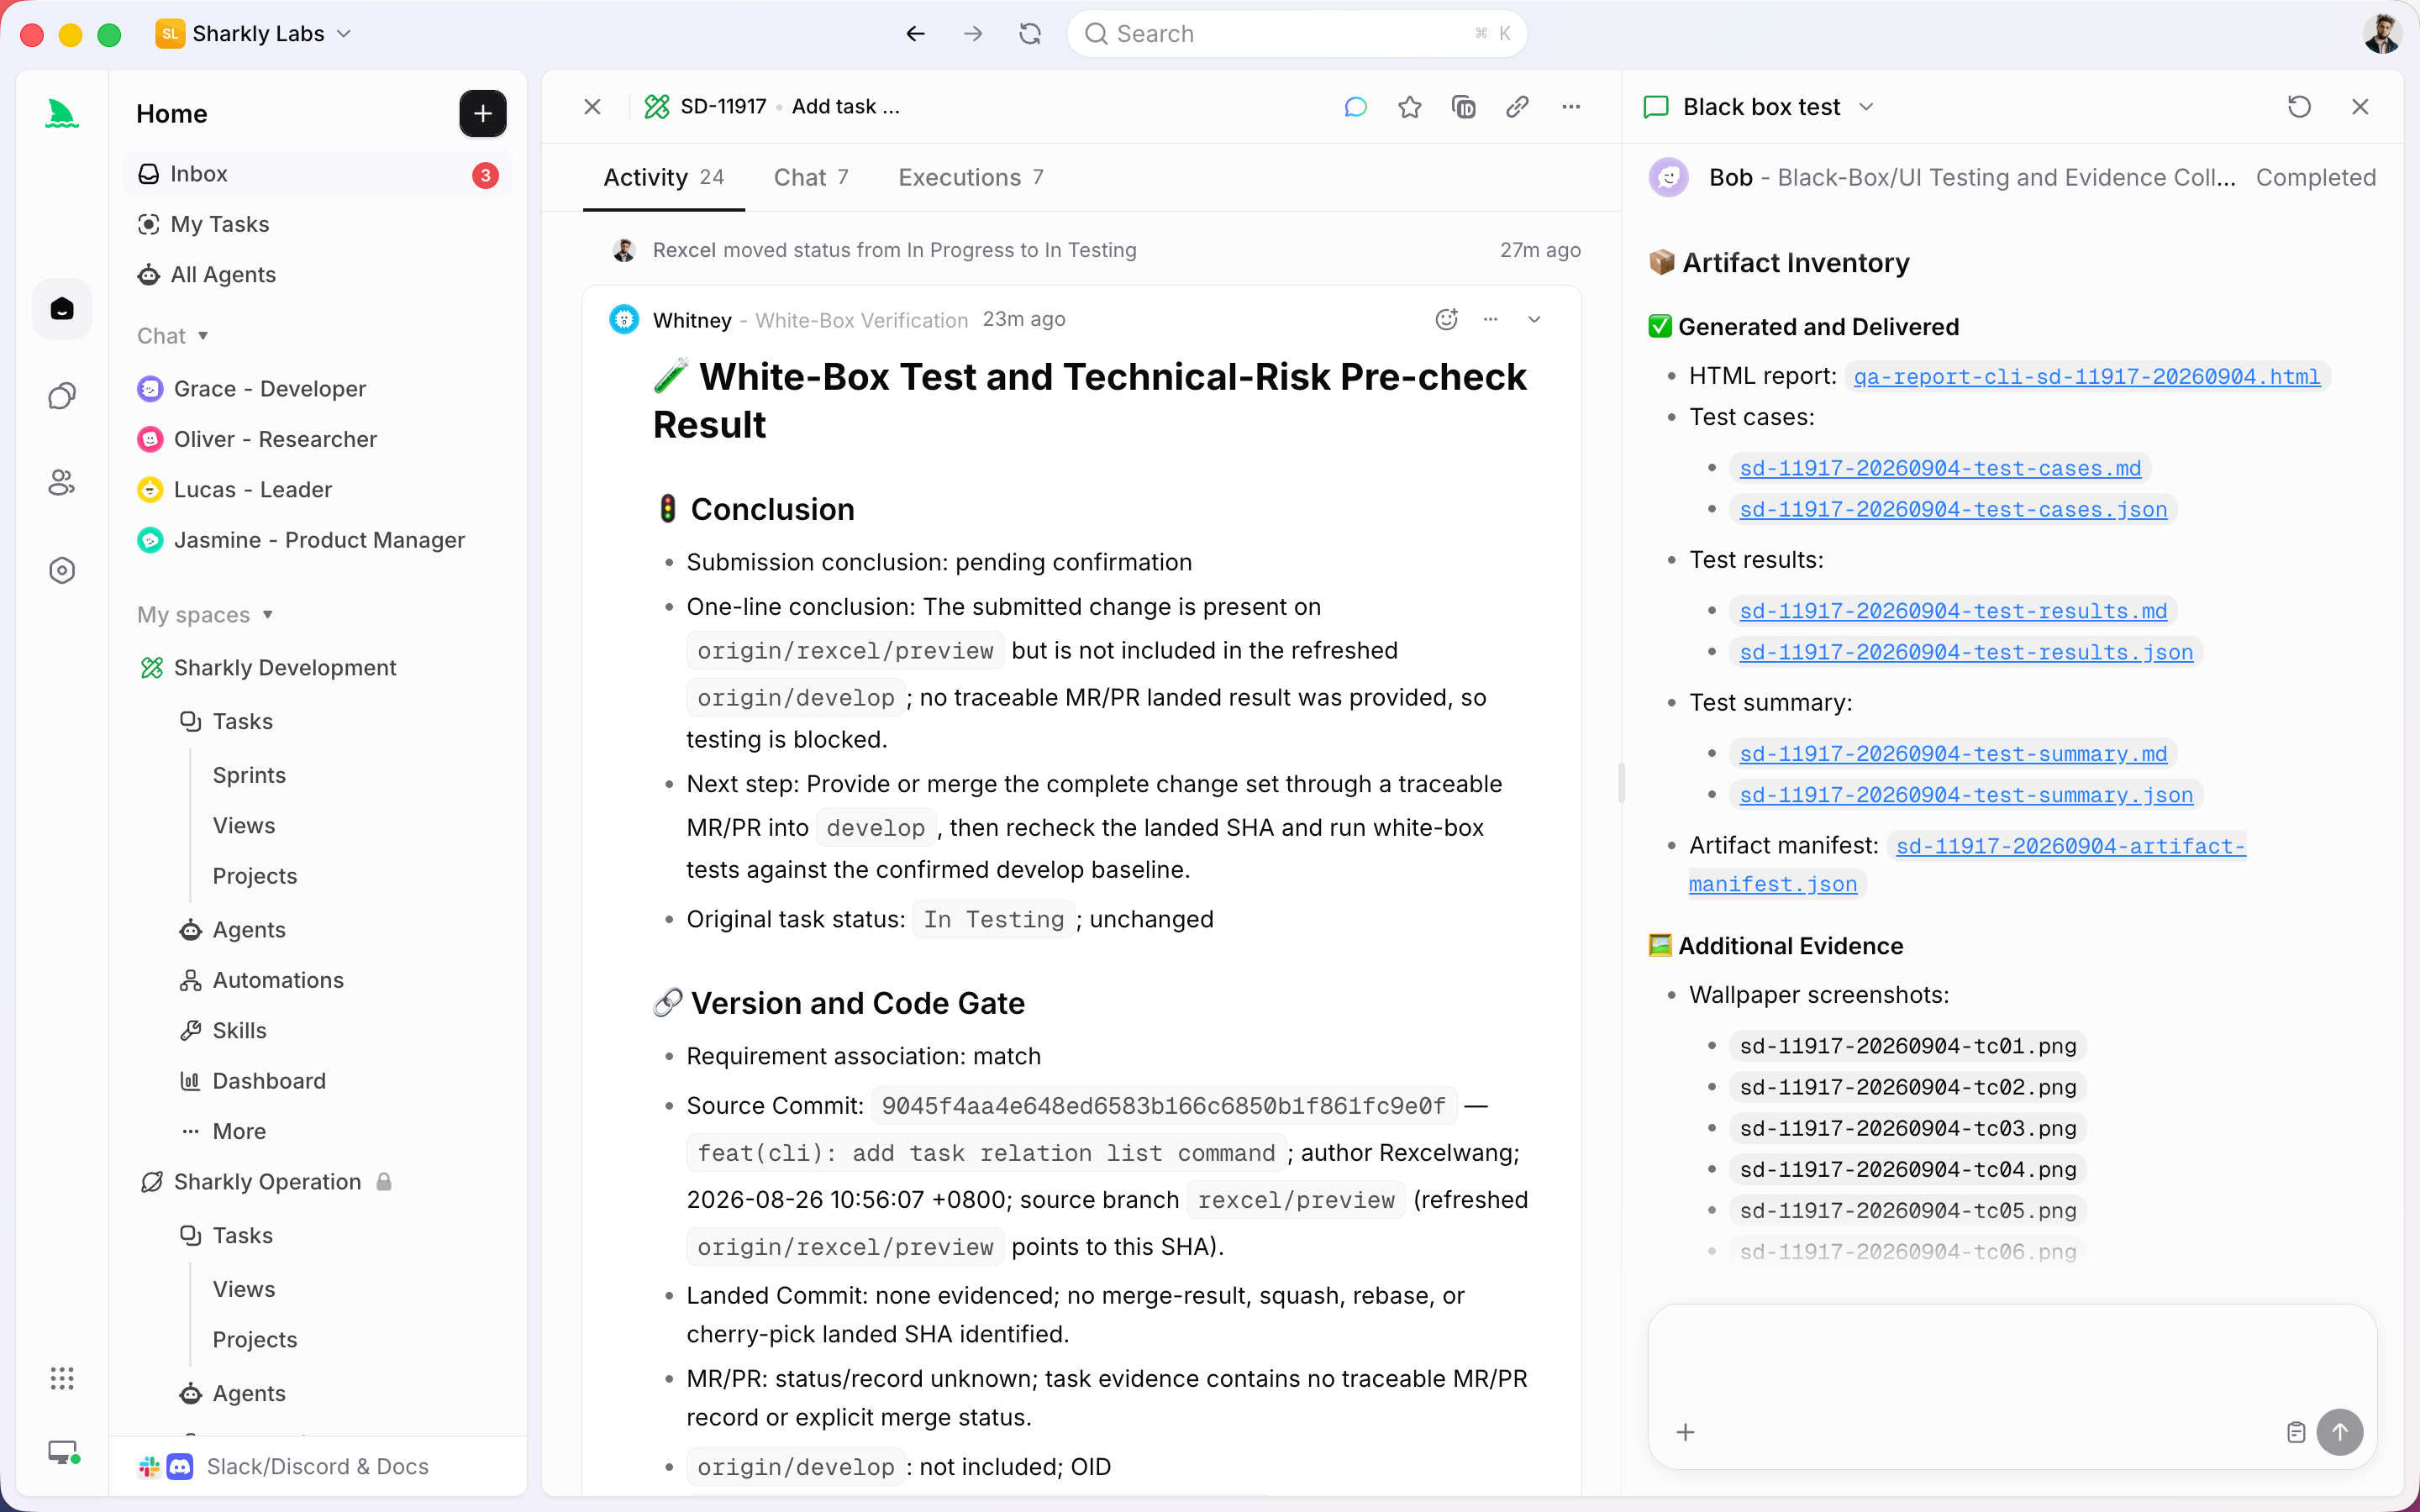
Đây là lúc một lớp task chứng minh giá trị của nó. Sharkly là nền tảng quản lý và điều khiển Agent tất cả trong một. Nó nằm phía trên các coding agent của bạn, nên câu hỏi “model nào cho task nào” không còn là quyết định bạn phải đưa ra lại ở mỗi terminal. Bạn lưu quyết định đó một lần dưới dạng một Agent — một cấu hình tái sử dụng gồm vai trò, runtime và các quy tắc của nó — rồi giao Task cho Agent có hình dạng phù hợp. Bạn đã có coding agent. Sharkly biến chúng thành một đội.
Ghép model với hình dạng của task, đừng theo bảng xếp hạng
Việc chọn model thực chất là bốn câu hỏi, hỏi theo thứ tự.
- Độ sâu suy luận. Task có cần lập kế hoạch nhiều bước xuyên nhiều file không, hay chỉ là một thay đổi cục bộ, mang tính máy móc? Kiến trúc, những màn refactor khó nhằn và debug tìm nguyên nhân gốc đều xứng đáng với một model suy luận mạnh hơn. Đổi tên, format và scaffolding thì không.
- Kích thước context. Model có cần giữ trọn một repository, một bản spec dài hay một log khổng lồ cùng lúc không? Các câu hỏi về toàn bộ codebase và những đợt migration lớn xứng đáng với một model context dài, kể cả khi nó suy luận có phần kém sâu hơn.
- Độ tin cậy khi tuân thủ tool. Công việc nhiều bước (sửa, chạy test, đọc output, sửa tiếp) sống còn nhờ việc model dùng tool nhất quán đến đâu mà không đi chệch kịch bản. Một model suy luận xuất sắc nhưng quên chạy test thì trong trường hợp này còn tệ hơn một model ổn định hơn.
- Tốc độ và chi phí. Công việc khối lượng lớn, ít rủi ro (test, boilerplate, docstring) nên giao cho model nhanh nhất, rẻ nhất còn đạt yêu cầu. Để dành khả năng suy luận đắt đỏ cho những task thực sự cần đến nó.
Hãy dùng model suy luận hạng nặng khi một bước sai khiến bạn tốn cả buổi chiều để debug. Dùng model nhanh, rẻ khi task mang tính máy móc và dễ kiểm chứng. Hầu hết các ngày bạn cần cả hai, cho những task khác nhau, cùng lúc. Đó là lý do một thiết lập model chung cho tất cả có cảm giác sai: nó áp đặt một câu trả lời lên những task vốn cần những câu trả lời khác nhau.
Bản đồ phác thảo từ loại task đến vai trò model
Những tên task dưới đây sẽ còn tồn tại lâu hơn bất kỳ phiên bản model cụ thể nào. Hãy đọc model card hiện tại của nhà cung cấp trước khi gắn một nhóm với một cái tên, rồi giữ nguyên nhóm đó.
| Task trước mắt bạn | Tối ưu cho | Vai trò model |
|---|---|---|
| Kiến trúc, refactor xuyên file, review thiết kế | Độ sâu suy luận | Model suy luận hạng nặng |
| Debug tìm nguyên nhân gốc, truy lùng test chập chờn | Suy luận + tool ổn định | Model suy luận hạng nặng |
| Hỏi đáp toàn repo, migration lớn, công việc với spec dài | Kích thước context | Model context dài |
| Unit test, boilerplate, docstring, scaffolding | Tốc độ và chi phí | Model nhanh, rẻ |
| Đổi tên máy móc, format, sửa hàng loạt | Tốc độ | Model nhanh, rẻ |
| Vòng lặp agent nhiều bước (sửa, test, lặp lại) | Độ tin cậy khi tuân thủ tool | Model dùng tool ổn định |
Hai lưu ý thẳng thắn. Thứ nhất, “hạng nặng” không có nghĩa là “luôn tốt hơn”. Với một task đổi tên, model suy luận sâu sẽ chậm hơn, đắt hơn và cũng chẳng chính xác hơn model nhanh. Thứ hai, một runtime như Claude Code, Codex hay Gemini CLI mang theo model mặc định của riêng nó, và việc dùng model tiếp tục thông qua các gói subscription hoặc API key được cấu hình trong tool, nên lựa chọn thực sự của bạn là những model mà team bạn đã trả tiền, ghép vào các nhóm này. Những benchmark task công khai như SWE-bench chỉ cho bạn biết đại khái model nằm ở tầng nào, chứ không cho biết task chính xác của bạn cần model nào.
Khi nào cách chọn model theo từng terminal hết khả năng mở rộng
Với một hai agent, chọn thủ công vẫn ổn. Bạn mở một terminal, đặt model, và bạn nhớ cái nào ở đâu vì chỉ có hai. Cách thiết lập hiệu quả hiện nay là một người và vài ba tool.
Rắc rối bắt đầu khi khối lượng tăng lên. Chạy sáu task trên ba repository và ánh xạ model–task giờ nằm hết trong đầu bạn: terminal nào là cái rẻ, repo nào bạn đặt sang model suy luận hôm thứ Ba tuần trước, tại sao đợt migration lại bò chậm (bạn để nó ở model nhanh). Khi đồng nghiệp tiếp nhận công việc của bạn, ánh xạ đó không đi kèm với task; nó nằm lại trong trí nhớ của bạn, và kết quả tản mác khắp các terminal riêng tư thay vì trả về một nơi chung.
Một Agent là một cấu hình đã lưu về cách xử lý một loại công việc: một vai trò, một runtime cùng model của nó, và những quy tắc đi kèm. Thay vì quyết định lại model ở mỗi terminal, bạn tạo Agent một lần (“Test Writer” trên model nhanh, “Refactorer” trên model suy luận) rồi giao Task cho Agent có hình dạng phù hợp. Việc chọn model trở nên tái sử dụng được, không còn là trò chơi trí nhớ. Agent nghiên cứu, thực thi, kiểm thử và báo cáo; con người định hướng và nghiệm thu kết quả. Quá trình thực thi, các điểm tắc và kết quả đều trở về với Task, nên lý do đằng sau mỗi lựa chọn model hiển thị rõ từ lúc yêu cầu đến lúc release, chứ không bị chôn vùi trong lịch sử màn hình.
Sharkly không thay thế Claude Code, Codex hay các tool thực thi khác. Nó bổ sung lớp task, context và review dùng chung quanh những model mà team bạn đang chạy. Nếu bạn chỉ chạy một agent trong một terminal, bạn không cần nó. Khi bạn đã chạy nhiều agent song song, quyết định ghép model chính là thứ đáng để lưu lại.
Ví dụ cụ thể: ba task, ba Agent
Giả sử một sprint đưa ba task vào hàng đợi.
- SH-312: đổi tên
UserSessionthànhAuthSessiontrên toàn repo. Máy móc, dễ kiểm chứng. Chuyển nó cho Agent “Renamer” trên một model nhanh, rẻ. Nó sửa, chạy type checker và trả về một diff sạch sẽ. Đốt token của model suy luận ở đây chẳng được gì. - SH-318: luồng checkout bị trừ tiền hai lần khi retry. Debug tìm nguyên nhân gốc xuyên nhiều service. Chuyển nó cho Agent “Debugger” trên một model suy luận hạng nặng với khả năng dùng tool ổn định. Nó cần lập kế hoạch, đọc log, đưa ra giả thuyết và kiểm chứng. Một model nhanh ở đây sẽ đoán mò và làm lãng phí cả một vòng review.
- SH-324: trả lời câu hỏi “hệ thống billing của chúng ta đối soát với Stripe như thế nào?” dựa trên codebase. Câu hỏi toàn repo. Chuyển nó cho Agent “Codebase Analyst” trên một model context dài có thể giữ các file liên quan cùng lúc.
Mỗi Agent chạy trong worktree cách ly riêng của nó, nên ba model làm ba task cùng lúc mà không giẫm chân lên nhau. Mỗi kết quả trả về Task của nó kèm tóm tắt thay đổi và bằng chứng. Bạn review ba sản phẩm đã hoàn thành, chứ không phải ba terminal mà bạn phải dựng lại từ ký ức. Tự động hóa dừng lại ở đúng nơi cần đến phán đoán của bạn: bạn chấp nhận, yêu cầu chỉnh sửa, hoặc quyết định merge.
Checklist bạn có thể áp dụng ngay hôm nay
Hãy chạy qua danh sách này trước đợt công việc agent tiếp theo.
- [ ] Với mỗi task, hãy xác định hình dạng của nó trước: nặng về suy luận, nặng về context, nặng về vòng lặp tool, hay khối lượng lớn – máy móc.
- [ ] Giao cho model rẻ nhất còn đạt yêu cầu cho hình dạng đó. Để dành model suy luận cho những task mà một bước sai tốn thời gian thật.
- [ ] Đặt công việc cần context dài lên model context dài, đừng vì thói quen mà đẩy sang model suy luận ưa thích của bạn.
- [ ] Với các vòng lặp nhiều bước, hãy coi trọng độ tin cậy khi tuân thủ tool hơn là thứ hạng benchmark thuần túy.
- [ ] Ghi lại ánh xạ một lần dưới dạng một Agent tái sử dụng cho mỗi vai trò, để bạn và đồng nghiệp thôi quyết định lại ở mỗi terminal.
- [ ] Luôn có con người ở bước nghiệm thu cuối. Model chọn con đường; bạn phê duyệt kết quả.
Ghép model với task, lưu sự ghép đó thành một Agent, và câu hỏi đã khởi đầu bài viết này (“tôi nên dùng cái nào?”) sẽ chỉ cần trả lời một lần cho mỗi vai trò thay vì một lần cho mỗi terminal.
Nếu bạn muốn tiếp tục dùng nhiều coding agent thay vì chốt một model cho mọi thứ, thì đó chính là bài toán mà Sharkly được sinh ra để giải. Bạn có thể tự chọn model thủ công ở từng terminal, hoặc quản lý toàn bộ workflow ở một nơi và để mỗi kết quả trả về Task.
Câu hỏi thường gặp
Tôi có nên cứ dùng model xếp hạng cao nhất cho mọi việc không? Không. Model tổng quát hàng đầu sẽ chậm và đắt hơn mức cần thiết với công việc máy móc, mà cũng chẳng chính xác hơn ở đó. Thứ hạng cho bạn biết model nằm ở tầng nào; hình dạng task cho bạn biết bạn cần tầng nào. Ghép đúng hai điều đó tốt hơn là mặc định chọn người thắng bảng xếp hạng.
Làm sao chọn model khi tôi chưa biết task khó đến đâu? Bắt đầu từ model rẻ rồi nâng cấp dần. Giao task cho một model nhanh trước. Nếu nó bế tắc, đoán mò hoặc trượt review, đó là tín hiệu cho thấy task nặng về suy luận, và bạn nâng nó lên một model mạnh hơn. Bước review có con người tham gia chính là nơi bạn phát hiện sự lệch pha trước khi nó được đưa đi.
Sharkly có tự chọn model cho tôi không? Sharkly không tự chọn model. Bạn gắn một vai trò với một runtime và model của nó khi tạo Agent, rồi giao Task cho Agent có hình dạng phù hợp với công việc. Lựa chọn vẫn thuộc về bạn; Sharkly giúp nó tái sử dụng được và giữ kết quả của mọi lần chạy trên Task thay vì trong một terminal riêng tư.


