
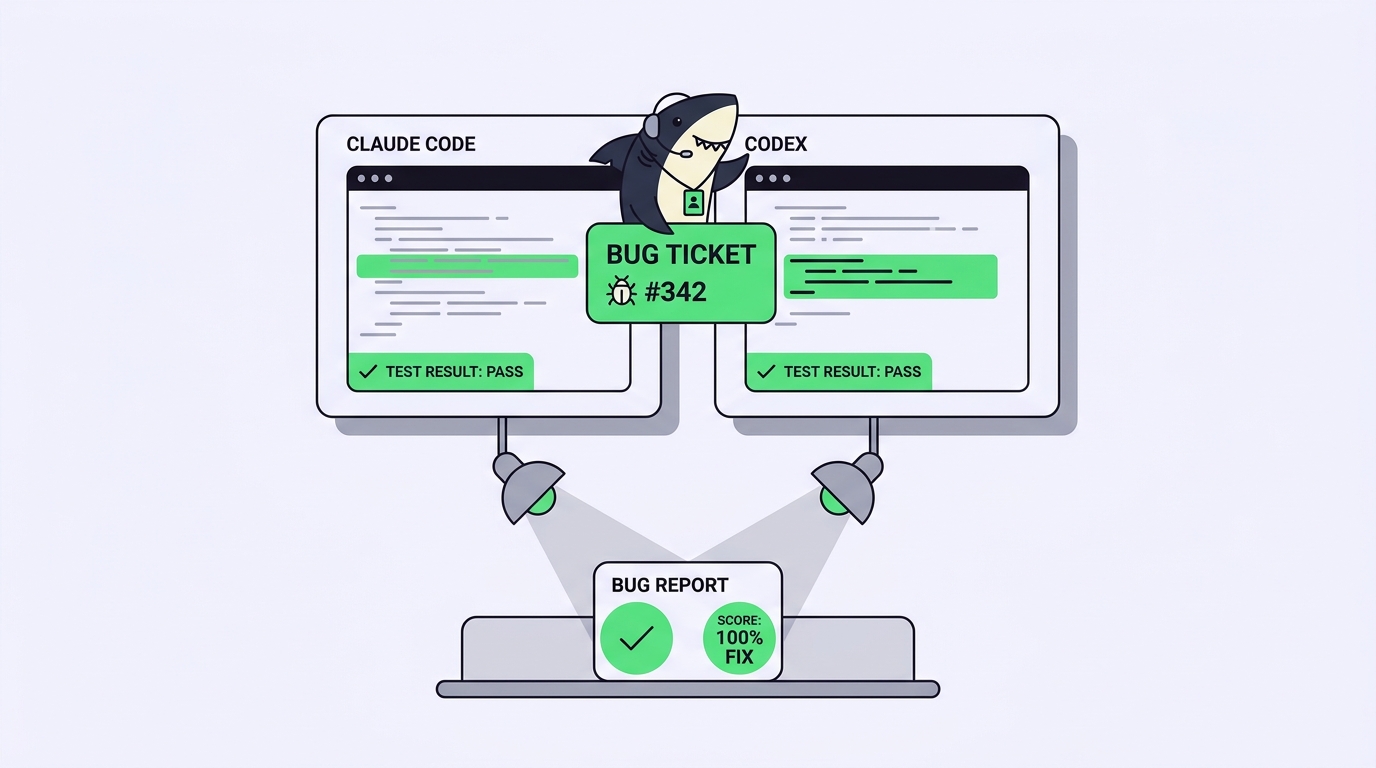
لديك خلل برمجي حقيقي مفتوح، ووكيلان قادران على إصلاحه: Claude Code وCodex. تمتلئ علامات التبويب بالآراء حول أيّهما أذكى، لكن لا شيء منها يخبرك بأيّهما توجّه نحو هذا الخلل، في هذا المستودع، اليوم. وأرقام المعايير العامة لا تفعل ذلك أيضًا؛ فجدول الترتيب يقيس مجموعة ثابتة من المسائل مفتوحة المصدر ضمن بيئة اختبار مضبوطة. أما خللك البرمجي فهو مسألة خاصة: أعرافك أنت، واختبارك المتقلّب، والوحدة التي لا يفهمها سوى شخص واحد.
الطريقة الصادقة للإجابة عن سؤال «Claude Code أم Codex» هي تشغيل كليهما على الخلل نفسه، في الظروف نفسها، ثم قراءة ما يعيده كل منهما. يبدو الأمر بسيطًا، لكنه يتحول سريعًا إلى فوضى: وكيلان يحرّران الملفات ذاتها، ونافذتا طرفية، ومجموعتان من مخرجات الاختبارات، ولا طريقة نظيفة لمقارنتهما جنبًا إلى جنب. المقارنة التي تريدها تدور حول الوكيلين، أما العمل الذي ينتظرك فهو منعهما من التصادم.
هذا التصادم هو ما يزيله Sharkly. Sharkly منصة شاملة لإدارة الوكيل وإصدار الأوامر: تُسنِد المهمة نفسها إلى وكيلين مختلفين، فيعمل كل منهما على حاسوب متصل داخل شجرة عمل معزولة خاصة به، ثم تعود كل عملية تشغيل بفارقها ونتائج اختباراتها ومراجعتها إلى مكان واحد. Sharkly ليس بديلًا عن Claude Code أو Codex، وليس بيئة اختبار معيارية. إنه الطبقة التي تجعل المواجهة المباشرة العادلة ممكنة دون فتح نافذة طرفية ثانية. يشرح هذا الدليل المنهج، ومعيارًا للتقييم خاصًا بخلل واحد، ومواضع تفوّق كل وكيل عادةً.
الإجابة السريعة
لمقارنة Claude Code وCodex بصدق، أعطِ كليهما الخلل نفسه، ونقطة البداية نفسها في السجلّ، واختبار القبول نفسه، مع تشغيل كل منهما بأفضل إعداداته. ثم قيّم ما يعود إليك: هل ينجح الإصلاح؟ هل يبقى الفارق ضمن النطاق؟ وكم يستغرق التغيير من وقتك لمراجعته؟ الوكيل الذي يفوز في خلل واحد إنما فاز في خلل واحد فقط. طبّق المنهج على عدة أخطاء قبل أن تثق بالحكم.
لماذا يُعدّ سؤال «أيّهما أفضل» سؤالًا خاطئًا
كلٌّ من Claude Code وCodex وكيل برمجي يعمل من الطرفية أولًا. يقرأان مستودعك، ويحرّران الملفات، وينفّذان الأوامر، ثم يعيدان التقرير. يختلفان في طريقة إعدادهما وفي سلوكهما تحت الضغط، لكن لا واحد منهما متقدّم بشكل مطلق في العمل الذي يملأ دورة تطوير عادية.
ترتيب عالمي واحد يخفي الجزء الذي يهمّك. سؤال «أيّهما أفضل» يختزل كل شيء في رقم لا يصمد أمام قواعدك البرمجية. أما «أيّهما أفضل في هذا النوع من الأخطاء، في مستودعي، وقت المراجعة» فسؤال قابل للإجابة، وهو النسخة الوحيدة الجديرة بالجهد. وإذا كنت لا تزال تحدد النموذج الذي ينبغي أن يعمل عليه كل وكيل، فإن مطابقة النماذج بأدوار الوكلاء سؤال أولى أفضل من أي جدول ترتيب.
شغّل كليهما على الخلل نفسه: منهج يمكنك الوثوق به
المقارنة العادلة تُبقي كل شيء ثابتًا عدا الوكيل. أربع قواعد تحقّق ذلك.
- اختر خللًا حقيقيًا واحدًا، لا طلبًا تجريبيًا. انتقِ عيبًا محدودًا من قائمة مهامك المتراكمة، مع اختبار قبول يمكنك تشغيله وفارق يمكنك قراءته في بضع دقائق. اكتبه كما يفعل نظام تتبّع المهام لديك: مهمة مثل
SH-312: fix the timezone drift in the invoice export. أما «ابنِ تطبيق مهام» فلا يخبرك بشيء عن كودك. - أعطِ كليهما المدخلات نفسها. الوصف نفسه للمهمة، ونقطة البداية نفسها، ومعايير القبول نفسها. فإذا حصل Claude Code على طلب أغنى من Codex، فأنت تقيس جودة طلبك لا جودة الوكيل.
- شغّل كلًّا منهما في أفضل حالاته. امنح Claude Code ملف
CLAUDE.mdالخاص به، وامنح Codex ملفAGENTS.mdوإعداداته، وأعطِ كلًّا منهما الأذونات والنموذج الذي توصي به وثائقه. مقارنة وكيل مُعدّ جيدًا بآخر عاري الإعداد تقيس أيّهما تكبّدت عناء ضبطه. - اعزل عمليتَي التشغيل. يحتاج كل وكيل إلى نسخة عمل خاصة به. وكيلان في نسخة سحب واحدة سيكتب أحدهما فوق الآخر، وستقضي العصر في فكّ تداخل الدمج بدل قراءة محاولتين نظيفتين. وهذا بالضبط ما تُستخدم من أجله أشجار العمل المعزولة.
شغّل المحاولتين، ثم تخلَّ عن الفرع الخاسر. فتحتفظ بالإصلاح الذي تثق به والدليل على سبب اختياره.
معيار تقييم لإصلاح خلل واحد
سؤال «هل نجح؟» لا يمنحك سوى معلومة واحدة. الإصلاح الحقيقي يحدده أكثر من ذلك، وتدوين معيار التقييم قبل النظر إلى النتائج يُبقي المقارنة صادقة.
| ما الذي تقيّمه | السؤال الذي يجيب عنه | لماذا يهمّ |
|---|---|---|
| الصحة | هل ينجح اختبار القبول، وهل يبقى كل شيء آخر سليمًا؟ | الحد الأدنى. الوكيل الذي يطبع «تم» لم ينجح في أي شيء. |
| الالتزام بالنطاق | هل لمس الفارق ما يحتاجه الخلل فقط؟ | الإصلاح الذي يعيد كتابة أربعة ملفات غير ذات صلة يكلّف مراجعته أكثر مما يوفّر. |
| جودة الاختبار | هل أضاف الوكيل اختبارًا يكشف هذا التراجع أو حدّثه؟ | إصلاح بلا اختبار هو إصلاح ستعيده مرة أخرى. |
| زمن المراجعة | كم استغرقت من الوقت لتثق بالتغيير؟ | غالبًا ما يكون عنق الزجاجة الحقيقي، ويسهل تجاهله حتى يلتهم فترة ما بعد الظهر. |
| الصدق | هل نبّه الوكيل إلى حدوده وافتراضاته؟ | التشغيل الذي يمكنك الوثوق به هو الذي يخبرك بما لم يتحقق منه. |
قيّم المحاولتين وفق هذه المعايير الخمسة نفسها، على الخلل نفسه، وسيتوقف الفائز عن كونه مسألة ذوق. ويستحق زمن المراجعة وزنًا إضافيًا: فقد ينتهي وكيلان كلاهما في عشرين دقيقة، لكن التحقق من كل منهما يستهلك ساعة كاملة. وهذه الساعة غالبًا هي الحد الحقيقي لما يستطيع الفريق استيعابه من عمل الوكلاء.
أين يميل كل منهما إلى التفوّق
لا أرقام مختلقة هنا، بل ما ينبغي أن تراقبه فقط. يعتمد Claude Code على ذاكرة المشروع في ملف CLAUDE.md ويميل إلى الالتزام بأعراف المستودع في التغييرات التي تمسّ عدة ملفات، وهو ما يظهر في إعادة الهيكلة الممتدة عبر وحدات متعددة. أما Codex فيرتاح في بيئة معزولة قائمة على الإعدادات، وكثيرًا ما ينظّم الكود الجديد واختباراته بإتقان، وهو ما يظهر في الإصلاحات المحدودة. وكلاهما يشرد أكثر كلما كبر المستودع، وكلاهما سيسلّمك بثقة تغييرًا لا ينجح. شغّل خللك الخاص قبل أن تعتبر أيًّا من هذا أمرًا محسومًا.
وهنا الجزء الصادق الذي تتجاهله معظم المقارنات. إذا كنت تستخدم وكيلًا واحدًا فقط وتعيش في نافذة طرفية واحدة، فلست بحاجة إلى منصة لتطبيق هذا. جلسة Claude Code مضبوطة جيدًا في شجرة عمل واحدة، أو تشغيل واحد لـCodex، كافٍ، ويمكنك تفقّد الفارق بنفسك. لكن المعادلة تتغير لحظة أن تصبح المقارنة بين وكيلين، وعلى أكثر من خلل واحد، مع رغبة في الحصول على النتائج بشكل يستطيع شخص آخر قراءته.
إجراء المواجهة المباشرة في Sharkly
هنا تستحق Sharkly مكانتها. تُنشئ مهمة واحدة للخلل، ثم تُسندها إلى وكيل Claude Code وإلى وكيل Codex معًا. يعمل كل وكيل على حاسوب متصل داخل شجرة عمل خاصة به، فلا تلمس المحاولتان الملفات نفسها أبدًا. تعود عمليات التنفيذ والعوائق والنتائج وملخّص التغيير إلى الخط الزمني للمهمة، فتقرأ الفارقين ونتائج الاختبارين مقابل بعضهما في عرض واحد، بدل أن تحاول تذكّر أي نافذة طرفية كانت لأيّ وكيل.
ويبقى تقسيم العمل واضحًا. يبحث الوكلاء وينفّذون ويختبرون ويقدّمون التقارير، بينما يحدّد البشر الاتجاه ويقبلون النتيجة. تتوقف الأتمتة عند النقطة التي يلزم فيها حكمك، وتُبقي Sharkly السياق والتقدّم والعوائق والنتائج والمراجعة البشرية ظاهرة من الطلب حتى الإصدار. أنت لا تسلّم القرار إلى أداة، بل تحصل على المحاولتين معروضتين أمامك بحيث لا تستغرق المقارنة سوى دقائق. وإذا رغبت في الاحتفاظ بالوكيلين للعمل اليومي بدل تجربة عابرة، فإن تشغيل Claude Code وCodex معًا على قاعدة كود واحدة هو سير العمل نفسه، لكن على نحو معتاد.
أيّهما تختار، حسب حجم الفريق
يعتمد الاختيار الصحيح على من يقوم بالاختيار وعلى ما يجب أن تصمد أمامه المقارنة.
| حجم الفريق | الأكثر وزنًا | ما الذي تختاره |
|---|---|---|
| مطوّر فردي | زمن المراجعة والتنفيذ على جهازك | أي وكيل تراجعه أسرع؛ فأنت القارئ الوحيد |
| فريق صغير | التشغيل المتوازي والرؤية المشتركة | كلاهما، عبر إسنادهما إلى مهمة واحدة ليرى الجميع الأدلة نفسها |
| فريق المنصات | التكاملات والحياد تجاه المزوّد | احتفظ بكليهما؛ فعملية العمل يجب أن تصمد أيًّا كان الوكيل المتصدّر في الربع القادم |
هذا الصف الأخير هو السبب الحقيقي لإجراء المقارنة بدل اختيار مفضّل والدفاع عنه. فقد لا يكون أفضل وكيل هذا الربع هو الأفضل في الربع القادم، وإعادة بناء عمليتك كلما تغيّر المتصدّر ضريبة بحد ذاتها. أما المقارنة على أخطائك أنت، ضمن سير عمل يشغّل أي وكيل، فتُبقيك حرًّا في التبديل حين تتغير الإجابة.
إذا كنت تريد الاستمرار في استخدام عدة وكلاء برمجيين بدل الالتزام بمنظومة واحدة، فهذه هي المسألة التي صُممت Sharkly من أجلها. نزّل Sharkly، ووصّل حاسوبًا واحدًا، وأسند الخلل الحقيقي نفسه إلى الوكيلين. الحكم الذي ستحصل عليه يخصّ قاعدة كودك أنت، وهي الوحيدة القادرة على التنبؤ بأسبوعك.
الأسئلة الشائعة
هل Claude Code أم Codex أفضل في إصلاح الأخطاء؟ لا واحد منهما يتفوّق بشكل عام. على الخلل نفسه، وبأفضل إعدادات كل منهما، يتقدّم أحدهما عادةً على الآخر، ويتبدّل المتقدّم حسب نوع الخلل وحجم المستودع. شغّل كليهما على عيب حقيقي من قائمة مهامك المتراكمة، وقيّم الصحة والنطاق والاختبارات وزمن المراجعة.
هل يمكنني تشغيل Claude Code وCodex على الخلل نفسه في الوقت نفسه؟ نعم، إذا كانت لكل منهما نسخة عمل خاصة به. فالوكيلان في نسخة سحب واحدة يكتب أحدهما فوق الآخر. امنح كلًّا منهما شجرة عمل معزولة، أو أسند المهمة إلى كليهما في Sharkly ودع كل وكيل يعمل على حاسوبه الخاص.
هل تخبرني نتائج المعايير بالوكيل الذي ينبغي أن أستخدمه؟ إنها تخبرك بأي الوكلاء يستحق التجربة، لا بكيفية تصرّف أحدهم في مستودعك. فمجموعة بيانات عامة لا يمكن أن تحتوي مكتباتك الداخلية، أو إعدادات فحص الكود لديك، أو وحدتك غير المختبرة. تعامل مع جدول الترتيب كمُرشِّح، ثم أجرِ المقارنة التي تهمّ فعلًا على كودك أنت.
هل يستبدل Sharkly كلاً من Claude Code وCodex؟ لا. Sharkly هو طبقة الإسناد والسياق والمراجعة المحيطة بالوكلاء البرمجيين الذين يستخدمهم فريقك بالفعل. يقوم الوكلاء بالتنفيذ، بينما تدير Sharkly المهمة، وتُبقي عمليات التشغيل ظاهرة، وتترك القبول للبشر.
كم عدد الأخطاء التي ينبغي أن أقارنها قبل أن أقرر؟ خلل واحد يخبرك عن خلل واحد. طبّق المنهج على مجموعة من أنواع العيوب قبل أن تثق بنمط ما، واحتفظ بمعيار التقييم نفسه في كل مرة لتتراكم النتائج.


