
أربعة وكلاء برمجيين ينهون عملهم خلال الساعة نفسها ويفتحون أربعة طلبات سحب. أحدها يمسّ مسار إعادة محاولة الفوترة، وآخر يعيد تسمية دالة مساعدة في الاختبارات، وثالث يضيف ترحيلاً، ورابع يصلح خطأً مطبعياً في ملف README. عنق الزجاجة ليس الكود ولا الاختبارات، بل السؤال الذي يجيب عنه المرء قبل أن يقرأ سطراً واحداً من الفروقات: بأيّها أبدأ؟ سبق أن قلنا إن المراجعة البشرية هي عنق الزجاجة بمجرد أن تعمل الوكلاء على التوازي. تتناول هذه التدوينة الجانب الميكانيكي من تلك المشكلة، أي ترتيب قائمة الانتظار، وكيف يمكن لنموذج قرار مثل Jev أن يرفع هذا العبء عن المراجع دون أن ينتزع منه المراجعة.
ما هو Jev
Jev هو نموذج System One من TypeSafe AI: ترسل إليه قطعة من الحالة ومجموعة من الأسئلة المصنّفة، فيعيد إجابة عن كل سؤال مع احتمال معايَر، ولا يعيد نصاً حراً أبداً. وللتوضيح بشأن الاسم، هذا Jev نموذج TypeSafe، لا اليوتيوبر ولا لقاح التهاب الدماغ الياباني. يصفه منشور الإطلاق الخاص بـTypeSafe بأنه «حالة غير مهيكلة تدخل، وقرارات احتمالية مصنّفة تخرج». أما واجهة API فهي نقطة نهاية واحدة، POST https://api.typesafe.ai/v1/systemone، مفتاح Bearer، والطراز jev-latest، وثلاثة أنواع من الأسئلة: noul (احتمال نعم/لا)، وchoice (اختيار واحد من حتى 255 خياراً)، وscore (موضع على سلّم تقييم من 2 إلى 10 مستويات). نص فقط، 64 ألف رمز لكل طلب منها 32 ألفاً للحالة، و0.042 دولار لكل مليون رمز إدخال، والمخرجات بلا رسوم. تتناول تدوينتنا الشقيقة عن Jev كطبقة قرار لوكلاء البرمجة النموذج بشكل عام؛ أما هنا فنستخدمه لمهمة واحدة.
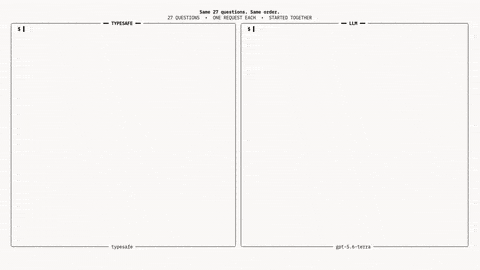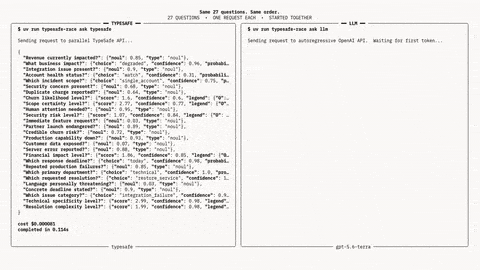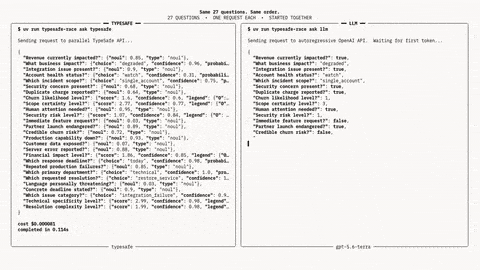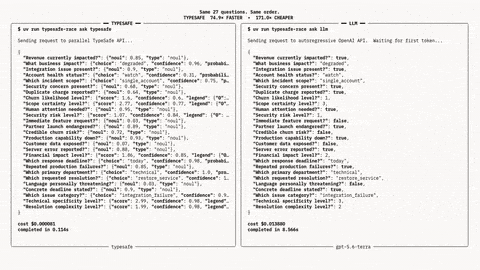
أسئلة المراجعة الثلاثة
كل طلب سحب يفتحه وكيل برمجي يطرح الأسئلة الثلاثة نفسها، وكل سؤال يقابل بدائية واحدة. والحالة واحدة في الأسئلة الثلاثة: ملخص الفروقات، ونتيجة الاختبارات، والمسارات المتأثرة. ليس الفروقات كاملة. فالملخص يُبقي الطلب ضمن الميزانية ويُبقي النموذج مجيباً عن سؤال التوجيه بدل أن يعيد مراجعة الكود.
هل يحتاج هذا إلى شخص قبل الدمج؟ سؤال noul. هذا هو المُرشِّح. يقرر ما إذا كان طلب السحب يدخل قائمة الانتظار البشرية أصلاً أو ينتظر في مسار منخفض الأولوية.
أي مراجع أو أي قائمة انتظار؟ سؤال choice بين قوائم الانتظار التي يشغّلها فريقك فعلاً. وتحمل الإجابة الاختيار مع التوزيع الكامل، لذا فإن انقساماً بنسبة 0.48 / 0.44 بين قائمتين يخبرك بأن طلب السحب يقع على حدود الملكية، وهذه معلومة تستحق المعرفة بحد ذاتها.
ما مقدار المخاطرة التي يحملها؟ سؤال score على سلّم تقييم مرتب. والنتيجة موضع مرجّح بالاحتمالات، لذا قد يستقر تغيير عند 2.6 بين «تغيير منطقي مغطى بالاختبارات» و«يمسّ المصادقة أو الفوترة أو البيانات». وهذا الرقم هو مفتاح الترتيب في قائمة الانتظار.
طلب واحد يجيب عن الأسئلة الثلاثة:
{
  "model": "jev-latest",
  "state": {
    "task": "SH-418 Fix double charge on retried webhook",
    "diff_summary": "billing/retry.ts adds an idempotency key check; new test covers the retry path",
    "tests": "58 passed, 0 failed",
    "touched_paths": ["billing/retry.ts", "billing/retry.test.ts"]
  },
  "questions": {
    "needs_human": {
      "type": "noul",
      "instructions": "Does this change need a person to read it before merge?"
    },
    "queue": {
      "type": "choice",
      "instructions": "Which review queue owns this change?",
      "criteria": {
        "payments": "billing, invoicing, refunds, retries",
        "infra": "deploy, migrations, config",
        "frontend": "UI and client code",
        "docs": "documentation and comments only"
      }
    },
    "risk": {
      "type": "score",
      "instructions": "How much damage can this change do if it is wrong?",
      "criteria": ["cosmetic", "logic change covered by tests", "touches auth, billing, or data"]
    }
  }
}
تتضمن الاستجابة ثلاث إجابات مصنّفة تحت المفاتيح نفسها. بالنسبة إلى SH-418، توقّع needs_human قريباً من 0.9، وqueue تختار payments، وrisk قريباً من أعلى السلّم. فإصلاح إعادة محاولة الفوترة مع اختبارات ناجحة يذهب رغم ذلك إلى مقدمة قائمة انتظار المدفوعات، لأن الاختبارات الناجحة لا تجيب عن سؤال «هل ينبغي أن يقرأ هذا شخص؟».
الحدود وما تفعله كل فئة
لا يكون الاحتمال مفيداً إلا عندما يحوّله الكود إلى إجراء. والفئات أدناه نقطة انطلاق، لا توصية بمستودعك؛ اضبطها بعد أسبوع من التشغيل.
needs_human |
الإجراء |
|---|---|
| 0.85 فأكثر | مقدمة قائمة الانتظار البشرية، مرتبة حسب risk تنازلياً |
| من 0.15 إلى 0.85 | قائمة الانتظار البشرية، مرتبة حسب risk، بعد الفئة أعلاه |
| أقل من 0.15 | مسار منخفض الأولوية؛ ولا يزال شخص ما يدمجه وفق جدوله الخاص |
قاعدتان تحافظان على نزاهة هذا النظام. أولاً، risk في أعلى السلّم يرقّي طلب السحب دائماً إلى الفئة الأولى، مهما قال needs_human. فنموذج بلغت ثقته 0.12 بأن ترحيل مخطط يحتاج مراجعة إنما رأى ملخص فروقات أنيقاً، لا بيئة الإنتاج. ثانياً، سؤال choice الذي يقع أفضل خيارَين فيه ضمن 0.1 من بعضهما يُوجَّه إلى كلتا القائمتين بدلاً من ألا يُوجَّه إلى أيٍّ منهما. فالغموض في الملكية سبب ليُلقي شخصان نظرة على تغيير، لا لئلا يلقياها.
لاحظ ما يبقى بيد الشخص في كل فئة: الدمج. الفئات تغيّر ترتيب القراءة وعمق القراءة، لكنها لا تغيّر أبداً من يقرر.
استخدم Jev لقائمة الانتظار، لا للحُكم
استخدم Jev حين يكون للسؤال مجموعة إجابات ثابتة، وتكون الحالة ملخصاً أميناً، وتريد أن تصرف انتباه الإنسان بترتيب أفضل: من يقرأ هذا، ومتى، وفي أي قائمة انتظار. هذه الأسئلة تظهر مع كل طلب سحب، وهي رخيصة بما يكفي بهذا السعر لطرحها في كل تشغيل.
واستخدم إنساناً، أو نموذجاً لغوياً قادراً على إظهار استدلاله، حين يكون السؤال هو ما إذا كان التغيير صحيحاً. فاحتمال أن تغييراً يحتاج مراجعة ليس مراجعة. فـJev لا يملك مُصرِّفاً ولا مُشغِّل اختبارات ولا وصولاً إلى الملف الذي يقيّمه، بل فقط الملخص الذي أرسلته. ونتيجة 0.96 على «آمن للدمج» سبب قوي لوضع طلب السحب في أعلى قائمة أحدهم، وليست أبداً سبباً لتخطي ذلك الأحد. تقع بوابة الموافقة بعد النموذج، ولا سبيل للنموذج إلى فتحها.
ما بناه المجتمع
خلال أيام من الإطلاق، نشر أحد المطورين jev-review، الذي يصفه ملف README الخاص به بأنه «سير عمل صغير لمراجعة الكود مبني بـTypeSafe Jev». وهو يراجع إما فرق Git أو قاعدة كود كاملة، ويفحص الصحة والأمان والموثوقية والتوافق وتغطية الاختبارات، ويختار مناطق الكود قبل تقييم الأثر، ويطبّق الحدود وسياسات سير العمل في الكود، ويعرض النتائج في لوحة تحكم محلية. ويحرص ملف README على توضيح النطاق: فهو يسمي المشروع «تجربة في تركيب أحكام مصنّفة سريعة ضمن سير عمل مراجعة»، ويقول إنه «لا يدمج بعد تشخيصات المُصرِّف ولا المحللات الساكنة ولا فهرسة المستودع ولا الشروح المولّدة».
وثمة أمران في هذا التصميم يستحقان التقليد: أن التنسيق يقع في الكود وأن Jev لا يجيب إلا عن أسئلة محددة النطاق، وأن العمل مُقسَّم على مراحل، اختر منطقة ثم قيّمها، بدلاً من سؤال عملاق واحد على كامل الفروقات. كما يتوفر Jev على Vercel AI Gateway باسم typesafe-ai/jev عبر experimental_evaluate في AI SDK 7؛ وتشير وثائق Gateway إلى أن هذا متاح عبر AI SDK فقط.
موقع هذا من Sharkly
لا يستدعي Sharkly Jev نيابةً عنك، وهو ليس نموذج قرار. إنه طبقة المهام والحاسوب والسياق والمراجعة المشتركة حول وكلاء البرمجة الذين يشغّلهم فريقك بالفعل. وما تحتاجه قائمة انتظار مرتّبة من هذه الطبقة هو مكان للتشغيل ومكان للوصول.
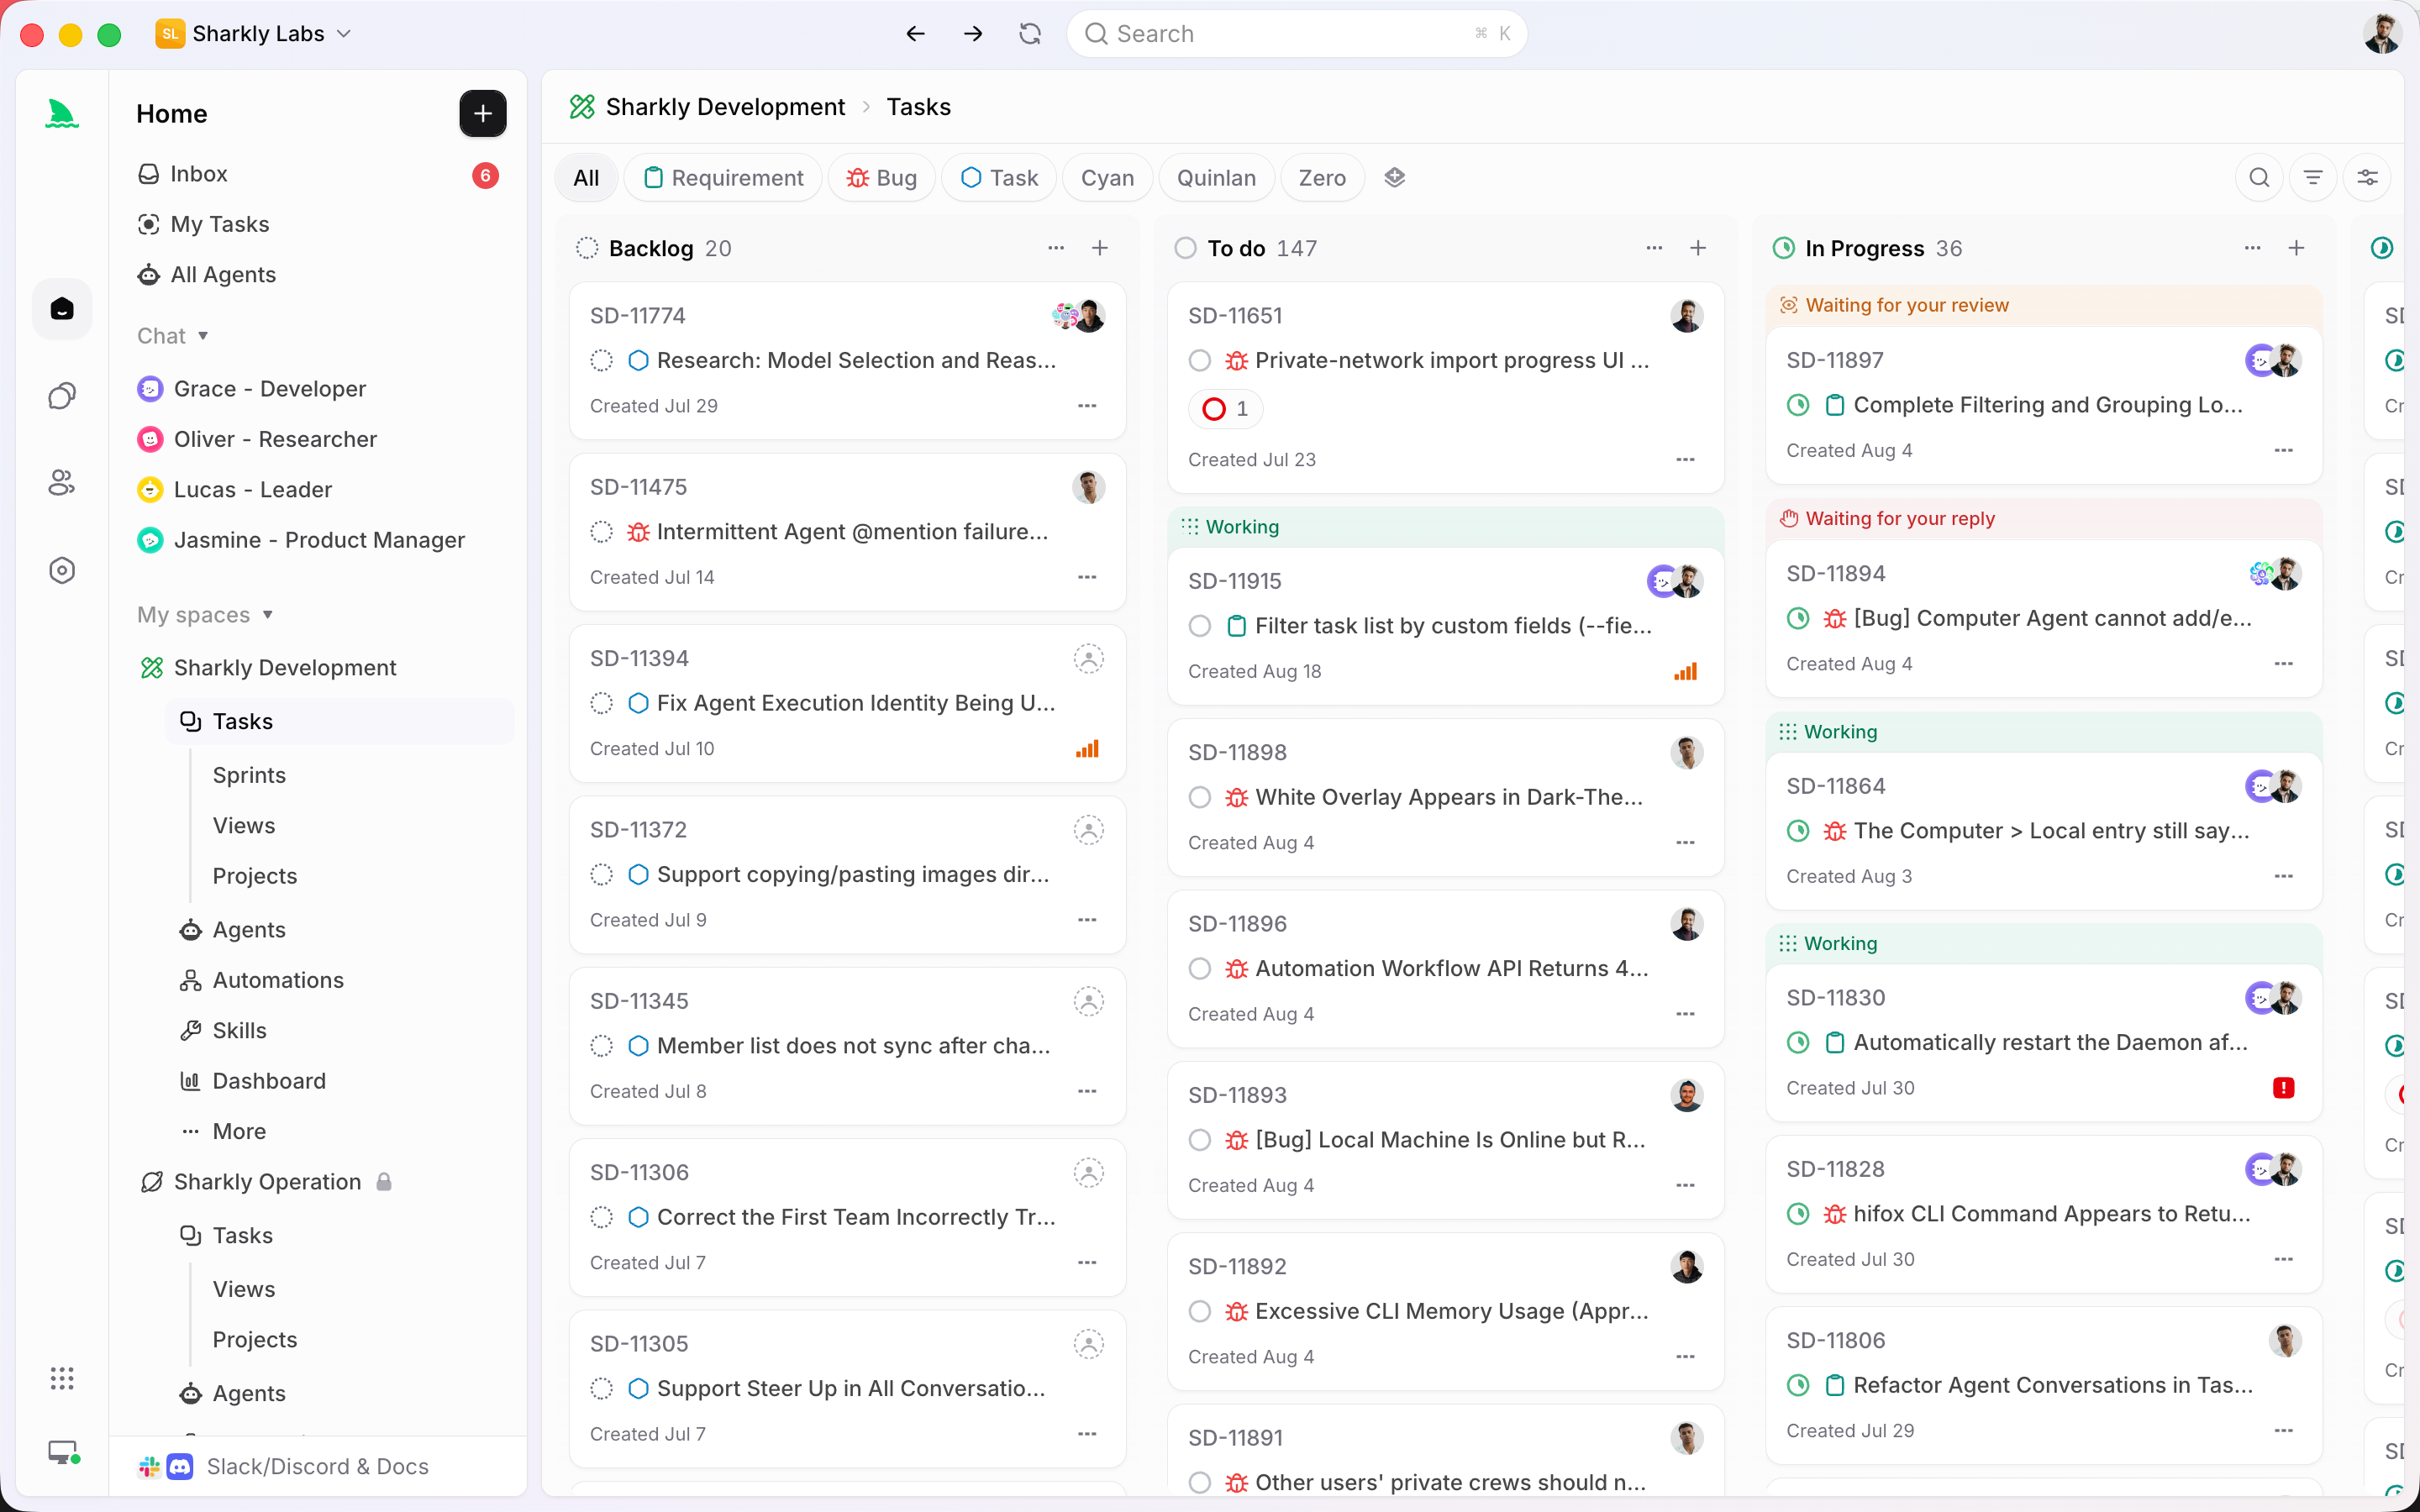
مكان التشغيل هو Automation: قاعدة مملوكة لـSpace تُشغِّل وكيلاً بمجموعة تعليمات عند حدث مُشغِّل، وأحد هذه المُشغِّلات هو انتقال مهمة إلى حالة مختارة. وجّهها إلى الحالة التي يصل إليها وكلاؤك عند فتح طلب سحب، فتصبح التعليمات: اقرأ ملخص الفروقات ونتيجة الاختبارات والمسارات المتأثرة في المهمة؛ واستدعِ Jev بالأسئلة الثلاثة؛ واكتب الإجابات والفئة كتعليق على المهمة؛ واضبط وسمًا لقائمة الانتظار. وتوضح الوثائق صراحةً أن التشغيل المكتمل «ليس وعداً بأن كل نتيجة تجارية لاحقة كانت صحيحة»، وهو الحد نفسه الذي ترسمه فئات المراجعة.
أما مكان الوصول فهو المهمة نفسها. تعود الفئة وقائمة الانتظار ودرجة المخاطرة إلى المهمة حيث ينظر المراجع أصلاً، بجوار ملخص تغييرات التشغيل ونتائج التحقق. يفتح الشخص اللوحة مرتبة حسب المخاطرة ويرى لماذا يقع كل طلب سحب حيث يقع. الوكلاء يفتحون طلبات السحب ويشغّلون الاختبارات ويقدّمون التقارير. والناس يقرأون بالترتيب الذي تقترحه قائمة الانتظار، ثم يقبلون أو يرفضون. الترتيب جاء من احتمال؛ أما القرار فلم يأتِ منه.
وإذا كنت تشغّل بالفعل عدة وكلاء وكانت قائمة انتظار المراجعة هي موضع الألم، فهذا هو سير العمل الذي يُعِدّه الدليل التمهيدي إلى Sharkly: حاسوب واحد، ووكيل واحد، ومهمة واحدة تحمل الأدلة التي يحتاجها الترتيب.
الأسئلة الشائعة
هل يستطيع Jev قراءة الفروقات كاملة بدلاً من ملخص؟
يستقبل حتى 32 ألف رمز من الحالة، لذا تتسع الفروقات الصغيرة. أرسل ملخصاً على أي حال: ففروقات الوكلاء تتجاوز الميزانية بكثير، والملخص يُبقي السؤال على مستوى التوجيه. أما الفروقات الكاملة فهي ما يقرأه الإنسان، وإلى جانبها أدلة على مستوى المهمة.
ماذا لو كتب الوكيل ملخص الفروقات بنفسه؟
حينها قد يكون الملخص خاطئاً لصالح الوكيل، ويرث الترتيب ذلك. فضّل ملخصاً يُنتَج من الفروقات عبر خطوة منفصلة، ودع دائماً درجة risk العليا تتجاوز needs_human المنخفض. وينطبق هنا ما لا تستطيعه مراجعة الكود بالذكاء الاصطناعي: يستطيع النموذج ترتيب ما يُعرض عليه، ولا يستطيع التحقق مما لا يُعرض.
هل تعني الفئة المنخفضة أن طلب السحب يُدمج تلقائياً؟
لا. الفئة المنخفضة تعني أن شخصاً ما يدمجه لاحقاً وفق جدوله الخاص، دون أن يقرأه أولاً في قائمة الانتظار. أما ملكية الدمج، وملكية العمل الذي أنتجه الوكيل، فتبقى لشخص مُسمّى في كل فئة.
هل Jev مجاني عبر Sharkly؟
لا يعيد Sharkly بيع Jev أو أي نموذج آخر؛ فأنت تأتي بمفتاح TypeSafe أو Gateway الخاص بك، تماماً كما تُحتسب التشغيلات على الاشتراكات المرتبطة بـRuntimes لديك. أما Sharkly نفسه فهو مجاني حالياً للمؤسسات التي تضم حتى 5 أشخاص.


