يشير جدول الأسعار بتاريخ 2026-09-22 إلى شكل واضح. ضع GPT-6 Luna بسعر 0.10 دولار لكل مليون رمز إدخال على العمل الذي لا يحبه أحد، وضع Claude Opus 5.5 بسعر 4 دولارات على الوكيل الذي يتحقق منه، فتحتفظ بمعظم الإنتاجية مقابل جزء بسيط من الفاتورة. كثير من الفرق تُعدّ هذا الإعداد هذا الأسبوع، ومعظمها ستبني شيئًا يشبه المراجعة وليس مراجعة.
لا يكمن الفشل في أي من النموذجين، بل فيما يعبر الفجوة بينهما. المراجع الذي يقرأ ملخص العامل لعمله الخاص إنما يقرأ ادعاءً، وكل ما يمكنه إرجاعه هو حكم على ادعاء. التغيير نجح، يقول العامل. يبدو جيدًا، يقول المراجع. ثم يوافق شخص عليه لأن نموذجين اتفقا، وهذا أقل أنواع الاتفاق فائدة.
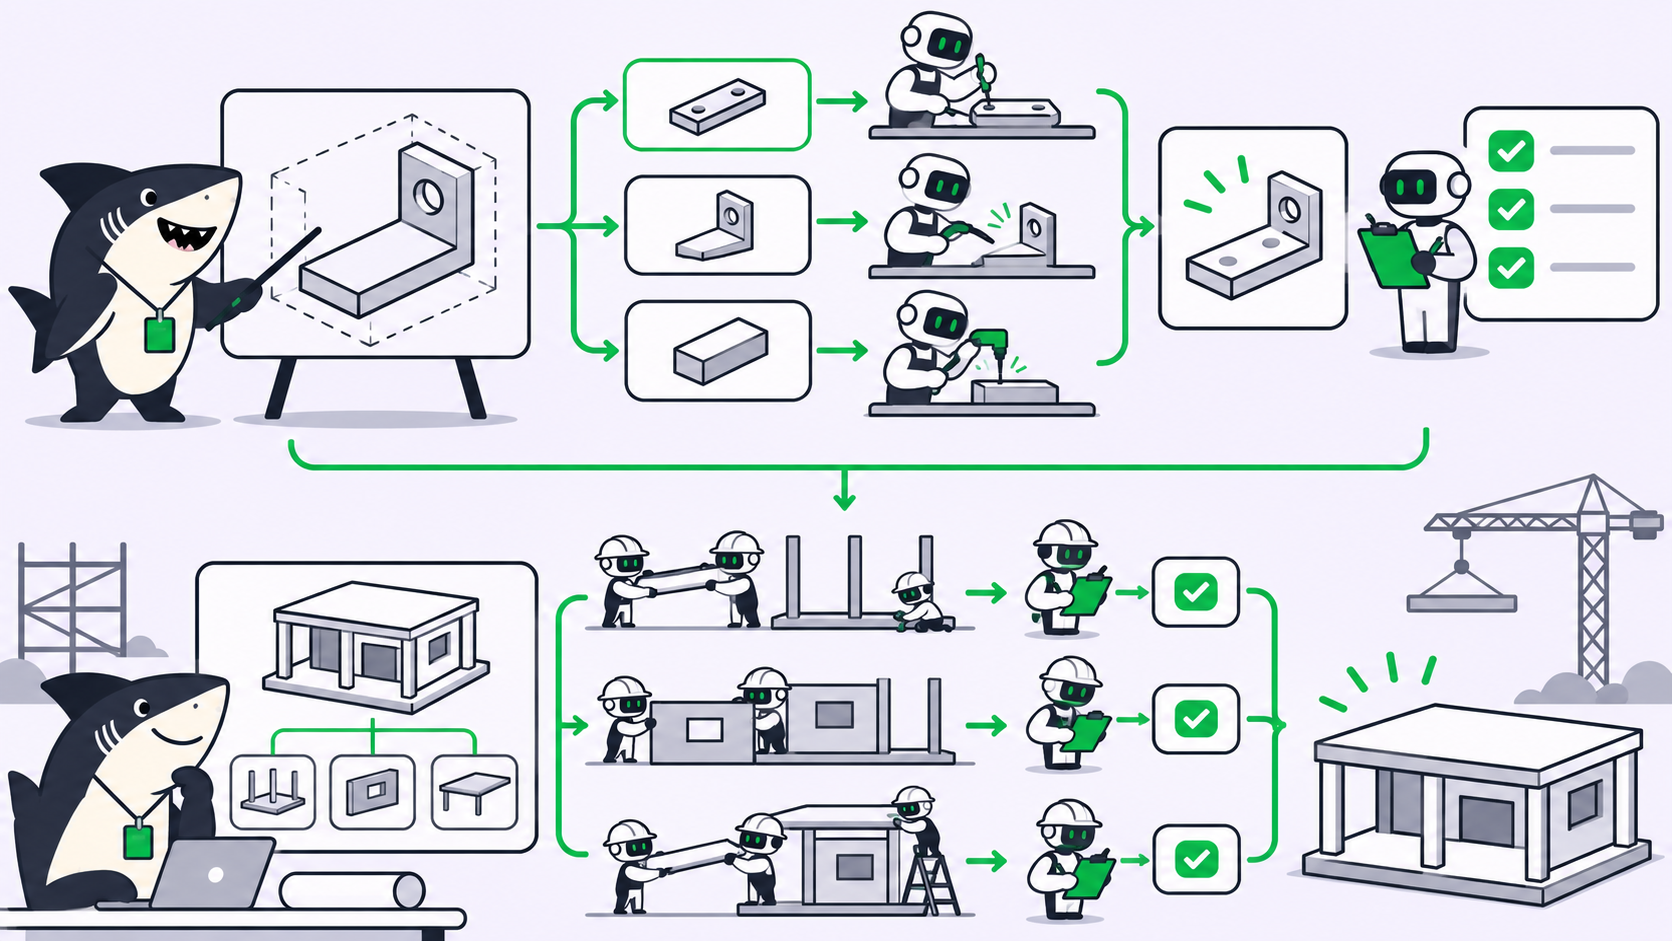
لذا فالسؤال المثير في Crew مختلط النماذج ليس أي نموذج يذهب أين، بل ما الذي يجب أن يحمله التسليم.
ما هو Crew مختلط النماذج
Crew مختلط النماذج هو مجموعة من الوكلاء يُختار فيها الـ Runtime لكل دور بدلًا من أن يُختار لكل فريق، ويكون فيه دور واحد على الأقل موجودًا فقط للتحقق من مخرجات الآخرين.
الوكيل المراجع ليس موافقة، بل رأي ثانٍ له تكلفة، يُنتج قبل أن ينظر الشخص، فيقرأ الشخص قائمة أقصر. يبحث الوكلاء وينفذون ويختبرون ويقدمون التقارير. أما الأشخاص فيحددون الاتجاه، ويمنحون الصلاحية، ويقبلون النتيجة. وإضافة نموذج مكلف في منتصف هذه الجملة لا تحرّك الجزء الأخير منها.
المستويات الثلاثة كما نشرتها الشركات المطوّرة
| Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|
| API id | claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| Input / output per 1M | $4 / $20 | $2 / $10 | $0.10 / $0.50 |
| Cached input | $0.20 read, $5 write | 90% off reads | 90% off reads |
| Context | 1M | 872k | 1M |
تصف OpenAI كلاً من Sol وLuna بأنهما أرخص بنسبة 50% من التسعير الترويجي لـ GPT-5.6، وكلمة «ترويجي» لها دلالتها الخاصة: فالسعر الأساسي هو سعر مخفّض أصلًا. وتقول OpenAI أيضًا إن GPT-6 Astra «لا يزال أفضل نموذج لدينا في كل المجالات».
تحذير واحد قبل أن يستنتج أحد ترتيبًا من هذا التقسيم: تقيس OpenAI في منشور الإطلاق الخاص بها كلاً من Sol وLuna مقابل Claude Opus 5، لأن Opus 5.5 لم يكن موجودًا عند كتابة المنشور، ثم صدر بعد ساعات بسعر أقل بنسبة 40% في التشغيل من Opus 5 وفقًا لما ذكرته Anthropic نفسها. لم يُعِد أحد إجراء تلك المقارنة، والشركتان لا تستخدمان بيئة اختبار مشتركة. اختر الأدوار بناءً على السعر والسلوك الملاحَظ في مستودعك الخاص.
لكن ما تقوله كل شركة عن نموذجها الخاص كافٍ لتوزيع الأدوار. عن Luna، تذكر OpenAI نتيجة 66.6% على DeepSWE 1.1 بأقصى جهد استدلالي، وأرخص بنسبة 93% لكل مهمة من Claude Opus 5 و96% من Fable 5، وعند جهد أعلى نتيجة واقعية تضاهي GPT-5.6 Sol بنحو واحد من مئة من التكلفة. هذا نموذج يمكنك توجيهه نحو الحجم الكبير. وعن Opus 5.5، تذكر Anthropic نتيجة 66.4% على Terminal-Bench 4.0، و54.4% على FrontierCode v1.1، و81.8% على OSWorld 2.0، وحدًا أقصى للمخرجات يبلغ 128k، وقدرة على البقاء في المهمة لمدة 18 ساعة أو أكثر. هذا نموذج يمكنك توجيهه نحو الحكم والتقدير.
القراءة هي النصف الرخيص من النموذج المكلف
سبب صمود هذا الشكل أمام الفاتورة هو التخزين المؤقت (caching)، وعدم التماثل هو ما يحسم التصميم.
تبلغ قراءة الإدخال المخزّن مؤقتًا في Opus 5.5 سعر 0.20 دولار لكل مليون. أي واحد على عشرين من سعر إدخاله غير المخزّن، وضِعف سعر إدخال Luna غير المخزّن. أما مخرجاته فتبلغ 20 دولارًا لكل مليون، أي أربعين ضعف سعر Luna البالغ 0.50 دولار. لذا فمراجع يقرأ قدرًا هائلًا ويكتب عشرين سطرًا يكون شبه مجاني، بينما مراجع يسرد ويطيل ليس كذلك.
هذا يمنحك قاعدة مسنودة بفاتورة: المراجع يقرأ كل شيء ولا يقول تقريبًا شيئًا. أعطه بادئة المستودع، والاصطلاحات، والتغيير، والحزمة أدناه، ثم ضع حدًا أقصى لما يعيده.
جانب العامل يستفيد من التخزين المؤقت أيضًا. يرفع GPT-6 معدلات الإصابة افتراضيًا بخصم 90% على قراءات الإدخال المخزّنة، ويضيف نقاط فصل صريحة لتختار أين تنتهي البادئة المخزّنة، ولم يعد يُبطل الذاكرة المؤقتة عند تغيير جهد الاستدلال أو توافر الأدوات. وتذكر GitHub انخفاضًا بأكثر من 50% في رموز الـ prompt التي تحتاج معالجة جديدة عبر مليارات الطلبات. وبالنسبة لأسطول من عمال Luna يعيدون قراءة المستودع نفسه طوال اليوم، فهذا يمثل معظم الفاتورة.
ما الذي يجب أن يحمله التسليم
هذا هو المخرَج، قالب تسليم مصمم لقارئ من نوع نموذج. يعيده العامل إلى المهمة عند توقفه، ولا يقرأ المراجع سواه بالإضافة إلى التغيير.
SH-312  Add retry with backoff to the webhook sender
Worker:   Agent "backend-worker" - Runtime Codex on gpt-6-luna
Attempts: 2 (attempt 1 failed on lint)
Diff:     4 files, +118 / -12   (worktree sh-312, commit a91f4c2)

Commands run, verbatim:
  $ pnpm lint            exit 0
  $ pnpm typecheck       exit 0
  $ pnpm test -- sender  exit 0   14 passed, 0 failed, 3 skipped
  $ pnpm build           exit 0

Not done:
  - The 3 skipped tests need a live webhook endpoint. Not run.
  - Did not touch the queue consumer, which has the same bug.

Assumptions made:
  - Max 5 retries, ceiling 30s. No spec said. Copied the values
    already used in payments/retry.ts.

Stopped because: acceptance criteria met.
أربع خصائص تجعل هذه الحزمة تستحق ما تستهلكه من رموز.
إنها مخرجات فعلية، لا سرد. يمكن إعادة تشغيل الأوامر ورموز الخروج. أما «لقد تحققت من السلوك» فلا يمكن لأحد التحقق منها.
تُصرّح بما لم يُنجز. الاختبارات المتخطاة والمستهلك غير الملموس هما الشيئان اللذان كان الملخص سيُسقطهما، وهما أكثر ما يحتاجه المراجع. اطلب ذكر الغيابات صراحةً، وإلا فلن يحتويها ملخص مرتب.
تسجّل الافتراضات. كل مهمة محدودة النطاق تحتوي على قرار لم يتخذه المواصفات. فإن كُتب، صار بند مراجعة. وإن أُغفل، صار مفاجأة في الإنتاج بعد شهر.
تسمّي سبب التوقف. الانتهاء، والتوقف، ونفاد الميزانية، والفشل مرتين تبدو جميعها متطابقة في المستودع، لكنها تعني أشياء مختلفة على لوحة المهام.
ما الذي يعيده المراجع
REVIEWER  Agent "review" - Runtime Claude Code on claude-opus-5-5
Reads:  repository prefix (cached), the packet, the full diff
Writes: at most 20 lines

VERDICT      changes requested
CHECKED      4 commands re-run, all exit 0. Backoff ceiling honoured.
UNVERIFIED   3 skipped tests. No evidence the retry path ever runs.
BLOCKING     Retry wraps the 4xx branch. A 422 will be retried 5 times.
FOR A PERSON Queue consumer has the same bug and is out of scope.
             Split SH-312, or widen it?
سطر UNVERIFIED هو ما يستحق تكلفة المراجع. فالعامل الرخيص لن يخبرك أي من ادعاءاته لا يستند إلى شيء، لأنه لا يعرف أصلًا. أما نموذج مكلف يقرأ حزمة منظمة فيمكنه الفصل بين ما أكده وما تبنّاه على الثقة، وهذا الفصل هو جوهر خطوة المراجعة. وسطر FOR A PERSON هو النصف الآخر: المراجع لا يقرر النطاق، بل يعيد السؤال إلى المهمة.
الحد الذي يحافظ على هذا الاتساق: يستطيع الوكيل المراجع إعادة تشغيل الأوامر، وقراءة التغيير، والإشارة إلى الفرق بين الدليل والادعاء. لكنه لا يستطيع أن يخبرك هل كانت هذه هي الميزة الصحيحة أصلًا. ما يستطيع وكيل المراجعة التحقق منه وما لا يستطيع قائمة ثابتة، وهي تقصر لا تطول عندما يكون المراجع مكلفًا.
نمطا فشل يجب مراقبتهما
زمن الاستجابة هو الأول، وهو مخالف للتوقعات. قاست Artificial Analysis، وهي طرف ثالث لا ينتمي إلى أي من الشركتين، النسخ ذات الاستدلال «الأقصى» بـ 124.23 ثانية للرمز الأول لدى Luna و102.15 ثانية لدى Sol. [VERIFY] تحقق من هذه الأرقام مقابل القائمة الحالية قبل الاعتماد عليها. الشكل أهم من الأرقام: عند الجهد الاستدلالي العالي، النماذج الرخيصة ليست هي الأسرع في البدء، لذا يصبح لدى Crew مختلط النماذج عمال يبدون متعطلين ومراجع ينتظرهم. هذه مشكلة حالة تشغيل، لا مشكلة نموذج.
حجم المراجعة هو الثاني. عشرة عمال Luna ينتجون عشر حزم. فإن وافق المراجع على تسع وصعّد واحدة، فقد حوّلت عشر تشغيلات وكيل إلى قرار بشري واحد، وهذا هو الهدف. وإن صعّد ستًا، فقد دفعت تكلفة المراجعة وما زلت مدينًا بستة قرارات، وطابور المراجعة كان أصلًا عنق الزجاجة. تتبّع معدل التصعيد لكل وكيل عامل خلال Sprint واحد. يخبرك ذلك هل الحزمة رقيقة جدًا أم المهام كبيرة جدًا، قبل أن تفعل الفاتورة ذلك بوقت طويل.
متى لا تفعل هذا
استخدم نموذجًا واحدًا لكل شيء عندما يدير شخص واحد وكيلًا أو وكيلين على مستودع واحد. فالحزمة عبء إضافي، والمراجع فاتورة ثانية، وأنت المراجع على أي حال.
استخدم Crew مختلط النماذج عندما يعمل عدة وكلاء بالتوازي، أو عندما يستطيع أكثر من شخص بدء تشغيل، أو عندما يتجاوز العمل المكتمل الوقت المتاح لأي أحد لقراءته.
ولا تضع النموذج المكلف على المراجعة حين يكون العمل نفسه هو الجزء الصعب. فالترحيل الذي يجب أن يحافظ على السياق لساعات ينبغي أن يكون على Opus 5.5 مباشرةً، مع وكيل رخيص يكتب الحزمة بعده. الاختيار لكل دور يعني الاختيار لكل مهمة، لا مرة واحدة لكل فريق، ولهذا فإن مطابقة النماذج بأدوار الوكلاء قاعدة تكتبها لا عادة يحتفظ بها ستة أشخاص في سرّهم.
الرقم الذي لم يتحرك
انخفضت التكلفة لكل مهمة مكتملة بقوة على جانبي هذا الإطلاق. وتذكر OpenAI أن باحثها الوسيط ينفق أكثر من 600 دولار يوميًا على وكلاء البرمجة، مع تجاوز المئين التسعين 7000 دولار. الفرق التي تقع تحت ذلك الخط تستطيع الآن تحمّل عمل بالوكلاء يزيد عدة أضعاف عما كانت عليه الأسبوع الماضي.
أما ساعات المراجعين فهي على حالها تمامًا. يكسب Crew مختلط النماذج قيمته بتحويل مخرجات رخيصة أكثر إلى قرارات بشرية أقل، وهذا لا يحدث إلا إذا حمل التسليم دليلًا بدلًا من ملخص. حافظ على الهدف، والتغيير، والأوامر، والعوائق، والادعاءات غير المتحقق منها، مع عودة المراجعة البشرية إلى المهمة من الطلب حتى الإصدار، وسيصبح تقسيم النماذج إعدادًا يمكنك تغييره الربع القادم دون تغيير طريقة عمل أي أحد.
Sharkly لا تشغّل النموذج ولا تختاره نيابة عنك. إنها الطبقة المشتركة للمهمة والحاسوب والسياق والمراجعة حول الأدوات التي تفعل ذلك، وهي المكان الذي يجب أن يعيش فيه التسليم إذا كان المراجع والشخص سيقرآنه معًا. وإن كنت تدير بالفعل عدة وكلاء برمجة: اربط حاسوبًا واحدًا، وأنشئ وكيل عامل واحدًا ووكيل مراجع واحدًا، واجعل العامل يعيد تلك الحزمة على شيء ممل.