
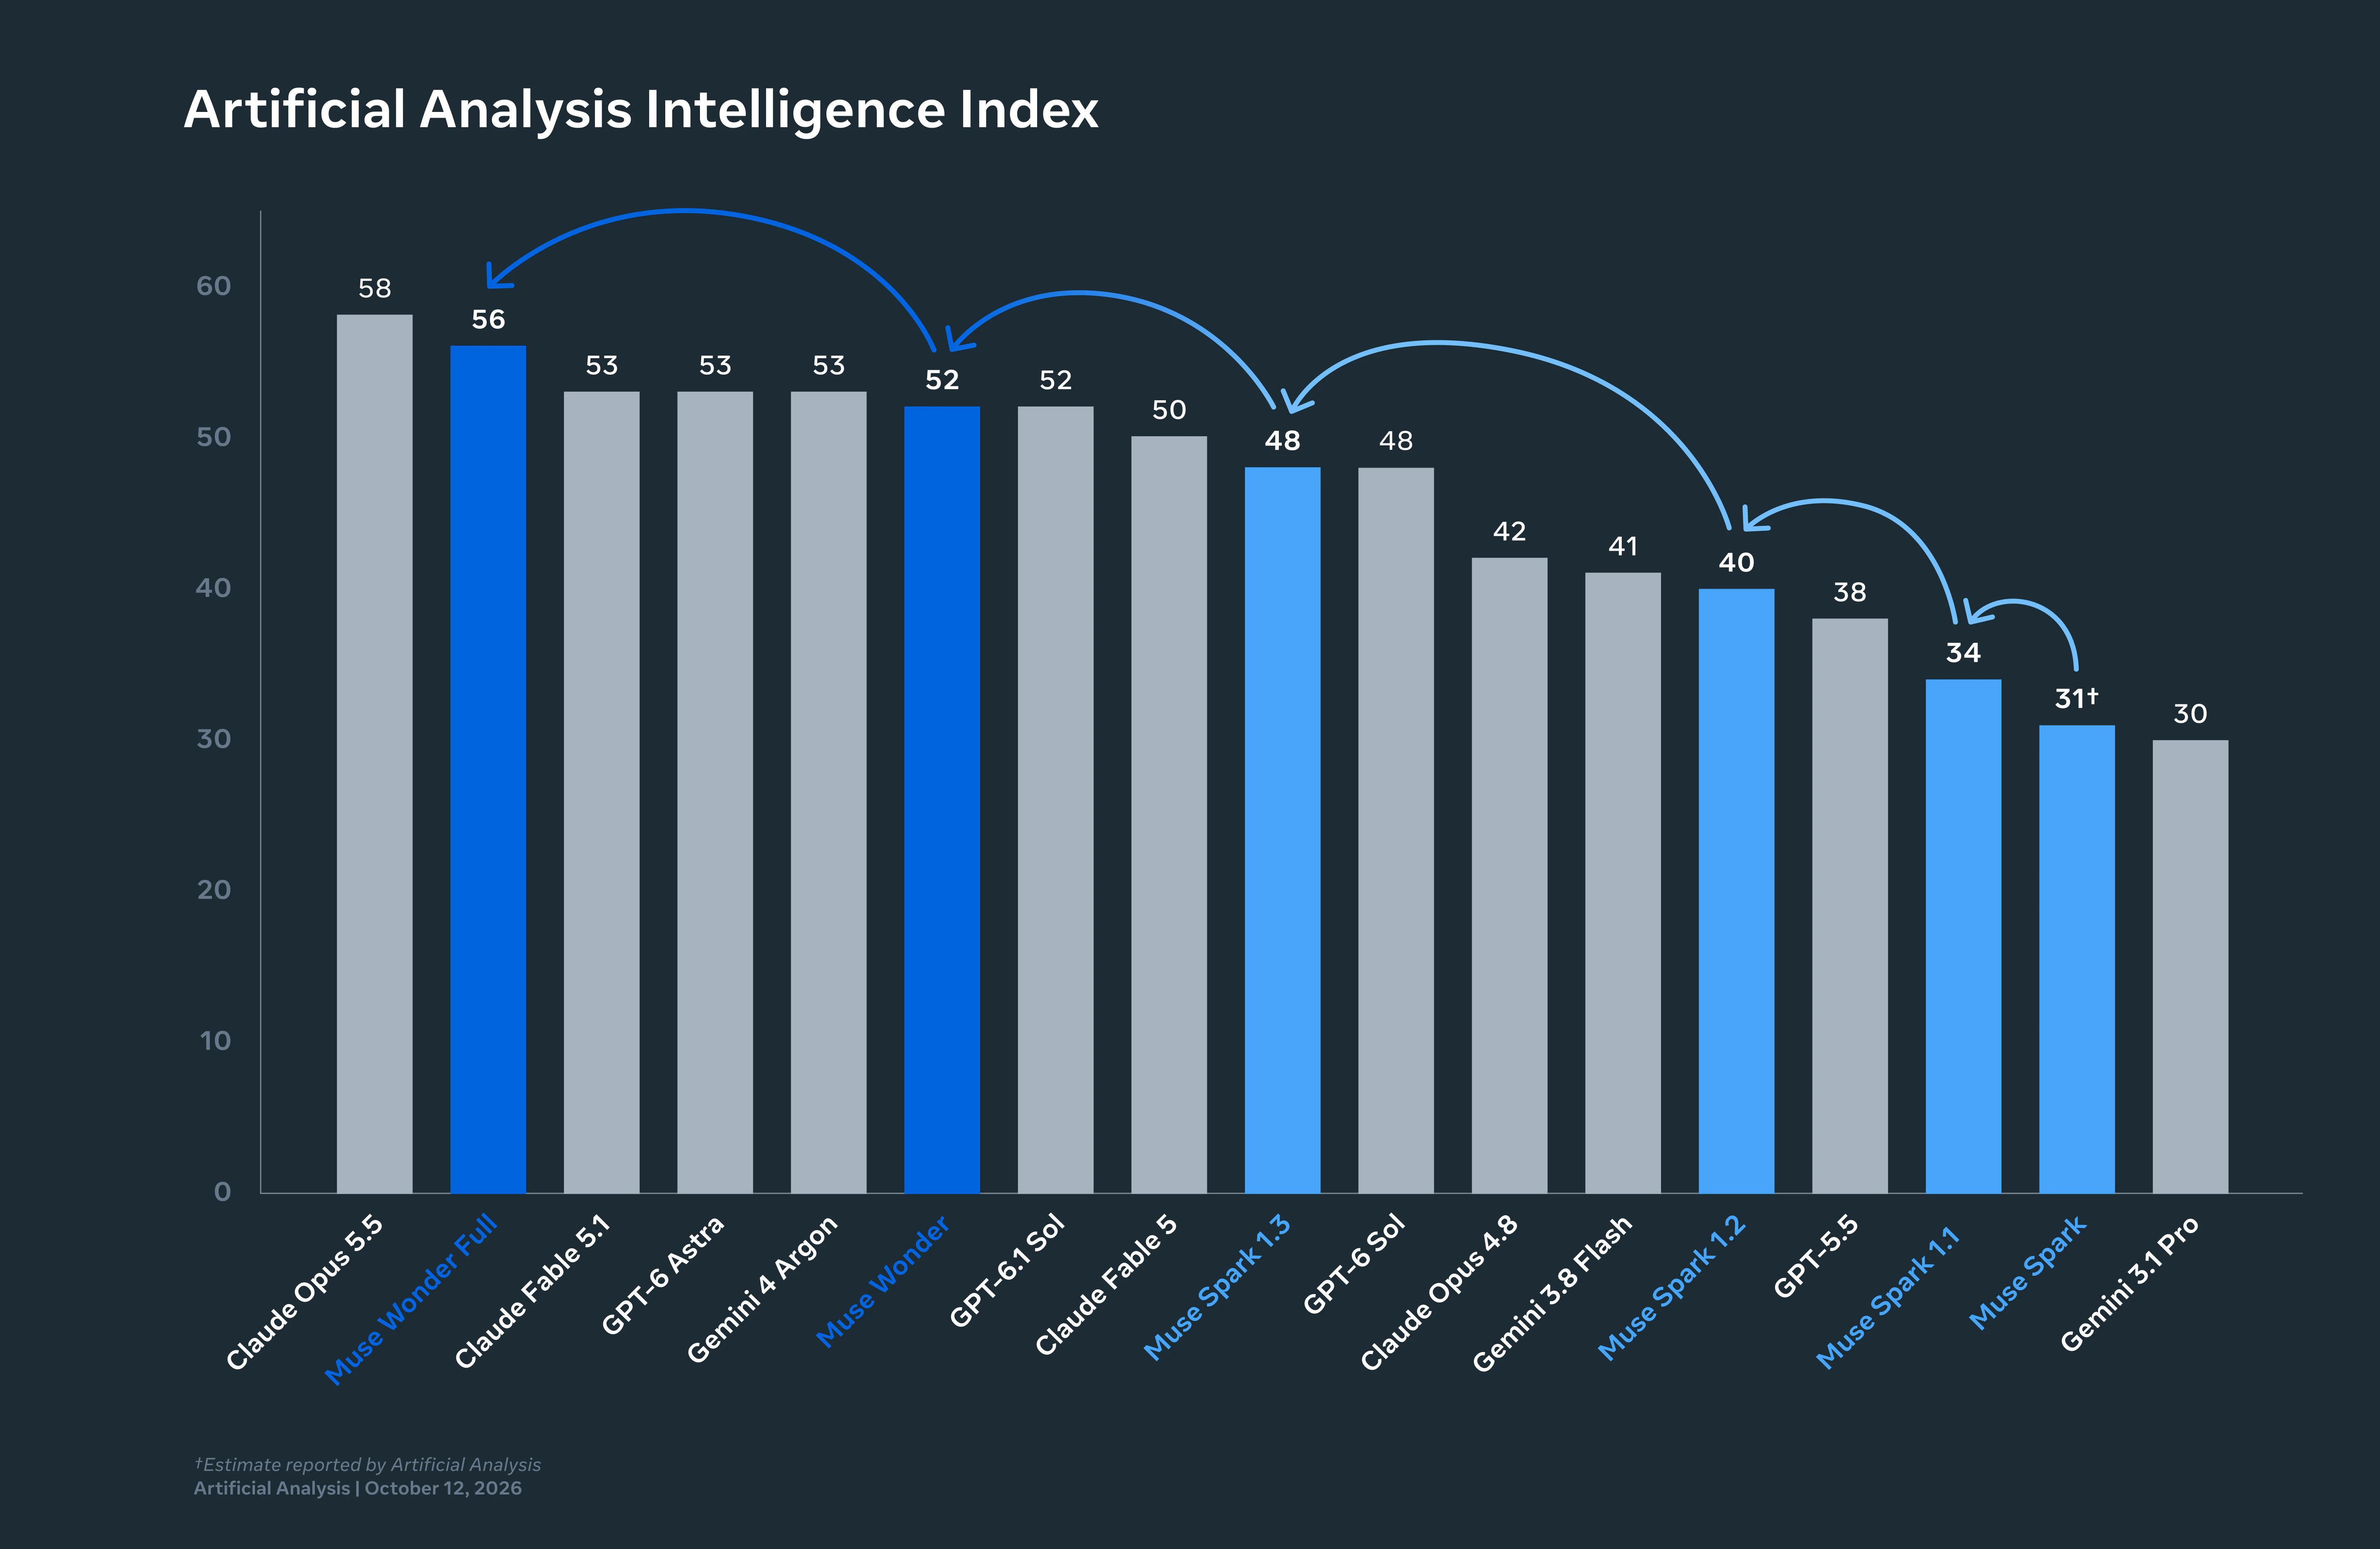
يتطابق نموذجا Muse Wonder وClaude Opus 5.5 في التكلفة تمامًا، حيث تبلغ 4 دولارات لكل مليون رمز إدخال و20 دولارًا لكل مليون رمز إخراج. لذلك، بالنسبة لأي فريق عمل (Crew)، لا يمثل الاختيار بينهما مسألة ميزانية، بل قاعدة توجيه للمهام. تُظهر بطاقة نموذج Meta تفوق Wonder في الاختبار المعياري الذي يقيس مهام البرمجة الطويلة والمستمرة (SWE-Marathon بواقع 53.1 مقابل 46.3)، بينما يتفوق Opus في العمل على الطرفية (59.6 مقابل 52.0)، والذكاء العام (58 مقابل 52 على المؤشر المستقل)، والمعرفة العامة (46 مقابل 25). تصف هذه الأرقام الأربعة وكيلين ذكيين (Agents) مختلفين تمامًا في طبيعتهما؛ وتوجيه المهام بناءً على هذه الأرقام عبر لوحة العمل يحقق أقصى استفادة من كليهما مقارنةً باختيار نموذج واحد افتراضي لكل المهام.
يوضح هذا المقال كيفية تحويل هذه الأرقام إلى توزيع عملي للمهام: أي المهام تسند إلى وكيل Muse Wonder، وأيها يظل لدى Opus 5.5، وأثر كل منهما على قائمة المراجعة (Review queue)، وكيفية التحقق بعد أسبوع من مدى نجاح قاعدة التوجيه المتبعة. خطوات الإعداد لمسار Meta مشروحة في مقال كيفية تشغيل وكلاء Muse Wonder في Sharkly.
الأرقام الأكثر أهمية لتوجيه المهام
| المعيار | Muse Wonder | Claude Opus 5.5 | المصدر |
|---|---|---|---|
| SWE-Marathon (جلسات البرمجة الطويلة) | 53.1 | 46.3 | بطاقة نموذج Meta |
| DeepSWE 1.1 | 78.8 | 74.2 | بطاقة نموذج Meta |
| Terminal-Bench 4.0 | 52.0 | 59.6 | بطاقة نموذج Meta |
| AA-Omniscience (المعرفة) | 25 | 46 | Artificial Analysis |
| معدل الهلوسة | 27% | أقل، وفق تصنيف AA | Artificial Analysis |
| مؤشر الذكاء | 52 | 58 | Artificial Analysis |
| مؤشر وكلاء البرمجة | 63 | 66 (Claude Code) | Artificial Analysis |
| التكلفة لكل مهمة ضمن المؤشر | $4.52 | $5.98 | Artificial Analysis |
| المدخلات المدعومة | نصوص، صور، فيديو، صوت | نصوص، صور، ملفات PDF | وثائق المطورين |
اقرأ هذا الجدول بوصفه ملفين تعريفيين مختلفين. Wonder: مثابر، وأقل تكلفة لكل مهمة لأن مخرجاته موجزة ومباشرة، وأضعف في استرجاع المعلومات، ويدعم الفيديو والصوت. Opus: أكثر ذكاءً في المجمل، وأقوى في بيئة الطرفية (Shell)، ويمتلك مخزونًا معرفيًا أكبر، وأعلى تكلفة لكل مهمة. لا يوجد نموذج أفضل بالمطلق؛ فلكل منهما نوعية المهام التي تناسبه.
المهام المثالية لوكيل Muse Wonder
العامل المشترك هنا هو المهام الطويلة المليئة بالعقبات البرمجية. دربت Meta هذا النموذج على ما تسميه «التركيز النشط» (Active Focus)، أي تجربة طرق بديلة والتعامل مع العقبات والتغلب عليها، ومقياس SWE-Marathon مصمم خصيصًا لقياس هذا الجانب.
- إعادة هيكلة الأكواد البرمجية عبر ملفات متعددة مع الحفاظ على نجاح الاختبارات. خطوات متسلسلة عديدة، كل خطوة منها قابلة للتحقق، مع وجود أخطاء تتطلب محاولة ثانية وثالثة.
- ترقية حزم التبعيات وأطر العمل. السيناريو الكلاسيكي للمهام الطويلة: الترقية، حدوث أخطاء، الإصلاح، ثم التكرار، حيث المطلوب ألا يستسلم النموذج عند الخطوة الحادية عشرة.
- حلقات الإصلاح والتحقق في بيئات الاختبارات غير المستقرة (Flaky tests). الجلسات التي تتطلب من النموذج التمييز بين الخلل الناتج عن كوده والخلل الأصلي في بيئة الاختبار.
- المهام التي تعتمد على مدخلات فيديو أو صوت. مثل تسجيل شاشة يوضح خطأً برمجيًا، أو تسجيل مكالمة يتضمن متطلبات المشروع، وهي مدخلات لا يدعمها Opus 5.5.
احرص على صياغة معيار القبول بحيث يتمكن النموذج من التحقق منه ذاتيًا أثناء التشغيل. يقدم Wonder أفضل أداء عندما تنص المهمة صراحةً على: «اجتياز جميع الاختبارات في packages/api وتحديث سجل التغييرات»، بينما يكون في أسوأ حالاته عندما يترك له تحديد متى تنتهي المهمة.
المهام التي ينبغي إسنادها إلى Opus 5.5
- المهام التي تعتمد بكثافة على الطرفية (Terminal). مثل سكربتات البنية التحتية، ومسارات النشر البرمجي (Deploy pipelines)، وأي مهمة يعمل فيها الوكيل داخل الطرفية. ففارق سبع نقاط ونصف في Terminal-Bench يمثل فجوة حقيقية في الأداء.
- المهام التي تتطلب مخزونًا معرفيًا واسعًا. تسجيل 25 نقطة في Omniscience مقابل 46 يعني أن احتمال افتقار Wonder لمعلومة ما هو ضعف احتمال Opus. ففيما يتعلق بواجهات برمجة التطبيقات للمكتبات التي لم يرها من قبل، أو رموز الأخطاء النادرة، أو المعرفة التخصصية بمجال معين، يجيب Opus من الذاكرة مباشرة، بينما يضطر Wonder للبحث عنها أو التخمين.
- دور المراجع. الوكيل الذي يتولى قراءة الفروق البرمجية (Diffs) التي أنجزها وكيل آخر ويقرر صحتها يجب أن يكون الأكثر ذكاءً بين نماذجك. ووفق المؤشر الشامل، فإن Opus هو الأنسب، كما أن نمط فرق العمل متعددة النماذج يعتمد بالفعل على النموذج الأكثر كفاءة وتكلفة في هذا الموقع.
- المهام القصيرة والدقيقة. في مقياس DeepSWE، الفارق بين النموذجين طفيف، لكن Opus يتصدر في الذكاء العام. فإذا كانت المهمة تستغرق عشر دقائق فقط، فلن تظهر ميزة المثابرة لدى Wonder إطلاقًا.
تأثير كل نموذج على قائمة المراجعة
توجيه المهام يحدد طبيعة النتائج التي تصل إلى المراجعين، وهنا تكمن التكلفة الحقيقية في الواقع العملي.
ينتج عن تشغيل Wonder في مهمة طويلة مسار أكثر تشعبًا: محاولات متعددة، ومناهج تراجع عنها، وتعديلات (Commits) كثيرة. هذا يعني ببساطة أن النموذج يؤدي عمله كما ينبغي، لكنه يعني أيضًا أن مجرد الاطلاع على الفروق البرمجية النهائية لا يكفي. يحتاج المراجع إلى سجل التشغيل الكامل، ولهذا يجب أن تتضمن تعليمات الوكيل توثيقًا مستمرًا لكل المحاولات والخطوات التي اتبعها. وهنا تتجلى بوضوح فكرة أن المراجعة البشرية هي عنق الزجاجة الأساسي؛ فالنموذج المثابر يولد حجمًا أكبر من العمل ليدققه المراجع لكل مهمة، وليس العكس.
أما النقص المعرفي لدى Wonder فيظهر في تقديم تفاصيل خاطئة وبثقة تامة: مثل وسيط غير موجود (Flag)، أو دالة أعيدت تسميتها منذ إصدارين. ورغم أن معدل الهلوسة لديه منخفض نسبيًا مقارنة بفئته—27% وفقًا لمقياس Artificial Analysis—إلا أن نسبة 27% تظل فارقة. لذلك، وجه الوكيل دائمًا للتأكد من أي تفصيلة غير متيقن منها داخل المستودع البرمجي والتصريح بما لم يستطع إثباته، ودع المراجع يدقق هذه الأسطر بالتحديد.
في المقابل، تميل جلسات Opus في المهمة نفسها إلى إنتاج مسار أقصر وأكثر حسمًا، لكن بتكلفة أعلى للمهمة الواحدة، مع مراجعة أسهل لكل تشغيل. ومع ذلك، عندما تكون المهمة طويلة ومعقدة بالعقبات، يكون Opus أكثر عرضة للتوقف قبل الإكمال، مما يُلقي بنوع آخر من الأعباء على القائمة: مهمة عادت منجزة جزئيًا وتحتاج إلى إعادة ضبط نطاق العمل.
أمثلة عملية لتوجيه ثلاث مهام
تساعد الأمثلة المحددة على تطبيق قاعدة التوجيه بسهولة عند توزيع المهام.
«ترقية أداة ربط البيانات بالكيانات (ORM) من الإصدار v5 إلى v7 عبر الخدمات كافة، مع التأكد من نجاح جميع اختبارات التكامل.» تُسند إلى Wonder. خطوات كثيرة ومتسلسلة، وبيئة اختبارات ستظهر أخطاء جديدة في كل مرحلة، وخط نهاية واضح يمكن التحقق منه. مثابرة النموذج هنا هي الميزة الأساسية، ويمكن لجلسة التشغيل التحقق من معيار القبول ذاتيًا.
«كتابة تكوين Terraform لبيئة التجريب الجديدة وتنفيذه.» تُسند إلى Opus. عمل يعتمد على الطرفية بشكل كبير، ومعرفة دقيقة بالبنية التحتية، وإجراء ينطوي على عواقب حساسة. نتائج Terminal-Bench ترجح Opus؛ ومستوى خطورة الأثر يتطلب من الوكيل التوقف وطلب التأكيد قبل تشغيل apply، بصرف النظر عن النموذج المستخدم.
«تفسير سبب تكرار إرسال إشعار الدفع البرمجي (Webhook) واقتراح حل له.» تُسند مهمة التفسير إلى Opus، لأنها تعتمد على معرفة آليات إعادة المحاولة لدى المزود، وهو أمر يتطلب استرجاعًا للمعلومات. وإذا تحول الحل المقترح إلى تعديلات برمجية واسعة تشمل ملفات متعددة مع اختبارات، فيمكن حينئذٍ إسناد مهمة المتابعة إلى Wonder.
الخلاصة المتبعة: وجه إلى Wonder المهام التي يحددها خط نهاية واضح، ووجه إلى Opus المهام التي تحددها طبيعة المعرفة المطلوبة لإنجازها. وعندما تجمع المهمة بين الاثنين، قسّمها. وقد صُممت منصة Sharkly تحديدًا لهذا النوع من التقسيم؛ مهمة واحدة لكل وكيل داخل مساره الخاص، مع توثيق التسليم والتسلم عبر لوحة العمل بدلاً من الاعتماد على الذاكرة الشخصية.
تشغيل النموذجين معًا وتقييم النتائج
طبق هذه القاعدة على لوحة العمل لمدة أسبوع ودع نتائج المهام تتحدث عن نفسها.
- أنشئ وكيل Muse Wonder واحتفظ بوكيل Opus 5.5. واطلب في تعليمات كلا الوكيلين ذكر معرف النموذج أعلى التقرير، نظرًا لأن Sharkly لا يعرضه افتراضيًا.
- وزع المهام بناءً على القاعدة الموضحة أعلاه، وليس وفق التفضيل الشخصي: المهام الطويلة والمليئة بالعقبات إلى Wonder، ومهام الطرفية والمعرفة إلى Opus، والمراجعة إلى Opus.
- بعد انقضاء أسبوع، راجع المهام التي أنهاها كل وكيل وقس ثلاثة أمور: عدد المرات التي توقف فيها الوكيل بطرح سؤال بدلاً من تقديم نتيجة، وعدد المهام التي تطلبت تشغيلًا ثانيًا، وعدد ملاحظات المراجعة التي تطلبتها كل مهمة.
إذا انتهت مهام Wonder الطويلة بجلسات إعادة تشغيل أقل، وانتهت مهام Opus في الطرفية بتصحيحات أقل، فالقاعدة تعمل بنجاح. أما إذا كانت مهام Wonder تتطلب ملاحظات مراجعة تفوق ما وفرته من جلسات إعادة، فقلص نطاق ما ترسله إليه. الأرقام الواردة في الجدول هي متوسطات عبر اختبارات معيارية، بينما مهام عملك الفعلية هي الاختبار الحقيقي الوحيد.
لا شيء من هذا يضاف إلى فاتورة Sharkly مباشرة؛ فاستخدام النماذج يتم عبر مفاتيح Meta وAnthropic المحددة على جهازك، ومع تطابق الأسعار الرسمية المعلنة، فإن الفرق الوحيد في التكلفة يحدده ما يسجله حقل usage في كل جلسة تشغيل.
تغيرت النماذج هذا الشهر، لكن بقيت الرؤية واضحة لكل من السياق، ومستوى التقدم، والعقبات، والنتائج، والمراجعة البشرية بدءًا من لحظة الطلب وحتى الإطلاق. يمكنك بناء ذلك يدويًا عبر مسارات العمل المتفرعة (Worktrees)، أو استخدام Sharkly لإدارة سير العمل بكفاءة.


