
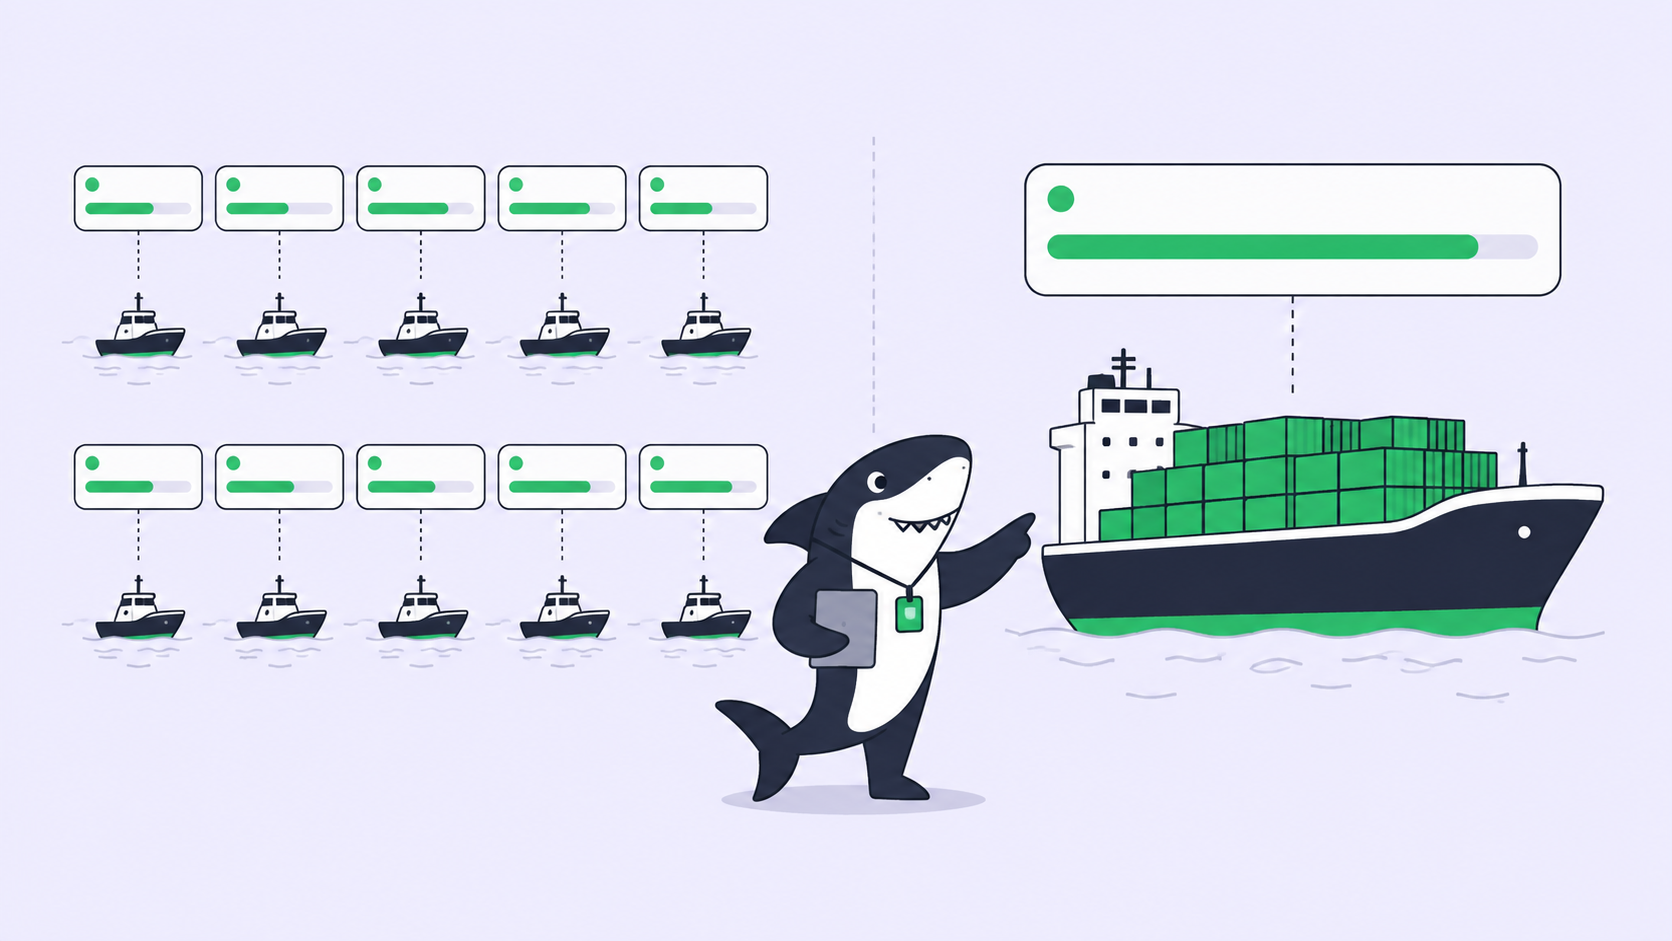
لديك عدد ثابت من المراجعين، ومنذ 2026-09-22 لديك نموذج لم يعد يقرر عنك شيئًا. سعر GPT-6 Luna هو 0.10 دولار لكل مليون رمز إدخال و0.50 دولار لكل مليون رمز إخراج، ومعرّف API هو gpt-6-luna. أما Claude Opus 5.5 فسعره 4 و20 دولارًا، ومعرّف API هو claude-opus-5-5. هذا فارق بمقدار 40 ضعفًا على جانبي العدّاد، وهو حسابنا المبني على قوائم الأسعار المعلنة من الشركتين، ويحوّل سؤالًا كان نظريًا في السابق إلى قرار جدولة أسبوعي. فمقابل المال نفسه، هل تشغّل عشرة وكلاء رخيصين أم وكيلًا واحدًا باهظًا؟
التهيئتان ليستا بديلتين إحداهما عن الأخرى. وما يفصل بينهما ليس جودة النموذج، وهو يظهر في نهاية التشغيل لا في بدايته: فكل تهيئة تضع قدرًا مختلفًا من العمل أمام شخص.
الحساب الذي يجعل السؤال مطروحًا فعليًا
تنشر OpenAI التكلفة لكل مهمة إلى جانب النتيجة، وهذا أنفع من قائمة أسعار. في DeepSWE 1.1، يحقق Luna بأقصى جهد استدلال نسبة 66.6%، وهي نسبة تصفها OpenAI بأنها مماثلة لـ Claude Opus 5 وFable 5 بالجهد المتوسط، وبتكلفة لكل مهمة أقل بنسبة 93% من Opus 5 و96% من Fable 5.
إذا حلّلنا الرقم الأول عكسيًا، فإن مهمة واحدة على Opus 5 تعادل نحو أربع عشرة مهمة على Luna. وبالتالي فإن عشر تشغيلات على Luna تكلف نحو سبعة أعشار تشغيلة واحدة على Opus 5 باستخدام هذا الإطار. هذا الضرب من حسابنا، مبني على نسبة 93% التي أعلنتها OpenAI.
تقول Anthropic إن تشغيل Opus 5.5 يكلف أقل بنسبة 40% من Opus 5. وإذا طبّقنا ذلك، تنخفض النسبة إلى نحو تسعة إلى واحد. هذا الرقم يربط قياسات من شركتين مختلفتين أُخذت على إطارات مختلفة، لذا اعتبره اتجاهًا لا رقمًا دقيقًا: عشر محاولات رخيصة ومحاولة واحدة باهظة تكلف الآن تقريبًا الشيء نفسه، بأي طريقة حسبتها.
| GPT-6 Luna | Claude Opus 5.5 | |
|---|---|---|
| معرّف API | gpt-6-luna |
claude-opus-5-5 |
| الإدخال / الإخراج لكل مليون | 0.10 $ / 0.50 $ | 4 $ / 20 $ |
| الإدخال المخزّن مؤقتًا | خصم 90% على القراءات | 0.20 $ قراءة، 5 $ كتابة |
| نافذة السياق | 1M | 1M |
| ادعاء الشركة بشأن المدى الطويل | لا شيء معلن | يبقى على المهمة 18+ ساعة |
| مؤشر Artificial Analysis | 37 | 58، في المرتبة الأولى من 212 |
يجب أن يرافق هذا الجدول تحذيران. العنوان الرئيسي لـ OpenAI هو أن Sol وLuna أرخص بنسبة 50% لكل منهما من تسعير GPT-5.6 الترويجي، وكلمة "ترويجي" هي كلمة OpenAI نفسها: فالمقارنة تجري مقابل سعر مخفّض، لا سعر قائمة. كما أن منشوري الإطلاق ليسا مواجهة مباشرة. فكلتا الشركتين تعلنان نتيجة AutomationBench، على إصدارات إطار مختلفة ومستويات جهد مختلفة، في اليوم نفسه. ووضع هاتين النسبتين في صف واحد سينتج مقارنة لم تُجرِها أي من المختبرين. أما نسب التكلفة لكل مهمة أعلاه فتصمد لأنها تأتي من داخل قياس شركة واحدة.
ثلاث تهيئات تبدو وكأنها مقايضة واحدة
سؤال "عشرة وكلاء أم واحد" هو في الحقيقة ثلاث ترتيبات، وهي تتصرف بشكل مختلف عند خطوة المراجعة.
| التهيئة | ما يصل إلى المراجعة | من يختار الفائز | تعمل عندما |
|---|---|---|---|
| عشرة وكلاء رخيصون، عشر مهام | عشرة فروقات، عشرة قرارات | شخص، عشر مرات | يكون المخزون واسعًا وكل عنصر مقبولًا بشكل مستقل |
| عشرة وكلاء رخيصون، مهمة واحدة | فرق واحد، قرار واحد | مجموعة اختباراتك | تستطيع آلة ترتيب المحاولات دون أن يقرأها إنسان |
| وكيل واحد باهظ، مهمة واحدة | فرق واحد، قرار واحد | شخص، مرة واحدة | مدى طويل، أو إشارة تلقائية ضعيفة، أو تغيير يحتاج حكمًا طوال الوقت |
الصف الأوسط هو ما يفتحه خفض السعر فعليًا، وهو ما تتخطاه معظم الفرق. فتشغيل المهمة نفسها عشر مرات والاحتفاظ بالمحاولة التي تجتاز فحص الأنواع والاختبارات والبناء استراتيجية لم تصبح ميسورة إلا عندما توقف تكلفة المحاولة عن أن تكون مالًا حقيقيًا. عند معدل نجاح قريب من الثلثين في المعايير، يفشل ثلث المحاولات الفردية. ولو كانت المحاولات تفشل بشكل مستقل، لما فشلت عشر محاولات جميعًا تقريبًا. لكنها لا تفشل بشكل مستقل: فمهمة فيها متطلب غامض أو عنصر ناقص تُحبط كل محاولة بالطريقة نفسها. التوزيع يمنحك التباين، لا ضمانًا.
الصف الأول هو ما تلجأ إليه معظم الفرق فعليًا، وهو المكلف. ليس بالدولار. فتشغيل عشرة وكلاء على عشر مهام ينتج عشرة فروقات، وكل واحد منها يحتاج شخصًا ليقرأه ويفهم ما اختاره الوكيل ويتحمّل مسؤولية دمجه. هذه التكلفة لم تنخفض في 2026-09-22 ولا يمسّها أي إصدار نموذج. لقد كتبنا عن لماذا تشكّل المراجعة البشرية عنق الزجاجة في العمل المتوازي للوكلاء وعن كم من أيام عمل الوكلاء يستطيع يوم عمل بشري واحد استيعابه؛ والحساب هناك لا يتغير برموز أرخص.
عشرة وكلاء على Luna ليسوا عشرة أضعاف المخرجات. إنهم عشرة أضعاف العمل الواصل. النموذج الأرخص يشتري المحاولات. لكنه لا يشتري سعة المراجعة، ومن السهل الخلط بين الاثنين عندما تكون الفاتورة الرقم الوحيد الذي يجري متابعته.
التكلفة لكل تغيير مقبول هي الرقم القابل للتطبيق
التكلفة لكل تغيير مقبول هي ما تنفقه فرقتك على الاستدلال مقابل كل فرق يقرأه شخص ويقبله فعليًا. وهو رقم التكلفة الوحيد للوكلاء الذي يتصل بالعمل المُسلَّم، لأن محاولة لا يراجعها أحد لم تُسلِّم شيئًا.
هذا التعريف يفرز التهيئات الثلاث فورًا. فالتوزيع على مهمة واحدة يقسم عشر محاولات على قرار مراجعة واحد، لذا تُخفّض المحاولات الأرخص التكلفة لكل تغيير مقبول على خط مستقيم. أما العرض على عشر مهام فيقسم محاولة واحدة على قرار مراجعة واحد عشر مرات، لذا تُخفّض المحاولات الأرخص بند الاستدلال بينما يبقى بند المراجعة ثابتًا ويصبح هو القيد. أما العمق على وكيل واحد باهظ فيشتري احتمالًا أعلى بأن تكون المحاولة الوحيدة أمام مراجعك هي الجديرة بالدمج.
هناك أثر ثانٍ لا يظهر إلا في الممارسة العملية. عشر محاولات رخيصة ومحاولة واحدة باهظة لا تُشعرك بالشيء نفسه أثناء العمل. تقيس Artificial Analysis متغيّرات أقصى جهد استدلال لهذه النماذج عند 124.23 ثانية حتى أول رمز لـ Luna و102.15 ثانية لـ Sol، وهي أرقام طرف ثالث لمتغيّرات أقصى الجهد تحديدًا ويستحسن تأكيدها قبل التخطيط على أساسها. عشرة وكلاء يقضي كل منهم دقيقتين صامتًا قبل إنتاج أي حرف ليسوا خط أنابيب سريعًا. إنهم عشر تشغيلات تبدو جميعها متعطلة في الوقت نفسه، وهذه مشكلة حالة لا مشكلة نموذج.
زوج القرار
استخدم عشرة وكلاء رخيصين عندما تقرر آلة. أي عندما تكون للمهمة إشارة قبول حقيقية تعمل دون إنسان: اختبار يفشل اليوم ويجب أن ينجح، فحص أنواع، بناء، قاعدة lint، سكربت إعادة إنتاج. ويصدق هذا على الفرز والوسم وتجهيز الاختبارات وإعادة الهيكلة الميكانيكية. وكذلك أي تغيير يكون فيه سؤال "هل نجح؟" أمرًا برمجيًا لا رأيًا.
استخدم وكيلًا واحدًا باهظًا عندما يقرر شخص. فإذا كان قبول التغيير يتطلب قراءة الكود وتكوين رأي، فلن تفيد المحاولات الإضافية، بل ستضاعف القراءة. وينطبق الأمر ذاته على العمل طويل المدى: تقول Anthropic إن Opus 5.5 يبقى على المهمة لمدة 18 ساعة أو أكثر، وتشغيلة تحافظ على هدف طوال فترة بعد الظهر أثمن من عشر تشغيلات تبدأ كل منها من الفهم الجزئي نفسه.
لا تستخدم التوزيع لتجنّب كتابة إشارة القبول. فعشرة فروقات معقولة دون حَكَم تلقائي أسوأ من فرق واحد، لأن الاختيار بين عشرة فروقات معقولة مهمة أصعب من مراجعة فرق واحد، وهي مهمة تقع على الشخص الذي كنت تحاول حمايته.
ما تحتاجه التهيئة الواسعة من الطبقة الأعلى
تشغيل عشرة وكلاء في الوقت نفسه مشكلة تنسيق قبل أن يكون مشكلة تكلفة. والعناصر معروفة: تشغيل كل نسخة في شجرة عمل خاصة بها حتى لا يتحول تعديل وكيلين للملف نفسه إلى حادثة، ومكلَّف واحد لكل مهمة حتى لا تكون الملكية غامضة أبدًا، وحالة تفرّق بين قيد التشغيل والانتظار والفشل.
الوكيل يحدد كيف ينبغي التعامل مع العمل. والحاسوب يوفّر المضيف والموارد المحلية. وبيئة التشغيل تنفّذ الجلسة. والمهمة تبقى السجل المشترك. وعندما تنتهي عشر تشغيلات في غضون ساعة من بعضها، فإن هذا الجزء الأخير هو ما يمنع تلك الساعة من أن تتحول إلى بحث مضنٍ في عشرة طرفيات.
ينبغي أن تعيد تشغيلة Luna المنتهية شيئًا كهذا إلى مهمتها، لا إلى سجل جلسة خاص:
SH-312  Add retry with backoff to the webhook dispatcher
Runtime   gpt-6-luna (fan-out, 8 attempts, 3 passed the suite)
Selected  attempt 6, smallest diff of the passing set
Evidence  typecheck ok, 214 tests pass, build ok, coverage +0.4%
Known limit  no test for the 429 path, dispatcher is not idempotent yet
Status    Ready for review, waiting on a human
سطر الاختيار هو الجزء المهم. فهو يبيّن ما الذي قرر، ليعرف المراجع ما إذا كان يصادق على اختيار آلة أم يتخذ قرارًا بنفسه. عشر محاولات دون سجل اختيار هي عشرة أضعاف العمل متنكّرة في هيئة مهمة واحدة.
الجواب
عشرة وكلاء رخيصون يسلّمون أكثر عندما تقرر مجموعة اختبارات ويكون المخزون واسعًا بما يكفي لإبقائهم مشغولين. ووكيل واحد باهظ يسلّم أكثر عندما يكون قرار القبول بشريًا، أو المدى طويلًا، أو الإشارة التلقائية ضعيفة. ومعظم الفرق تريد الاثنين، موزّعين حسب نوع المهمة لا حسب التفضيل، وهذا هو جوهر الحجة في مطابقة النماذج بأدوار الوكلاء.
لا تغيّر أي من التهيئتين الخطوة الأخيرة. فالوكلاء يبحثون وينفّذون ويختبرون ويقدّمون التقارير. والناس يحددون الاتجاه ويمنحون الصلاحية ويقبلون النتيجة. تحرّكت أسعار النماذج بمقدار 40 ضعفًا في يوم واحد، أما عدد التغييرات التي تستطيع فرقتك قبولها بمسؤولية فلم يتحرك قيد أنملة.
إذا كنت تشغّل عدة وكلاء بالفعل، فـ Sharkly يمنحك مكانًا واحدًا تُبقي فيه السياق والتقدم والعوائق والنتائج والمراجعة البشرية ظاهرة من الطلب إلى الإصدار، أيًّا كانت بيئة التشغيل التي أنتجت الفرق.


