
Dein Coding-Agent kann einen Service schreiben, ein Modul refaktorieren und einen Stack Trace erklären. Frag ihn, was letzte Woche über ein Library-Release gesagt wurde, und er hängt. Bitte ihn, einen Konferenzvortrag zusammenzufassen, und er kommt nicht an das Transkript heran. Die Informationen, die ein Agent am dringendsten braucht, liegen auf Plattformen, die entweder Geld für den Zugang verlangen oder ihn blockieren.
Agent-Reach ist eine einzige CLI, die das umgeht, und mit 77.134 Sternen ist es die am häufigsten übernommene Antwort auf dieses Problem. Es löst das Lesen. Es löst nicht, was mit dem Gelesenen passiert – und genau das kostet Teams echte Zeit.
TL;DR
Dies ist einer von fünf Deep Dives aus unserer Übersicht über Open-Source-Tools, die Coding-Agents erweitern.
Agent-Reach verbindet jeden Agenten, der Shell-Befehle ausführen kann, mit X, Reddit, YouTube, GitHub, RSS, Bilibili, XiaoHongShu, Facebook, Instagram, Podcasts und allgemeiner Websuche – über kostenlose Zugangswege statt über kostenpflichtige Plattform-APIs. Jede Plattform läuft über ein primäres Backend mit Fallbacks, sodass defekte Zugangswege upstream umgeschaltet werden und nicht von dir. Beginne mit den Plattformen ohne Konfiguration, prüfe die Bedingungen, bevor du cookie-basierte verbindest, und gib der Recherche einen Ort zum Landen, der nicht der Scrollback des Terminals ist.
Die Hürde, die es beseitigt
Jede dieser Plattformen hat ihr eigenes Hindernis, und jede Umgehung ist ihr eigenes kleines Integrationsprojekt:
| Plattform | Die Hürde | Einrichtung in Agent-Reach |
|---|---|---|
| Twitter/X | Kostenpflichtige API, rund 215 $/Monat bei moderater Nutzung | Browser-Cookie |
| Server-IPs werden bei anonymen Endpunkten blockiert | Browser-Sitzung oder Cookie | |
| YouTube | Transkripte werden nicht bereitgestellt | Keine Konfiguration nötig |
| GitHub | Authentifizierung nötig, sobald es über öffentliche Lesezugriffe hinausgeht | Keine Konfiguration nötig, gh auth login für mehr |
| Webseiten | Markup-Rauschen | Keine Konfiguration nötig |
| Websuche | API-Schlüssel | Wird bei der Installation automatisch konfiguriert |
Wenn du fünf Plattformen selbst anbindest, hast du fünf Dinge, die unabhängig voneinander ausfallen. Das Versprechen hier lautet: einmal installieren und danach unsichtbar.
Die Installation
Der Installationsweg ist ungewöhnlich: Du gibst deinem Agenten eine Dokumentations-URL, statt einen Befehl auszuführen.
Install Agent Reach: https://raw.githubusercontent.com/Panniantong/agent-reach/main/docs/install.md
Der Agent installiert das Python-Paket, prüft die Umgebung und meldet, was bereit ist. Standardmäßig ist der Zugriff schreibgeschützt, und systemweite Änderungen erfordern ein explizites Flag.
pip install https://github.com/Panniantong/agent-reach/archive/main.zip
agent-reach install --env=auto
agent-reach doctor
agent-reach doctor gibt aus, was funktioniert, was nicht, und wie sich beides beheben lässt. Für ein Tool, dessen Aufgabe inhärent fragiler Drittanbieter-Zugriff ist, ist ein Gesundheitscheck als erstklassiger Befehl genau der richtige Instinkt.
Die Design-Entscheidung, die es sich zu kopieren lohnt
Einen Scraper zu verpacken, kann jeder. Warum dieses Projekt Bestand hat, liegt an der Fallback-Kette: Jede Plattform hat ein primäres Backend und eine geordnete Liste von Alternativen. Wenn ein Zugangsweg stirbt, wechselt das Projekt den Standard und liefert ein Update aus. Ihr eigenes Beispiel: Bilibili begann im Juni 2026, einem Backend 412-Fehler zurückzugeben – ohne dass Nutzer etwas bemerkten.
Das verhindert den Fehlermodus, der selbstgebaute Versionen das Leben kostet. Dein Scraper funktioniert vier Monate, bricht an einem Dienstag zusammen, und du erfährst es, wenn ein Agent selbstsicher meldet, ein Thema werde nirgends diskutiert, statt dass der Abruf fehlgeschlagen ist. Ein Agent, der ein leeres Ergebnis nicht von einer fehlgeschlagenen Anfrage unterscheiden kann, verkündet beides mit derselben Überzeugung.
Wo das kostenlose Zugangsmodell eine Entscheidung verlangt
Die Plattformen ohne Konfiguration sind unkompliziert: öffentliche APIs, die offizielle GitHub-CLI, RSS und ein Suchanbieter, der den Traffic will.
Die cookie-basierten Plattformen sind eine andere Frage. X, Reddit oder Instagram über deine eigene angemeldete Sitzung zu lesen, ist kein autorisierter API-Weg. Das Projekt geht verantwortungsvoll damit um: Cookies bleiben lokal und werden nie hochgeladen, und da es Open Source ist, kannst du das überprüfen. Was es nicht ändern kann, sind die Bedingungen, denen du bei diesen Konten zugestimmt hast.
Nutze es für persönliche Recherche mit deinen eigenen Konten – genau dafür installieren es die meisten. Prüfe die relevanten Bedingungen, bevor du es kommerziell einsetzt, und verwende ein Konto, dessen Verlust du verschmerzen kannst. Behandle inoffiziellen Zugang nicht als Produktionsdatenquelle.
Recherche ist langwierige Arbeit, und langwierige Arbeit braucht eine Task
Hier ist das Problem, das in Woche zwei auftaucht – und es ist nicht technisch.
Recherche-Läufe sind lang. Ein Agent, der zwei Stunden lang X, Reddit, Hacker News und GitHub durchsucht, produziert etwas Wertvolles: Quellen, Zitate, Daten, Links, eine Synthese. Dann endet die Sitzung. Eine Kollegin fragt, woher eine Aussage stammt, und die Antwort ist nicht verfügbar. Schlimmer noch: Jemand betreibt die gleiche Recherche nächsten Monat erneut, weil niemand wusste, dass es sie schon gibt.
Eine Task ist die zentrale Arbeitseinheit in Sharkly. Sie bündelt Anfrage, Kontext, Ausführung und Ergebnis an einem gemeinsamen Ort, statt sie über private Prompts und Terminal-Sitzungen zu verteilen. Ausführung, Blocker, Ergebnisse und Folgediskussion landen in der Timeline der Task, sodass die Quellen auch im nächsten Quartal noch da sind.
Drei Teile des Modells sind speziell für Recherchearbeit wichtig.
Ein Agent ist eine gespeicherte Konfiguration: Anweisungen, Runtime, Skills, Repositories und Umgebung. Ein Recherche-Setup, das du einmal abgestimmt hast – inklusive der Frage, welche Plattformen es anfassen darf –, wird wiederverwendet statt neu aufgebaut.
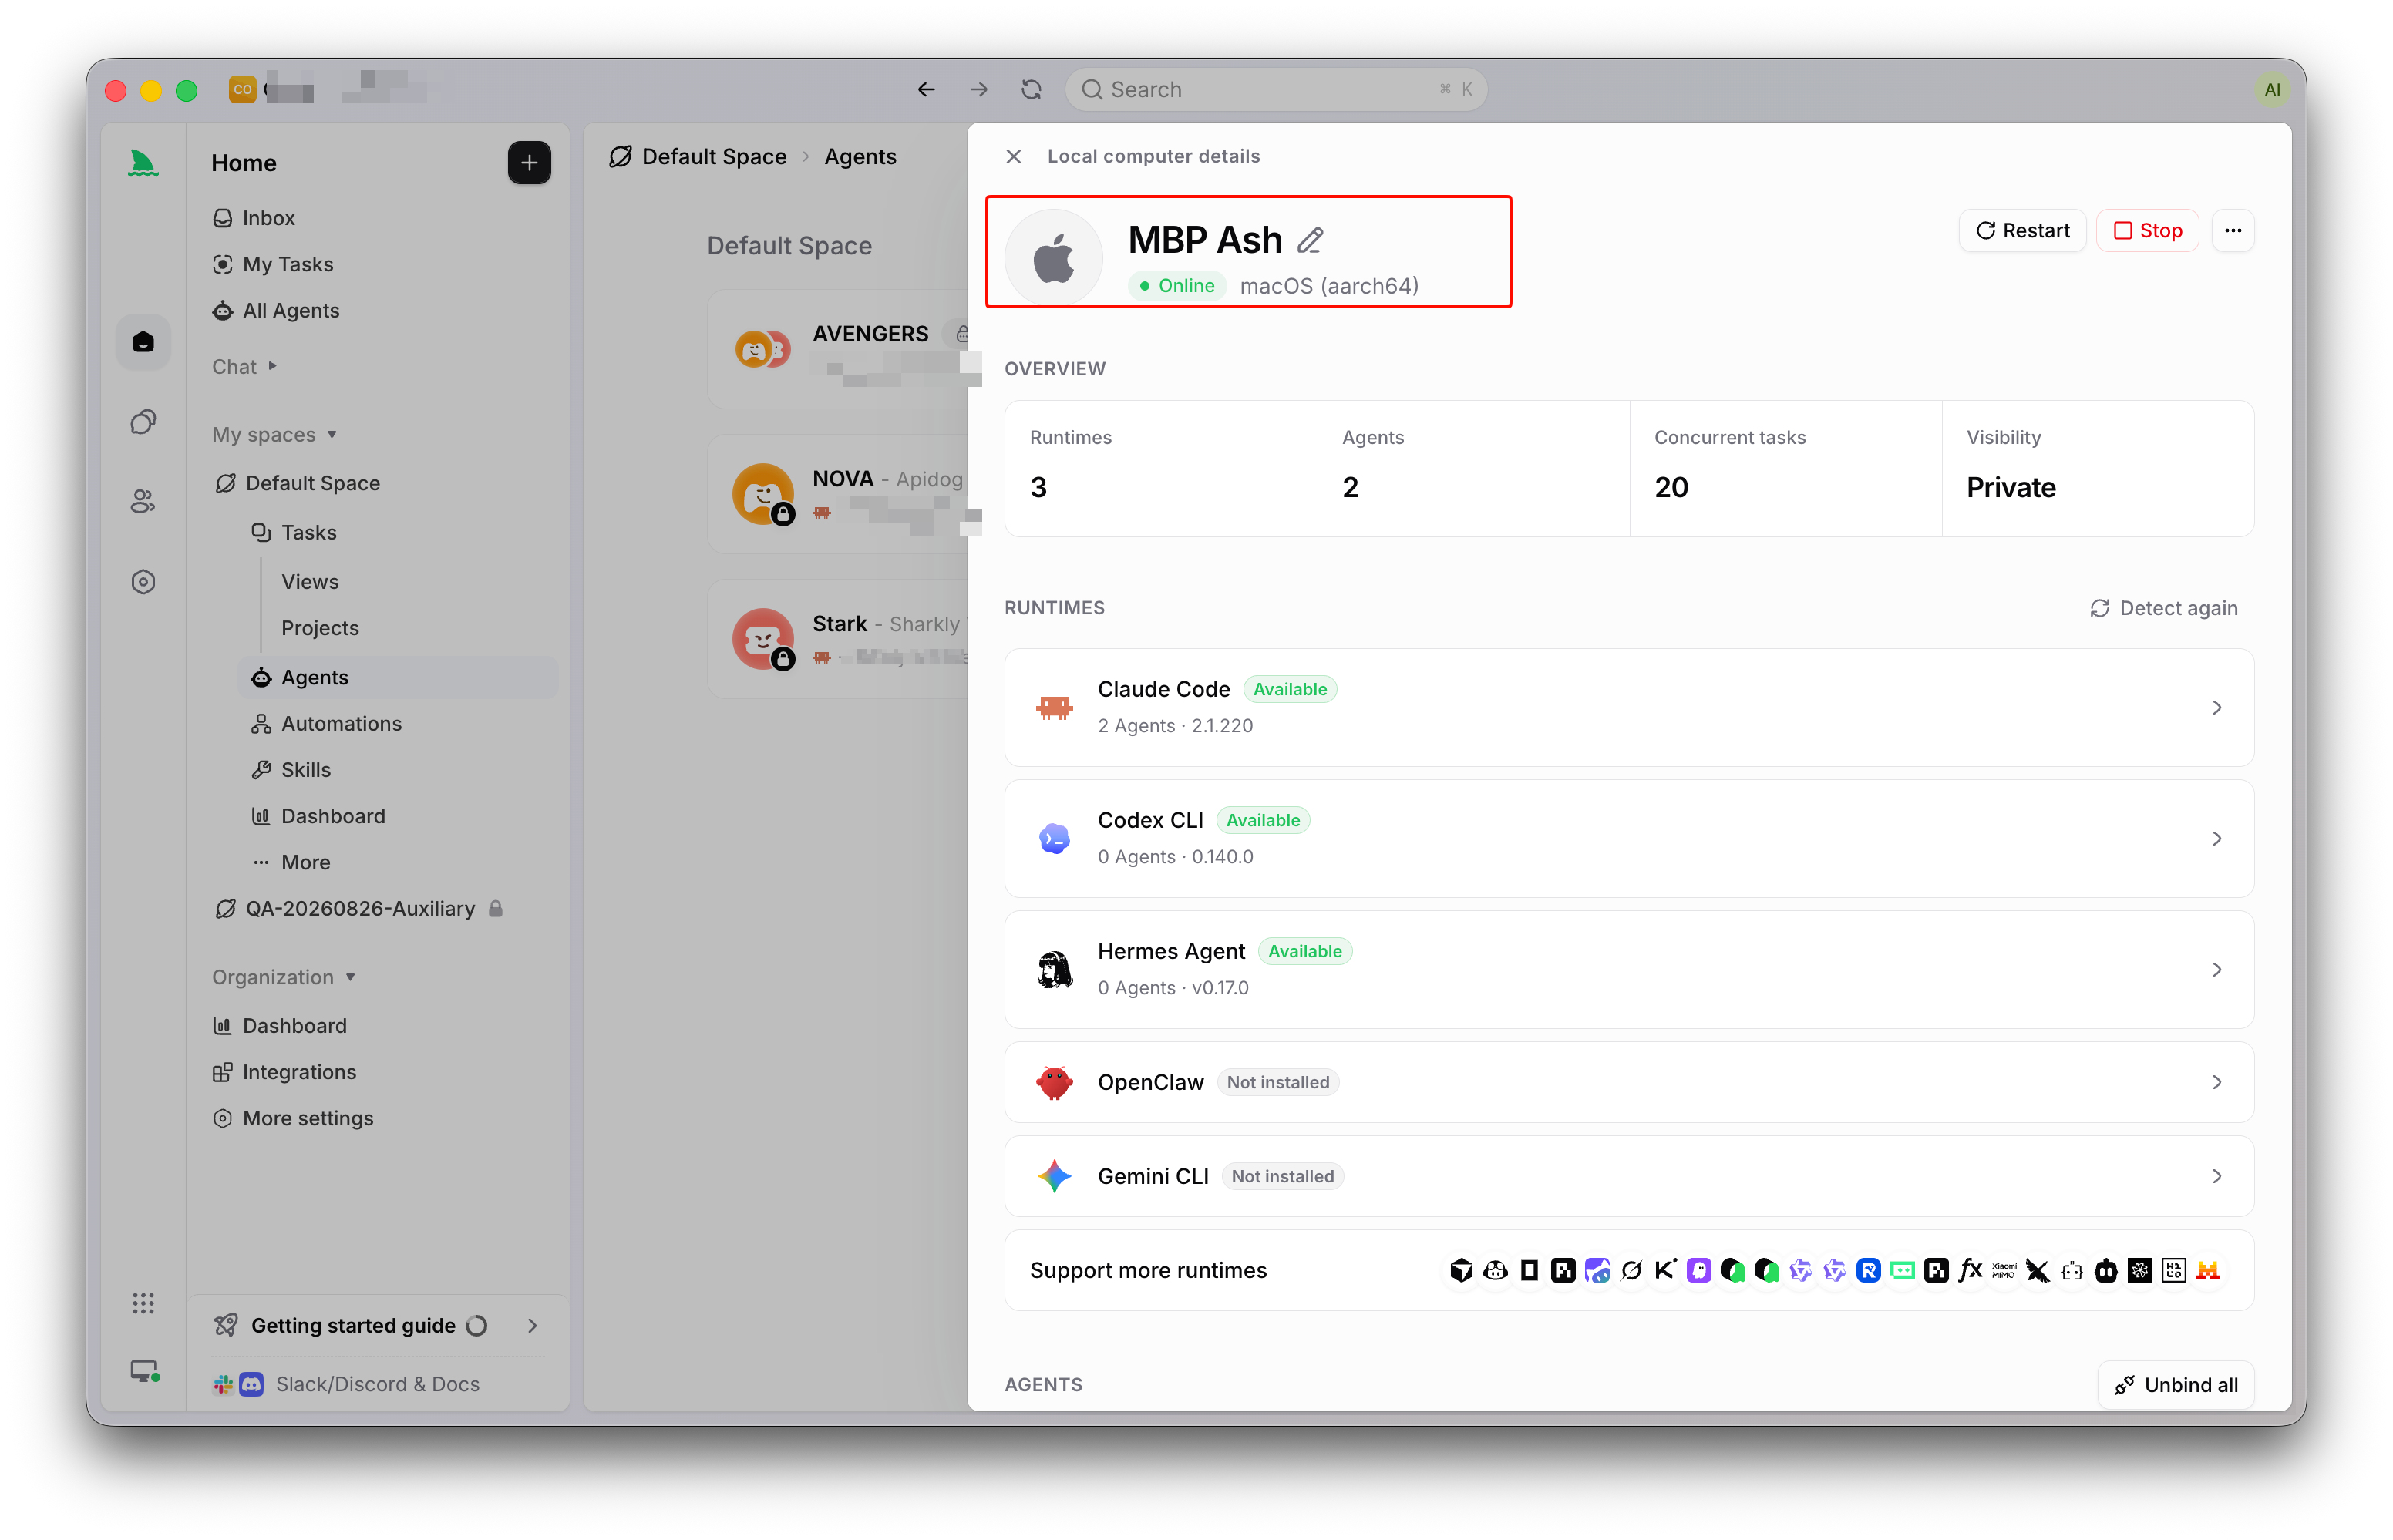
Ein Computer stellt den Host und die lokalen Ressourcen bereit, und die Runtime führt die Sitzung darauf aus. Das ist hier nicht abstrakt. Die cookie-basierten Plattformen von Agent-Reach brauchen einen echten angemeldeten Browser auf einer bestimmten Maschine. Auf welchem Computer eine Recherche-Task läuft, ist also eine echte operative Entscheidung und nicht davon abhängig, welcher Laptop gerade offen war.
Eine Task im Backlog startet keinen Lauf. Du kannst Recherchethemen einreihen, sobald sie dir einfallen, ohne im Moment des Aufschreibens Rate Limits zu verbrauchen.
Sharkly ersetzt weder Agent-Reach noch das Coding-Tool, das es ausführt. Es ergänzt beide um die gemeinsame Ebene für Task, Computer, Kontext, Steuerung und Review.
Direkt nutzen oder ihm einen Ort zum Berichten geben
Nutze Agent-Reach allein, wenn du heute eine Frage für dich selbst beantwortest. Installieren, fragen, lesen, weitermachen. Mehr ist nicht nötig.
Nutze ein gemeinsames Arbeitsystem, wenn die Erkenntnisse in eine Entscheidung einfließen, die jemand anderes trifft, wenn eine Aussage in einem Dokument oder einem Kundengespräch landen wird oder wenn dieselbe Recherche sonst von einer Kollegin wiederholt würde, die nichts von ihr wusste.
In beiden Fällen gilt eine Disziplin: Behandle jeden Fund als ungeprüft, bis ein Mensch den Link öffnet. Ein Agent kann einen Beitrag lesen, der ein Benchmark-Ergebnis behauptet; er kann dir nicht sagen, ob das Benchmark echt war. Agenten recherchieren, führen aus, testen und berichten. Menschen geben die Richtung vor, erteilen Befugnisse und nehmen das Ergebnis ab.
Häufig gestellte Fragen
Mit welchen Agenten funktioniert Agent-Reach? Mit jedem Agenten, der Shell-Befehle ausführen kann, darunter Claude Code, Cursor, Windsurf, OpenClaw und Codex. Bei OpenClaw muss zuerst die exec-Berechtigung aktiviert werden, weil das standardmäßige Messaging-Profil keine Befehle ausführen kann.
Ist die Nutzung wirklich kostenlos? Die Tools sind Open Source und die Zugangswege verursachen keine Kosten. Ein Server-Proxy kostet etwa einen Dollar im Monat, falls die IP deiner Maschine blockiert ist; lokale Maschinen brauchen keinen. Keine Anbieterrechnung zu zahlen ist nicht dasselbe wie frei von Nutzungsbedingungen zu sein.
Sind meine Cookies sicher? Das Projekt erklärt, dass Cookies lokal bleiben und nie hochgeladen werden, und der Quellcode lässt sich überprüfen. Das praktische Risiko ist nicht die Exfiltration, sondern dass dein Konto von der Plattform gedrosselt oder markiert wird.
Bricht es, wenn Plattformen sich ändern? Ja, und darauf ist es ausgelegt. Jede Plattform hat Fallbacks, und das Projekt schaltet die Standards upstream um. Führe agent-reach doctor aus, wenn etwas seltsam aussieht.
Wie passt das zum parallelen Betrieb mehrerer Agenten? Recherche und Code laufen gut parallel, und jeder Task-Lauf bekommt seinen eigenen isolierten Worktree, sodass nichts kollidiert. Die Ergebnisse landen in ihrer jeweiligen Task.
Die Kurzfassung
Agent-Reach beseitigt eine echte Einschränkung. Ein Agent, der die tatsächliche Diskussion rund um eine Library lesen, den Vortrag ansehen und den Issue-Tracker prüfen kann, antwortet besser als einer, der mit einem Trainings-Cutoff arbeitet – und das Fallback-Design sorgt dafür, dass er auch nach dem unvermeidlichen Ausfall weiterläuft.
Installiere es zuerst für die Plattformen ohne Konfiguration und denk nach, bevor du Cookies verbindest. Entscheide dann, wohin die Ergebnisse gehen. Recherche, die nur im Scrollback lebt, wird wiederholt. Sharkly hält die andere Hälfte: Die Task ist der gemeinsame Datensatz, die Ausführung läuft auf Computern, die du verbindest, und die Ergebnisse landen dort, wo ein Mensch sie prüfen kann.


